抖音星图达人评估 API 教程:投放前对比达人画像、表现与报价 | SandBase
品牌投放前怎么比达人?用 SandBase 先拿到星图 kolId,再读基础信息、粉丝画像、近期视频表现和报价,把 2~3 个候选摆在一张表里。
品牌方甩过来三个抖音账号,只问一句:这条植入给谁?光看粉丝数是答不出来的。你得知道每个号的粉丝到底是谁、最近的视频跑得怎么样、商单和自然流量差多少、报价又是多少。这些商业维度的数据,在抖音体系里放在巨量星图——官方的达人营销撮合平台。这篇教程用 SandBase 的星图端点,把候选达人的星图数据拉下来并排对比,交给 Agent 或分析师写推荐意见。
本文挂在 抖音公开数据 API 总览 下面。如果你要的是达人发过的视频和播放量,而不是商业视图,请看 抖音达人视频研究教程。这篇只管一件事:投放决策。
不需要抖音或星图账号,用 SandBase API key 鉴权即可。本文用到的抖音端点(包括星图这几个)目前在 SandBase 目录里标的是 Free。星图参考页的描述里另有一行按次价格,kol 详情类接口还会提到企业账号。SandBase 的当前状态以目录为准,正式使用前请先确认。
参考页只保证响应信封。下文所有业务字段名都来自我自己的调用(测试于 2026-10-01,UTC),仅作示意,属于实测观察,不是文档保证。
先说结论
- 星图端点要的是
kolId,不是抖音的sec_user_id。先用douyin/xingtu/xingtu-kolid-by-sec-user-id换出来。kol-base-info-v1、kol-fans-portrait-v1、kol-video-performance-v1分别给出达人分类、粉丝构成,以及近期自然视频和商单视频的播放表现。kol-service-price-v1返回星图报价单,kol-cp-info-v1返回预期播放量和 CPM、CPE 估算。- 我测了三个公开媒体品牌号(日食记、中国国家地理、一条),全部解析成功,详情调用全部完成。其中一个号的表现汇总是空的,所以代码会退回到原始视频播放量。
为什么要看星图数据
抖音公开主页只告诉你粉丝数和获赞数。谈商单要的是另一套数字:粉丝的年龄、城市线级、八大人群构成,商单视频的播放中位数,以及每种视频形式的挂牌价。这些星图只开放给广告主看,SandBase 的 douyin/xingtu 系列按 kolId 读取。
| 你的需求 | 用什么 |
|---|---|
| 用星图公开挂牌数据筛选、对比达人 | SandBase douyin/xingtu 端点 |
| 下单、签约、给达人发 brief | 星图官方广告主后台 |
| 私有投放结果或仅账号可见的数据 | 两条公开路线都不行 |
说白了,这是做调研,不是下单。SandBase 帮你读到挂牌数据,真正下单还是在星图里完成。
流程一览
- 找到账号:
douyin/search/user-search-v2(keyword、cursor),记下sec_user_id。 - 换星图
kolId:douyin/xingtu/xingtu-kolid-by-sec-user-id(sec_user_id)。 - 读基础信息:
douyin/xingtu/kol-base-info-v1(kolId、platformChannel)。 - 读粉丝画像:
douyin/xingtu/kol-fans-portrait-v1(kolId)。 - 读近期视频表现:
douyin/xingtu/kol-video-performance-v1(kolId、onlyAssign)。 - 读报价和成本估算:
douyin/xingtu/kol-service-price-v1(kolId、platformChannel)加douyin/xingtu/kol-cp-info-v1(kolId)。
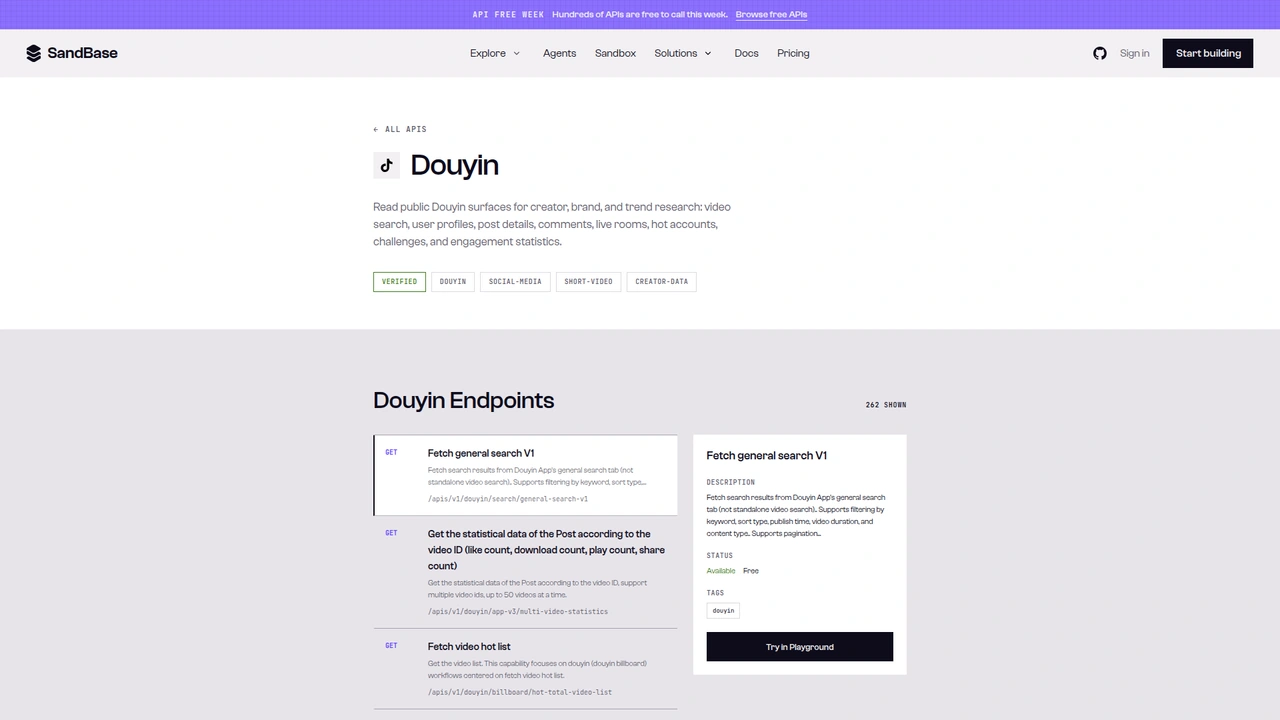 SandBase 上的抖音目录页:共 262 个端点,路径写成
GET /apis/v1/douyin/...,右侧选中的综合搜索 V1 标着 Available、Free。本教程调用的是 Model API 的 POST /v1/api/douyin/... 路由。
目录页展示的是 GET /apis/v1/douyin/<path>。下面的代码用的是端点参考页里的 Model API:POST /v1/api/douyin/<path>,JSON body 里只放该端点自己的参数。复制示例时,POST 方法和 /v1/api/ 前缀都别改。
第 0 步:一个通用调用函数
import os
import statistics
import time
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call(path: str, payload: dict, retries: int = 2) -> dict:
    for attempt in range(retries + 1):
        try:
            resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=90)
            resp.raise_for_status()
            break
        except requests.RequestException:
            if attempt == retries:
                raise
            time.sleep(2 * (attempt + 1))
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error", {}).get("message", f"{path} did not complete"))
    # Documented shape is outputs[0].data; also accept a top-level `output`.
    output = body.get("output")
    if output is None and body.get("outputs"):
        output = body["outputs"][0].get("data", {})
    output = output or {}
    status = (output.get("base_resp") or {}).get("status_code", 0)
    if status != 0:
        raise RuntimeError(f"{path}: base_resp.status_code={status}")
    return output
参考页写的是 outputs[0].data,我最后那轮调用也全是这个结构。之所以还兼容顶层 output,是因为 SandBase 其他平台端点返回过这种结构,两路都读更稳。
测试里还有两处细节。星图的每个返回里都带一个 base_resp,正常时 status_code 为 0,所以函数把非 0 当失败处理。重试也不是摆设:下文引用的那轮运行里,有一次 kol-fans-portrait-v1 直接回了 HTTP 错误,提示 upstream error 400: Request failed. Please retry,第二次就成功了(run e5c76e47-6ace-47d8-b2ef-317fef873e74)。
第 1 步:换出星图 kolId
def resolve_kol(keyword: str) -> dict:
    found = call("douyin/search/user-search-v2", {"keyword": keyword, "cursor": 0})
    users = (found.get("data") or {}).get("user_list") or []
    exact = [u for u in users if u.get("nick_name") == keyword]
    if len(exact) != 1:
        # no silent fallback: zero or several exact matches need a human decision
        raise LookupError(f"{keyword}: {len(exact)} exact nickname matches; confirm the account first")
    sec_user_id = exact[0]["user_id"]  # holds a sec_user_id (MS4wLjABAAAA...)
    kol = call("douyin/xingtu/xingtu-kolid-by-sec-user-id", {"sec_user_id": sec_user_id})
    if not kol.get("id"):
        raise LookupError(f"{keyword} is not registered on Xingtu")
    return {"keyword": keyword, "sec_user_id": sec_user_id,
            "kol_id": kol["id"], "nick_name": kol.get("nick_name"), "tag": kol.get("tag")}
以美食视频品牌日食记为例:搜索(run 2bd433e3-58f2-445c-93e8-9299d9d2071d)返回的 user_list 里,user_id 字段装的其实是 sec_user_id。换 id 的调用(run 44a9f085-3832-4b92-a183-d5259d43e059)返回星图记录:
{
  "id": "6677767167234015243",
  "core_user_id": "64117131714",
  "nick_name": "日食记",
  "tag": "美食",
  "base_resp": {"status_code": 0, "status_message": "Success"}
}
这个 id 就是后面所有调用要的 kolId。中国国家地理和一条走同样的路子也都成功了(run a6517c08-7b7d-4c19-b932-f83f4c578a8c、e2c448b7-33ed-49d9-9864-cebad3305633)。
为什么不直接搜星图?douyin/xingtu/search-kol-v2 传 keyword 就能返回带 kolId 的 authors,能用。但搜「一条」时,第一页把别的达人排在了这个媒体号前面。而且它的请求 schema 里没有翻页参数,返回里却带着含 has_more 的 pagination 对象。相比之下,先搜抖音用户、再按昵称精确匹配更可控。如果你手上已经有 uid 或抖音号,可以用 xingtu-kolid-by-uid、xingtu-kolid-by-unique-id,用法一样。
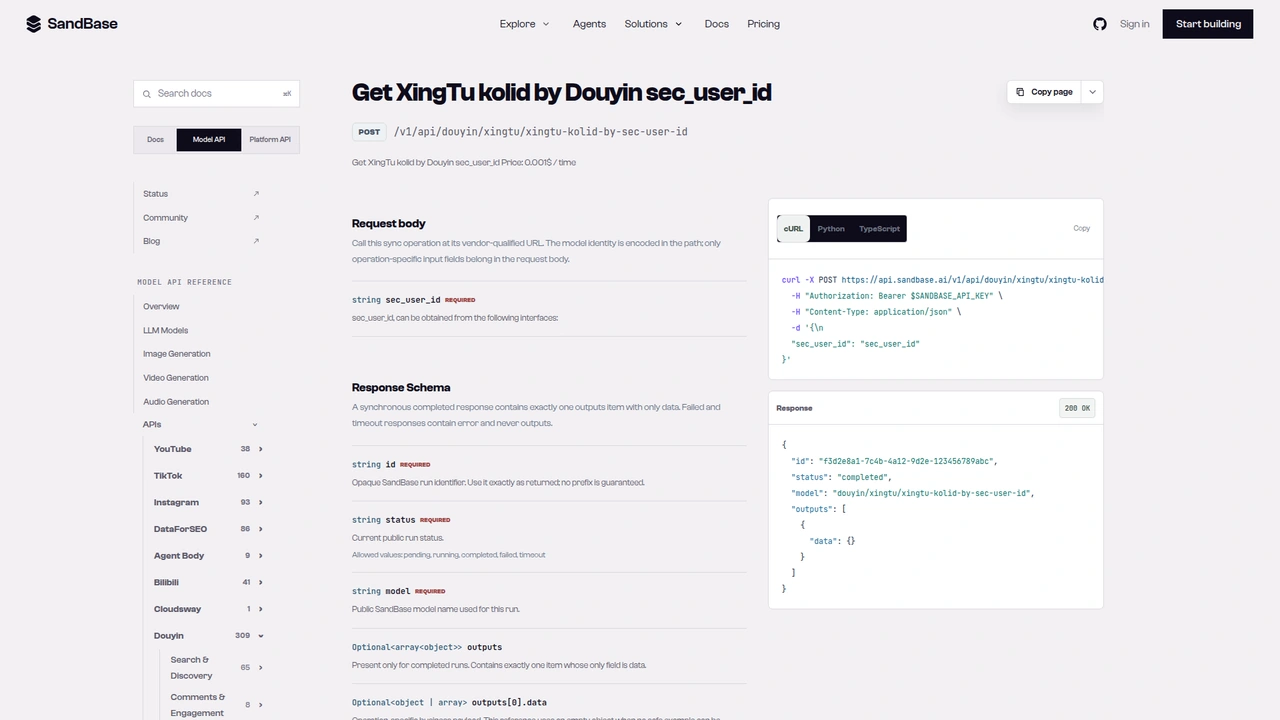
xingtu-kolid-by-sec-user-id 参考页:POST /v1/api/douyin/xingtu/xingtu-kolid-by-sec-user-id,只有一个必填参数 sec_user_id;文档里的响应示例 outputs[0].data 是空的。
第 2 步:基础信息和粉丝画像
def base_info(kol_id: str) -> dict:
    b = call("douyin/xingtu/kol-base-info-v1", {"kolId": kol_id, "platformChannel": "_1"})
    return {
        "followers": b.get("follower"),
        "tags_level_two": b.get("tags_level_two"),       # JSON string in my runs
        "content_themes": (b.get("content_theme_labels") or [])[:5],
        "has_mcn": bool(b.get("mcn_id") and b.get("mcn_id") != "0"),
        "is_star": b.get("is_star"),
    }

def fans_portrait(kol_id: str) -> dict:
    p = call("douyin/xingtu/kol-fans-portrait-v1", {"kolId": kol_id})
    return {d.get("type_display"): d.get("description")
            for d in p.get("distributions", []) if d.get("description")}
platformChannel 是必填,但参考页的说明写到「supports the following parameters:」就断了,没列出取值。我传的是 "_1",也就是抖音短视频渠道;试过 "1",返回一样。其他取值我没验证,参考页补上列表之前,建议就用 _1。
基础信息里有 follower、content_theme_labels、tags_level_two 和 MCN 相关字段。注意 tags、tags_level_two 是 JSON 字符串,不是数组。记录里还有一段 MCN 介绍,可能带商务联系方式,所以函数只留一个「有没有 MCN」的布尔值。做共享报告时也建议这么处理。
粉丝画像返回 distributions 列表,每一项有 type_display 标签、distribution_list 原始键值计数和一句 description。日食记的节选(run e5c76e47-6ace-47d8-b2ef-317fef873e74):
{
  "distributions": [
    {"type_display": "年龄分布", "description": "24到30岁居多,占比30%"},
    {"type_display": "城市等级分布", "description": "一线居多,占比37%"},
    {"type_display": "八大人群分布", "description": "新锐白领居多,占比26%"},
    {"type_display": "性别分布", "description": "男性居多,占比50%"}
  ]
}
这些一句话描述直接塞进 prompt 很方便,但取整很粗。性别那行写着「男性居多,占比 50%」,而 v2 的同类端点 xingtu-v2/author-fans-distribution(run 82bcca0d-4e4b-4b8f-9ca8-75ca62aabdad)给出的原始计数是男 6,169,425、女 6,155,171,基本五五开。如果 brief 很看重性别比例,就自己从 distribution_list 算。
另外还有 kol-audience-portrait-v1,描述的是观众而不是粉丝。日食记的观众(run 1d0456b8-5e68-48ce-9a45-0aac0f434471)更年轻:18~23 岁最多(32%),人群以 Z 世代为首;而粉丝是 24~30 岁、新锐白领居多。这个差异挺有用——它告诉你谁在看,谁在关注。
第 3 步:近期视频表现
def video_performance(kol_id: str) -> dict:
    v = call("douyin/xingtu/kol-video-performance-v1", {"kolId": kol_id, "onlyAssign": False})
    desc = v.get("data_description") or {}
    items = v.get("latest_item_info") or []
    plays = [i.get("play") for i in items if isinstance(i.get("play"), int)]
    sponsored = v.get("latest_star_item_info") or []
    return {
        "play_median": (desc.get("play_medium") or {}).get("rate"),
        "interaction_rate": (desc.get("interaction") or {}).get("rate"),
        "recent_items": len(items),
        "recent_play_median": statistics.median(plays) if plays else None,
        "sponsored_items": len(sponsored),
        "sponsored_play_median": (desc.get("play_medium_enrollment") or {}).get("rate"),
}我看到的返回分三块。data_description 是汇总指标(play_medium、interaction、video_view_rate),每项有一个 rate 和若干对比值;带 _enrollment 后缀的看起来对应星图商单视频。latest_item_info 列出 15 条近期视频,带 play、like、comment、share、duration、item_date。latest_star_item_info 是近期商单视频,结构相同。
日食记(run c6d7e6f1-8615-406c-a776-98266ecf1111)的播放中位数约 179 万,商单视频中位数约 38.6 万。自然和商单的这个落差,是我会第一个拿给品牌方看的数字。
坑在这里:中国国家地理(run c4a11532-3bcb-4fe9-a4f7-e448172bb999)的 data_description 每一项都是空对象,视频列表却好好的。所以函数会从 latest_item_info 自己算 recent_play_median,汇总值一律用 .get() 读。千万别让一个空汇总在对比表里变成 0。
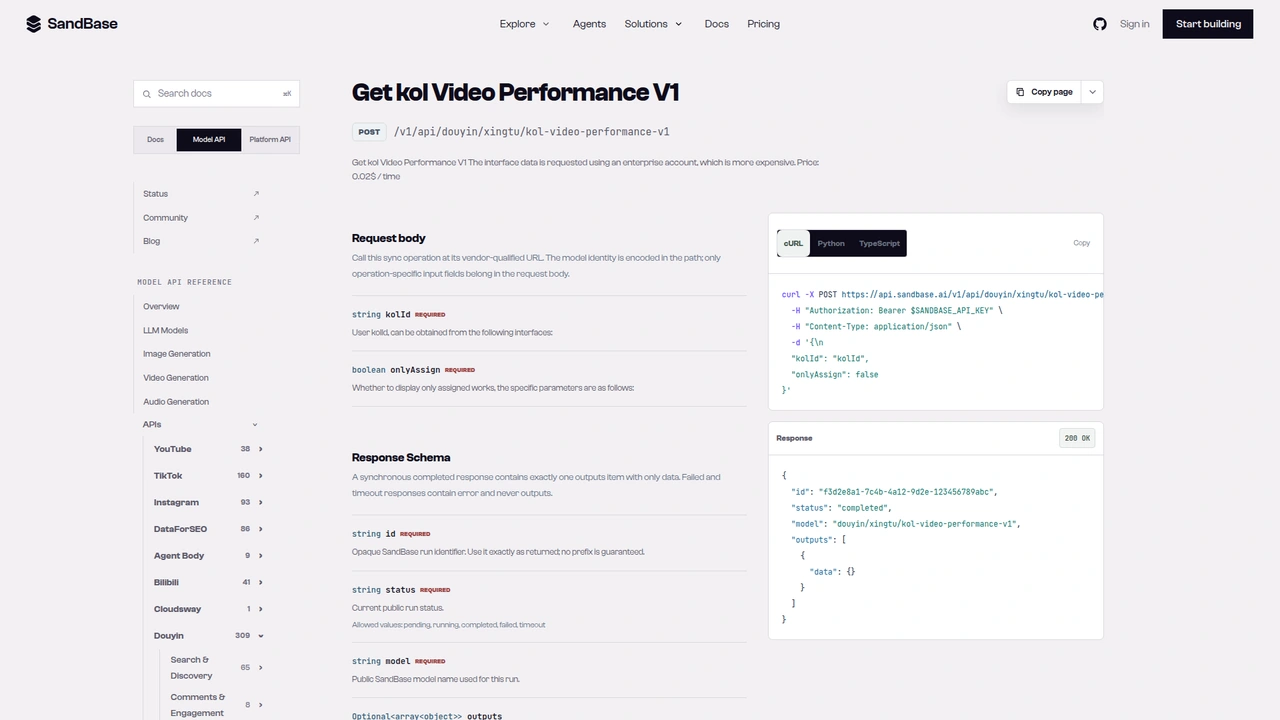
kol-video-performance-v1 参考页:必填 kolId 和布尔值 onlyAssign。和 platformChannel 一样,取值说明写到「as follows:」就截断了。
第 4 步:报价单和成本估算
def pricing(kol_id: str) -> dict:
    p = call("douyin/xingtu/kol-service-price-v1", {"kolId": kol_id, "platformChannel": "_1"})
    card = {x.get("desc"): x.get("price") for x in p.get("price_info", [])
            if x.get("enable") and x.get("task_category") == 1}
    cp = call("douyin/xingtu/kol-cp-info-v1", {"kolId": kol_id})
    return {
        "rate_card": card,
        "industry_tags": p.get("industry_tags", []),
        "expect_vv": (cp.get("expect_vv") or {}).get("value"),
        "expect_cpm_60s": (cp.get("expect_cpm") or {}).get("cpm_60"),
        "expect_cpe_60s": (cp.get("expect_cpe") or {}).get("cpe_60"),
    }
price_info 是服务项列表,每项有 desc(比如植入视频、定制视频)、price、enable、settlement_desc 和 task_category。我看到的返回里,还夹着几项 task_category 不同、价格象征性的广告推送附加项,以及一项没有价格的「按自然播放量结算」。按 enable 加 task_category == 1 过滤,就只剩视频形式本身。
日食记的节选(run 8bc1807b-f27a-4cd6-883a-1d66b8ac5b3d):
{
  "industry_tags": ["食品饮料-水饮冲调", "3C及电器-大家电", "母婴宠物-宠物生活"],
  "price_info": [
    {"desc": "植入视频", "price": 180000, "settlement_desc": "固定价格", "task_category": 1, "enable": true},
    {"desc": "定制视频", "price": 300000, "settlement_desc": "固定价格", "task_category": 1, "enable": true}
  ]
}kol-cp-info-v1(run be7df1c1-692c-427d-9aa9-7ccbd7d26028)返回 expect_vv,以及按 21_60、60 分档的 expect_cpm、expect_cpe。单位文档没写,我自己核了一下:用植入视频价格除以 expect_vv 再乘 100,000,三个号都能精确还原 cpm_21_60。也就是说,这个 CPM 看起来是「每千次预期播放多少分」,植入视频对应 21~60 秒档。60 秒档和定制视频在三个号里对上了两个,日食记没对上。这两点都只是我从数据里推出来的,真要拿 CPM 做决策,建议自己用报价和预期播放算一遍。
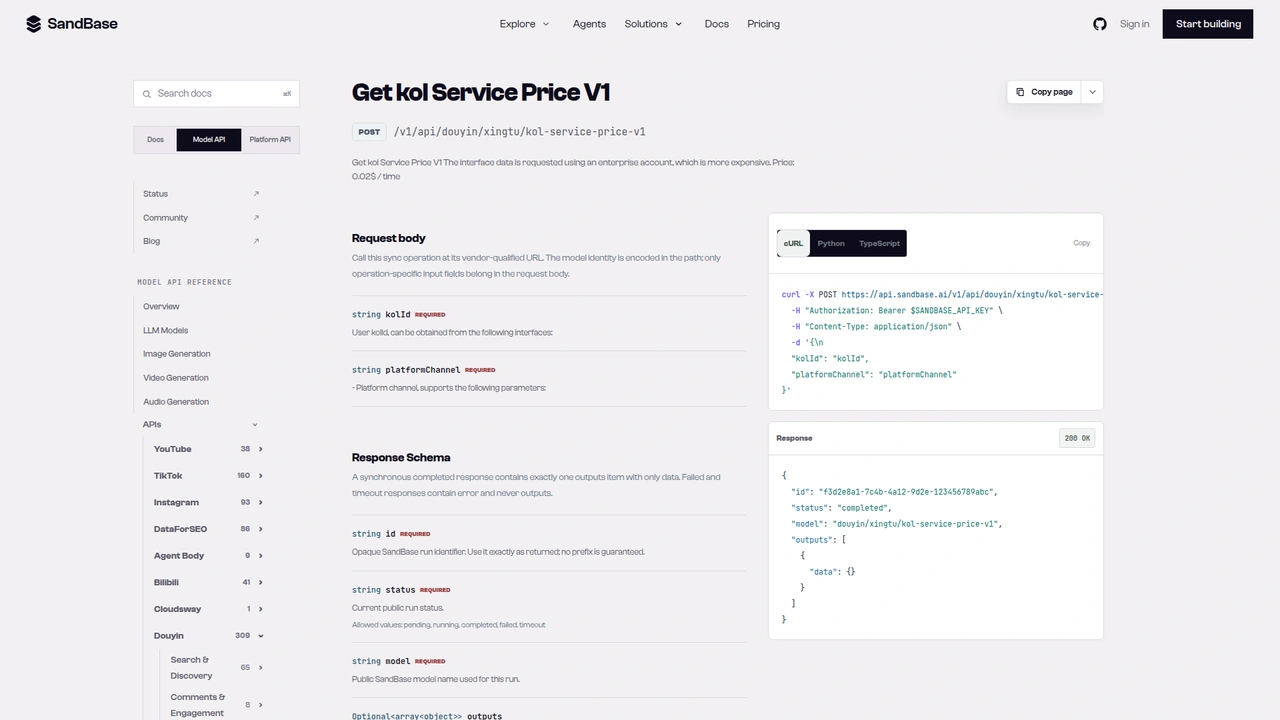
kol-service-price-v1 参考页:POST /v1/api/douyin/xingtu/kol-service-price-v1,必填 kolId 和 platformChannel。描述里另有企业账号说明和一行按次价格;这个端点目前在 SandBase 目录里标的是 Free。
串起来:给候选名单做对比
def evaluate(keywords: list[str]) -> list[dict]:
    rows = []
    for kw in keywords:
        try:
            kol = resolve_kol(kw)
        except (LookupError, RuntimeError) as e:
            print("skip:", kw, e)
            continue
        kid = kol["kol_id"]
        rows.append({**kol, **base_info(kid), "fans": fans_portrait(kid),
                     **video_performance(kid), **pricing(kid)})
    return rows

rows = evaluate(["日食记", "中国国家地理", "一条"])
我拿三个公开媒体品牌号原样跑了一遍,一共 21 次成功调用,外加那一次重试。结果取整如下:
| 账号 | 粉丝 | 近期播放中位数 | 植入视频报价 | 预期播放 | 粉丝画像 |
|---|---|---|---|---|---|
| 日食记(美食) | 约 1,254 万 | 约 414 万(15 条) | 约 18 万元 | 约 311 万 | 24~30 岁,新锐白领 |
| 中国国家地理(自然科学) | 约 564 万 | 约 78 万 | 约 8 千元 | 约 29 万 | 31~40 岁,新锐白领 |
| 一条(人文生活) | 约 666 万 | 约 30 万 | 约 15 万元 | 约 31 万 | 31~40 岁,新锐白领 |
「近期播放中位数」这一列,是我用列出的 15 条视频自己算的,三个号口径一致。它和 play_medium 汇总值(日食记约 179 万)对不上,因为星图汇总用的时间窗口和算法在返回里没有说明。对比时选一种口径,从头用到尾。
单看数字是这样的:中国国家地理的单次预期播放成本最低,而且低得多;日食记覆盖面最大;一条的报价和日食记接近,预期播放却只有它的十分之一左右。但最后拍板的是 brief。比如家居品牌可能还是会选一条,因为它的内容主题有家居装修、家居生活;三个号的 industry_tags 组合也各不相同。把这几行数据连同 brief 一起丢给模型,让它写出引用具体字段的推荐理由,而不是只挑 CPM 最低的那个。
可选:粉丝趋势和 xingtu-v2 系列
kol-daily-fans-v1 接收 kolId、startDate、endDate(格式 yyyy-MM-dd)。日食记 2026-09-01 到 2026-09-28 这段(run f67341bd-80a0-4387-90a5-928d54f669e3)返回 28 个每日 fans_cnt,从约 1,259 万缓慢降到约 1,255 万。为覆盖面付钱之前,粉丝盘子是在涨还是在掉,值得心里有数。
douyin/xingtu-v2 系列覆盖同样的数据,参数是 snake_case。author-base-info、author-fans-distribution、author-spread-info、author-cp-info 都能把同一个 kolId 当 o_author_id 用,我测试时都成功了(run 8cd17f09-cadc-487c-b34d-8a4cf3245497、82bcca0d-4e4b-4b8f-9ca8-75ca62aabdad、59c050f8-3b65-4117-a30d-169c2a6136fa、194b74e9-78f2-4711-9d4e-19bd00b07e51)。author-cp-info 和 kol-cp-info-v1 返回的数值完全一样。两个系列选一个用到底就好。
文档保证 vs. 实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/douyin/xingtu/xingtu-kolid-by-sec-user-id,参数 sec_user_id | 参考页有文档 |
kol-base-info-v1、kol-service-price-v1,参数 kolId + platformChannel | 有文档(渠道取值未列出) |
kol-video-performance-v1,参数 kolId + onlyAssign | 有文档 |
信封 id / status / model / outputs[0].data | 有文档 |
platformChannel: "_1" 对应抖音短视频 | 仅实测 |
base_resp.status_code、换 id 返回的 id 即 kolId | 仅实测 |
distributions[].type_display / description / distribution_list | 仅实测 |
data_description、latest_item_info、latest_star_item_info | 仅实测(有一个号汇总为空) |
price_info[].desc / price / task_category;expect_cpm 单位 | 仅实测;单位为推断 |
典型场景
商单达人初筛
输入 3~10 个候选昵称,输出每个达人一行对比数据。用上面整条链路。
受众匹配检查
拿产品的目标人群去对粉丝画像里的年龄、城市线级、八大人群,再和观众画像比一比,看实际是谁在看。端点:kol-fans-portrait-v1、kol-audience-portrait-v1。
商单播放折损
对比商单视频和自然视频的播放中位数,看一条付费视频大概会少多少覆盖。端点:kol-video-performance-v1。
续约前复盘
续约前拉一下每日粉丝趋势和最新报价单。端点:kol-daily-fans-v1、kol-service-price-v1。
实用提示
kolId换一次就缓存。 同一个号在我所有调用里都没变过。- 昵称要精确匹配。 搜索会带出很多相似账号。以新世相为例,抖音搜索和星图搜索给出的粉丝数也不一样,粉丝数请固定用一个来源。
- 汇总值要防御式读取。
data_description可能是空的,退回原始视频列表。 - 比例敏感时用原始计数,别信一句话描述,性别那个例子就是教训。
- 联系方式别落库。 MCN 介绍里可能有商务联系方式,不要存也不要展示。
- 上游偶发错误要重试。 我那一轮就有一次调用靠第二次才成功。
- 只读公开挂牌数据。 不能下单,也读不到私有投放结果。
常见问题
需要星图广告主账号吗?
不需要。用 SANDBASE_API_KEY 向 SandBase 鉴权即可。真正下单还是要去星图。
收费吗? 本文用到的抖音端点(包括星图这几个)目前在 SandBase 目录里标的是 Free。星图参考页描述里另有一行按次价格,正式使用前请以目录页当前状态为准。
达人没入驻星图怎么办?
换 id 的接口不会返回 id,resolve_kol 抛出 LookupError,evaluate 会跳过这个号。
platformChannel 传什么?
我测试时 "_1"(抖音短视频)可用,"1" 返回相同数据。参考页暂时没列取值。
报价就是最终成交价吗? 那是调用时的挂牌报价,实际成交可能不同,当起点看就好。
写在最后
有一个抖音昵称,就能拼出达人的商业画像:先换出星图 kolId,再读基础信息、粉丝画像、近期表现和报价单,就得到一组可以对着 brief 比较的数据。我测的三个媒体号里,最便宜的覆盖和最大的覆盖落在不同账号上——这正是这套数据要帮你做的取舍。更多抖音端点见 抖音公开数据 API 总览。