抖音榜单 API:读取一次选定榜单,保留指标边界
读取一次抖音高赞榜或综合视频榜,验证嵌套结果,区分历史快照、未解决的时间窗口和增长结论。
抖音榜单的一页数据,可以帮助你查看一组视频,却不能单独回答“相比昨天发生了什么”。接监测任务之前,先弄清选的是哪张榜、实际返回哪一页、指标口径是否已知。本篇准备一次高赞榜或综合视频榜查询,保留返回的 ID 和计数,到这里就停止,不顺带分页、解析链接或建立调度。
2026 年 11 月 8 日这次修订依据当前公开 schema、已有保存响应和离线测试,没有执行新的业务请求。高赞榜保存记录有八条,综合榜保存的是第 20 页、45 条;它们不能证明本轮跑通了首屏,更不是完整的一千条视频集合。
先说结论
- 高赞榜与综合榜二选一;教学请求显式选择 page=1、page_size=10,综合榜另传 sub_type=1001。
- date_window 的默认值与说明冲突,本例省略它,但不声称已验证小时、日或 24 小时窗口。
- 只读 completed 的 outputs[0].data,检查整数 code 为 0,再检查 data.objs 和返回页信息。
- 字符串 ID、原始计数与比率分别保留;数组位置、score 或单次结果都不能证明全局排名和增长。
保留封面是榜单进入 agent 的概念图,其中数字、合成 ID、“canonicalize”阶段与 monitoring 标题都不是接口实测结果,也不代表本轮执行了这条链路。
先选一张榜
| 选定任务 | 当前接口参考 | 教学请求体 |
|---|---|---|
| 查看高赞榜 | 高赞榜接口 | {"page":1,"page_size":10} |
| 查看综合视频榜 | 综合视频榜接口 | {"page":1,"page_size":10,"sub_type":1001} |
这两项是独立选择,不是必须连续执行的两步。当前 schema 各输入字段都是可选的,页码 1 和页大小 10 是与文档默认值一致的本地选择,不是服务端上限,也不是必定返回十条的承诺。高赞榜历史请求体是空对象,返回页信息为 1/10;综合榜保存请求则是 20/50,不能把它的内容标成教学首屏结果。
综合接口还列出 1002 低粉爆款、1003 高完播、1004 高涨粉、1005 高赞率等分类。这些是提供方的筛选标签,不代表本轮验证了相应效果,也不能推定 1005 与独立高赞榜接口返回相同记录。新代码选择综合榜时只用 1001。
keyword 可以用于另行选定的话题过滤。tags 虽声明为对象数组,但对象内部字段未在这里确认,所以不猜造分类对象,也不自动查询标签。未来如果调整筛选,应把设置和结果一起存下,避免把不同条件下的两次结果直接当作同一条时间序列。
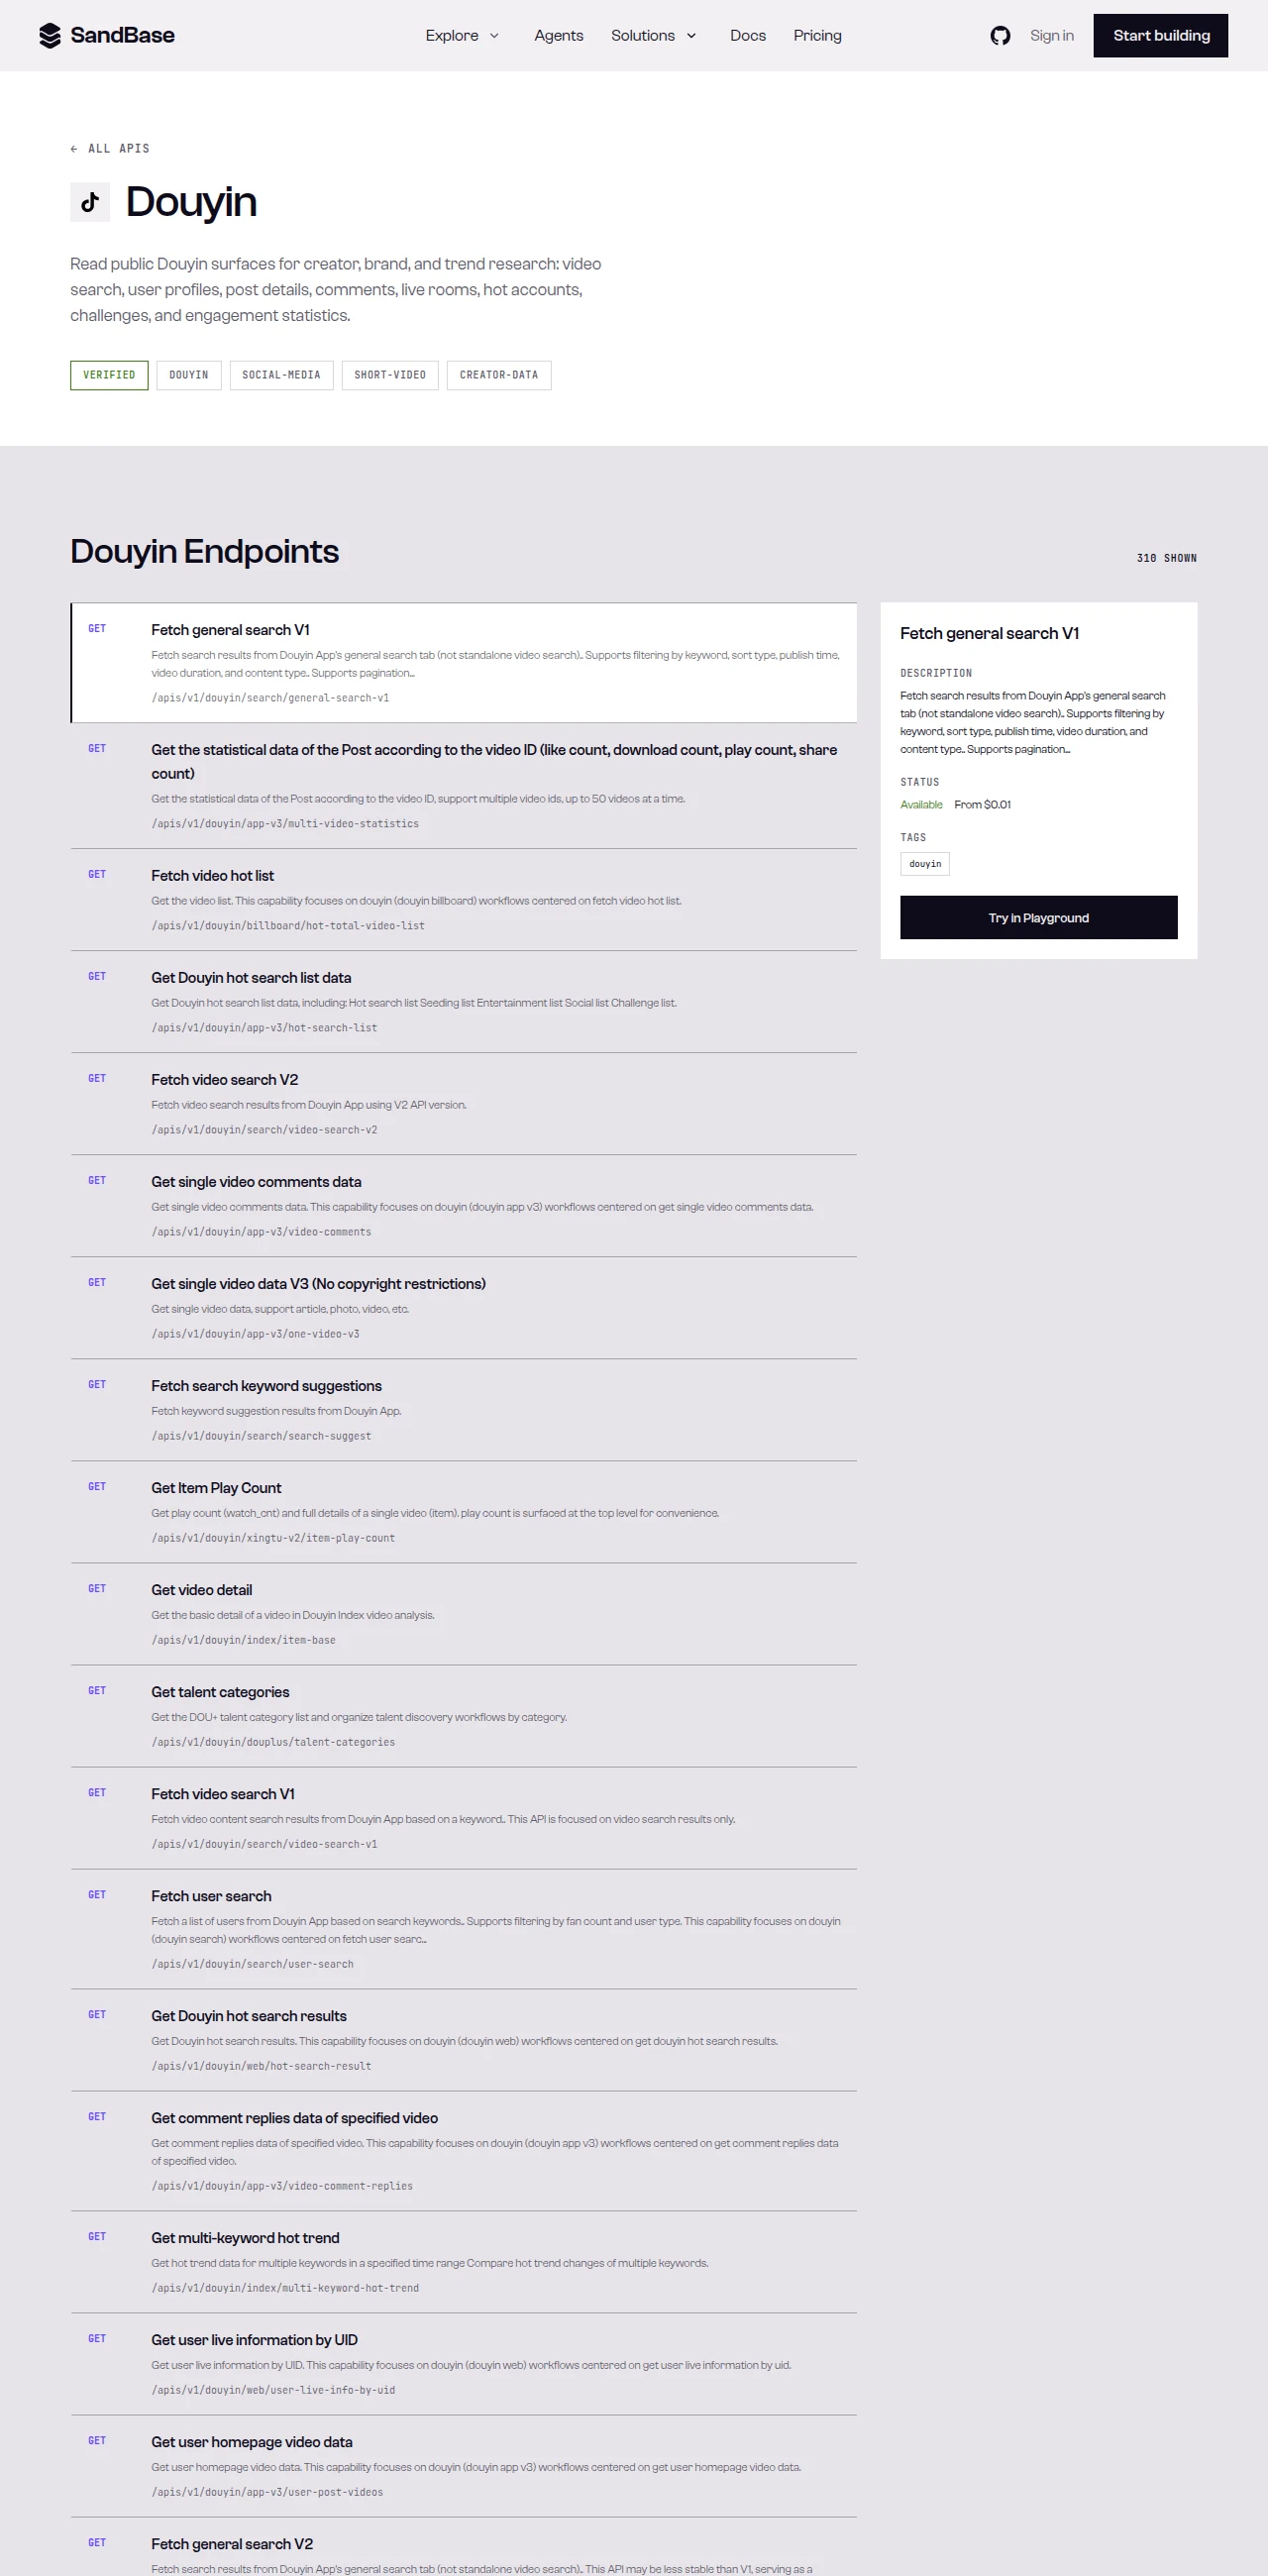 历史抖音目录展示 GET 导航路径、综合视频榜条目和选中的综合搜索面板。图中 From $0.01 属于旧搜索面板,不是本轮每次 $0.001 的两个榜单接口,也不是实际榜单响应。
date_window 的冲突不能靠猜解决
两个 schema 都把 date_window 默认值写成 24,描述却写着 “1 by hour 2 by day”,两份保存输入都没有显式传该字段。因此不能把 24 解释为 24 小时,也不能擅自选 1 或 2 宣称已验证某种时间模式,更不应在客户端悄悄“修正”后端默认值。
本例省略 date_window,只是避免声称支持某个未经确认的值,并没有解决服务端省略字段后的含义。输出应称为“所选提供方榜单快照”,不要标为小时榜或日榜。若业务问题必须依赖精确时间区间,应先澄清这项契约,再用它做跨时间比较。
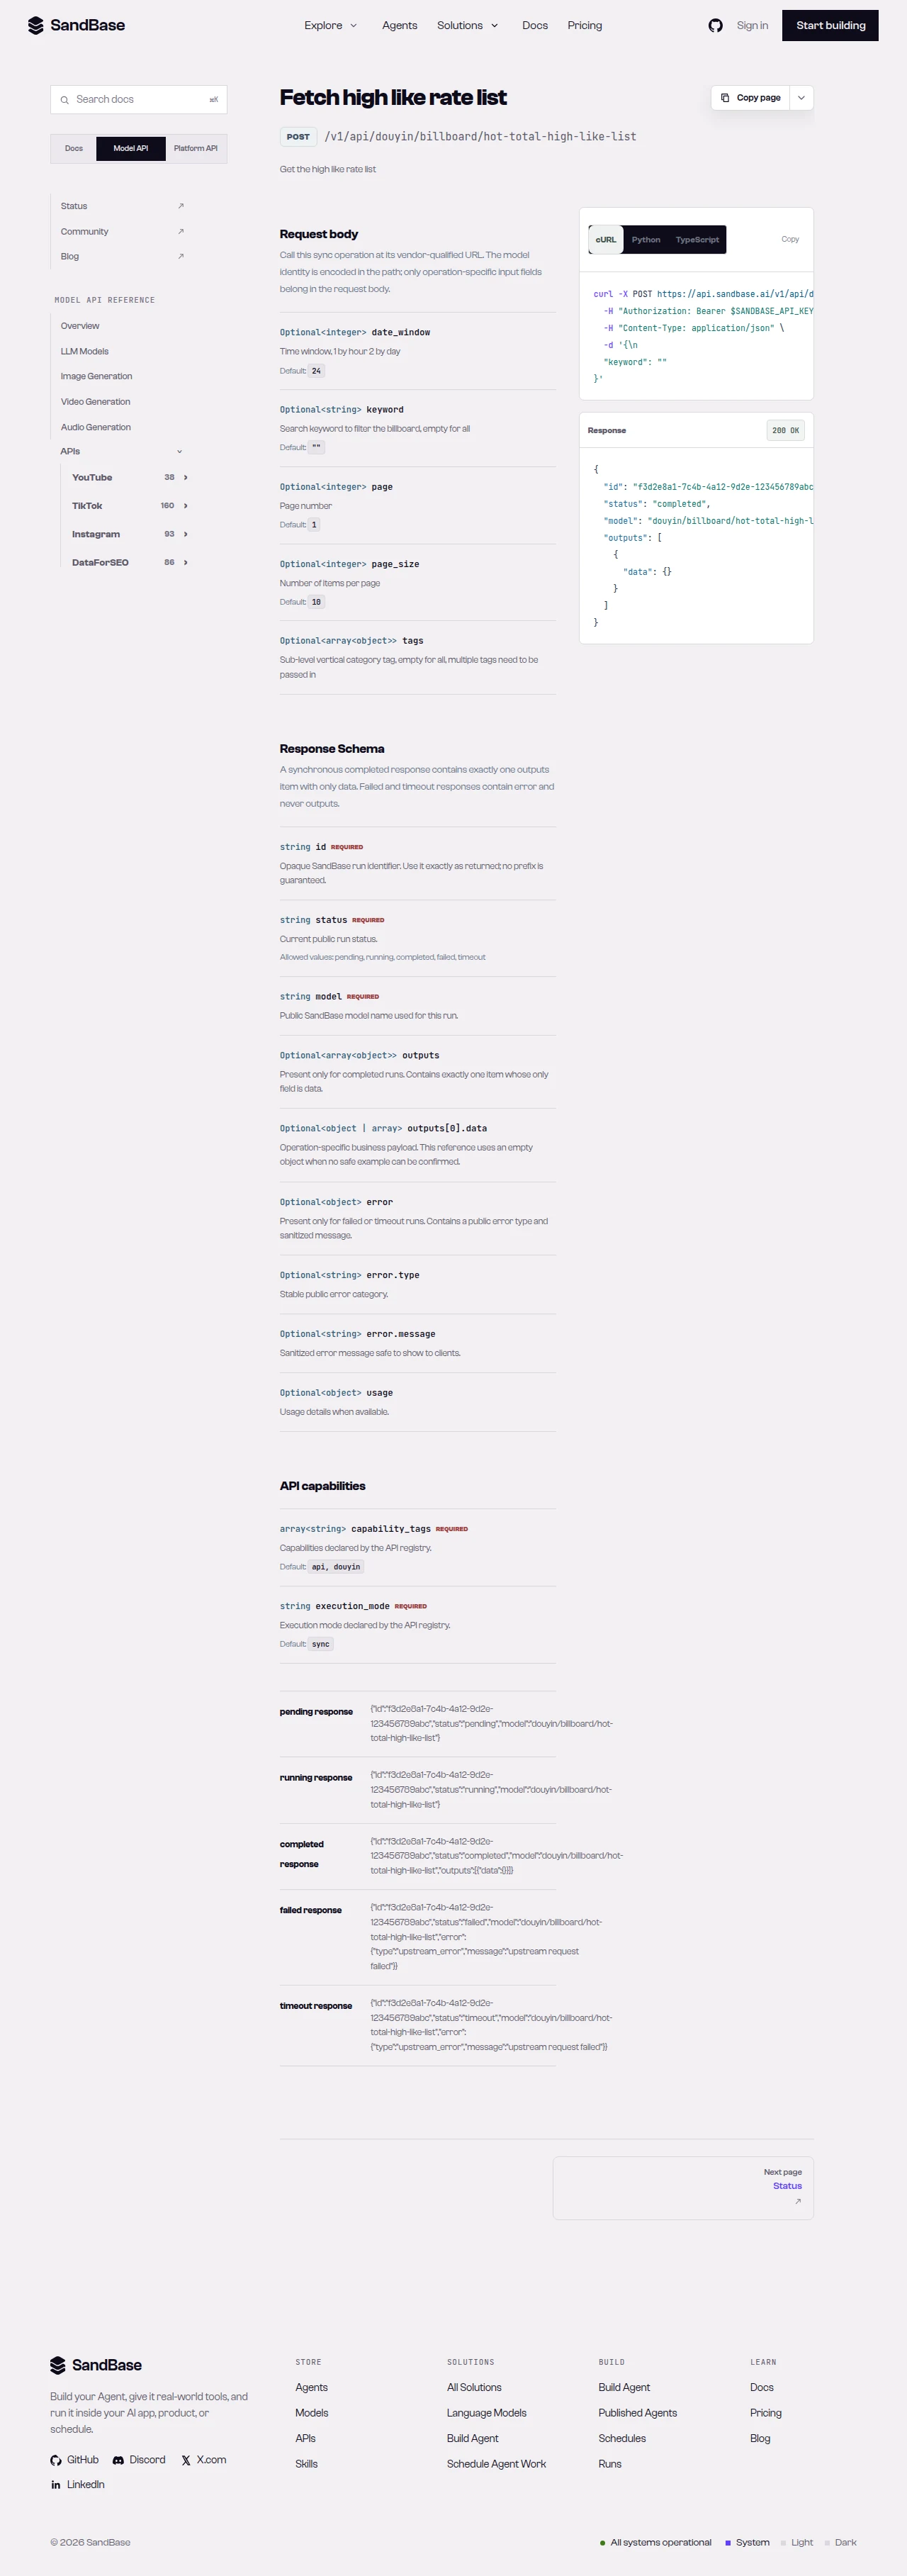 历史高赞榜参数页把 date_window 默认 24 与 1/小时、2/日说明并列展示,生成响应 data 为空。本篇明确保留这个冲突,不把截图当作成功取得榜单的证据。
把任务交给 agent 时说清停止位置
已有 key,就复用项目里的本地 SANDBASE_API_KEY,按需安装 requests。不需要为了另一个端点重建密钥管理,也不要在提示词里粘贴 key,或为排查配置把它输出到终端日志。
agent 已经连接好时,只交代所选榜单、首屏范围和停止条件:准备一次请求,验证数据,保留原始字段名,然后停止。不要只说“帮我监测趋势”,却没有明确时间窗口、状态存储和预算;那会让一个简单读取变成没有边界的连续调用。
新项目可把 setup skill 与 Markdown quickstart 交给 agent。例如:“复用我的本地 key,实现并测试一次高赞榜 page=1、page_size=10 请求。省略 date_window 并说明未解决的时间窗口,不调用解析器、不抓媒体、不翻页、不安装定时任务。”需要综合榜时,明确换成该任务。
11 月 8 日 inspect 中,两端点都标价每次 0.001 美元,符合组织共享每日 100 次合资格调用额度,UTC 00:00 重置。资格不是余额,也不能证明下一次免费。选一次标价 0.001 美元,明确各选一次则抵扣前合计 0.002 美元。本轮没有查看实际扣费或重新测量上游可用性。
Python:只验证选中的一次响应
这里使用 Model API 的 POST /v1/api 路由,不是目录页展示的 GET。模型已经编码在路径中,请求体只放操作参数。下面只发一次请求,没有自动重试。
import os
import re
import requests

API = "https://api.sandbase.ai/v1/api/douyin/billboard"


def parse_board(body):
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("SandBase request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Missing documented outputs[0]")
    payload = outputs[0].get("data")
    if not isinstance(payload, dict):
        raise RuntimeError("Missing documented outputs[0].data object")
    if type(payload.get("code")) is not int or payload["code"] != 0:
        raise RuntimeError("Douyin board result is not integer code zero")
    data = payload.get("data")
    if not isinstance(data, dict):
        raise RuntimeError("Missing board data object")
    rows, page = data.get("objs"), data.get("page")
    if not isinstance(rows, list) or any(not isinstance(row, dict) for row in rows):
        raise RuntimeError("Missing or malformed board objs array")
    for row in rows:
        if not isinstance(row.get("item_id"), str) or not re.fullmatch(r"[0-9]+", row["item_id"]):
            raise RuntimeError("Expected an unchanged decimal string item_id")
    if (not isinstance(page, dict)
            or any(type(page.get(k)) is not int for k in ("page", "page_size", "total"))
            or page["page"] < 1 or page["page_size"] < 1 or page["total"] < 0):
        raise RuntimeError("Missing or malformed board page metadata")
    return payload


def first_request(board):
    if board == "high_like":
        route = "hot-total-high-like-list"
        params = {"page": 1, "page_size": 10}
    elif board == "overall":
        route = "hot-total-video-list"
        params = {"page": 1, "page_size": 10, "sub_type": 1001}
    else:
        raise ValueError("Choose high_like or overall")
    # date_window deliberately omitted: its default and description conflict.
    key = os.environ.get("SANDBASE_API_KEY", "").strip()
    if not key:
        raise ValueError("Set SANDBASE_API_KEY locally")
    try:
        response = requests.post(
            f"{API}/{route}",
            headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
            json=params, timeout=(10, 90), allow_redirects=False,
        )
        if not 200 <= response.status_code < 300:
            raise RuntimeError(f"SandBase HTTP {response.status_code}; request stopped")
        body = response.json()
    except requests.RequestException:
        raise RuntimeError("Network request failed; no automatic retry made") from None
    except ValueError:
        raise RuntimeError("SandBase returned invalid JSON") from None
    payload = parse_board(body)
    page = payload["data"]["page"]
    if page["page"] != 1 or page["page_size"] != 10:
        raise RuntimeError("Returned page metadata differs from the selected first request")
    return payload


if __name__ == "__main__":
    result = first_request("high_like")
    print("Returned records:", len(result["data"]["objs"]))
若要综合榜,把 main 中的 result = first_request("high_like") 替换为 result = first_request("overall"),不要在后面追加第二次调用。正数页信息和十进制字符串 ID 检查是本任务针对参考结构的保守本地约束,不是所有提供方数据的通用定义。可选计数和标记原样返回,不补零。
parse_board 可以检查任何正页码的保存信封;first_request 还要求返回 page/page_size 与它选择的首屏一致。这样离线测试可以解析真实第 20 页保存结果,同时正确拒绝把它当成 page=1 新请求的成功返回,不需要篡改旧页码来制造通过。
外层 completed 不够:数组缺失、上游非零 code、内部对象错误都要报错。严格整数检查也避免 Python 把 False 等同于 0。两份保存成功响应的 message 为空,所以不强制它等于猜测的 success。明确存在的空 objs 是合法空页,却不能证明整个榜没有其他内容。
HTTP 错误、重定向、无效 JSON、未完成状态、超时和页信息不一致都会停止。错误信息不打印上游正文、签名 URL 或密钥。超时的实际结果尚不确定,是否再次请求需要另查原因和计费,不能隐含在循环里。
两份保存榜单分别说明什么
高赞榜保存样本 9b892f8c-413f-4e67-9078-82537434c27e 创建于 2026 年 10 月 7 日 17:37:02.062 UTC,输入为 {}。可见捕获有八条,page/page_size/total 为 1/10/1000。以下按原值截取首条记录,不展示签名媒体地址:
{
  "item_id": "7692681489309628406",
  "like_cnt": 1218230,
  "play_cnt": 13545023,
  "like_rate": 0.089939,
  "fans_cnt": 7287,
  "follow_cnt": 3774,
  "follow_rate": 0.00029,
  "score": 1215906,
  "publish_time": 1791091983,
  "item_duration": 13652
}
综合榜样本 7358df41-8bd6-4d24-96cb-f06606135dcb 创建于同日 17:37:33.175 UTC,输入包含空 keyword、page=20、page_size=50、sub_type=1001、空 tags。捕获有 45 条,页信息是 20/50/1000。首条捕获记录如下:
{
  "item_id": "7692701792556425715",
  "like_cnt": 436943,
  "play_cnt": 13576423,
  "like_rate": 0.032184,
  "fans_cnt": 36229536,
  "follow_cnt": 8327,
  "follow_rate": 0.00062,
  "score": 193300,
  "publish_time": 1791104400,
  "item_duration": 260800
}
八条不等于十条,45 条也不等于 50 条,这只是保存捕获的实际数量,本轮不推断短缺原因、不补造缺少的行。total=1000 是提供方报告的数量,不能证明一千条都能取到、之前的页都走过,或覆盖了抖音所有内容。尤其第 20 页的第一条,不能用数组下标加一标成全局第一名。
两段 README 短例分别显示另一个 ID:7703456989958999305 和 7702397404621350821,页信息都是 1/10。它们是无日期的裁剪参考,与完整保存捕获分开测试;展示一条不代表整页只有一条,也没有证据证明本次执行了教学首屏。
指标和时间不要混算
like_cnt、play_cnt、like_rate、fans_cnt、follow_cnt、follow_rate、score 应各自按源字段存储。比率与原始计数分开保留,本篇不提出权威公式、分母或统计区间。follow_cnt 的含义没有独立核实为账号关注总量或净涨粉;score 也不等于可复现的排序算法。
publish_time 文档标为 Unix 秒,但 extra.now 的提供方时钟、保存样本日期、应用实际观察时间是不同信息,不能互相替换。item_duration 的单位未独立确认,不按数字量级猜成毫秒或自行换算秒数。
昵称、头像、粉丝相关计数都是提供方报告的信息,不是身份认证、独立受众或长期质量的证明。收藏标记是返回状态,也不是授权执行收藏。其他字段出现零,不意味着缺失项也可以补零。只上榜一次更不能证明持续趋势或增长原因。
为什么不再自动解析链接和轮询
榜单已经给出完整字符串 item_id。item_url 与封面链接可能是有过期时间的签名媒体引用,未证实它们就是解析器接受的分享链接。本次不下载、不解析,也没有获得媒体复用权;大数字 ID 必须保留字符串精度。
9 月 27 日旧代码对每条记录调解析器,再用内存 SEEN 集合过滤。内存集合只在当前进程中记住已见 ID,进程重启就丢失,也不会报告旧 ID 上计数的变化。因此原来的“每次定时执行只输出变化”承诺不成立。六段中英 Python 已原样保存在 历史代码与哈希归档,用于追溯,不作为现行接入方式。
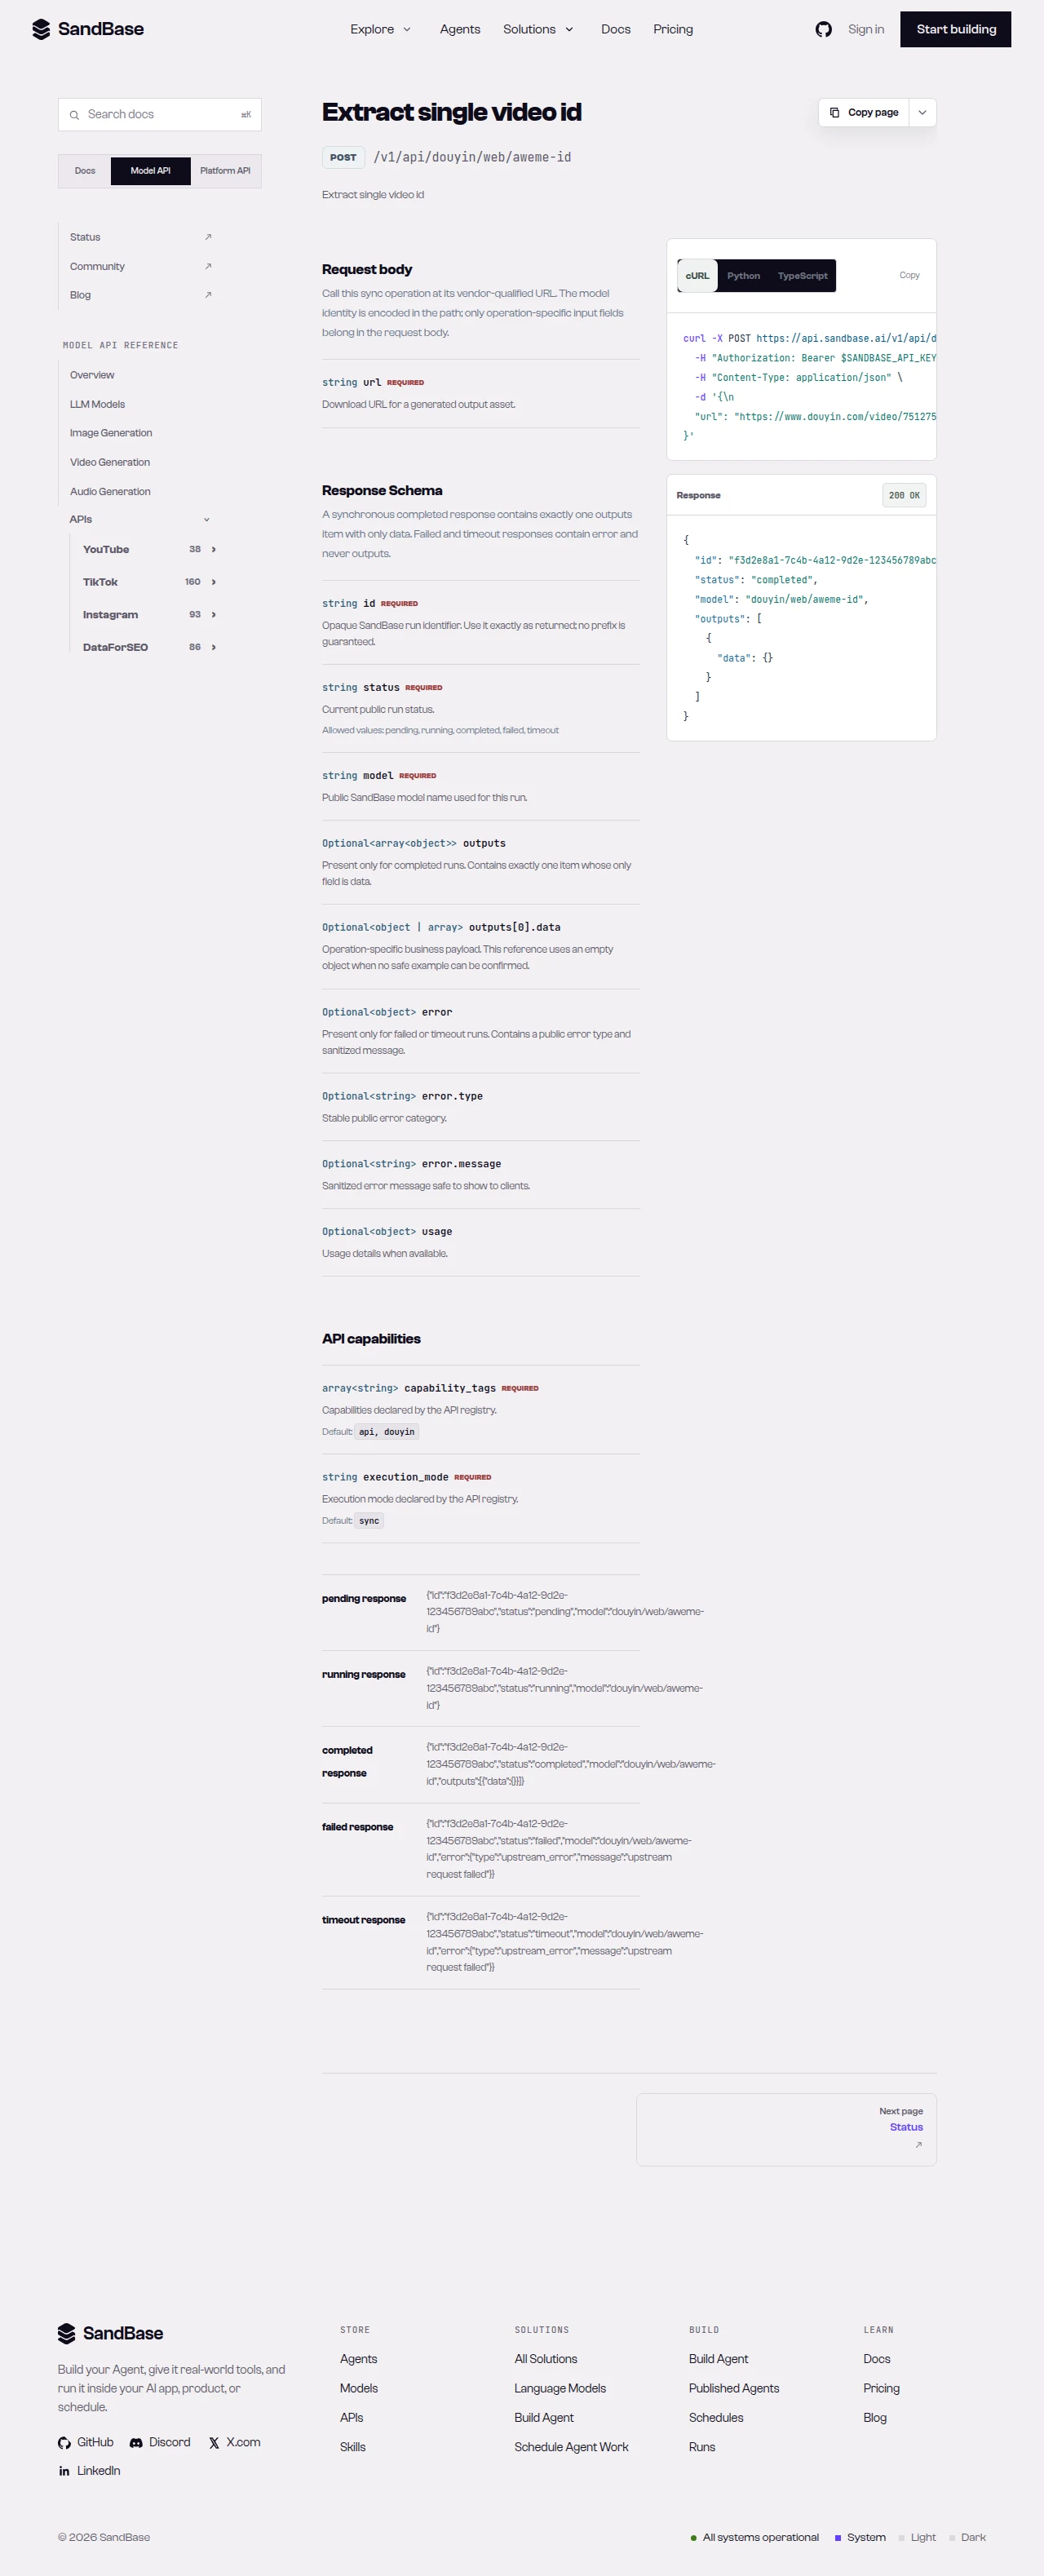 历史 aweme-id 参数参考展示 URL 输入和空的生成响应。解析器不在本轮范围内,图片不能证明榜单签名媒体地址可作为输入,也不能证明解析链路成功。
下方原 JSON 保持示意性质,包括 run 形状 ID d4727a3b-18ea-403d-b90b-db093210ecac。它没有对应的实测日期,不能替代上面独立的保存样本。
{
  "id": "d4727a3b-18ea-403d-b90b-db093210ecac",
  "status": "completed",
  "model": "douyin/billboard/hot-total-high-like-list",
  "outputs": [
    {
      "data": {
        "code": 0,
        "data": {
          "objs": [
            { "item_id": "…", "item_title": "…", "nick_name": "…", "like_cnt": 0, "item_url": "…" }
          ]
        }
      }
    }
  ]
}
常见问题
可以把结果标为“最近 24 小时”吗? 不可以。默认值与说明冲突尚未澄清,省略字段也不能证明时间区间。需要时间对比时,应先独立确认契约。
page_size=10 一定返回十条吗? 不是。高赞榜保存捕获只有八条。保留真实行数、返回页信息和上下文,不插空记录,也不要为了凑十条自动继续下一页。
这些计数能立刻做涨粉告警吗? 还需要可比较的榜单条件、观察时间、持久化状态、去重策略和有上限的轮询预算。一张快照不能验证这套设计,本文不建立调度或执行续页。
其他能力可查 抖音 API 导航;如果已选定的是创作者而非榜单,使用独立的 账号资料与投稿教程。先把这次选择、实际返回页和未知指标解释清楚,再考虑扩展。
觉得有用?分享给更多人