DeepSeek V4.1-Flash-1017:这次 10 月更新改了什么
2026 年 10 月 17 日,DeepSeek-V4.1-Flash-1017 直接升级进 deepseek-flash:价格不变、跑分更高、输出更短。改了什么、哪里领先、哪里仍不如 Opus 5。
2026 年 10 月 17 日,DeepSeek 上线了一个新模型。如果你的配置文件里写的是 deepseek-flash,那你其实已经在用它了。没有新模型名、没有迁移步骤、价格也没动。DeepSeek 把 V4.1-Flash-1017 称为”小版本更新”,但跑分的提升一点都不小:Terminal-Bench 4.0 从 31.2 涨到 42.3,ProgramBench 从 20.3 涨到 29.1,而这一切都发生在你昨天就在调用的那个 API 名字里面。
对任何把 agent 跑在生产环境里的人来说,这才是这次发布的重点:一个你没有主动选择的 checkpoint 正在回答你的请求,而且按 DeepSeek 自己的数据,它的推理方式和它取代的 9 月版 V4.1 Flash 不一样——更快、输出更短。这篇文章讲清楚:到底改了什么、哪些跑分动了、它在同类模型里哪里领先哪里仍落后,以及在你把这些收益当成自己的之前该先核对什么。文中所有数字都是厂商自测结果,我没有复现 DeepSeek 的基准测试。
先说结论
deepseek-flash现在在 DeepSeek 的网页、App 和 API 上都指向 DeepSeek-V4.1-Flash-1017。调用方式和价格都没变,现有代码无需改动即可用上。- 相比 9 月版 V4.1 Flash,DeepSeek 公布的每一项跑分都在涨:DeepSWE v1.1 从 74.2 到 77.0,Terminal-Bench 4.0 从 31.2 到 42.3,Apex Bench v1.1 从 64.6 到 72.1。
- 它还”降低了任务用时和输出长度”——这才是省钱的那一部分:每个完成的任务用的输出 token 更少,而不是单价更低。
- 和更大的模型比则有强有弱:1017 在 Terminal-Bench 4.0 和 DeepSWE 上领先,但 Claude Opus 5 在 HLE(56.3 对 42.6)、ProgramBench、NL2Repo-Bench 上更强。
- 权重以 MIT 协议开源在 Hugging Face 和 ModelScope 上。本次发布的技术报告标题是《Pushing the Limits of KV Cache Compression》。
这是一次你不用主动”同意”的更新
DeepSeek 更新日志 对机制说得很直白:V4.1 Flash “已升级为 DeepSeek-V4.1-Flash-1017”,网页和 App 模型也一并更新,“API 调用方式和价格保持不变——直接用 deepseek-flash 即可访问最新模型”。9 月已经退役的旧名字 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 同样路由到这里。
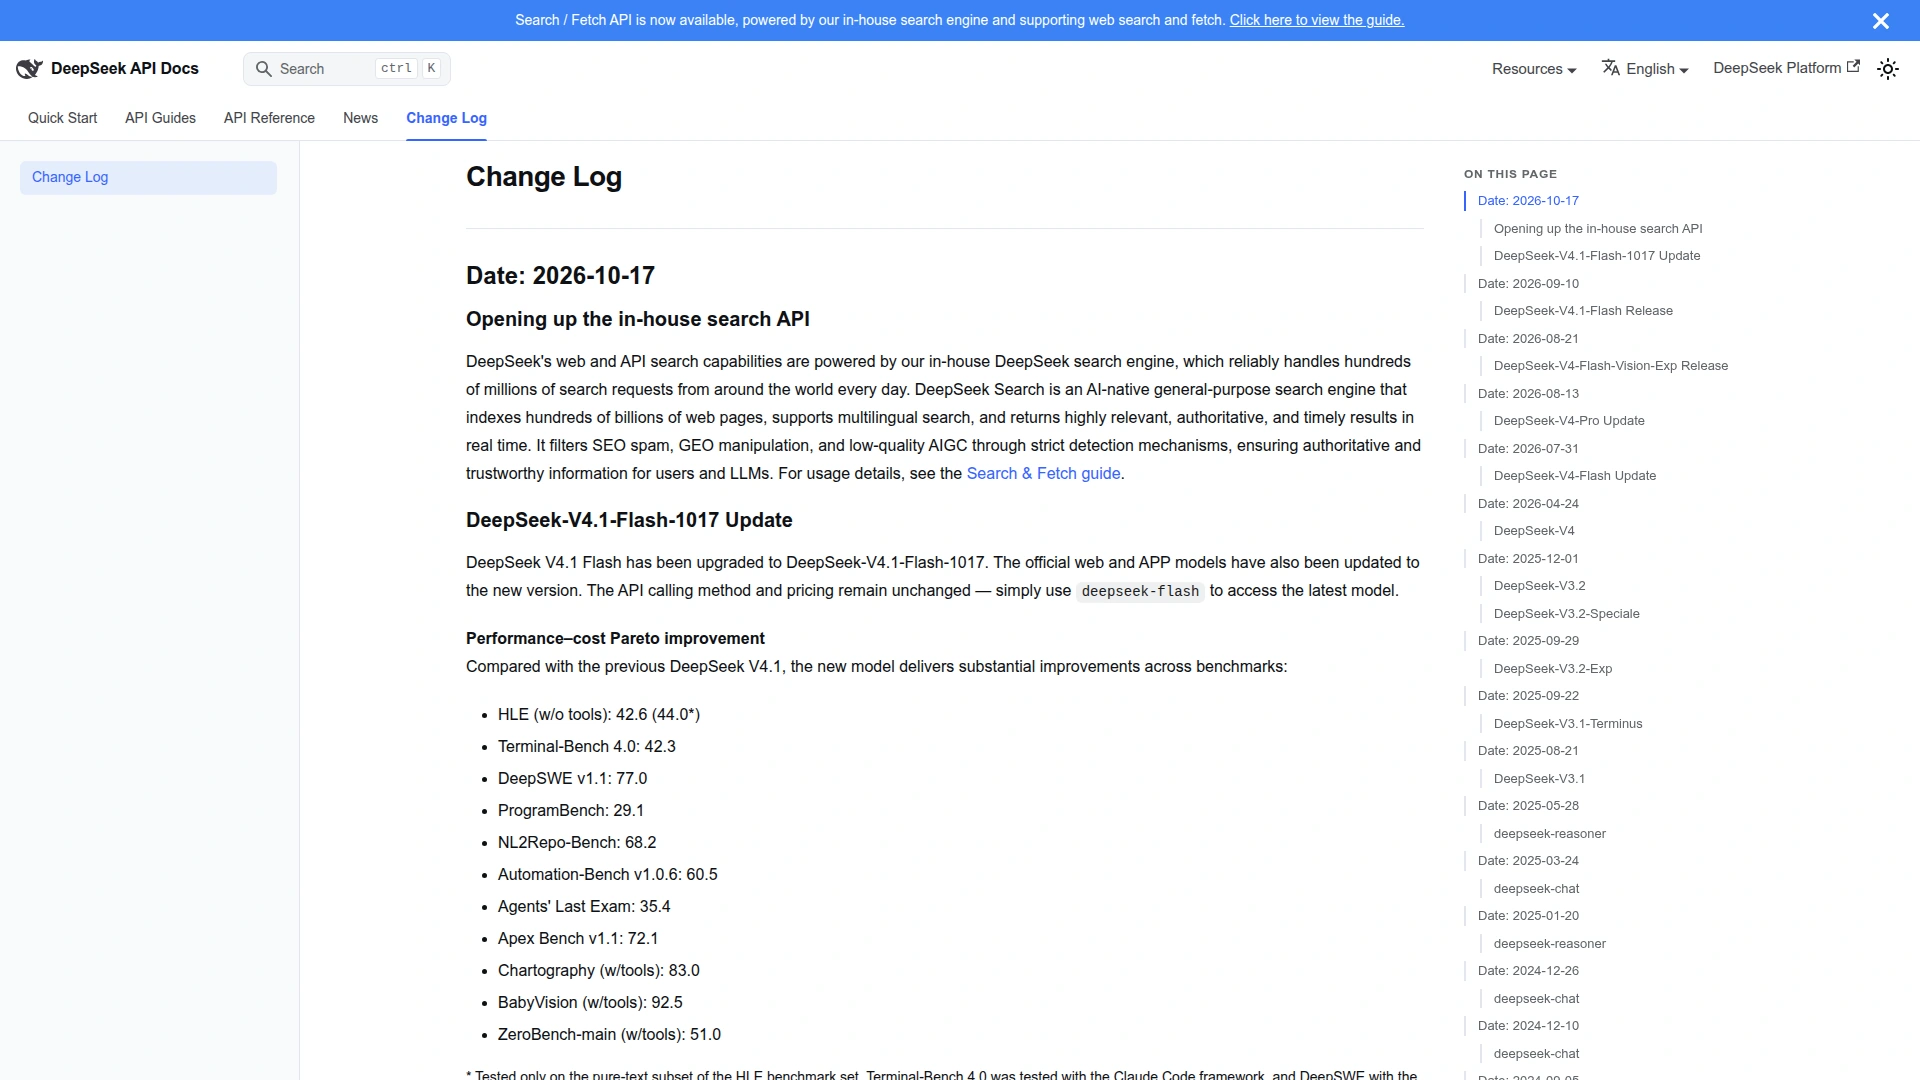 DeepSeek 官方更新日志把 10 月 17 日的升级直接绑定到
deepseek-flash 名字上,并列出新的跑分(截图于 2026-10-17)。
这件事方便又有点让人不安。方便是因为完全不用迁移;不安是因为一个回答你 prompt 的模型,在一个你一直当作稳定的名字下面被换掉了,而 9 月到 10 月的行为差异大到值得当回事。如果你有 golden output、回归测试,或者一套针对旧 Flash 调好的 prompt,今天该做的是拿新 checkpoint 重跑这些检查,而不是因为”小版本更新”这个标签就假设变化很小。关于”不带版本号的名字并不等于锁定版本”,V4.1 Flash 与 V4 Pro 对比 里讲得更细。
如果你需要锁定某个 checkpoint,开源权重就是出路:DeepSeek-V4.1-Flash-1017 已经以 MIT 协议发布在 Hugging Face 和 ModelScope 上,你可以自己托管一个确定的版本,防止将来某个”1118”再在你脚下换掉。
跑分到底说了什么
DeepSeek 把 1017 定位成一次”性能—成本”帕累托改进:既跑分更高,又回答更短更快。下面是官方公布的、对比它所取代模型的分数。
| 基准 | V4.1-Flash-1017 | V4.1-Flash(9 月) |
|---|---|---|
| HLE(无工具) | 42.6(纯文本 44.0) | 36.8(纯文本 39.1) |
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 |
| Agents’ Last Exam | 35.4 | 31.8 |
| Apex Bench v1.1 | 72.1 | 64.6 |
| Chartography(含工具) | 83.0 | 78.9 |
| BabyVision(含工具) | 92.5 | 89.6 |
| ZeroBench-main(含工具) | 51.0 | 49.0 |
涨幅最大的两项都是 agent 编码类分数:Terminal-Bench 4.0 涨了 11.1 分,ProgramBench 涨了 8.8 分。DeepSeek 也说明了测试设置:Terminal-Bench 4.0 用的是 Claude Code 框架,DeepSWE 用 Mini-SWE-V2 harness,ZeroBench-main 用 Pass@5,括号里的 HLE 是纯文本子集。这些都是依赖 harness 的结果,提醒你:最终拿到的分数取决于你把模型放进哪种脚手架里跑,而不只是权重本身。
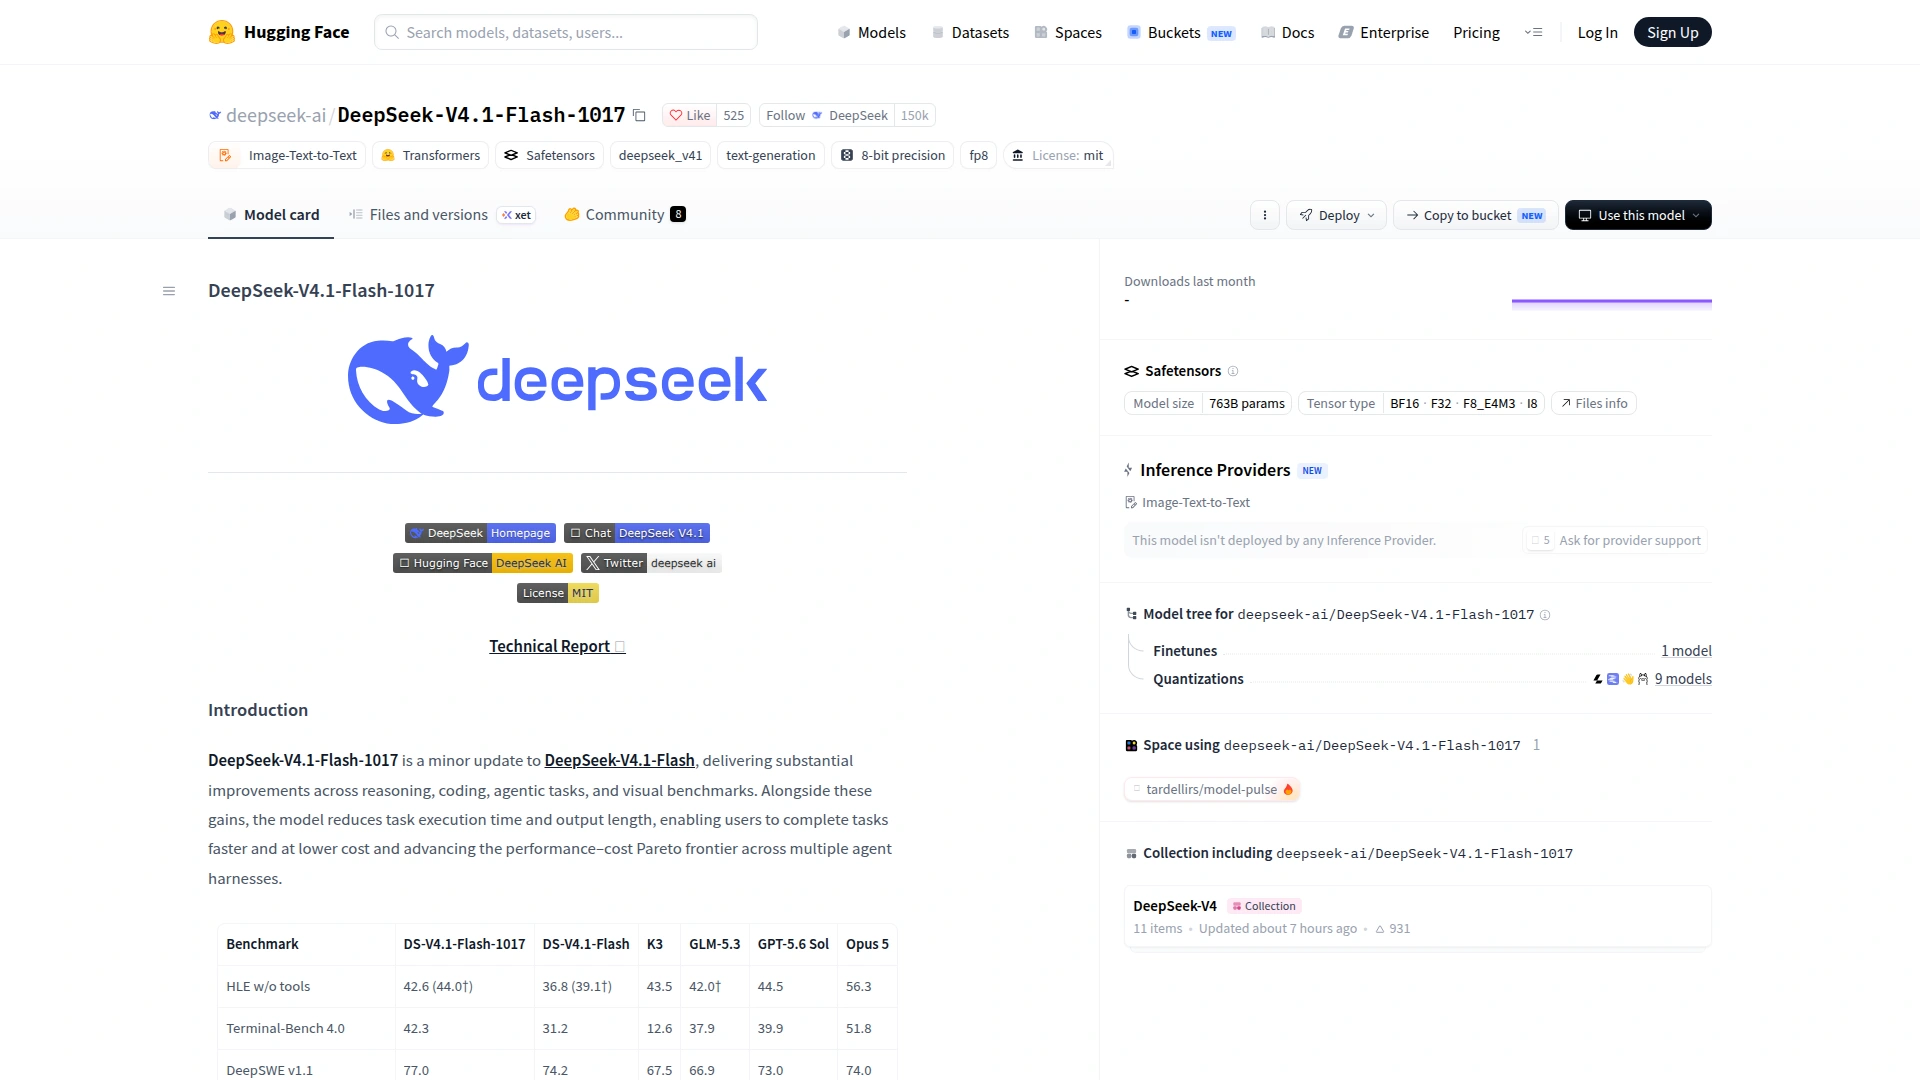 Hugging Face 模型卡显示 763B 总参数、MIT 协议,以及 DeepSeek 公布的同一张对比表,含同类模型各列(截图于 2026-10-17)。
哪里领先,哪里仍是 Opus 5 赢
DeepSeek 的发布说明和模型卡把 1017 和另外四个模型放在一起:Kimi K3、GLM-5.3、GPT-5.6 Sol、Claude Opus 5。横着读这张表,结论是具体的,而不是一边倒。
| 基准 | 1017 | Kimi K3 | GLM-5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 12.6 | 37.9 | 39.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 67.5 | 66.9 | 73.0 | 74.0 |
| Apex Bench v1.1 | 72.1 | 47.8 | 56.6 | 54.3 | 65.8 |
| HLE(无工具) | 42.6 | 43.5 | 42.0 | 44.5 | 56.3 |
| ProgramBench | 29.1 | 17.5 | 19.0 | 23.0 | 37.0 |
| NL2Repo-Bench | 68.2 | 58.0 | 58.0 | 56.8 | 75.3 |
在 DeepSWE v1.1 和 Apex Bench 上,1017 拿到了组内最高分,甚至压过 Claude Opus 5——对一个价格只有 Opus 零头的模型来说,这很说明问题。在 Terminal-Bench 4.0 上,它除了 Opus 5 以外全部领先。但该有差距的地方差距是真的:Opus 5 在 HLE 上领先近 14 分,在 ProgramBench 和 NL2Repo-Bench 上也明显更强。如果你的任务偏向广义知识推理(HLE)或仓库级代码合成(NL2Repo),在这些测试上更大的模型依然更好,而且是可量化的更好。
坦白讲:1017 是终端类、SWE 类 agent 循环里一个很强的性价比选择,但在最难的推理和整仓库任务上还是落后一档。这是按任务判断,不是排行榜名次,也正是值得你用自己的 prompt 去确认的那种事——Python API 教程 给出了一个可复现的方法来做这件事。
解释”输出更短”的那条架构说明
1017 的技术报告标题是《Pushing the Limits of KV Cache Compression》,这个主题正好对应那条实用的说法。V4.1 Flash 是一个基于 Causal Encoder-Decoder 设计的 MoE 模型:读取输入时激活约 8B 参数,生成输出时激活约 16B,KV 缓存大约只有上一代 Flash 的四分之一——这是 SandBase 模型页 上呈现的 DeepSeek 架构描述。Hugging Face 上则把完整模型标为 763B 参数。压缩后的 KV 缓存,正是让 1M token 上下文仍然用得起的原因;而更短的输出,意味着每个完成的任务计费的输出 token 更少。
这就是”更低成本、更高速度”背后的机制。它不是降价——单价和 9 月完全一样,而是模型用更少的 token 把任务做完。只有当你的任务此前把 token 花在了长推理链上,这一点才会体现为省钱。对一个本来就以输入 token 为主的工作负载,输出变短几乎不会影响账单。
价格:上游不变,SandBase 今天有折扣
这次发布没有改 deepseek-flash 的官方价格:高峰时段每百万未命中缓存输入 token 0.30 美元、输出 token 1.20 美元,命中缓存的输入 0.006 美元(低峰减半,所以命中缓存的输入低峰是 0.003 美元)。这些是 DeepSeek 模型与价格页 上的数字。
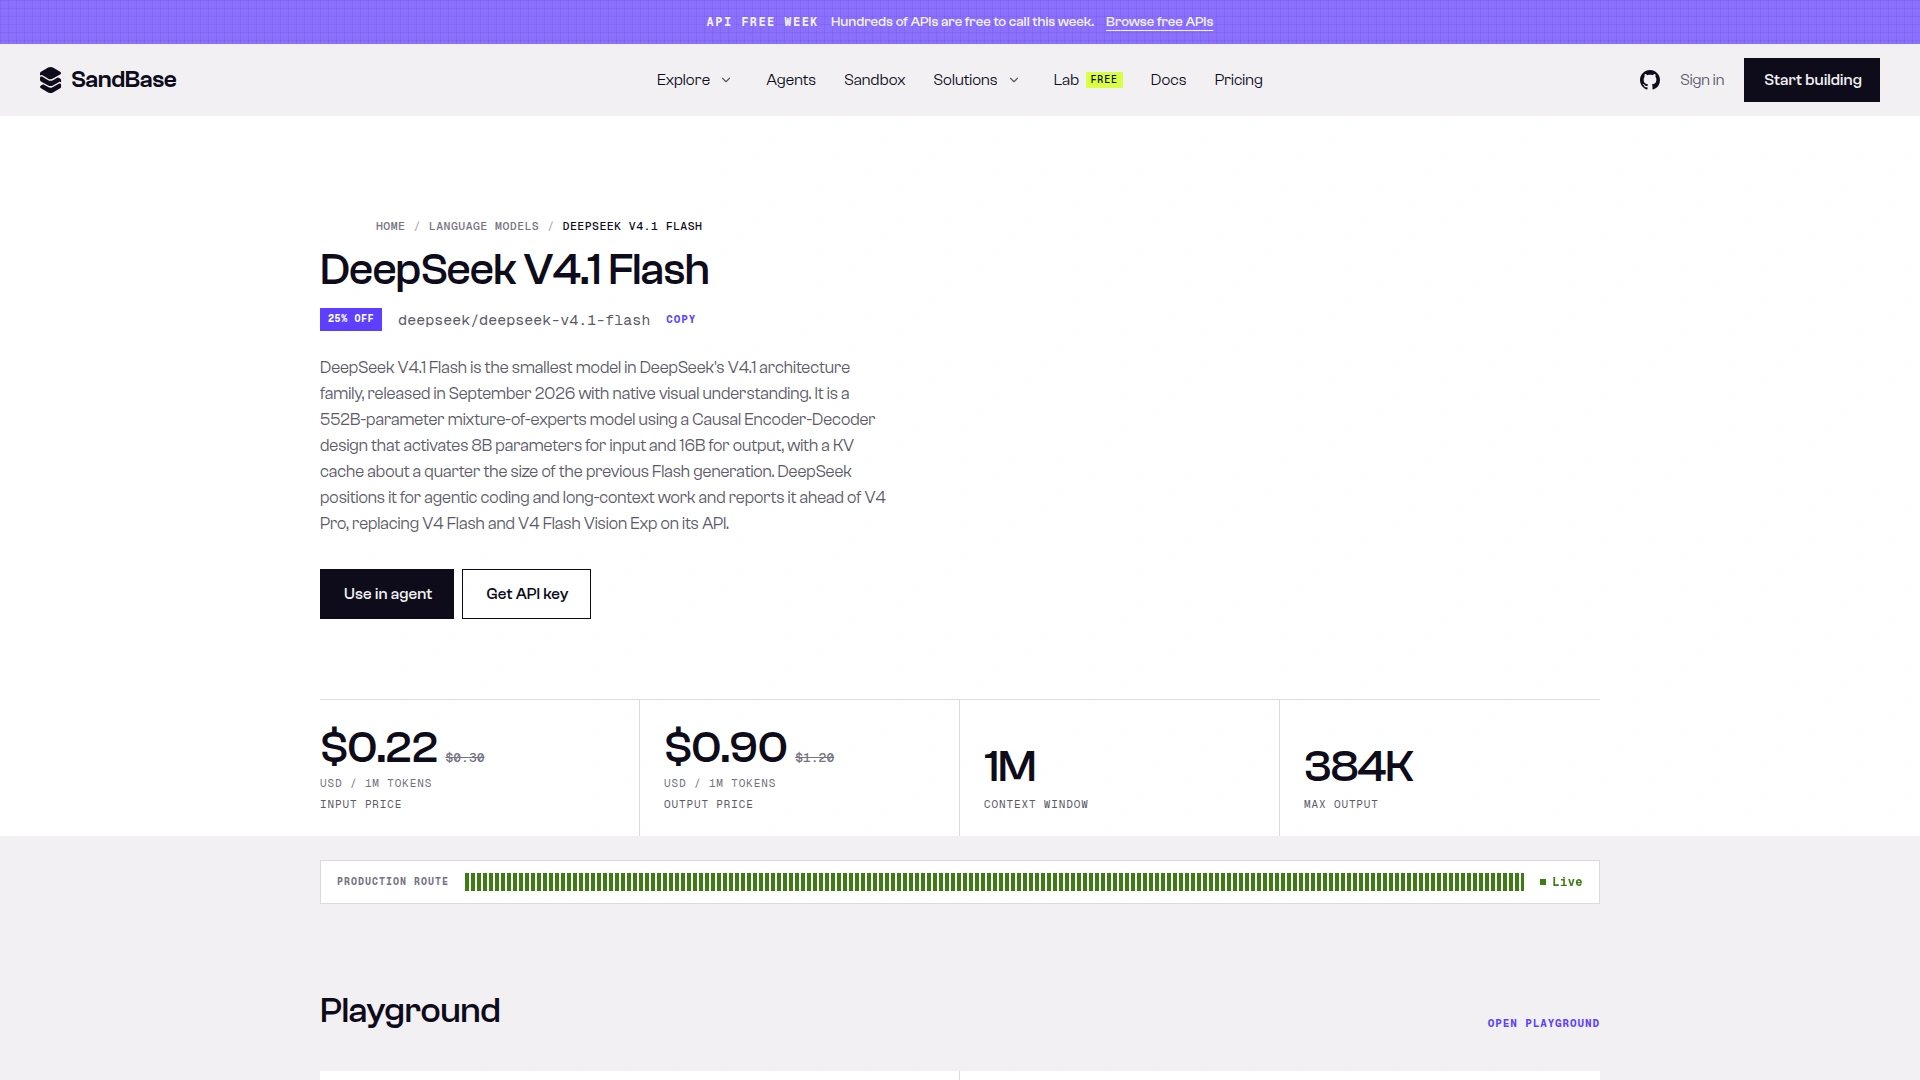 在 SandBase 上,模型 id 是
deepseek/deepseek-v4.1-flash,标价 $0.30 / $1.20,叠加 25% 上线折扣后显示 $0.22 / $0.90,1M 上下文、384K 最大输出(截图于 2026-10-17)。
通过 SandBase 调用时,这个模型同样是 1M 上下文、384K 最大输出;截图时的 25% 模型折扣把实际价格压到约每百万 token 0.22 美元输入、0.90 美元输出。折扣会变,所以把它当作某一时刻的快照,做预算前先看实时模型页。真正不变的是:无论你直连 DeepSeek 还是走 SandBase,1017 都在你早就用着的那个 deepseek-flash / deepseek/deepseek-v4.1-flash 标识下出现。
谁该现在关注
有三类人这周有理由行动:
- 把编码或终端 agent 跑在 Flash 上的团队。 Terminal-Bench 和 DeepSWE 的提升正好对准你的循环。重跑你的评测集,上限是真的,但依赖 harness。
- 有针对旧 Flash 的回归测试的人。 checkpoint 在一个稳定名字下被换掉了。在你假设”什么都没变”之前,先确认 golden output 还能过。
- 需要锁定版本的团队。 MIT 权重让你可以把 1017 作为固定版本自托管,而不是跟着一个会移动的
deepseek-flash别名走。
可以等的人:输出长度从来不是成本大头的输入密集型负载;以及以 Opus 级 HLE 表现为门槛的推理优先应用——1017 缩小了这个差距,但没抹平。
常见问题
用 DeepSeek V4.1-Flash-1017 需要改代码吗?
不需要。DeepSeek 在 2026 年 10 月 17 日原地升级了 deepseek-flash 这个名字,调用方式和价格不变。直连 API 的用户,以及在 SandBase 上用 deepseek/deepseek-v4.1-flash 的用户,都会自动用上新 checkpoint。唯一要做的是重新测试,而不是重新接入。
1017 比 9 月版 V4.1 Flash 好多少?
按 DeepSeek 自测,每一项列出的分数都在涨:比如 DeepSWE v1.1 从 74.2 升到 77.0,Terminal-Bench 4.0 从 31.2 升到 42.3。这些是厂商数据且依赖 harness,是让你去评测的理由,不是对你任务的保证。
DeepSeek V4.1-Flash-1017 比 Claude Opus 5 强吗?
看任务。在 DeepSeek 的对比表里,1017 在 DeepSWE v1.1 和 Apex Bench 上领先 Opus 5,而 Opus 5 在 HLE(56.3 对 42.6)、ProgramBench、NL2Repo-Bench 上更强。做终端和 SWE agent 循环,1017 以低得多的成本很有竞争力;做最难的推理则落后。
模型权重开放了吗?
开放了,以 MIT 协议发布在 Hugging Face 和 ModelScope 上。自托管是锁定固定 checkpoint、而不是跟随会移动的 deepseek-flash 名字的办法。
还有别的东西同期发布吗?
有。DeepSeek 同一天开放了自研的 Search 和 Fetch API。那是一个独立能力、单独计价,详见 DeepSeek Search 与 Fetch API 指南。
写在最后
V4.1-Flash-1017 是那种少见的更新:它对你毫无要求,却改变了你的结果。跑分提升集中在 agent 开发者最有感的地方——终端任务、SWE 循环、自动化;而”输出更短”的说法能在推理密集型工作上压低账单,还不涨价。它不是前沿推理模型,Opus 5 在 HLE 和整仓库合成上仍以明显优势领先。把”小版本更新”这个标签当成一个提示:在同一个 deepseek-flash 名字下重跑你的评测,并决定——一个会移动的别名,还是一个锁定的 MIT 自托管版本,才是你要搭的东西该用的地基。想用一把 key 把它和竞品放在一起测,从 DeepSeek V4.1 Flash 模型页 或 Python 教程 开始。