AI Agent 网页搜索与抓取 API 对比 (2026)
为 AI Agent 和 RAG 对比 Exa、Tavily、Firecrawl——神经搜索、带引用的答案、抓取——全部通过一个 SandBase 密钥。一份中立的 2026 选型指南。
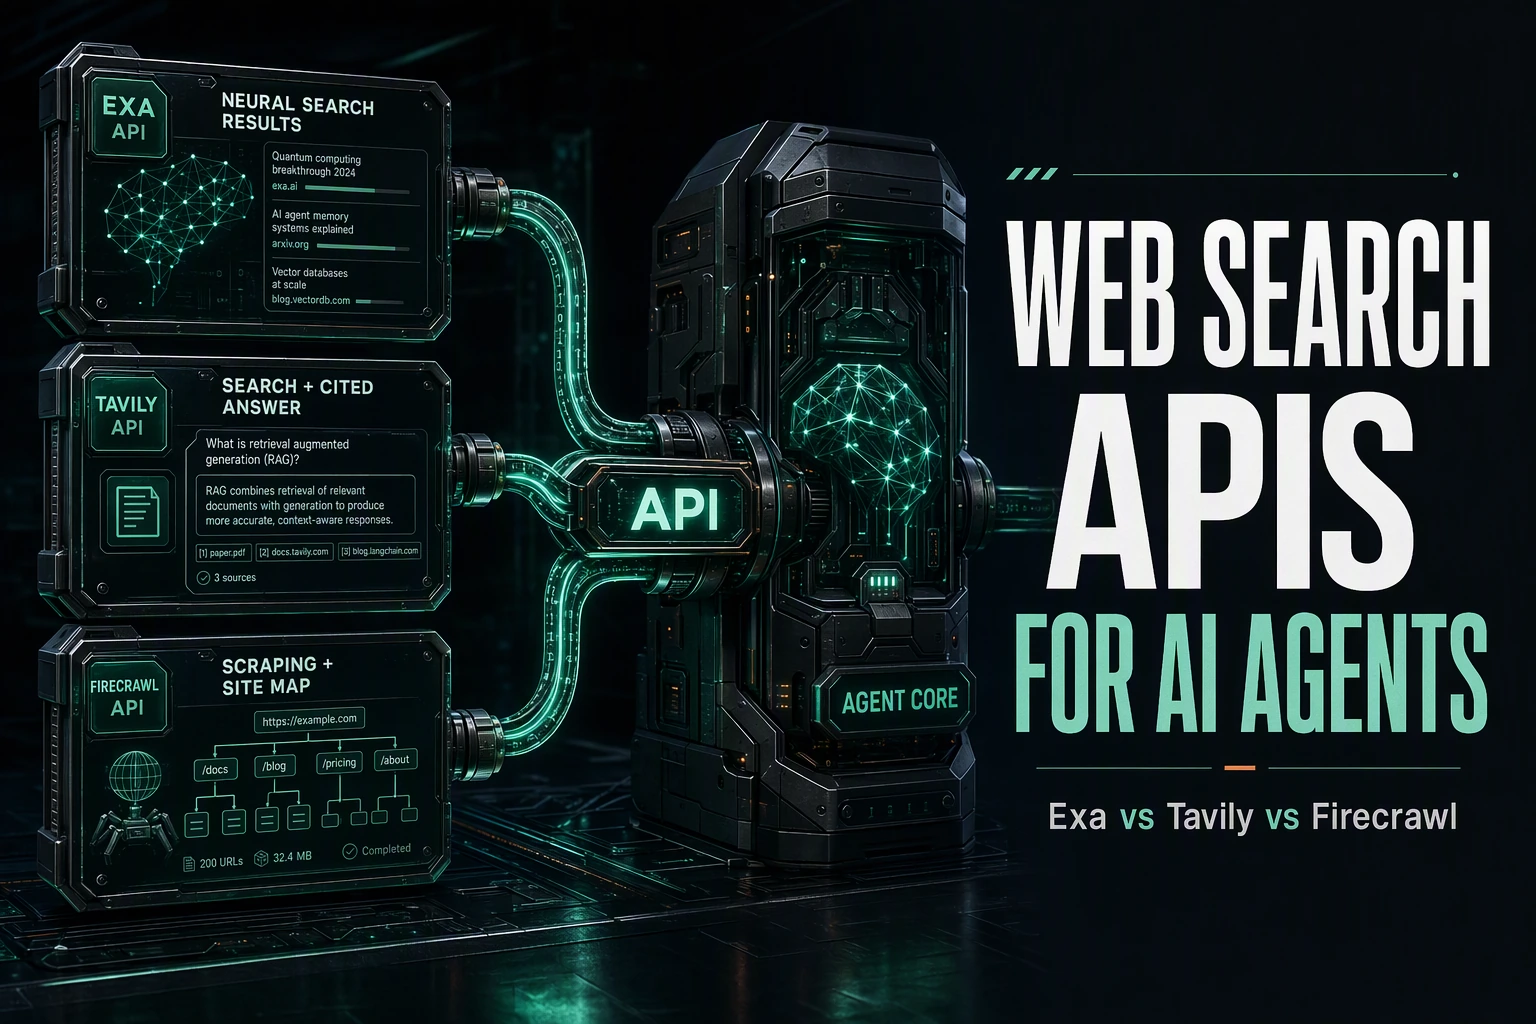
如果你在搭检索增强生成(RAG)流水线或研究型 Agent,最终都会需要同一样东西:一种把真实、最新的网页信息取下来喂给模型的办法。有三个 provider 在这块做得不错——Exa(为 AI 而建的神经搜索)、Tavily(带合成答案的 Agent 搜索)、Firecrawl(抓取与站点发现)。本文为 2026 年做一次中立对比,而且三者都能通过一个 SandBase API 密钥访问,所以你不用做三套集成就能全部试一遍。
下面的字段名和行为来自我通过 SandBase 实际跑的调用(测试于 2026-09-27,UTC),仅供观测——动手前请对照每个端点的线上参考核对。
先说结论(TL;DR)
- Exa — 神经(基于语义)搜索,加
contents和一个带引用的answer;当”按意图的相关性”重要时最强。- Tavily — 搜索一次调用同时返回排名结果和一个合成
answer,加extract和站点map;做有据回答的快捷默认。- Firecrawl — 为抓取和站点结构而建(
search、map);当你需要网页内容和爬取式覆盖时用它。- 三者都用
POST /v1/api/<vendor>/<path>加一个SANDBASE_API_KEY和同一个响应信封,所以切换只是一行改动。
你该用哪个?
| 你的需求 | 最佳选择 | 原因 |
|---|---|---|
| 按语义而非关键词找网页 | Exa | 神经检索按意图排名 |
| 一次调用同时返回结果和答案 | Tavily | search 返回 results 加一个合成 answer |
| 抓网页正文或映射站点结构 | Firecrawl 或 Tavily | Firecrawl map/search;Tavily extract/map |
| 对一个问题要一个带引用的直接答案 | Exa answer 或 Tavily search | 两者都带引用/来源合成 |
| 不做多套集成就试多个 | 任意,经 SandBase | 一个密钥、一个信封覆盖三者 |
共享的结构
三者都用同样方式调用——POST https://api.sandbase.ai/v1/api/<vendor>/<path> 加一个 Bearer 密钥。每个返回 id、status、model,以及在 completed 运行上的负载。信封可能不同:在我的调用里负载常出现在一个顶层 output 对象下,而端点参考记录的是 outputs[0].data。两种结构都读:
import os
import requests

def call(vendor_path: str, payload: dict) -> dict:
    resp = requests.post(
        f"https://api.sandbase.ai/v1/api/{vendor_path}",
        headers={
            "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=120,
    )
    resp.raise_for_status()
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error", {}).get("message", "未完成"))
    output = body.get("output")
    if output is None and body.get("outputs"):
        output = body["outputs"][0].get("data", {})
    return output or {}

exa = call("exa/search", {"query": "vector database benchmarks"})
tavily = call("tavily/search", {"query": "vector database benchmarks"})
firecrawl = call("firecrawl/search", {"query": "vector database benchmarks"})
因为调用结构完全一样,切换 provider——或调用三者再合并——只是一行改动。这正是走一层 API 的实际理由:你的检索代码不用为每个厂商分叉。
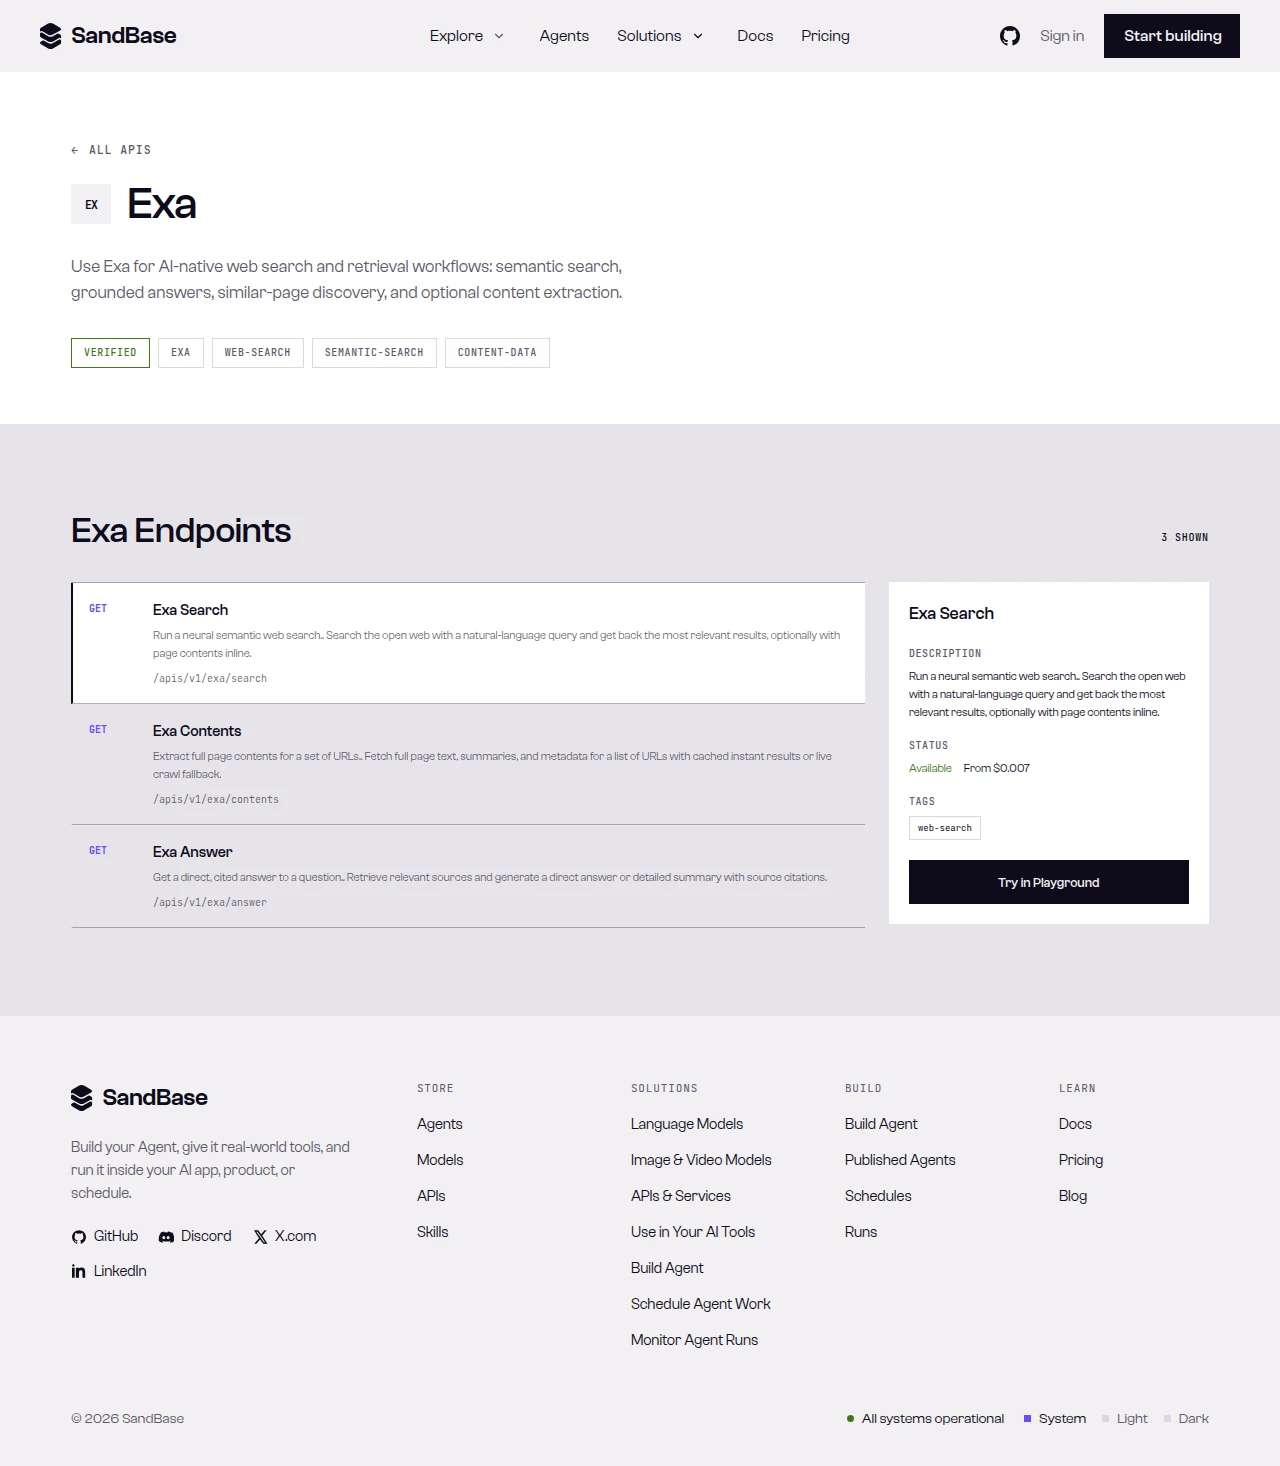 Exa、Tavily、Firecrawl——一个密钥、一个信封、一条代码路径。
Exa — 神经搜索 + 带引用的答案
Exa 做基于语义的检索,所以像”挑战 scaling laws 的论文”这样的查询会浮现概念相关的网页,而不是关键词匹配。在我的运行里,exa/search 返回排名 results(每条带 url、title、publishedDate);exa/contents 按 URL/ID 抓网页正文;exa/answer 返回一个带 citations 的合成 answer。
当”按意图的相关性”是首要时选 Exa——研究型 Agent、文献发现,或任何关键词搜索抓不住重点的场景。完整端点全景见 Exa 搜索 API 汇总页。
Tavily — 自带答案的搜索
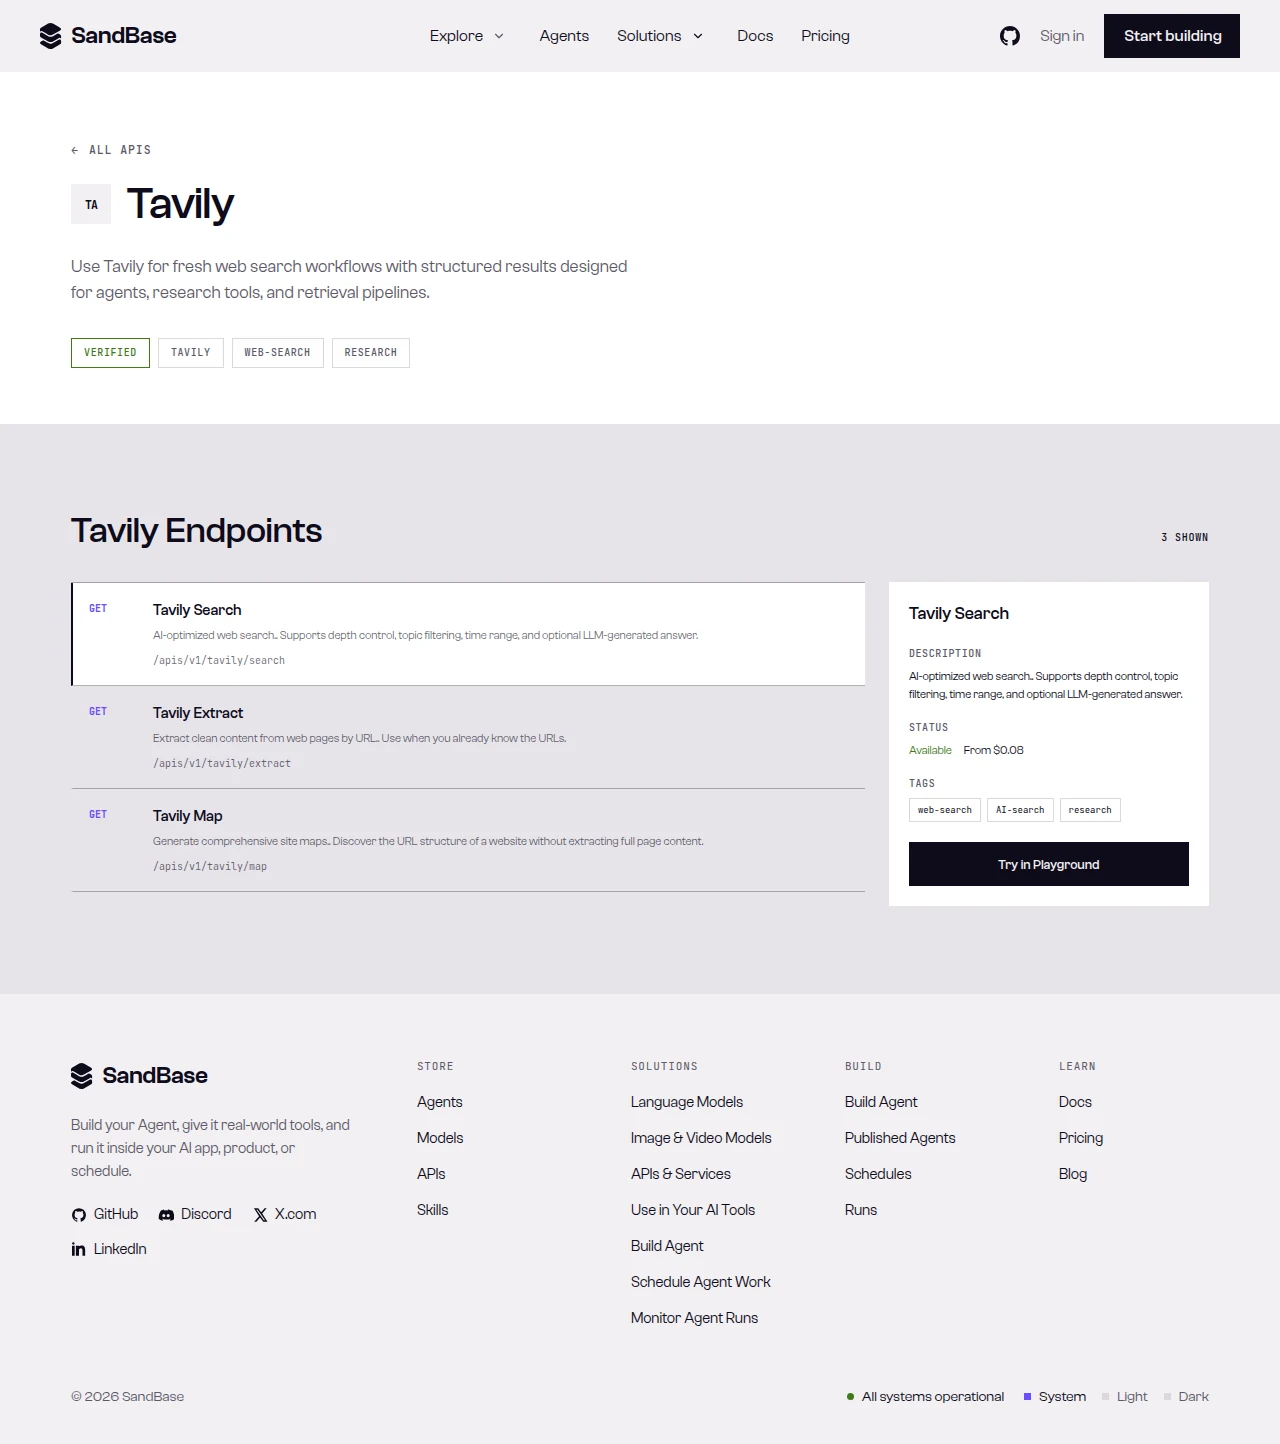
Tavily 的 search 一次调用同时返回排名 results 和一个合成 answer,这让它成为做有据回答的快捷默认。它还提供 extract(为一组 URL 抓 raw_content)和 map(发现站点结构)。
当你想一次调用既找到来源又起草一个有据答案,或你的 Agent 在搜索之外还需要抽取和站点映射时,选 Tavily。见 Tavily 搜索 API 汇总页。
Firecrawl — 抓取与站点结构
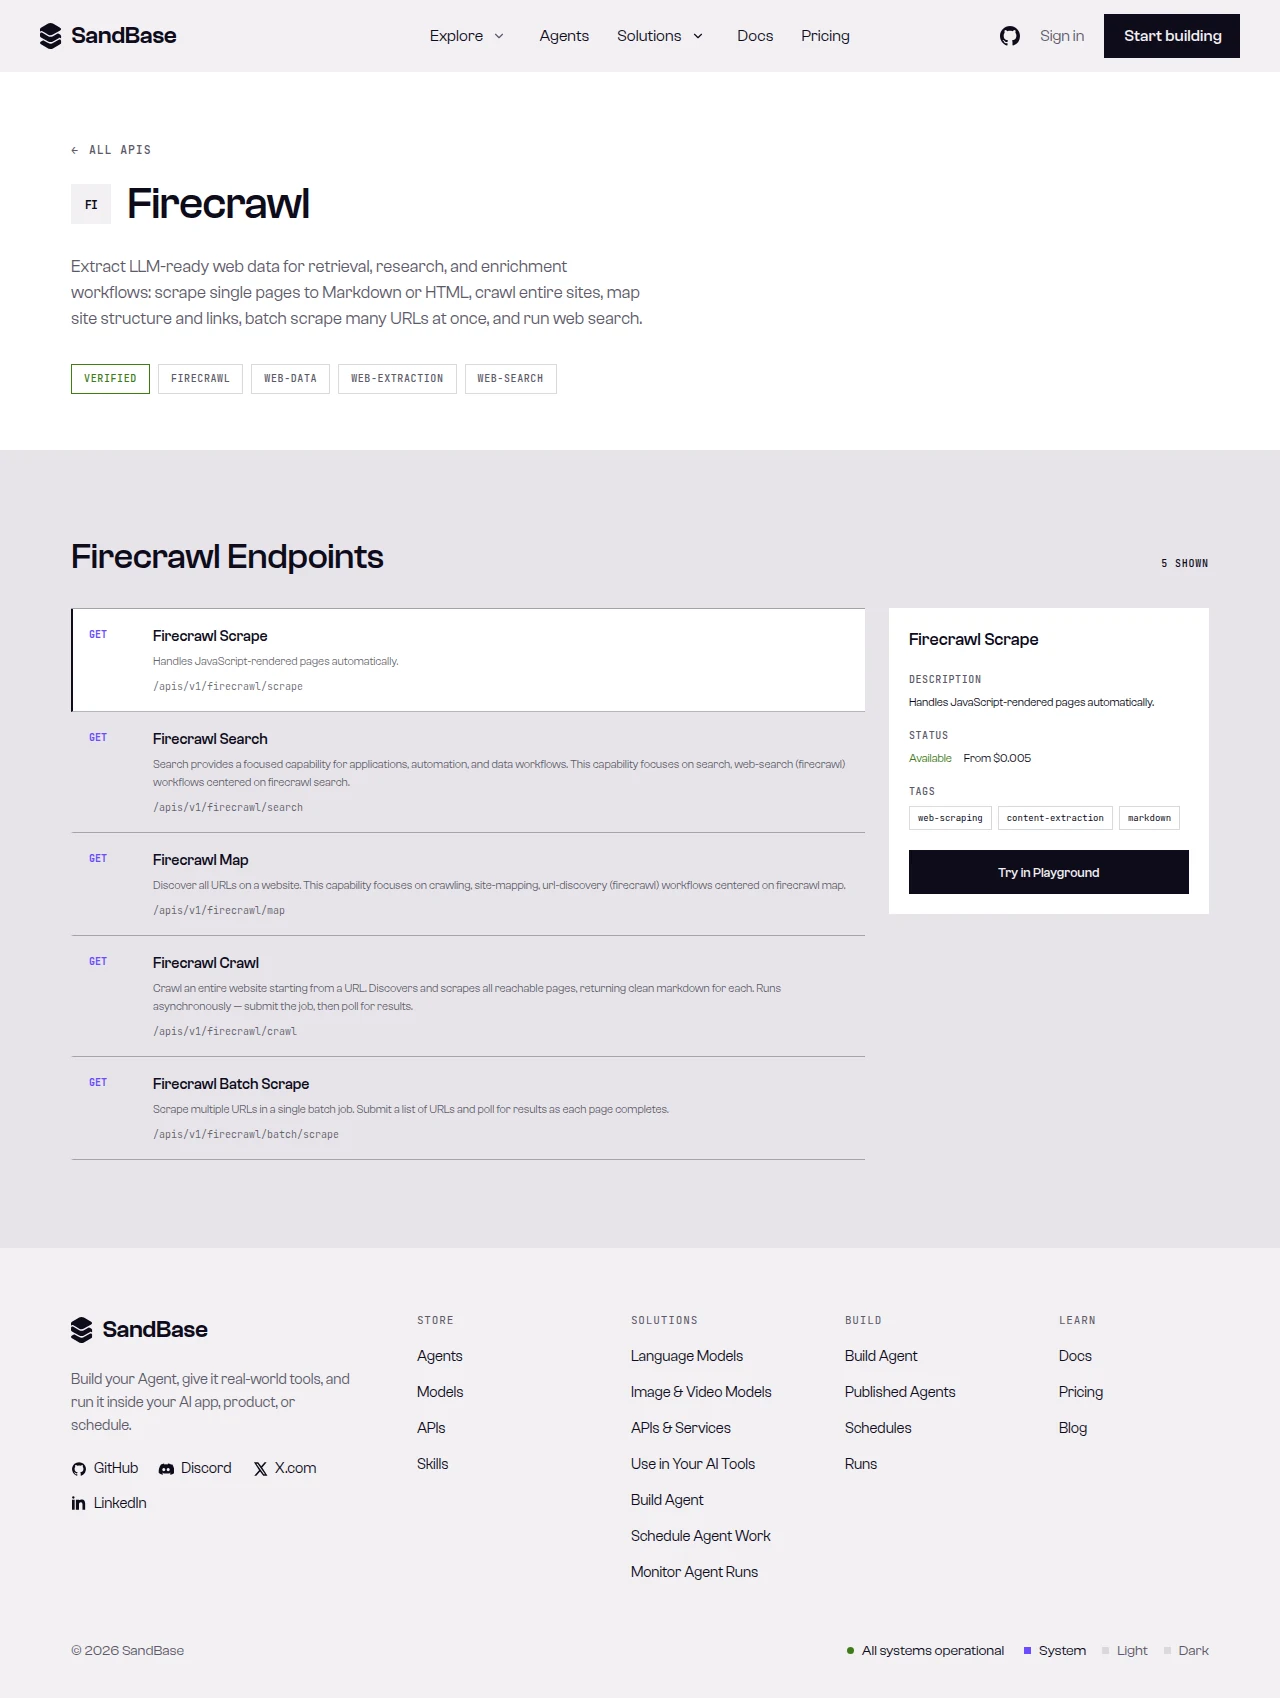
Firecrawl 围绕”把内容从网页取下来、理解站点结构”来设计。在我的测试里,firecrawl/search 返回网页结果,firecrawl/map 返回一个站点的 links。它抓取优先的设计契合爬取式覆盖和内容抽取工作流。
当你的活儿更接近”取内容和站点形状”而非”回答一个问题”时选 Firecrawl。可用性因端点而异,动手前请对照线上参考核对每个端点。
 不同的强项:按意图排名的结果、一个合成答案、站点结构。
功能对比
| 能力 | Exa | Tavily | Firecrawl |
|---|---|---|---|
| 关键词/神经搜索 | 神经 | 排名 + 答案 | 网页搜索 |
| 合成答案 | answer | 在 search 里 | — |
| 网页内容 | contents | extract | 抓取导向 |
| 站点映射 | — | map | map |
单个 SANDBASE_API_KEY | 是 | 是 | 是 |
把这当作起点地图、而非规格——能力和响应字段会演进,请对照每个端点的线上参考核对。
 三个厂商都在同一个目录里,用一个密钥即可访问。
三者通用的 RAG 模式
无论你选哪个,检索步看起来都一样:找候选网页、抓它们的正文、喂给你的模型。用 Exa 是 search → contents;用 Tavily 是 search → extract(或只用 search 拿自带答案);用 Firecrawl 是 search/map 做覆盖。因为 SandBase 信封是共享的,你甚至可以扇出到两个 provider、在同一个辅助函数后面合并结果——当你既想要神经相关性又想要合成答案时很有用。
常见问题
我需要三个单独的 API 密钥吗?
不需要。三者都通过 SandBase 用一个 SANDBASE_API_KEY。这正是在这里对比它们的意义——你不做三套集成就能各试一遍。
哪个做 RAG 最好? 没有单一赢家。Exa 强在按意图检索,Tavily 强在一次调用搜索加答案,Firecrawl 强在内容和站点覆盖。很多流水线会组合使用。
这些只返回公开数据吗? 这些是针对公开网页内容的读取/检索 API。请就你的使用场景遵守每个 provider 的条款和 robots 策略,并对照线上参考核对行为。
为什么响应有时用 output、有时用 outputs?
信封可能因端点和时间而异。两种结构都读——优先顶层 output,回退 outputs[0].data——如上面共享辅助函数所示。
结论
对 2026 年,按用途选:Exa 做基于语义的检索和带引用的答案,Tavily 做一次调用的搜索加答案带抽取,Firecrawl 做抓取和站点结构。因为三者都能通过一个 SandBase 密钥、用同一个信封访问,低风险的做法是把共享辅助函数接一次,然后在你自己的查询上各试一遍。