Exa 搜索 API | SandBase
用 Python 经 SandBase 调用 Exa 搜索 API,限定官方文档域名并获取相关片段;需要答案时,再独立调用 Answer 并核对引用来源。
想用 Python 经 SandBase 找到官方文档,先把搜索范围收窄。本例查询 OpenAI Agent 工具文档,只检索 openai.com,同时请求 highlights。先看与问题相关的片段,再决定哪些页面值得阅读全文。 3
这里先解决“找来源”,不是搭建完整托管 Agent。若还需要带引用的答案,可以另调 Answer;它不会自动接收前一步的网页或域名条件。当前示例依据公开文档编写,没有新增实测。文中 9 月 27 日的返回记录仍按历史材料保留。 4
先说结论
按当前文档读取响应包装层
下面的辅助函数只检查完成状态和 outputs[0].data,不解析业务字段。缺少数据或数据为 null 时直接报错;真实存在的非 null 数据则原样保留。即使包装层合格,也不能据此认定结果可用、引用齐全或答案正确。 3 4
你需要哪个 Exa 端点?
| 手头的任务 | 端点 | 本例使用的参数 |
|---|---|---|
| 找官方文档,先看相关片段 | exa/search | query、includeDomains、numResults、contents.highlights |
| 另问一次,获取带引用的答案 | exa/answer | query;可选 text |
已知 URL 的正文提取是另一项任务,Search README 为此提到了 Exa Contents。本例不实现该调用,也不建立跨端点 ID 传递规则。 3
SandBase vs. 直接用 Exa API
| 你的情况 | 用 |
|---|---|
| 想在多个服务商之间用一个密钥、一套约定 | SandBase Exa API(本文) |
| 需要 Exa 特有功能或直接计费 | Exa 自己的 API 和控制台 |
SandBase 在 Exa 的能力之上提供一层统一的 Model API;当你需要厂商特有控制或直接契约时,用 Exa 自己的 API。
Exa API 能取到什么
- Search 找来源。 当前 README 说明了
results[]以及网页的url、title和按需返回的highlights[]。标题可能为空;文档中的截短样例也不是下方新请求的返回结果。 3 - Answer 给答案和引用。 README 已说明
answer、citations[],引用中包括title、url、publishedDate、author,请求时还可带网页text。这些是文档字段说明,不是完整 schema,也不承诺每次字段都齐全。 4
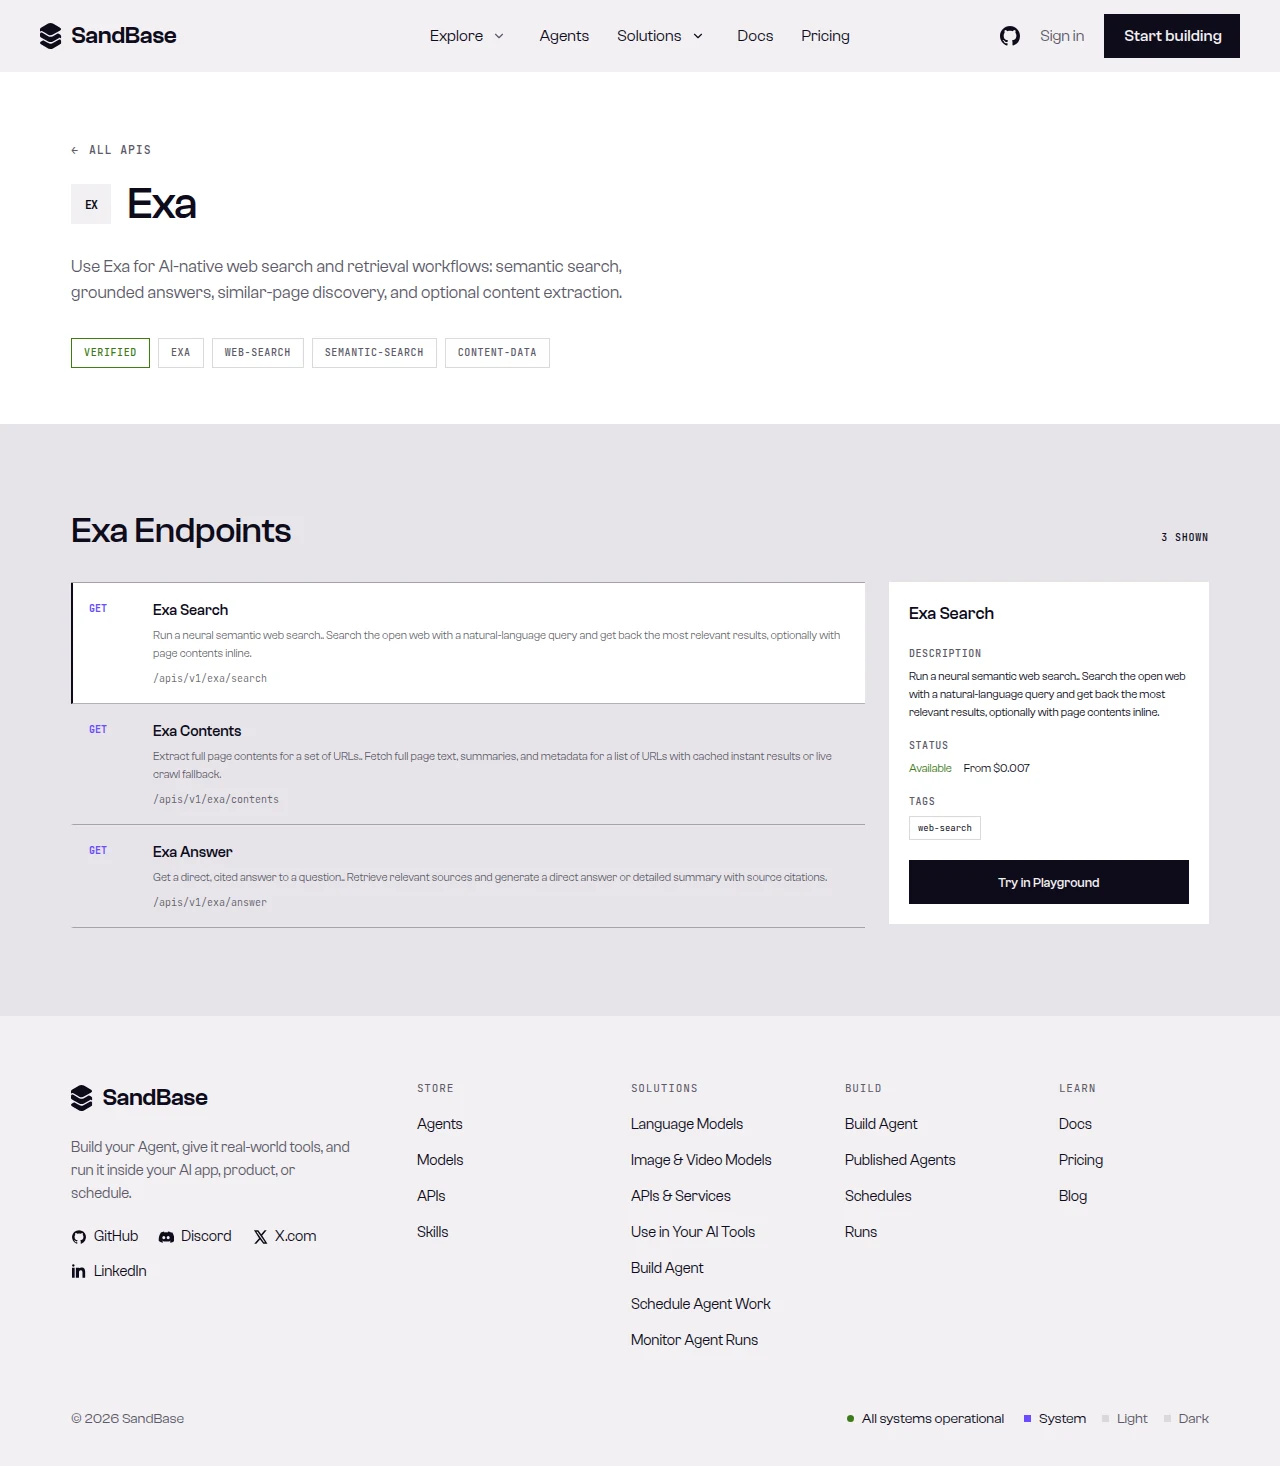 原文保留的历史截图:Exa 目录概览与端点列表,不是本轮调用结果。
用 Python 经 SandBase 调用 Exa 搜索 API
这里调用 Model API 的 POST 路由,不是目录中的 GET 路由。服务器环境需安装 requests 并设置 SANDBASE_API_KEY,不要把密钥放进前端。本例的查询与域名相匹配,不额外指定搜索模式,也不叠加类别和日期条件。以下代码依据文档编写,尚未运行。 Exa Search 请求参考
import os
import requests

SEARCH_URL = "https://api.sandbase.ai/v1/api/exa/search"
ANSWER_URL = "https://api.sandbase.ai/v1/api/exa/answer"


def read_documented_data(body):
    # Wrapper checks only; no application-data parsing or fallback.
    if not isinstance(body, dict):
        raise RuntimeError("SandBase response must be a JSON object")

    status = body.get("status")
    error = body.get("error")
    if status != "completed" or error is not None:
        # Never echo provider messages, raw payloads or arbitrary status text.
        status_label = status if status in (
            "completed", "failed", "timeout", "pending", "running"
        ) else "missing_or_unexpected"
        error_kind = "none" if error is None else type(error).__name__
        raise RuntimeError(
            f"SandBase response rejected: status={status_label}; "
            f"error_kind={error_kind}"
        )

    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs:
        raise RuntimeError("SandBase response is missing documented outputs")
    first = outputs[0]
    if not isinstance(first, dict):
        raise RuntimeError("SandBase outputs[0] must be an object")
    if "data" not in first or first["data"] is None:
        raise RuntimeError("SandBase outputs[0].data is missing or null")
    return first["data"]  # Preserve {}, [], 0, False and other non-null values.


def post_exa_model(url, payload):
    # Scope this helper to these two documented Model API routes.
    if url not in (SEARCH_URL, ANSWER_URL):
        raise ValueError("Unsupported Exa Model API route")
    key = os.environ.get("SANDBASE_API_KEY")
    if not key or not key.strip():
        raise RuntimeError("Set SANDBASE_API_KEY in the server environment")

    try:
        response = requests.post(
            url,
            headers={
                "Authorization": f"Bearer {key}",
                "Content-Type": "application/json",
            },
            json=payload,
            timeout=(10, 60),
        )
        response.raise_for_status()
    except requests.HTTPError:
        raise RuntimeError(
            f"SandBase HTTP request failed: status={response.status_code}"
        ) from None
    except requests.RequestException:
        raise RuntimeError("SandBase network request failed") from None

    try:
        body = response.json()
    except ValueError:
        raise RuntimeError("SandBase response was not valid JSON") from None
    return read_documented_data(body)


if __name__ == "__main__":
    search_data = post_exa_model(
        SEARCH_URL,
        {
            "query": "OpenAI agent tools documentation",
            "includeDomains": ["openai.com"],
            "numResults": 5,
            "contents": {"highlights": True},
        },
    )
    # Keep data for caller-side inspection; do not print raw provider payloads.
    print("Search response passed documented-wrapper checks only.")
可选:单独请求带引用的答案
如果还需要带引用的答案,另向 Answer 发起查询。当前参数只有 query、type、text、outputSchema,本例仅传 query。需要引用网页的正文时再加 text: true。Search 的 contents.text 是随搜索结果取正文;Answer 的 text 是随引用取正文,两者不要混用。 Exa Answer 请求参考 4
# Optional separate request; uses the definitions above.
answer_data = post_exa_model(
    ANSWER_URL,
    {"query": "OpenAI agent tools documentation"},
)
print("Answer response passed documented-wrapper checks only.")
历史记录:2026 年 9 月 27 日
下面保留我那次搜索调用的抓取片段(搜索 run id 67700c0e-9398-4f89-954d-42a434ed2706,测试于 2026-09-27,UTC),对应 Sophie Lin 原文的历史记录。它只展示当时观察到的结构,不代表当前契约,也不是上方新请求的结果。不要把这里的顶层 output 搬进现行代码。
{
  "id": "67700c0e-9398-4f89-954d-42a434ed2706",
  "model": "exa/search",
  "status": "completed",
  "output": {
    "results": [ { "id": "…", "title": "…", "url": "…", "publishedDate": "…" } ],
    "searchTime": 0.0,
    "resolvedSearchType": "…"
  }
}
现行接入请读 outputs[0].data。Search 和 Answer 的当前 README 已有字段说明及截短参考样例;这些是文档材料,不是本次更新新跑的结果。历史记录和保存样例都不能证明接口会持续可用。 3 4
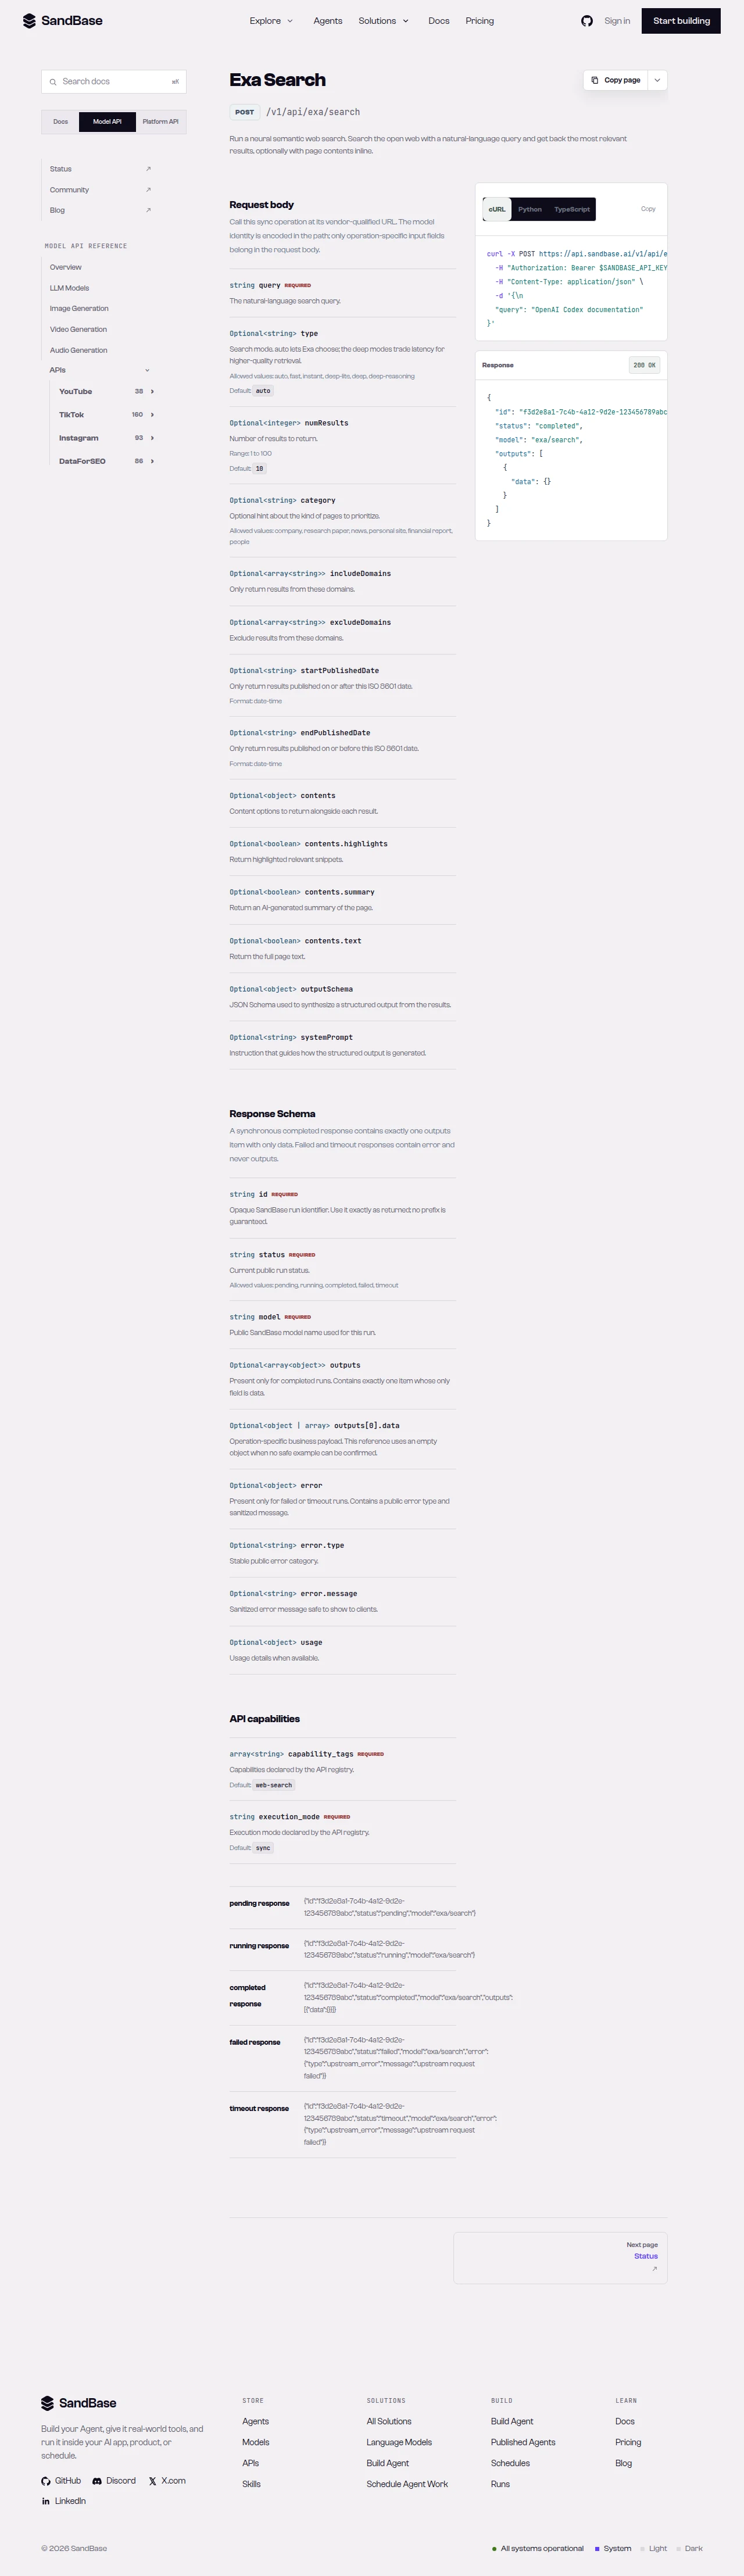 原文保留的历史 API 参考截图。当前参数和响应处理请以文中链接的最新参考为准。
Search 找来源,Answer 另问一次
Search 的域名筛选只约束这次搜索。Answer 是独立查询,文档没有接收先前结果列表或 includeDomains 的输入项;即便 query 相同,也不能认定答案只用了前一步找到的网页。 3 4
拿到来源后,仍要逐项检查 URL、可用的发布日期,以及原文是否支持答案中的具体说法。若要固定来源再交给模型生成,需要应用自行编排并验证生成步骤;本文没有执行这条 RAG 链路。
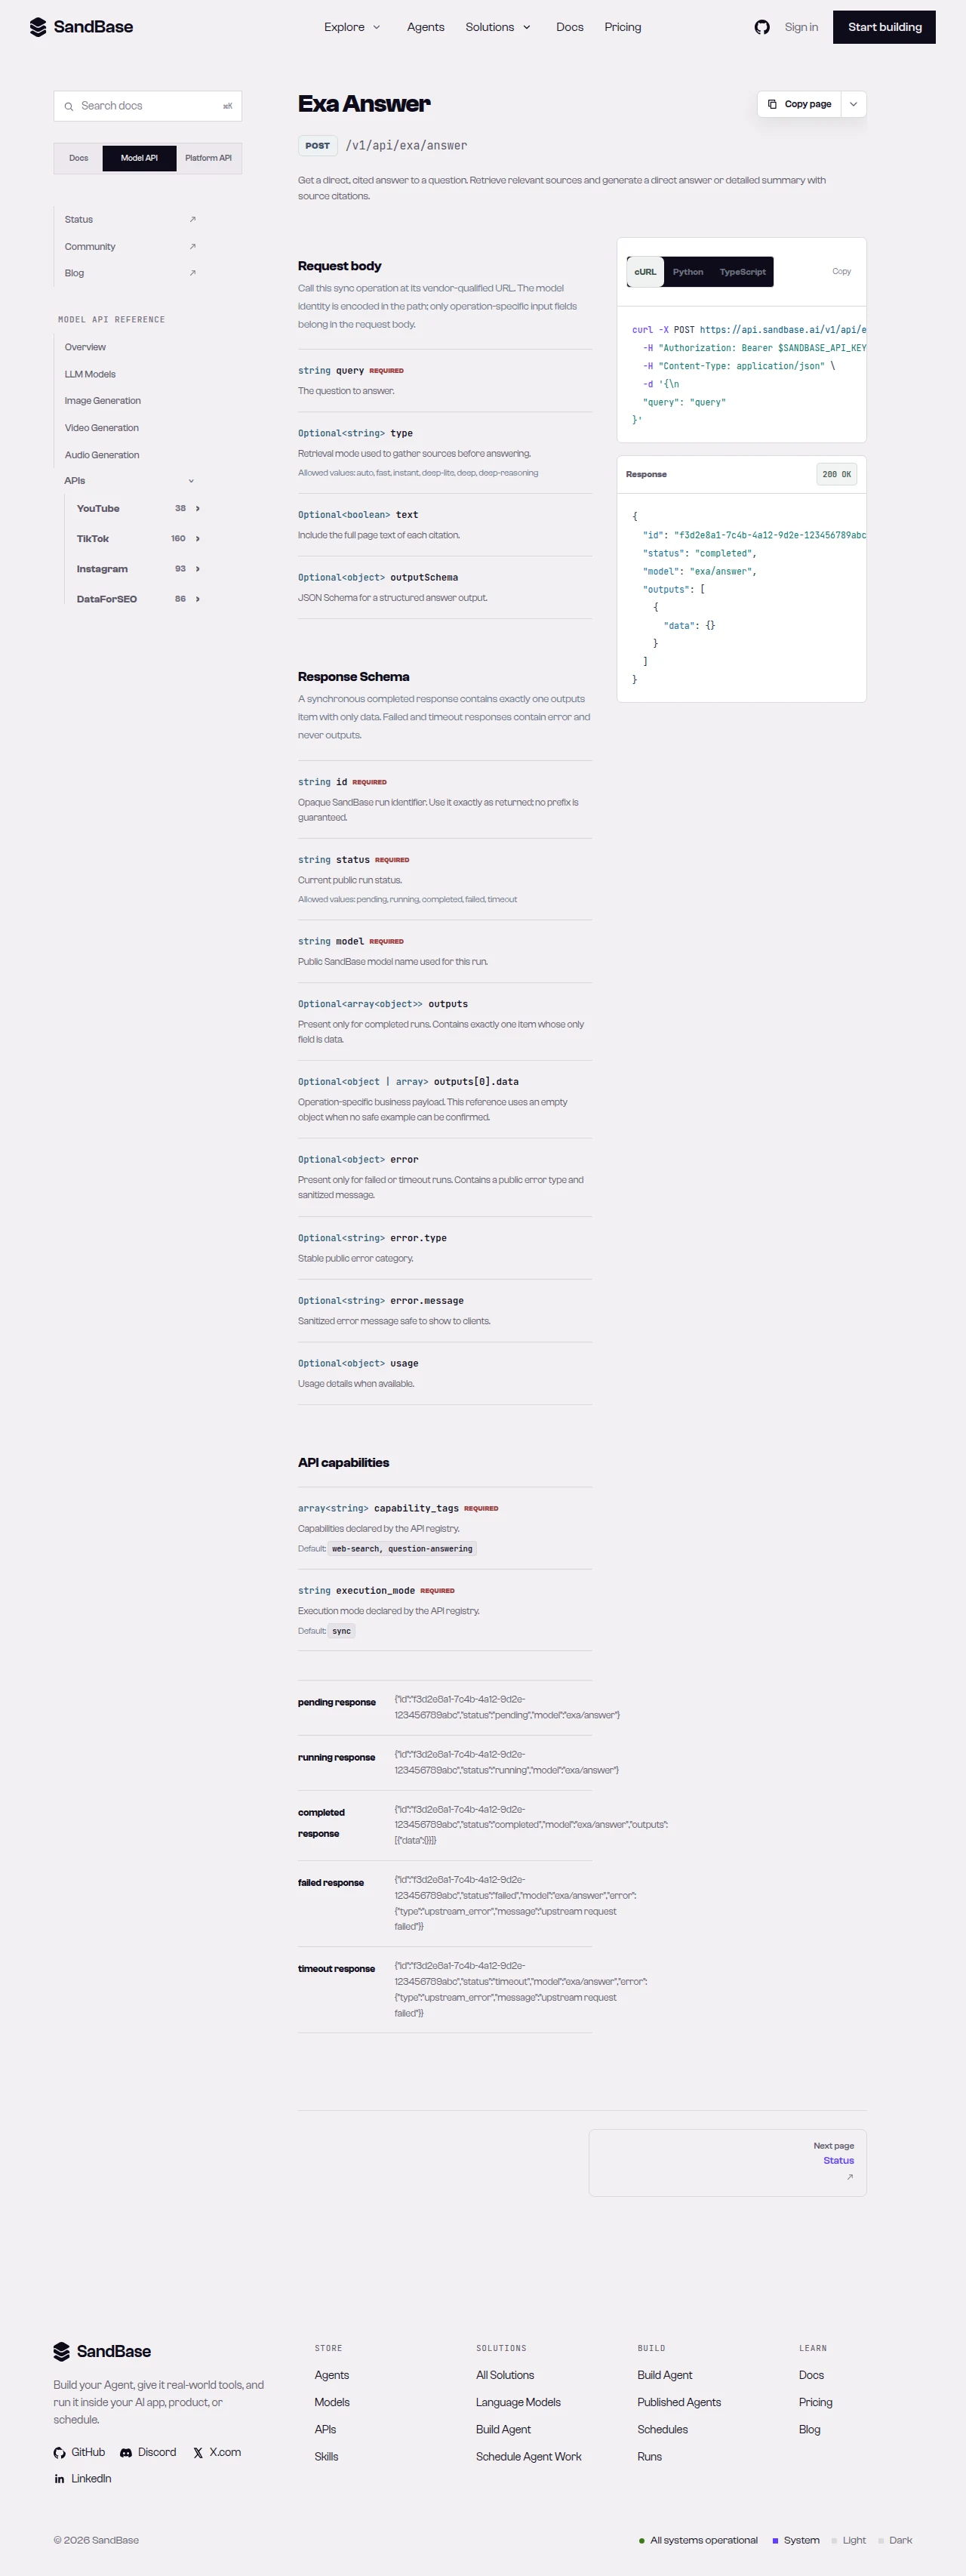 原文保留的历史 Exa Answer API 参考截图,展示 POST 路由、参数与响应结构;不代表新跑的 Answer 或已完成的调用链。
常见用例
先找官方文档
用 Search 限定域名并请求 highlights,筛出候选文档。片段用于初筛,最终证据仍应回到页面核对。 3
另取一份带引用的答案
需要答案时,独立调用 Answer。引用提供核验入口,不等于结论已经正确,更不能据此认为来源受先前的域名筛选约束。 4
已知 URL 的正文提取
这属于 Search README 提到的 Exa Contents 能力。本例仅保留任务说明,不执行该端点或承诺输入标识符可直接跨端点传递。 3
为什么放在 API 层来做
通过 REST 接入,不需要再引入 Exa SDK。上面两个调用可以共用鉴权、HTTP 检查和文档包装层检查,但请求参数与业务校验仍要分开。这是应用的接入组件,不是托管 Agent,也不能据此把同一个响应契约套到全部 SandBase 端点。 1 2 3 4
局限与边界
- 只检查包装层。 缺失、null、未完成或错误响应直接拒绝;通过检查后仍需验证业务数据。 3 4
- 文档说明不是新实测。 字段表和截短样例不等于完整 schema,也不保证持续可用。 3 4
- 来源范围不继承。 Answer 没有文档化的 Search 域名/正文设置或自定义结果输入,不能当作固定来源生成步骤。 4
- 引用仍须核验。 检查 URL、可用日期和原文对具体论断的支持,不把“有引用”当作“事实正确”。
常见问题
还需要单独申请 Exa 密钥或安装 SDK 吗?
调用这里的 SandBase 路由不需要。使用服务器环境中的 SANDBASE_API_KEY,不要把密钥交给浏览器。 1 2
Python 应该从哪里取结果?
当前两份 README 都指定 outputs[0].data。缺失或为 null 时应报错,不回退到顶层 output;上方 9 月记录只作历史说明。 3 4
怎样限定官方文档并拿到相关片段?
让 query 与所选域名匹配,在 Search 中设置 includeDomains 和 contents.highlights: true。本文给出的是文档请求示例,没有新增真实返回。 3
Answer 会接着使用上一轮 Search 的网页吗? 不能这样推断。Answer 自己接收 query,没有文档化的自定义结果输入或 Search 域名筛选。固定来源的 RAG 需要应用另行编排和验证。 4
从一次搜索开始
先用上面的 Search 请求找来源,通过包装层检查后再核对网页。若需要 Answer,另行发起查询,不把它写成自动接续。选工具时可参考已有的 Exa 搜索 API 对比。准备实际接入时,再创建 SandBase API 密钥。
觉得有用?分享给更多人