模型对比
Agent 用便宜模型够不够?22 个模型分档实测
Agent 用便宜模型够不够实测:7 个厂商的 Flash、标准、Pro、Max 档共 22 个模型,17 道工具调用题各跑 3 次。GPT-6 Luna 51/51 全对,单任务成本约为 GPT-6.1 Sol 的 1/20。
阅读关于 AI 智能体、模型路由以及构建生产级 AI 系统的洞察。
Agent 用便宜模型够不够实测:7 个厂商的 Flash、标准、Pro、Max 档共 22 个模型,17 道工具调用题各跑 3 次。GPT-6 Luna 51/51 全对,单任务成本约为 GPT-6.1 Sol 的 1/20。
阅读
工程拆解:SandBase 如何把抖音、TikTok、微博、小红书上游 GET/POST、不同 body 形状的接口归一到 POST /v1/api 契约,含命名规则、body 包装和 fail-closed 校验。
阅读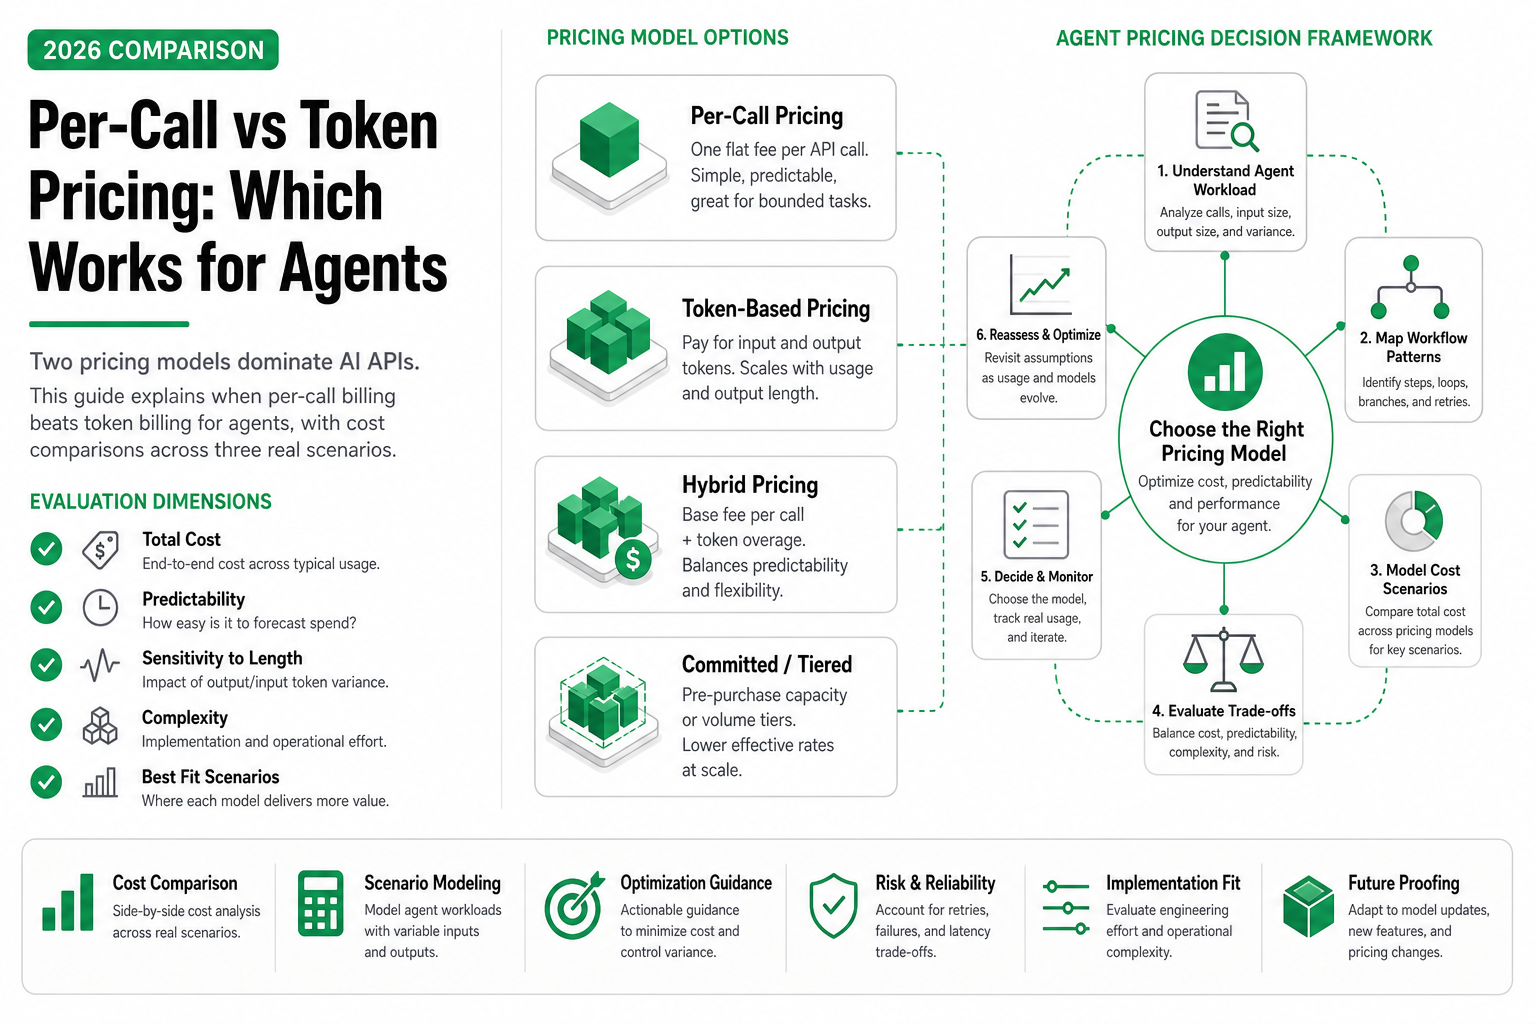
两种定价模式对比:什么时候 $0.001 一次的数据 API 比让 LLM 自己搜便宜 10 倍,以及怎么在一个 agent 里混用两者。
阅读
用 Python 写一个跨平台比价 Agent:同一款商品同时查 Google 商品卡、亚马逊和 TikTok Shop 美国站,型号匹配在代码里做,拿不准的标题才交给 GPT-6 Luna,人工核对精确率 94%。
阅读
商品评论分析 Agent 实战:抓 TikTok Shop 和小红书磁吸手机壳评论,LLM 打主题和情感,Python 统计。用 40 条人工标注对比 GPT-6 Luna 和 GPT-6.1 Sol 的准确率与成本。
阅读
用 Python 写一个舆情监测 Agent:微博、知乎、B站三平台抓同一话题,大模型打立场和主题标签,代码做统计。再用 50 条人工标注对比 GPT-6 Luna 和 GPT-6.1 Sol 的准确率、成本与耗时。
阅读
Research Agent 搜索 API 实测:固定 GPT-6.1 Sol,分别接 Exa、Tavily、Firecrawl、Cloudsway、Scholar 和 Exa Answer,20 道 2026 年新题各跑 3 次,对比答对率、引用有效率、成本和延迟。
阅读
Claude Code 接入 SandBase MCP 的官方做法:用开源 CLI 一条命令装好,再看 12 次无头实测,覆盖小红书、抖音和生图三个任务的工具调用、通过率、耗时和成本。
阅读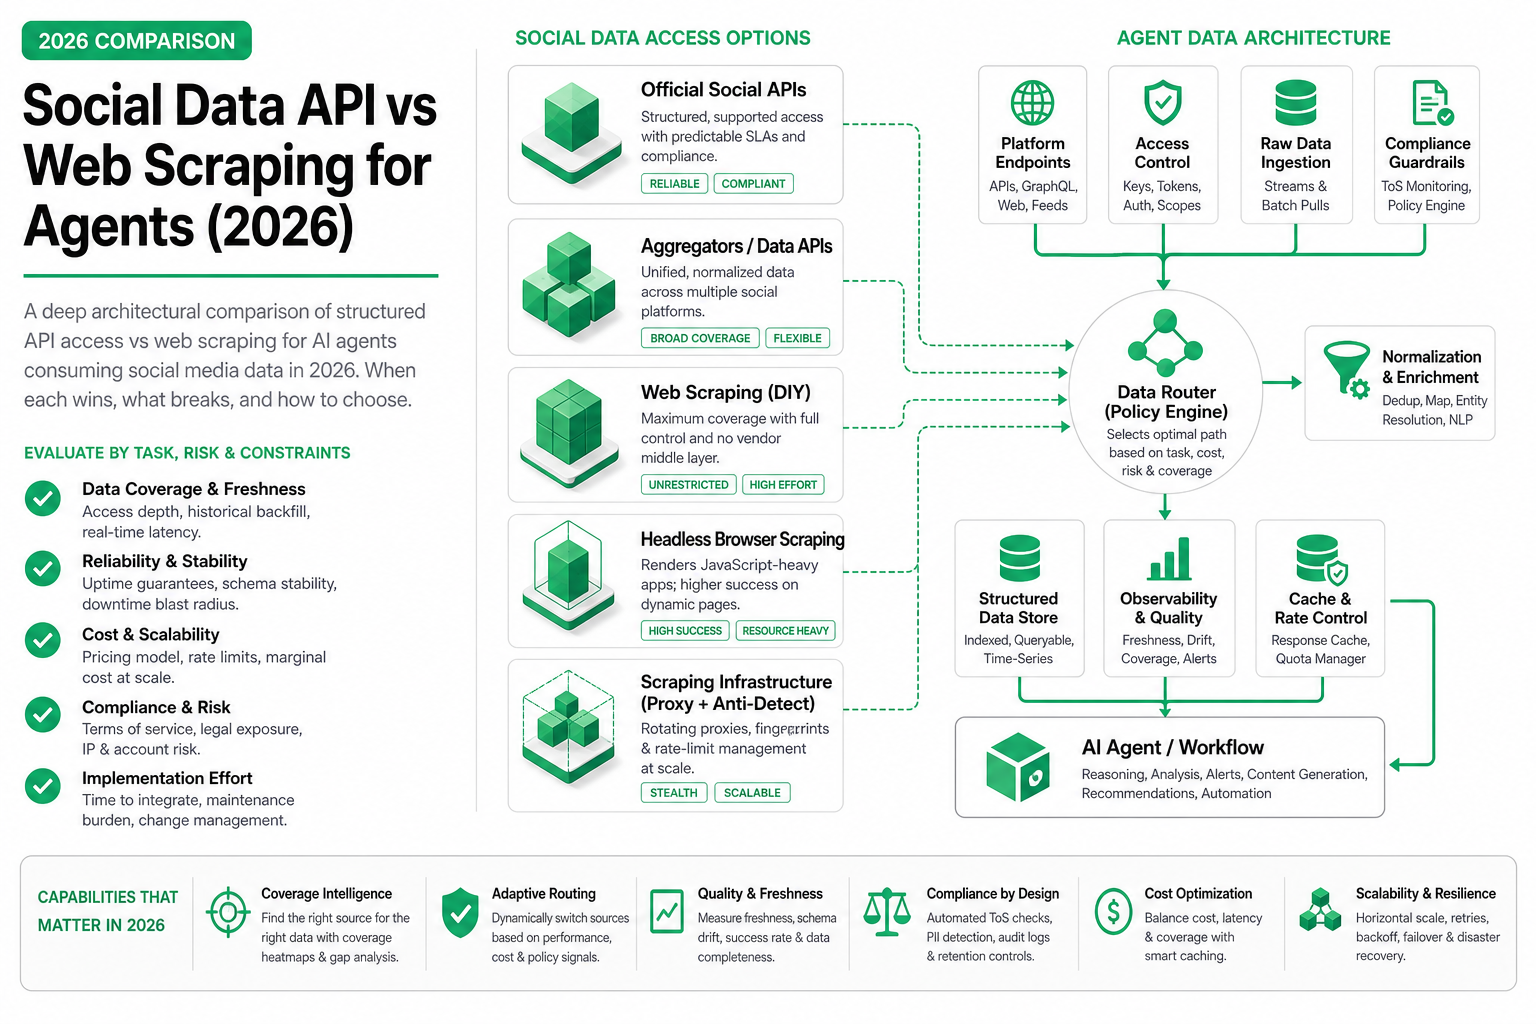
从架构视角对比结构化社媒数据 API 与爬虫:可靠性、合规风险、成本、延迟、数据覆盖五个维度,附一次 2026-10-01 实测的抖音 API 调用示例。
阅读