Research Agent 搜索 API 实测:6 种搜索工具跑 20 道新题
Research Agent 搜索 API 实测:固定 GPT-6.1 Sol,分别接 Exa、Tavily、Firecrawl、Cloudsway、Scholar 和 Exa Answer,20 道 2026 年新题各跑 3 次,对比答对率、引用有效率、成本和延迟。
Exa 第一轮只拿了 55/60,但问题不在 Exa。它的 91 次搜索里,有 44 次 Agent 拿到的是空列表。原因是 SandBase 网关对同一个 Exa 搜索会返回两种响应结构:一种把结果放在 results 里,另一种放在 entities 里,而我们的测试程序只认 results。把解析代码改成两种都认之后重跑,Exa 拿了 60/60。模型、提示词、题目一样没动。
这是这次 Research Agent 搜索 API 实测里最有用的发现。工具是 Agent 的手:模型固定之后,拉开差距的不是答案在不在网上,而是 Agent 能不能稳定读懂工具返回的东西、能不能打开原网页、读一次要花多少钱。我们在 2026-10-03(UTC)通过 SandBase 让 GPT-6.1 Sol 每次只接一家的搜索工具,回答 20 道关于 2026 年 7 到 10 月事实的题,每题跑 3 次。
先说结论
- 修好解析之后,有 4 套配置 60 次全对:Exa(搜索 + 正文)、Firecrawl(搜索 + 抓取)、Scholar 网页搜索、Exa Answer。Tavily 58/60,Cloudsway 55/60。不给工具时,51 次可回答的题模型只答对 1 次。
- 引用有效(引用的网址能打开且页面里有答案):Exa、Tavily、Scholar 都是 51/51,Exa Answer 50,Cloudsway 48,Firecrawl 46。
- 每题 LLM 成本中位数从 $0.0023(Exa Answer)、$0.0026(Scholar)到 $0.0121(Tavily),差距主要来自读取网页正文消耗的输入 token。
- 9 个搜索和抓取端点在 2026-10-03 的基础价格都是 $0,抽查 27 个 run id 的实际扣费都是 $0.000000。
- 测试范围:20 道短答案题,一个模型,每题 3 次,单日数据。前 4 名准确率已经封顶,这个测试分不出它们的高下。
功能层面的对比见AI Agent 网页搜索 API 对比和Exa、Tavily、Firecrawl、SerpAPI 对比。这篇把这些工具放进真实的 Agent 循环里实测。
测试设置:模型固定,每次只换搜索工具
LLM 用 openai/gpt-6.1-sol,走 SandBase POST /v1/chat/completions,每轮输出上限 2,000 token,每题最多 6 轮。选它是因为它在我们的 12 个模型工具调用实测里拿了 51/51,成本也不高。模型不变,差异就只能来自工具。
每次运行只给一家的工具,工具名和描述完全一样:
| 配置 | web_search 调用 | fetch_page 调用 | SandBase 基础价格(2026-10-03) |
|---|---|---|---|
| Exa | exa/search(5 条,带 highlights) | exa/contents | $0 / $0 |
| Tavily | tavily/search(5 条) | tavily/extract | $0 / $0 |
| Firecrawl | firecrawl/search(limit 5) | firecrawl/scrape(markdown) | $0 / $0 |
| Cloudsway | cloudsway/search(5 条) | 无 | $0 |
| Scholar | scholar/search-web(5 条) | 无 | $0 |
| Exa Answer | 由 exa/answer 提供的 answer_engine 工具 | 无 | $0 |
| 无工具 | 无 | 无 | 不适用 |
测试程序把每条搜索结果统一裁成标题、网址和 500 字符摘要,网页正文截到前 10,000 字符。Cloudsway 和 Scholar 在 SandBase 上没有抓取端点,所以这两套配置只能看摘要。Exa Answer 直接返回回答和引用网址,作为“答案引擎”对照组。
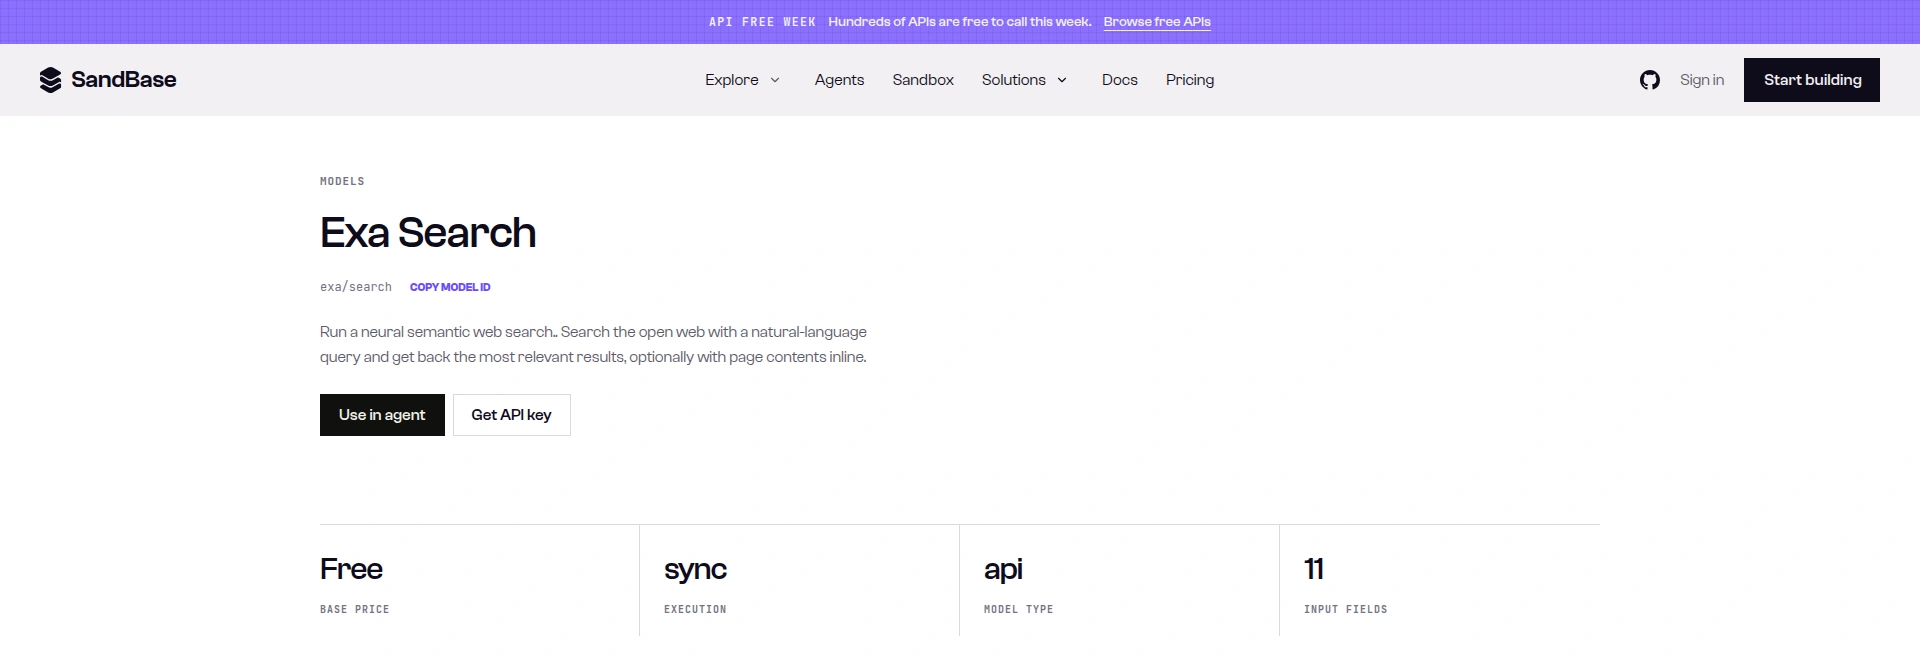
截图:exa/search 模型页标注基础价格 Free、同步执行;页面顶部横幅写着 API Free Week,所以 $0 只代表截图当天的价格(2026-10-03 截取)。
价格一栏取自 GET https://api.sandbase.ai/v1/models/<id>,9 个端点的 base_price 都是 "0",模型页显示的也一样。不过当天网站横幅写着“API Free Week”,别默认搜索会一直免费。GPT-6.1 Sol 的价格是每百万输入 token $2、输出 token $10。
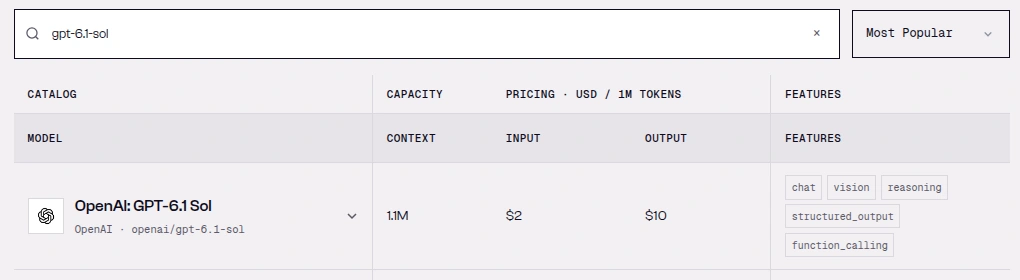
截图:SandBase 目录里 openai/gpt-6.1-sol 一行显示每百万 token 输入 $2、输出 $10,本文所有成本都按这个价格计算(2026-10-03 截取)。
20 道题
每道题的答案都很短,我们在 2026-10-03 逐一对照一手来源核对过,网址和不超过 25 个词的原文摘录记在 ground_truth.json 里。大部分是 2026 年 8 到 10 月的事实。3 道是错误前提题,正确答案是 null。4 道用中文提问,来源也是中文官方页面。
| 类型 | 数量 | 例子(答案) |
|---|---|---|
| 日期(发布、发文、停止支持) | 9 | Python 3.14.8(2026-09-30)、Go 1.27(2026-08-19)、Rust 1.99.0(2026-10-01)、Firefox 157(2026-09-29) |
| 名称和版本号 | 3 | Kubernetes v1.37 代号(Garhwal)、Next.js 九月安全更新版本(16.3.8)、DeepSeek V4.1 Flash 的 API 模型名(deepseek-flash) |
| 公告和价格里的数字 | 5 | Kubernetes v1.37 增强项数(67)、iPhone 18 Pro 美国起售价($1,199)和国行起售价(RMB 9,999)、国家统计局 8 月 CPI 同比(0.8%)和规模以上工业增加值增速(5.2%) |
| 错误前提 | 3 | PostgreSQL 19 正式版发布日期(计划 10 月 29 日,尚未发布)、4TB 版 iPhone 18 Pro 价格(最高只有 2TB)、Next.js 17 发布日期(尚未发布) |
有几道题埋了坑。PEP 745 里 Python 3.14.8 的计划日期还是 10 月 6 日,但它作为加急安全更新在 9 月 30 日就发布了。PostgreSQL 邮件列表写的是计划中的正式版日期,把“计划”当成“已发布”就会答错。
系统提示词原文:
You are a research agent. Today's date is 2026-10-03. Answer the user's question with the tools you have; if you have no tools, answer from your own knowledge. Prefer primary sources such as official sites, release notes, docs and press releases. If the thing asked about does not exist, has not happened yet, or you cannot find it, answer null. End with exactly one line: FINAL: {"answer": <value or null>, "source_url": <the URL that states the answer, or null>}评分:答案和引用分开算
答案:取 FINAL JSON 里的 answer,按题型归一化后和标准答案比较。
- 日期统一解析成 YYYY-MM-DD,“Sept. 30, 2026”“30 September 2026”“2026年9月30日”都算同一个日期。
- 数字去掉
$、¥、RMB、USD、元、%、千分位逗号和空格后按数值比较。 - 名称不区分大小写。
- 版本号去掉开头的
v或Next.js。 - 错误前提题只有答 null 或明确说“没找到”“未发布”才算对,给出日期或价格算错。
没有 FINAL 行算错。
引用:只对 17 道可回答的题打分。用普通 HTTP GET(带浏览器 User-Agent)请求 source_url,返回 HTTP 200,并且去掉空白后的页面文本里包含标准答案的某种写法,才算有效。日期会检查几种常见格式。短数字会带上单位或上下文(“67 enhancements”“$1,199”“0.8%”),免得页面上随便一个数字就算数。每个网址在 2026-10-03 只抓一次。
结果
一共 420 次计分运行:7 套配置 × 20 题 × 3 次,时间是 10:33 到 10:55 UTC。表里 Exa 那一行是修好解析后重跑的结果,过程见下一节。
| 配置 | 答对(60) | 可回答题(51) | 错误前提题(9) | 有效引用(51) | 工具调用 | 每题 LLM 成本中位数 | 耗时中位数 | p90 耗时 |
|---|---|---|---|---|---|---|---|---|
| Exa(搜索 + 正文) | 60 | 51 | 9 | 51 | 120 | $0.0077 | 14.1 s | 18.6 s |
| Firecrawl(搜索 + 抓取) | 60 | 51 | 9 | 46 | 121 | $0.0097 | 13.0 s | 17.0 s |
| Scholar 网页搜索 | 60 | 51 | 9 | 51 | 95 | $0.0026 | 10.2 s | 14.8 s |
| Exa Answer | 60 | 51 | 9 | 50 | 93 | $0.0023 | 12.0 s | 17.9 s |
| Tavily(搜索 + 提取) | 58 | 51 | 7 | 51 | 152 | $0.0121 | 13.9 s | 19.3 s |
| Cloudsway | 55 | 46 | 9 | 48 | 175 | $0.0058 | 14.3 s | 31.8 s |
| 无工具 | 10 | 1 | 9 | 1 | 0 | $0.0011 | 5.0 s | 7.7 s |
每道题的稳定性都很高。Exa、Firecrawl、Scholar 和 Exa Answer 每道题三次都对。Tavily 有一道题三次里错了两次。Cloudsway 有两道题 2/3,一道题 0/3。Cloudsway 的 48 次有效引用里有 2 次答案是错的:引用的页面上写着正确日期,Agent 却填了另一个。
无工具这一行说明这些事实不在模型记忆里。可回答的 51 次里,GPT-6.1 Sol 有 50 次老实回答 null,9 次错误前提题也全答 null。唯一答对的是 Rust 1.99.0 的发布日期(2026-10-01),三次里对了一次,连博客网址都写对了。Rust 每六周发一版,这更像是按节奏推出来的。
单次搜索调用耗时中位数从 1.65 s(Firecrawl)到 2.48 s(Tavily),Exa Answer 每次 1.91 s,抓取调用每次大约 1.0 到 1.6 s。
哪里出了问题
同一个端点,响应结构会变(Exa 第一轮)。 SandBase 的 API 参考文档写的是业务数据在 outputs[0].data。可这次实测里,数据从来没出现在那个位置:
- Firecrawl 搜索、Scholar、Exa Answer 和三个抓取端点都返回顶层
output对象。 - Cloudsway 返回
outputs[0],里面没有data这一层。 tavily/search两种都有:40 次output,33 次outputs[0]。exa/search(重跑)两种都有:37 次output,30 次outputs[0]。
Tavily 两种结构里的内容是一样的,Exa 不一样:output 里是 Exa 原生的 results 列表,outputs[0] 里是归一化过的 entities 列表。第一版测试程序只读 results,于是 Exa 有 44 次搜索看起来是空的,Agent 在 5 次运行里答了 null,第一轮只拿到 55/60。改成两种都读之后重跑,67 次搜索,60/60。Agent 时而“什么都搜不到”时,先记录每次调用的响应结构,别急着怪搜索引擎。
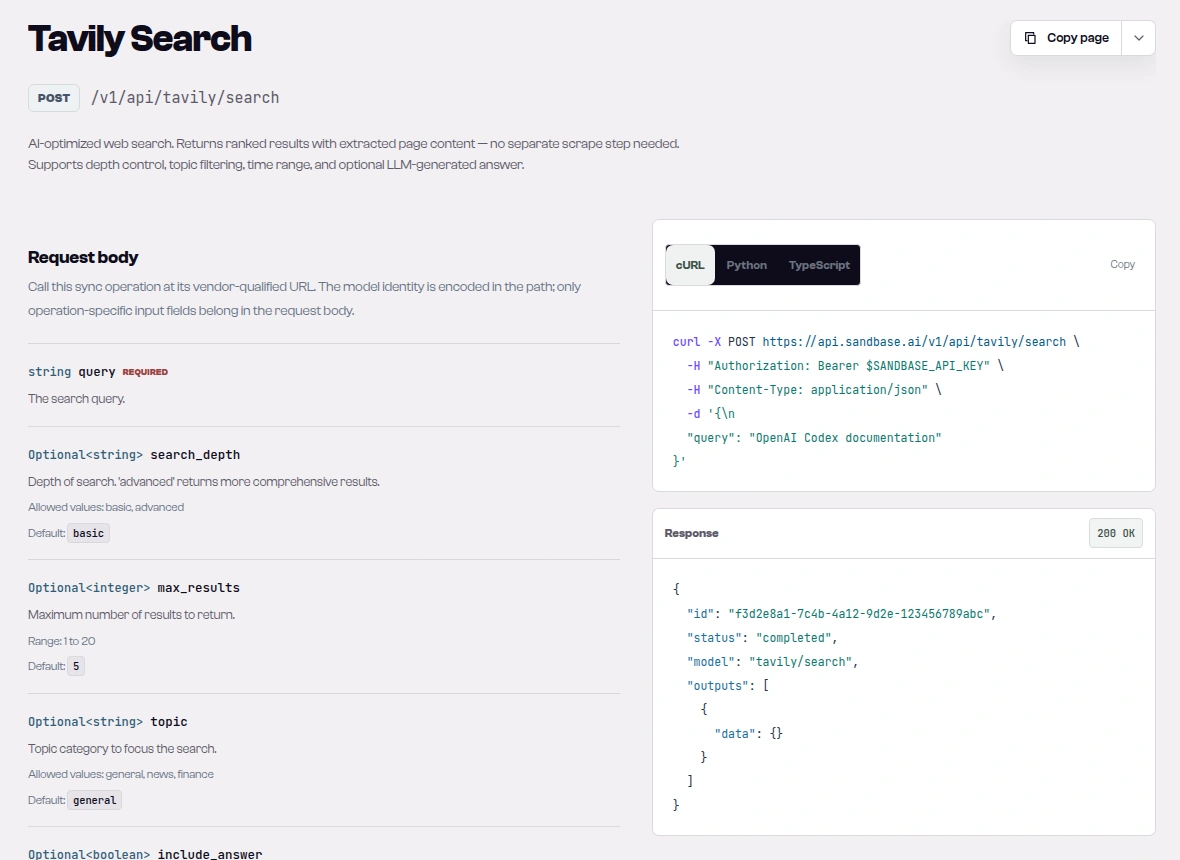
截图:tavily/search 参考页写明 POST /v1/api/tavily/search,completed 响应里数据在 outputs[0].data;而 2026-10-03 的实测返回的是顶层 output,或不带 data 的 outputs[0](2026-10-03 截取)。
没有抓取工具,只能信摘要(Cloudsway)。 DeepSeek 那道题 Cloudsway 三次全错:每次都把 6 轮用在对 DeepSeek 文档的 site: 搜索上,一直没搜到写着 deepseek-flash 的那句话。它还有一次把 Python 3.14.8 的发布日期答成 2026-10-01(Python Insider 的发布公告日期是 10 月 1 日),另一次把 Next.js 16.3 博文的日期答成 7 月(那篇博文提到预览版是前一个月发的)。两次看起来都是从摘要里拿了日期,又没法打开原页核对,不过我们没记录摘要,无法完全证实。不过 Scholar 同样没有抓取工具,却拿了 60/60,可见摘要质量和有没有抓取工具一样要紧。
找一个不存在的东西(Tavily)。 4TB iPhone 那道题,Tavily 三次里有两次一直搜索、提取网页,直到 6 轮用完也没写 FINAL 行。其中最贵的一次花了 $0.078,是全部 420 次里最高的,剩下那次答了 null。只靠轮数上限加一句“确认不了就答 null”,拦不住 Agent 去找一个根本不存在的价格。
普通 GET 验证不了的引用(Firecrawl、Exa Answer)。 Firecrawl 的 5 次引用失败,答案其实都是对的:
- 两次引用了
blog.rust-lang.org/releases/latest/。这是个跳转页,只有一个跳到 1.99.0 公告的 meta refresh。 - 三次引用了 Apple 中国的 iPhone 18 Pro 产品页,价格不在静态 HTML 里。
Exa Answer 唯一一次失败引用的是 Rust 的发布列表页。浏览器能看到答案,检查引用的脚本看不到。要留审计记录,就让 Agent 给具体文章页,别给落地页。
偶发的抓取错误。 有 3 次 exa/contents 返回 HTTP 503,上游报“必须提供 ids”,可请求体里明明有 ids,同样的请求在别的运行里也正常。Agent 退回去用搜索摘要,答案仍然是对的。
成本和计费
420 次计分运行一共用了 1,368,972 个输入 token 和 47,195 个输出 token,按标价是 $3.21。算上 Exa 第一轮($0.54)、28 次的预跑($0.28)和下面的示例程序,LLM 总花费约 $4.04,6 次截图另花了约 $0.03。搜索当天是免费的:所有端点基础价格都是 $0,我们用 GET /v1/tasks/<id>/cost 抽查了 27 个 run id(每个端点 3 个),返回的都是 "cost": "0.000000"、settled: true。GET /v1/tasks/<id>/cost 和 GET /v1/models/<id> 都需要和调用相同的 Authorization: Bearer Key;没有 Key 的话,可以在 sandbase.ai 的公开模型页面看到同样的价格。Exa 自己的返回里带一个 costDollars 字段,比如某次搜索是 0.007,那是 Exa 上游的数字,不是 SandBase 实际扣的钱。
所以表里的成本差异全是 LLM token,而且几乎都是输入。有工具的配置每题输出中位数都在 80 到 115 个 token 之间,输入中位数却从 711(Exa Answer)、919(Scholar)一直到 4,334(Firecrawl)和 5,493(Tavily)。真正让成本上去的是抓网页:60 次运行里,Tavily 的 Agent 抓了 79 次网页,Firecrawl 58 次,Exa 53 次。按中位数算,每天 1,000 道这类题,LLM 成本大约是 Exa Answer $2.30、Scholar $2.60、Exa $7.70、Tavily $12.10,免费周结束后还要加上搜索本身的费用。
怎么选
| 你的需求 | 先试 | 但要注意 |
|---|---|---|
| 短事实查询,又便宜又对 | Scholar 网页搜索:60/60,每题 $0.0026,耗时中位数最短 | 没有抓取工具,事实得出现在类似 Google 的摘要里 |
| 让厂商替你读网页 | Exa Answer:60/60,$0.0023 | 有一次引用的是列表页,你能看到的证据也更少 |
| 需要网页全文做深读或抽取 | Exa(搜索 + 正文):60/60,51 次引用全部有效 | 要兼容两种响应结构;成本大约是 Scholar 的 3 倍 |
| 要从 JS 很重的页面拿干净的 markdown | Firecrawl(搜索 + 抓取):60/60 | 有 5 次引用普通 GET 验证不了(跳转页、前端渲染的价格) |
| 想用 Tavily 的搜索 + 提取组合 | Tavily:51 次可回答题全对,引用全部有效 | 成本最高;错误前提的价格题有两次把轮数用完 |
| 需要日期过滤和地区化结果 | Cloudsway,支持 start_date、end_date、country(这次没用) | 只有摘要时 55/60;p90 耗时最长(31.8 s) |
这不是搜索质量排名。前 4 套配置准确率打平,20 道题、每题 3 次分不出它们的高下。所以 Research Agent 该用哪家搜索 API,要看哪一行最贴近你的业务,而不是看单一分数。
一个可以直接跑的单工具 Research Agent
下面是 Scholar 配置的精简版:一个搜索工具、GPT-6.1 Sol、FINAL 行,外加引用检查。它调用 POST https://api.sandbase.ai/v1/api/scholar/search-web,先按文档从 outputs[0].data 读数据。因为 2026-10-03 实测返回过别的结构,它也接受 outputs[0] 和顶层 output,运行没 completed 就直接报错。results[].title、link、snippet 这几个字段名是我们在响应里看到的,不是文档承诺。
import os
import re
import json
import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
MODEL = "openai/gpt-6.1-sol"   # $2 / $10 per million tokens on SandBase (2026-10-03)
SYSTEM = ("You are a research agent. Today's date is 2026-10-03. Answer with the tools you have. "
          "Prefer primary sources such as official sites, release notes, docs and press releases. "
          "If the thing asked about does not exist, has not happened yet, or you cannot find it, answer null. "
          'End with exactly one line: FINAL: {"answer": <value or null>, "source_url": <URL or null>}')


def read_payload(body: dict):
    """Return the business payload of a completed SandBase run.
    The API reference documents outputs[0].data. On 2026-10-03 the search endpoints we called also
    returned it as outputs[0] itself or as a top-level `output` object, so accept all three."""
    if body.get("status") != "completed":
        raise RuntimeError(f"run {body.get('id')} not completed: {body.get('status')} {body.get('error')}")
    outputs = body.get("outputs")
    if outputs:
        first = outputs[0]
        return first["data"] if "data" in first else first
    if "output" in body:
        return body["output"]
    raise RuntimeError(f"run {body.get('id')} has no payload")


def web_search(query: str) -> dict:
    """One search tool: SandBase scholar/search-web, trimmed to 5 results."""
    resp = requests.post(f"{BASE}/api/scholar/search-web", headers=HEADERS,
                         json={"query": query, "max_num_results": 5}, timeout=120)
    resp.raise_for_status()
    data = read_payload(resp.json())
    results = data.get("results") or []          # observed field names: results[].title/link/snippet
    return {"results": [{"title": r.get("title"), "url": r.get("link"),
                         "snippet": (r.get("snippet") or "")[:500]} for r in results]}


TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "Search the web. Returns up to 5 results with title, url and a short snippet.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}]


def ask(question: str, max_turns: int = 6) -> dict:
    messages = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": question}]
    tokens_in = tokens_out = searches = 0
    for _ in range(max_turns):
        resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS, timeout=240,
                             json={"model": MODEL, "max_tokens": 2000,
                                   "tools": TOOLS, "messages": messages})
        resp.raise_for_status()
        body = resp.json()
        tokens_in += body["usage"]["prompt_tokens"]
        tokens_out += body["usage"]["completion_tokens"]
        msg = body["choices"][0]["message"]
        messages.append({k: v for k, v in msg.items() if k in ("role", "content", "tool_calls")})
        if not msg.get("tool_calls"):
            match = re.search(r"FINAL:\s*(\{.*\})", msg.get("content") or "", re.S)
            final = json.loads(match.group(1)) if match else {"answer": None, "source_url": None}
            cost = tokens_in * 2 / 1e6 + tokens_out * 10 / 1e6
            return {**final, "searches": searches, "tokens_in": tokens_in, "tokens_out": tokens_out,
                    "llm_cost_usd": round(cost, 5)}
        for call in msg["tool_calls"]:
            args = json.loads(call["function"].get("arguments") or "{}")
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": json.dumps(web_search(**args), ensure_ascii=False)})
    raise RuntimeError("turn limit reached without a FINAL line")


def citation_supports(url, forms) -> bool:
    """The cited page must load (HTTP 200) and contain one surface form of the answer."""
    if not url:
        return False
    page = requests.get(url, headers={"User-Agent": "Mozilla/5.0"}, timeout=40)
    text = re.sub(r"\s+", "", page.text).casefold()
    return page.status_code == 200 and any(re.sub(r"\s+", "", f).casefold() in text for f in forms)


if __name__ == "__main__":
    result = ask("On what date was Go 1.27 released? Answer as YYYY-MM-DD.")
    result["citation_ok"] = citation_supports(result["source_url"], ["2026-08-19", "19 August 2026"])
    print(json.dumps(result, indent=1))
实测时间 2026-10-03(UTC)。 我们在 13:50 UTC 原样运行了上面的程序,输出 "answer": "2026-08-19"、"source_url": "https://go.dev/blog/go1.27",搜索 1 次,输入 764、输出 59 个 token,"llm_cost_usd": 0.00212,"citation_ok": true。GET /v1/tasks/<id>/cost 显示两次 GPT-6.1 Sol 调用分别计费 $0.000598 和 $0.001520(task id 79244a1b-2cd3-4582-a5e8-98f416320c91 和 d92957ee-d669-4e52-9ee0-20410ea080d0),合计 $0.002118,Scholar 调用 $0.000000。另外在 13:49 UTC 单独发了一次请求:POST https://api.sandbase.ai/v1/api/scholar/search-web,请求体 {"query": "Go 1.27 release date", "max_num_results": 5},返回 5 条结果。精简后的响应:
{"id": "d43afca6-3012-4a78-b484-8e929f9c98de", "status": "completed", "model": "scholar/search-web",
 "output": {"results": [
   {"title": "Go 1.27 Release Notes", "link": "https://go.dev/doc/go1.27",
    "snippet": "The latest Go release, version 1.27, arrives in August 2026, six months after Go 1.26. Most of its changes are in the implementation of the toolchain, runtime, ..."},
   {"title": "Go 1.27 is released", "link": "https://go.dev/blog/go1.27",
    "snippet": "Go 1.27 is released Nicholas Husin, 19 August 2026 Today the Go team is pleased to release Go 1.27. You can find its binary archives and ..."}]}}
只展示 5 条结果中的前 2 条,每条都是完整对象;省略了 output 里的 id 键。摘要末尾的 ... 是接口返回的原文。这次请求和程序运行里的那次搜索,返回的都是顶层 output 结构。想换别家搜索,只需要改 web_search 的请求体。比如 exa/search 在一种结构里返回 results[].url,在另一种里返回 entities[].url。
请求字段见 Scholar 网页搜索 API 文档。获取 SandBase API Key,用你自己的问题跑一遍这个 Agent。
数据范围说明:所有题目都是关于公司、开源项目和政府统计机构的公开网页,不涉及个人。调用需要 SandBase API Key,SandBase 不是 Exa、Tavily、Firecrawl、Cloudsway 或被搜索网站的官方合作方。方法、题型、评分规则和汇总结果都写在本文里;测试程序、标准答案和逐次运行记录留在内部,缓存的网页正文属于第三方内容,不公开。
常见问题
Research Agent 用哪个搜索 API 最好?
在这 20 道题上,Exa(带正文)、Firecrawl(带抓取)、Scholar 网页搜索和 Exa Answer 配 GPT-6.1 Sol 都是 60/60,其中 Scholar 和 Exa Answer 最便宜,每题约 $0.0025。准确率打平了,所以按成本、引用质量、要不要网页全文来选。
Exa 和 Tavily 谁更好?
51 次可回答题两家都全对,有效引用也都是 51/51。Tavily 有两次错误前提题把轮数用完,每题成本中位数 $0.0121,Exa 是 $0.0077。Exa 的响应结构会在两种之间切换,解析代码得两种都兼容。
Research Agent 一定要单独的抓取工具吗?
如果事实会出现在搜索摘要里,就不一定:Scholar 只有搜索也拿了 60/60。同样只有搜索的 Cloudsway 错了 5 次,多半是因为事实没出现在摘要里(我们没有记录摘要)。答案藏在网页深处时抓取工具有用,但在这次测试里它也是最主要的成本来源。
大模型不能直接凭记忆回答吗?
不能。不给工具时,GPT-6.1 Sol 在 51 次可回答题里答了 50 次 null,只蒙对一次 Rust 的发布日期,大概率是根据发布节奏推的。这些都是 2026 年 8 到 10 月的事,只能靠搜索。
在 SandBase 上跑一个靠搜索的 Research Agent 要多少钱?
2026-10-03 当天搜索端点扣费为 $0,按 GPT-6.1 Sol 每百万 token $2/$10 计算,每题 LLM 成本中位数在 $0.0023 到 $0.0121 之间。当时网站在做 API Free Week,上量前先去模型页确认价格。
局限
这次只有 20 道有标准答案的短答题,一个 LLM,每题 3 次,搜索参数全用默认值(没开深度、日期、域名选项),全部在同一天完成。前 4 套配置打平,所以这个测试衡量不了多跳推理、长篇研究这类难题上的检索质量。结果依赖实时索引,而索引会变。Exa 的分数来自我们修好自己的解析代码之后的重跑,第一轮的分数(55/60)也一并列出。引用检查用的是普通 GET:会跟随 HTTP 重定向,但不执行 JavaScript,也不跟随页面内的 meta refresh 跳转,比浏览器严格。耗时是在一台机器上、6 到 7 个任务并发测的。选型之前,用你自己的业务问题按这套方法重跑一遍。