OpenAI Agents API 自托管沙箱:哪些由你控制,哪些仍在云端
OpenAI Agents API 自托管沙箱不等于整个 Agent 本地运行。看清托管执行循环、会话配置、工具回调、文件保存和数据保留限制。
OpenAI Agents API 自托管沙箱:哪些由你控制,哪些仍在云端
把执行环境设成 self_hosted,不等于把整个 Agent 搬进自己的服务器。OpenAI Agents API 的分工是:你的机器运行命令、处理文件,OpenAI 仍负责 Codex 的模型与工具调用循环。正在为产品接入 Agent 的后端开发者,首先要判断的不是“有没有自托管选项”,而是这种分工是否满足项目要求。
OpenAI 更新日志将此次发布列在 9 月 10 日,状态是 public beta,也就是公开测试版。下面依据 9 月 11 日核对的官方文档解释接入边界,不是 SandBase 实测,也不代表 SandBase 已上线这个接口。
先说结论
- 自托管的是执行环境,Codex harness(管理模型和工具循环的程序)仍由 OpenAI 运行。
- 只用远程 MCP 或应用函数时,可以不配置沙箱,但不能因此获得内建终端和工作区。
- 自托管环境的启动、重连、关闭和文件保存仍归应用负责。
- 当前 Agents API 只支持美国数据驻留,不支持零数据保留;自托管沙箱也不能绕过这一限制。
OpenAI Agents API 自托管沙箱控制的是哪一部分
官方架构文档开头写得很直接:
“OpenAI runs the agent harness. Your application sends it work and receives results.”
这里有三个组成部分:OpenAI 运行的 harness、执行命令和存放文件的环境,以及你自己的应用后端。后端提交任务、接收事件、处理函数工具;如果环境由你提供,还要管理它的生命周期。
假设你做的是一个构建失败排查助手。它需要读取代码仓库、依赖和内部构建日志。把这些操作放进自己的环境,解决的是“命令在哪里执行”。用户问题、排查过程和后续追问如何进入托管会话,是另一件事。
因此,不能只在方案上写“Agent 自托管”,就推导出所有处理都发生在内网。更准确的描述是“OpenAI 托管模型与工具调用循环,连接我们提供的计算环境”。接下来才有办法逐项核对哪些数据会交给哪个组件。
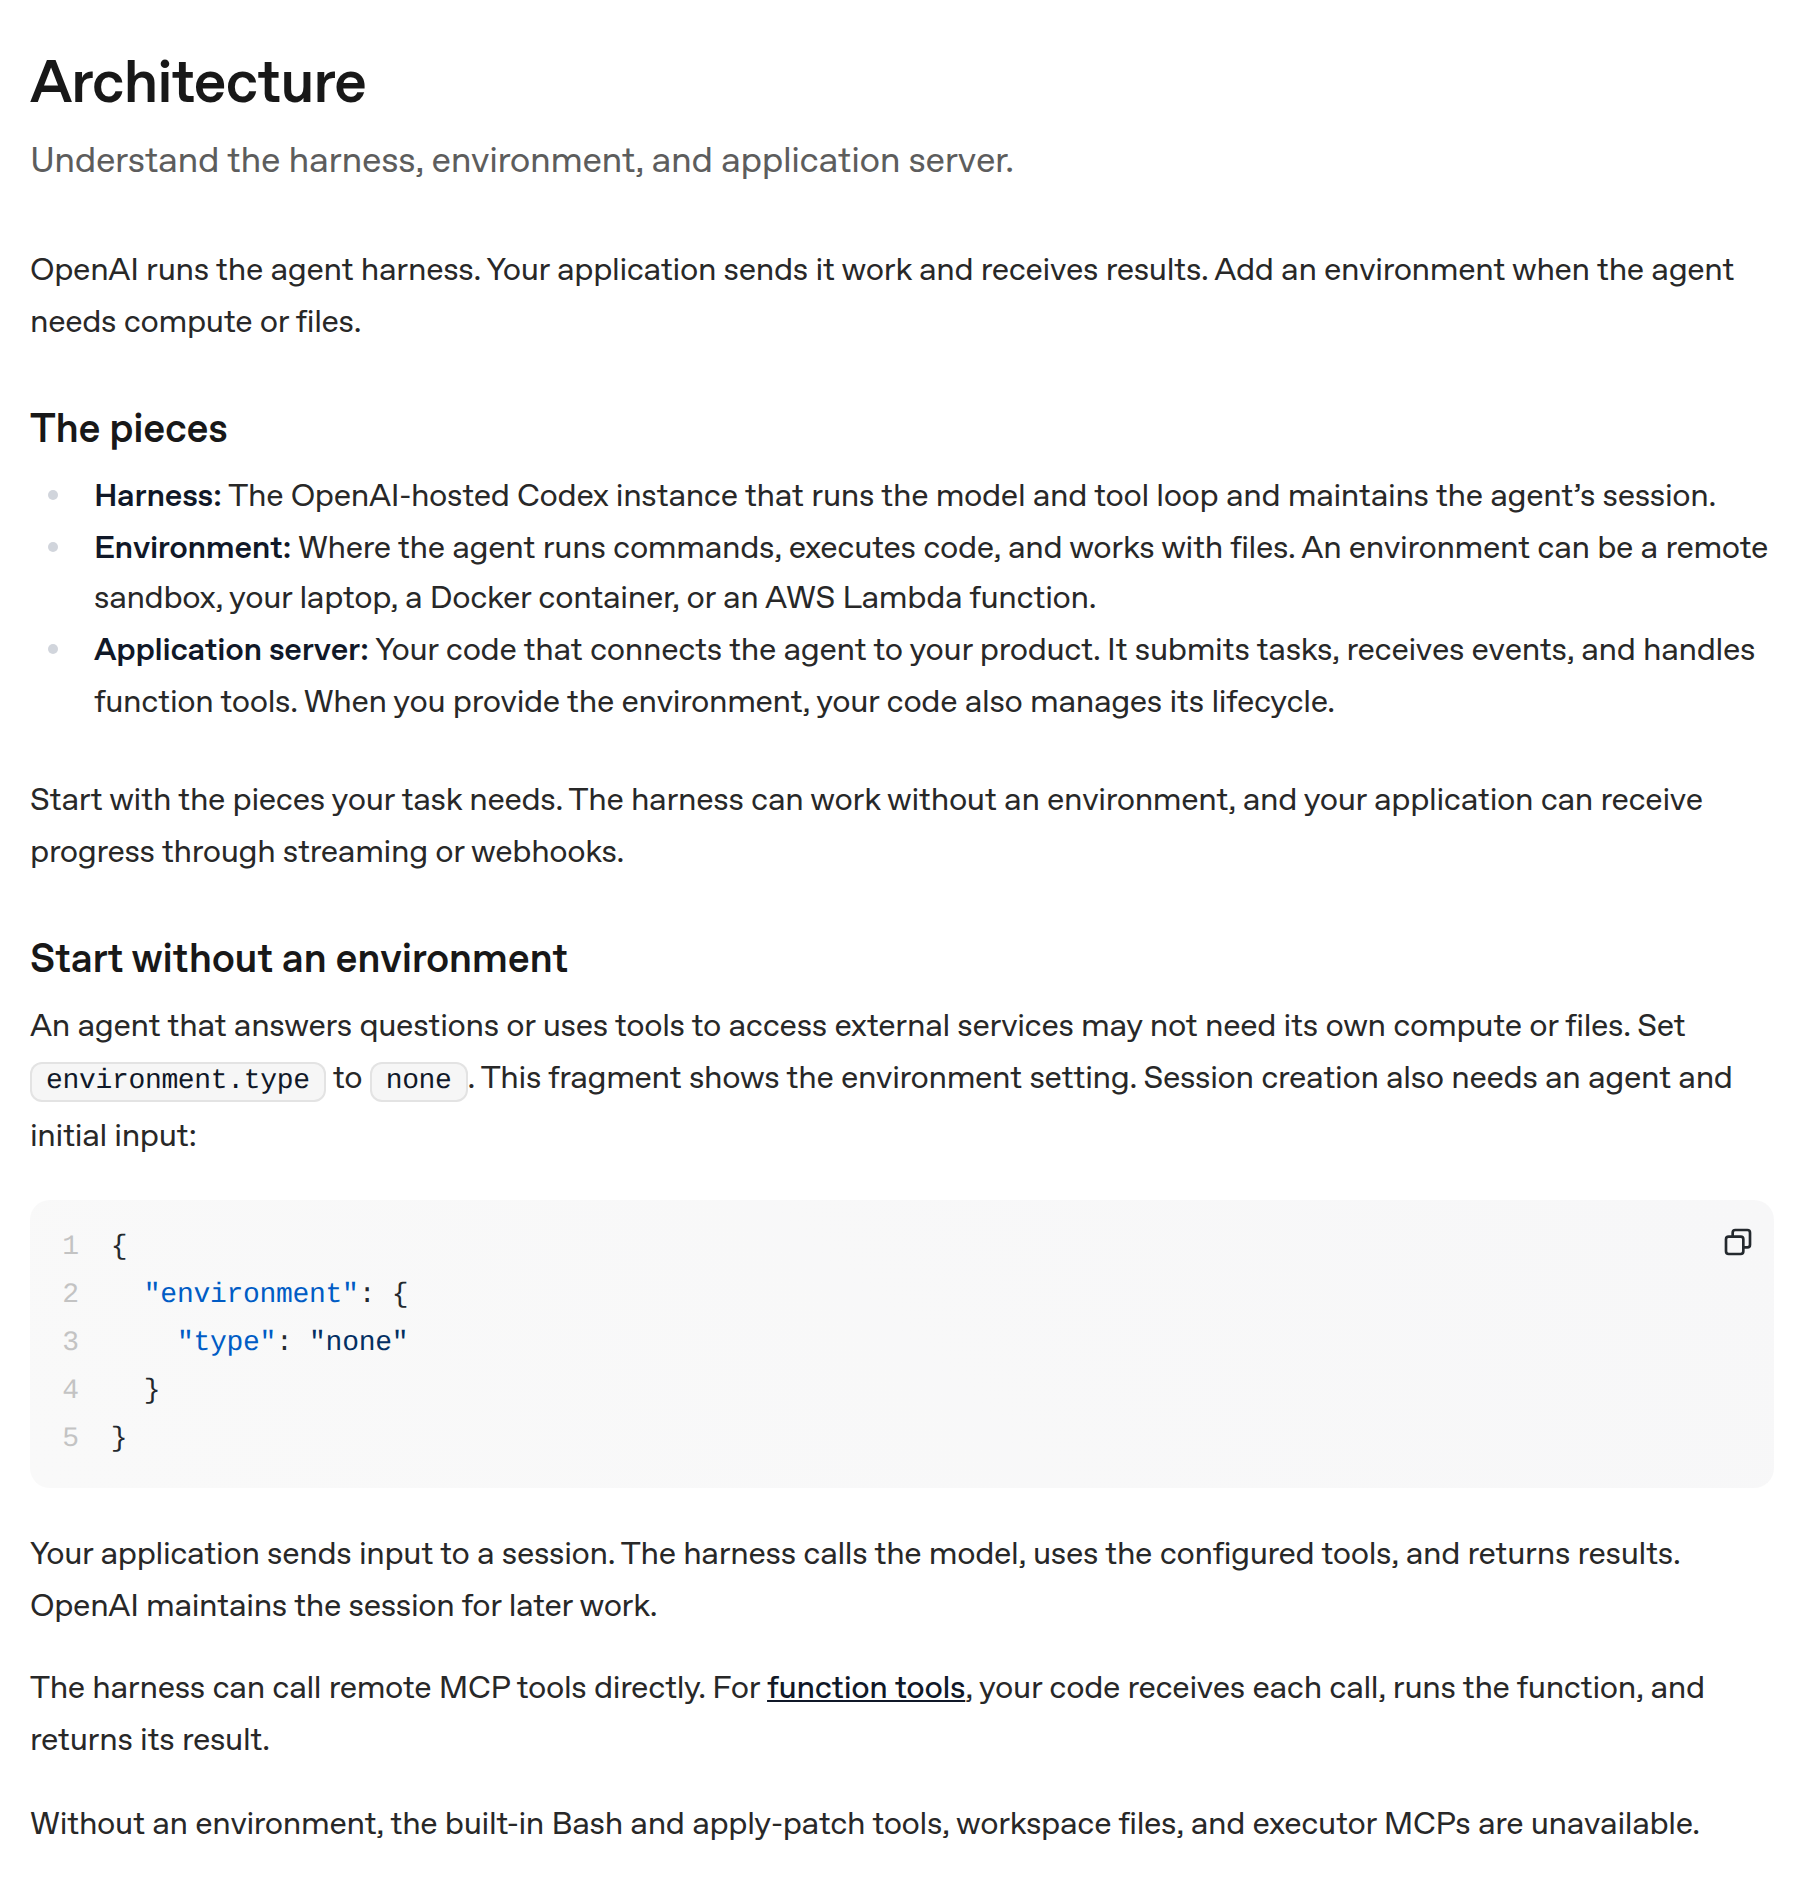
官方文档分别列出三个组件,并说明 none 模式缺少哪些内建工具。来源:OpenAI 架构文档,2026 年 9 月 11 日截图。
不需要文件和终端,就先别加沙箱
官方提供三种环境设置,差别是计算能力放在哪里,不是三个不同档次的模型。
| 设置 | 适合先评估的任务 | 需要注意 |
|---|---|---|
none | 通过远程工具查资料、回答问题 | 没有内建 Bash(命令行)、apply-patch(文件修改工具)和工作区文件 |
openai_hosted | 跑脚本、编辑文件、生成交付物 | OpenAI 管理沙箱,你配置软件包、初始文件和网络 |
self_hosted | 使用自有基础设施、内网或特殊软件 | 你负责计算资源、执行器连接和环境维护 |
例如,一个只读文档助手,如果所有材料都能通过远程 MCP 获取,就不一定需要终端。MCP 是让 Agent 调用外部工具的连接协议;它不等于一个文件系统。
反过来,需要修改代码的任务,也不能把 none 理解成“平台会自动补一个沙箱”。官方确实提到可以用应用函数实现虚拟运行环境,但那部分需要自己做,不是这个参数附赠的能力。先列出任务必须执行的动作,再选环境,比默认开一整套终端更容易检查权限。
会话覆盖工具列表时,不是追加
配置文档区分了可复用的 agent 配置和具体 session。前者保存模型、指令、工具等设置;后者保存本次工作的对话与过程。多个任务可以复用配置,但不等于共用一段会话。
一个容易漏看的规则是:会话传入的对象和数组会替换整个字段,不会自动合并。官方明确举了 tools 的例子。
假设保存的配置有几个工具,本次任务只传了一个新工具。结果不是“原来的工具再加一个”,而是原列表被替换。应用如果只是想补充能力,应先组装并检查完整工具列表,不能按普通配置合并的习惯猜测。
文档还说明凭证放在 vaults(保存工具凭证的保险库)中,与保存的 agent 配置分离。不要把“可复用配置”理解成可以把密钥直接塞进指令。用户能否继续某个会话,也应该由应用的访问控制决定,而不是只看有没有 agent ID。
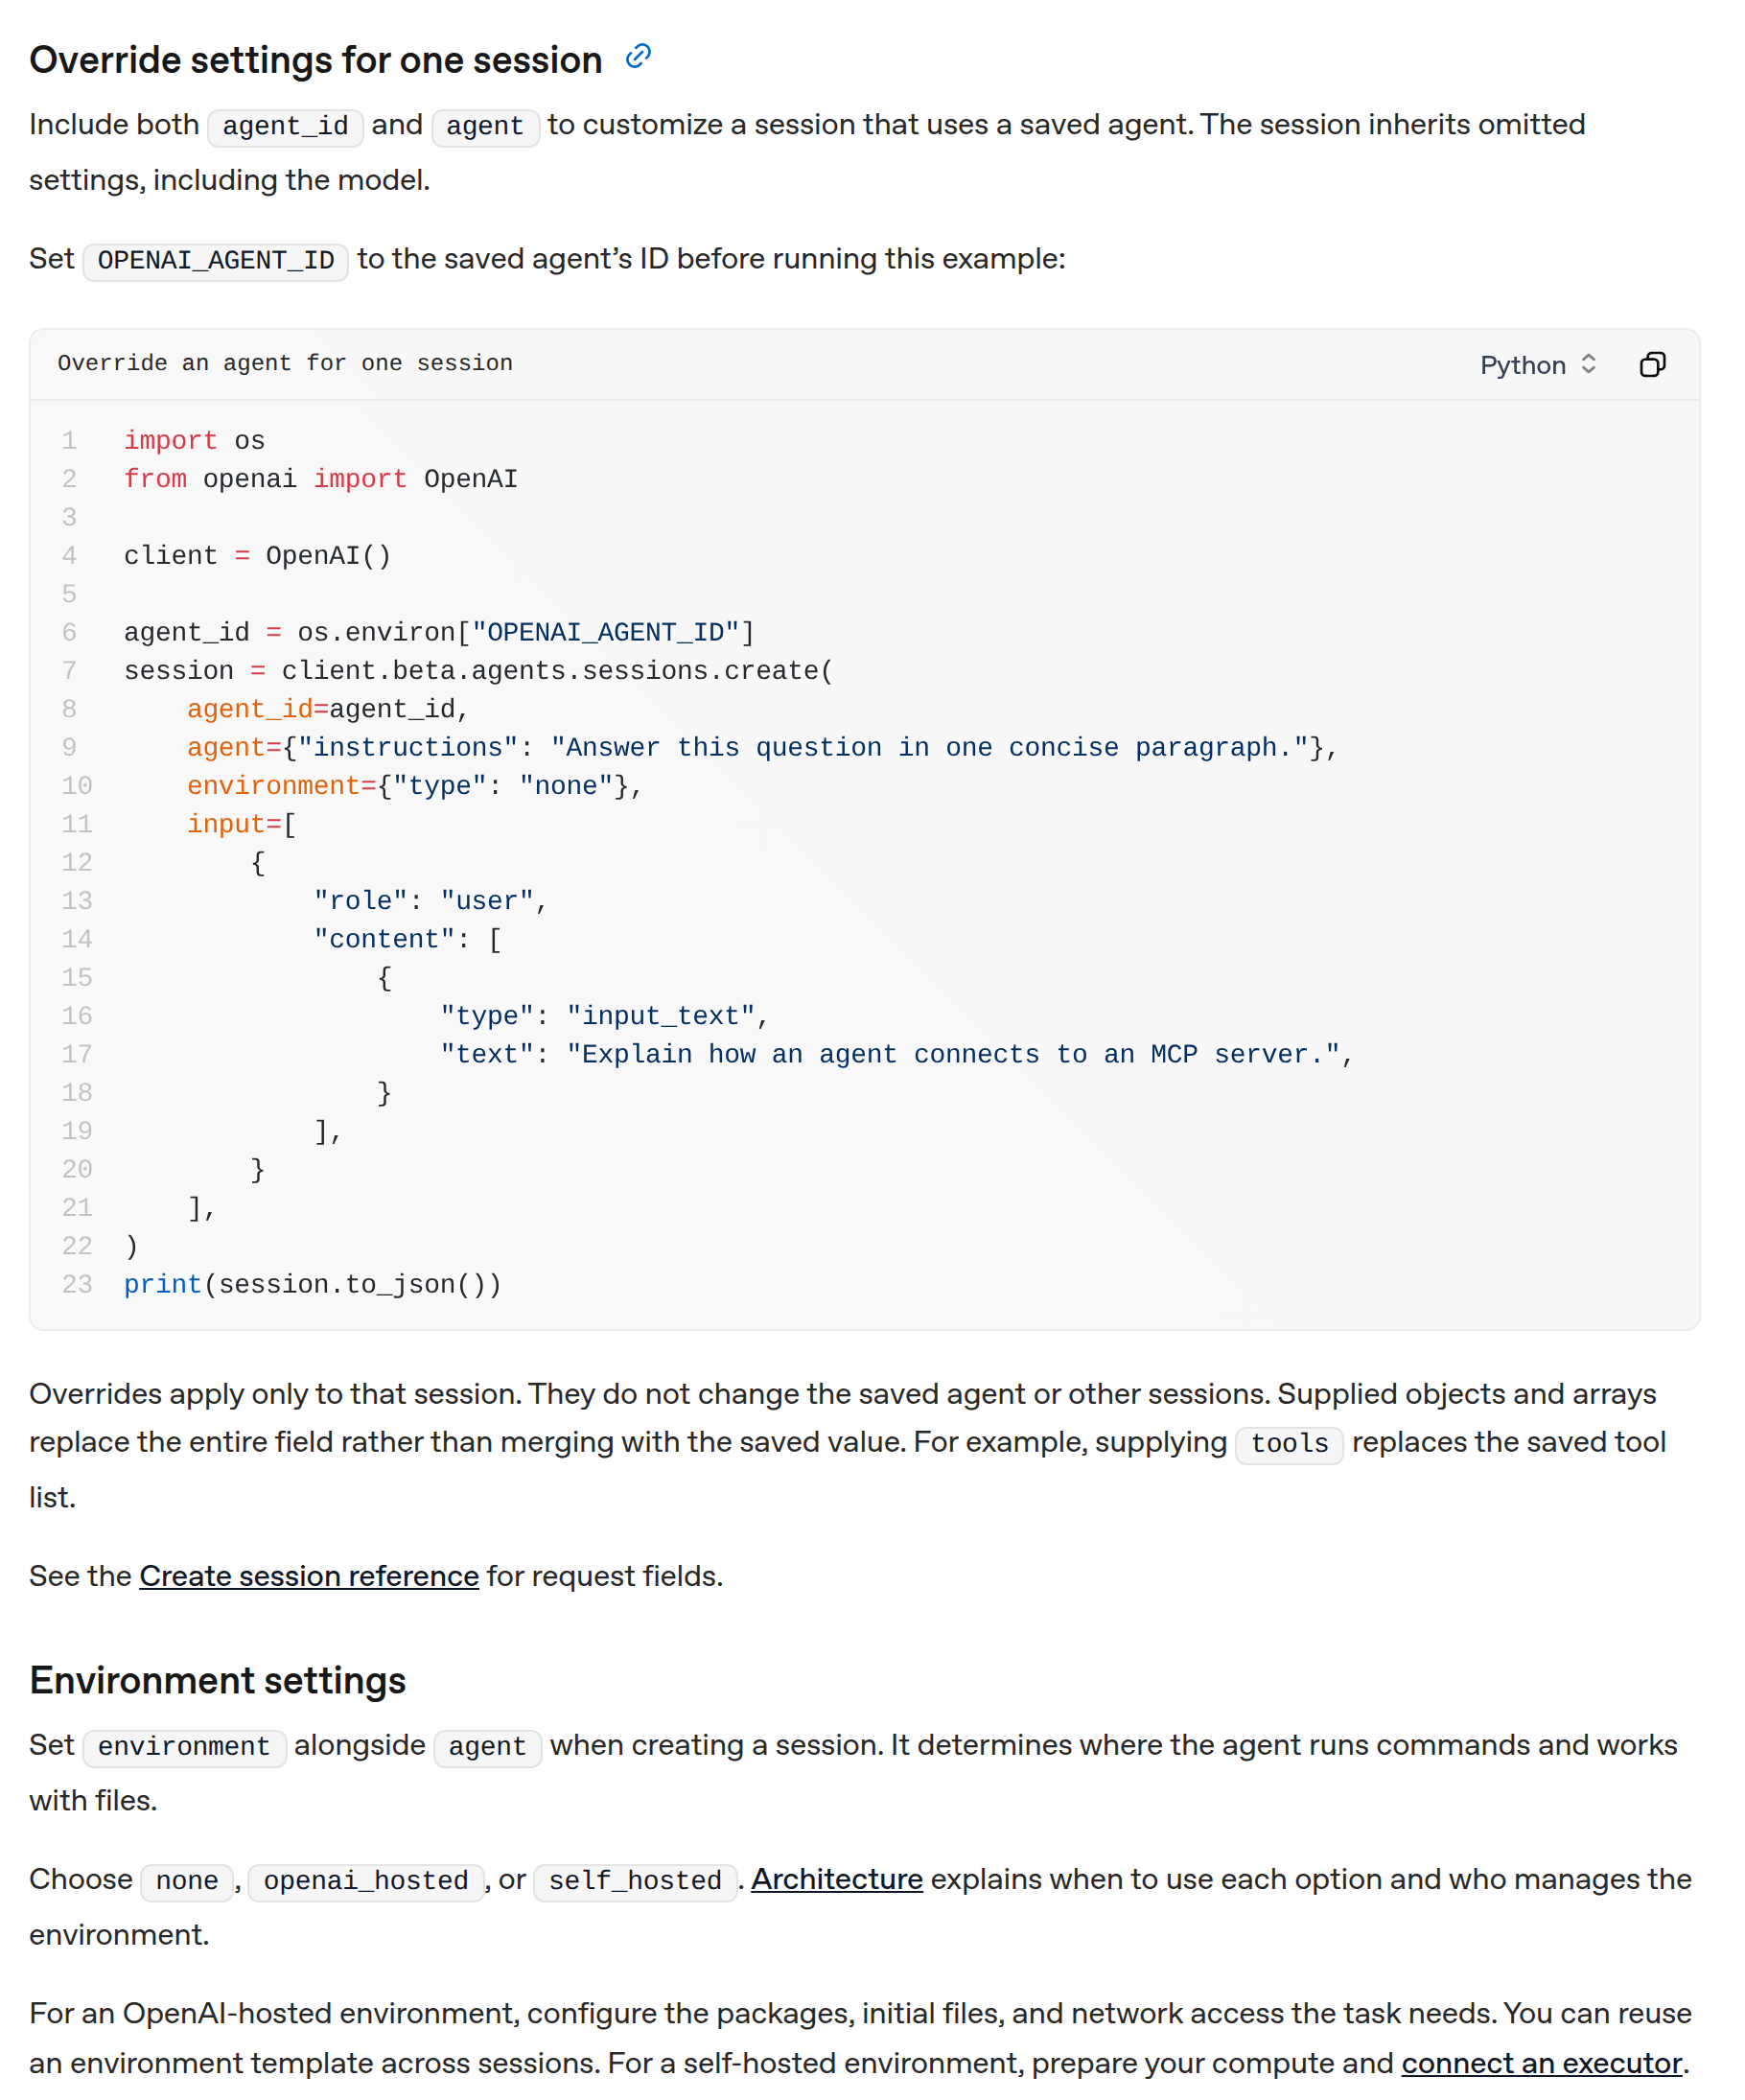
会话覆盖示例下方明确说明:对象和数组替换整个字段,传入工具列表不是追加。来源:OpenAI 配置文档,2026 年 9 月 11 日截图。
自己的机器谁来启动,什么时候能关
self_hosted 模式需要应用启动环境,再连接 executor,也就是接收并执行命令的执行器。你不必亲自转发每一条命令,但官方仍把资源创建、重连、关闭和文件保存列为应用责任。
这里不能只看“创建会话的请求成功了”。请求成功不等于工作进程已经就绪,也不等于文件会在环境关闭后保留。官方特别提醒:停止计算资源前,要协调新任务,并确认没有待执行工作。
对于代码排查助手,合理的接入检查可以是:给它一个只读任务,中途断开执行器,恢复连接后再查看任务状态和文件,然后检查关闭环境后的交付物。这是建议做的测试,本文没有实际执行,也没有据此承诺恢复时间。
持久会话和持久文件不是同一件事。如果最终要给用户一份报告或补丁,应用应明确在哪一步验证并保存它,而不是把“会话可继续”当成文件备份保证。
页面有进度,不代表工具有人接
Agents API 支持流式事件,也支持 webhook(状态变化时发给后端的通知)。两者可以组合使用,但都不能代替函数工具的处理程序。
官方架构文档提醒:函数处理程序不可用时,Agent 可能一直等待结果。假设排查任务请求读取内部构建日志,托管 harness 可以发起调用,却不能替缺失的后端程序返回日志。
因此,产品里最好区分“模型正在工作”和“等待工具结果”。远程 MCP 又是另一条路径,harness 可以直接调用它。设计重试前,先确认这次调用究竟由谁执行、谁返回结果,不能把所有工具错误都归成模型没响应。
自托管不等于零数据保留
官方概览明确说明:Agents API 保留会话状态,当前仅支持美国数据驻留,不支持 Zero Data Retention,简称 ZDR,即零数据保留。选择自托管沙箱也不会让这个 API 获得 ZDR 资格。
如果项目要求是“在内网运行我们自己的软件”,自托管值得评估。如果要求是“这个接口必须支持 ZDR”,按当前文档就不符合。两个要求不能混成一个“支持私有化”的勾选框。
文档允许删除不再需要的会话和已发布交付物,但“可以删除”也不能改写成“从不保留”。本文没有核实具体保留时长或合同例外;这些应继续查阅平台数据控制说明,不能从沙箱位置推断。
费用与第一步接入怎么判断
官方概览列的是几类费用:所选模型按 API 费率、OpenAI 工具按标准费率、OpenAI 托管沙箱按容器费率计费。它不是一个固定的“每次 Agent 任务价格”。
做预算时,应分别记模型、工具和执行环境。使用自己的机器,也还要计算自有基础设施费用,不能因为没有托管沙箱就把模型使用算成免费。本文没有运行计费实验,不给每任务价格或节省比例。
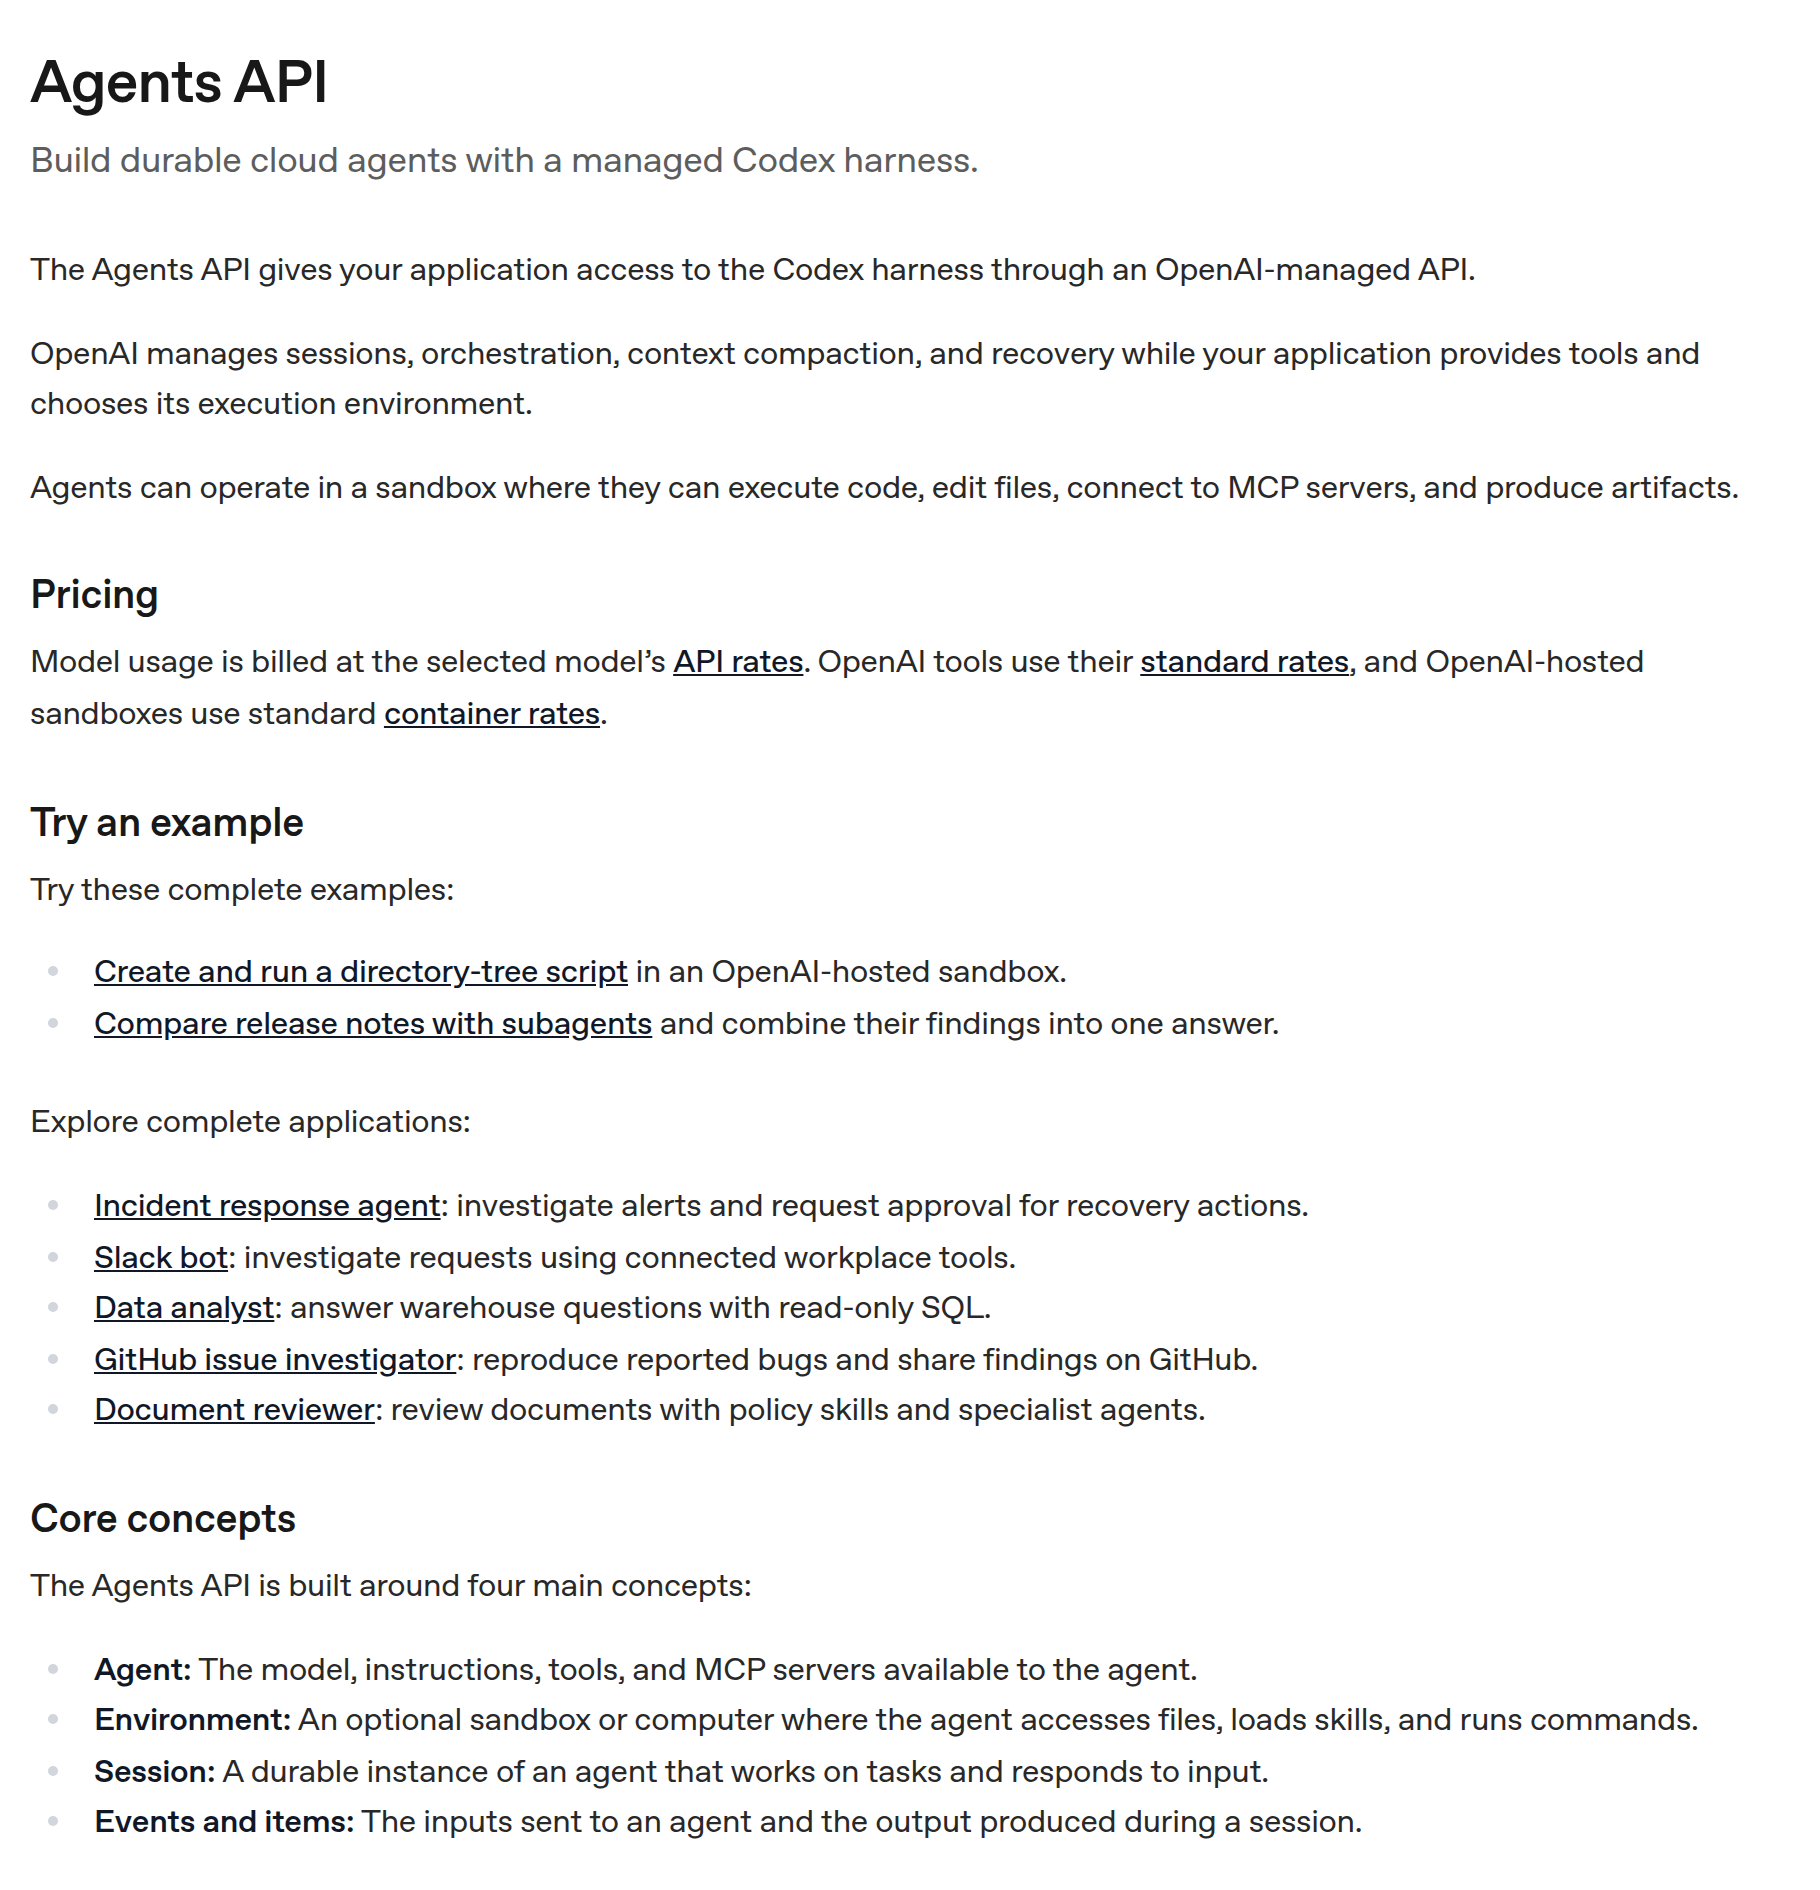
概览把模型、工具和托管容器分开计费,没有给出固定的每任务价格。来源:OpenAI 概览,2026 年 9 月 11 日截图。
如果目标是少维护一套模型与工具循环,同时仍能选择命令运行的位置,可以从一个非敏感、范围明确的任务开始评估。先检查工具列表、断开后的状态以及交付物能否保存,再考虑扩大使用。
已有的 Codex App Server 文章讨论本地进程和客户端协议;这次的新问题是托管 API 的责任分工。接入下一步可看官方快速开始。但如果美国数据驻留或不支持 ZDR 已经不符合项目要求,就没有必要先搭完沙箱再发现这一点。