X/Twitter 帖子快照 API:验证一次读取 | SandBase
用精确字符串 ID 读取一条 X/Twitter 帖子,核对状态与身份、保留计数类型,再规划后续比较。
做监测,先要有一份可信的观察记录。选定一条 X 帖子,保留精确 ID,读取资料后核对身份,再决定哪些字段能用于分析。本文实现的是这一步,不会自动搜索话题、启动定时轮询,也不会接着给作者建档。
本文于 2026-11-08 修订,依据免费 inspect 和公开保存的参考资料,没有新执行业务调用或监测区间。原网址保留 realtime 字样,但同步响应不等于流式数据、已验证的新鲜度或实时计数保证。关键词指南与账号资料 hub是另外的任务。
先说结论
- 向 POST /v1/api/twitter/web/tweet-detail 发送精确的 tweet_id 字符串,不传整数或整条 URL。
- 先检查 completed,再检查扁平 outputs[0].data、active 状态与一致的字符串 id。
- 保留 views 字符串、各项独立计数及 null;缺失不等于零,单个快照不能测增长。
- 五份保存样本的选定计数相同,不能据此证明上升趋势或一套正在运行的监测系统。
保留封面是旧搜索、帖子、作者链路的概念插画,不是正在运行的监测器。虚构 SandBase 帖子、徽标、18.6K 粉丝数、互动数字与“20x faster”文案都不是账号证据或实测性能。
先选定一条帖子
Tweet Detail API 要求 tweet_id 为字符串。例如选定帖子链接中的数字 ID 可保留为 "1808168603721650364"。从明确选择的 URL 或可信记录复制原始数字,不要混入用户名、conversation_id、媒体 ID 或作者 rest_id。
大整数帖子 ID 可能超出 JavaScript 的安全整数范围。保留原字符串,不能先转 Number 再转回文本;舍入丢失的位数无法恢复。下面的 Python helper 同样会在联网前拒绝数值、布尔值、空白、URL 和非数字文本。正十进制校验是本教程的保守本地规则,registry 的字段类型为必填字符串。
这次请求没有 page 或 cursor。如果手里只有话题,先通过独立的关键词流程选定帖子。旧文“重复携带上一次请求的 cursor”没有建立从响应读取续页状态的依据,不再作为当前指导;本次单帖读取也不涉及分页。
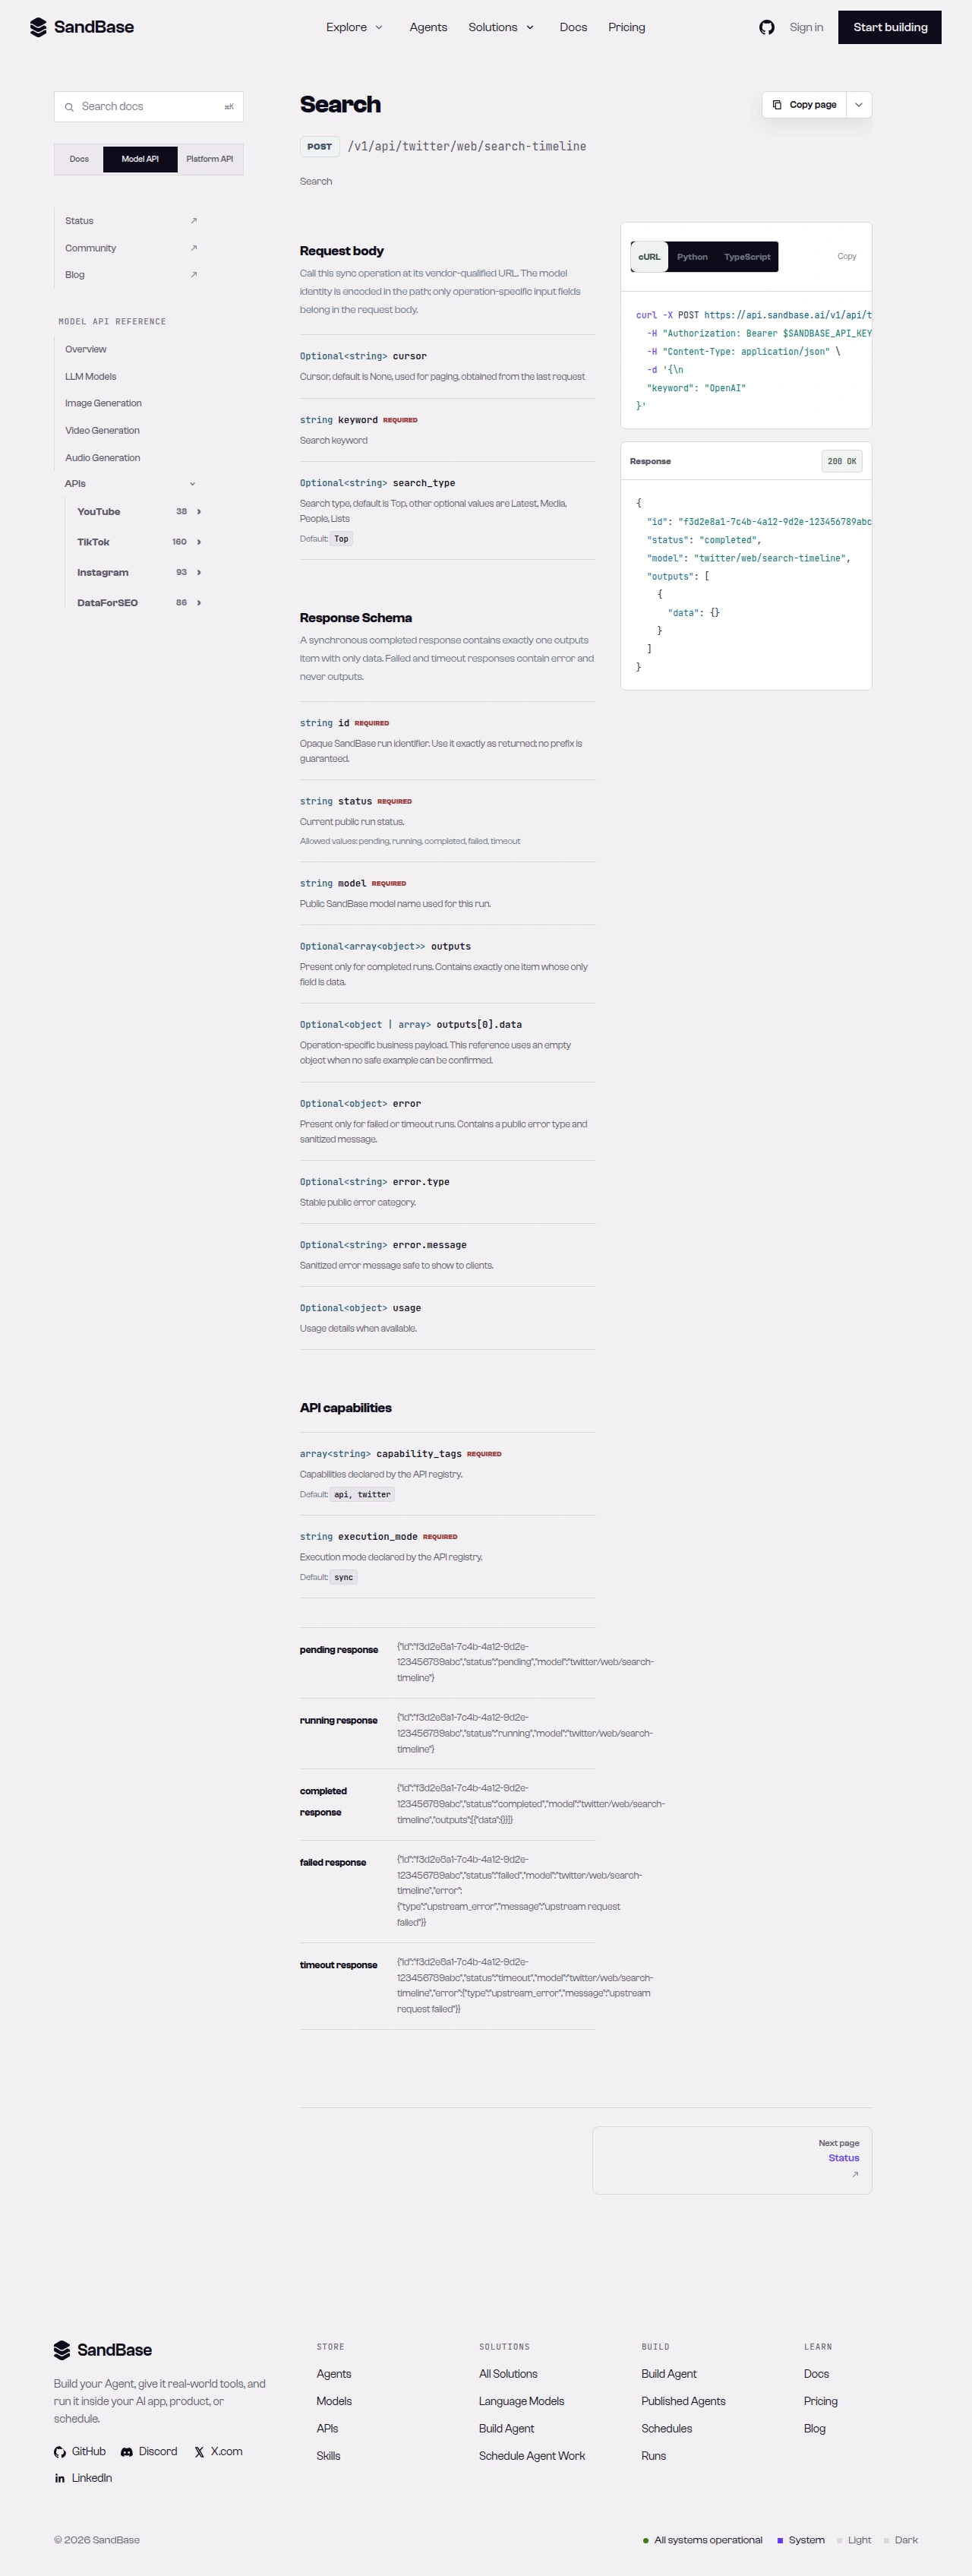 历史 search-timeline 参数截图,只展示搜索接口,并非旧三步流程的全部参数。本轮未验证搜索与分页,图中的示意信封也不是已保存的帖子业务结果。
复用现有接入方式
已有 SANDBASE_API_KEY 时,复用环境变量或密钥管理器。Agent 已连接,就给它选定的帖子 ID 和所需字段,不必重新开户,也不要把 key 粘贴进聊天。新项目可提供 setup Skill、Markdown quickstart和具体 Tweet Detail 页面;人工步骤见接入指南。
可以这样交代任务:“按这个精确 ID 读取一次帖子快照,核对业务状态和返回身份,保留可选字段原值并报告缺失项。响应后停止,不找替代帖子、不打开链接、不补抓作者。”这次公开读取使用 SandBase Bearer 鉴权,不授权发帖、私信或账号操作,SandBase 也不拥有 X。
执行一次有边界的请求
在 Python 环境安装 requests,并在本地配置 key。将主程序中的 ID 替换为你选定的精确字符串。示例只打印身份和已有字段名,不会假设每个可选字段都存在,也不会自动生成完整监测报告。
import os
import re
import requests

URL = "https://api.sandbase.ai/v1/api/twitter/web/tweet-detail"


def first_snapshot(tweet_id):
    if not isinstance(tweet_id, str) or not re.fullmatch(r"[1-9][0-9]*", tweet_id):
        raise ValueError("Provide the selected post's exact positive decimal ID as a string")
    key = os.environ.get("SANDBASE_API_KEY", "").strip()
    if not key:
        raise ValueError("Set SANDBASE_API_KEY in your environment")
    try:
        response = requests.post(
            URL,
            headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
            json={"tweet_id": tweet_id}, timeout=(10, 90), allow_redirects=False,
        )
        if not 200 <= response.status_code < 300:
            raise RuntimeError(f"SandBase HTTP {response.status_code}; request stopped")
        body = response.json()
    except requests.RequestException:
        raise RuntimeError("Network request failed; no retry or additional lookup made") from None
    except ValueError:
        raise RuntimeError("SandBase returned invalid JSON") from None
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("SandBase request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Missing documented outputs[0]")
    data = outputs[0].get("data")
    if not isinstance(data, dict):
        raise RuntimeError("Missing documented outputs[0].data object")
    if data.get("status") != "active":
        raise RuntimeError("Response is not the supported active-post reference shape")
    if not isinstance(data.get("id"), str) or data["id"] != tweet_id:
        raise RuntimeError("Missing or mismatched selected post identity")
    return data


if __name__ == "__main__":
    post = first_snapshot("1808168603721650364")
    print("Selected post:", post["id"])
    print("Returned fields:", sorted(post))
active 检查对应保存参考里本地支持的帖子状态,不是臆造一套完整上游状态分类。遇到其他状态或缺失状态,应停止“已读取活跃帖子”的报告,不能直接解释为帖子删除、空成功或全零观察记录。
业务对象是扁平的,不要再套 data.tweet、搜索结果数组或通用 code/message 成功判断。外层 run ID 标识 SandBase 请求,内层 id 才是选定帖子。completed 不能代替身份核验;反过来,空文本也不能独立证明帖子不存在,某些以媒体为主的内容可能不适合做文本分析。
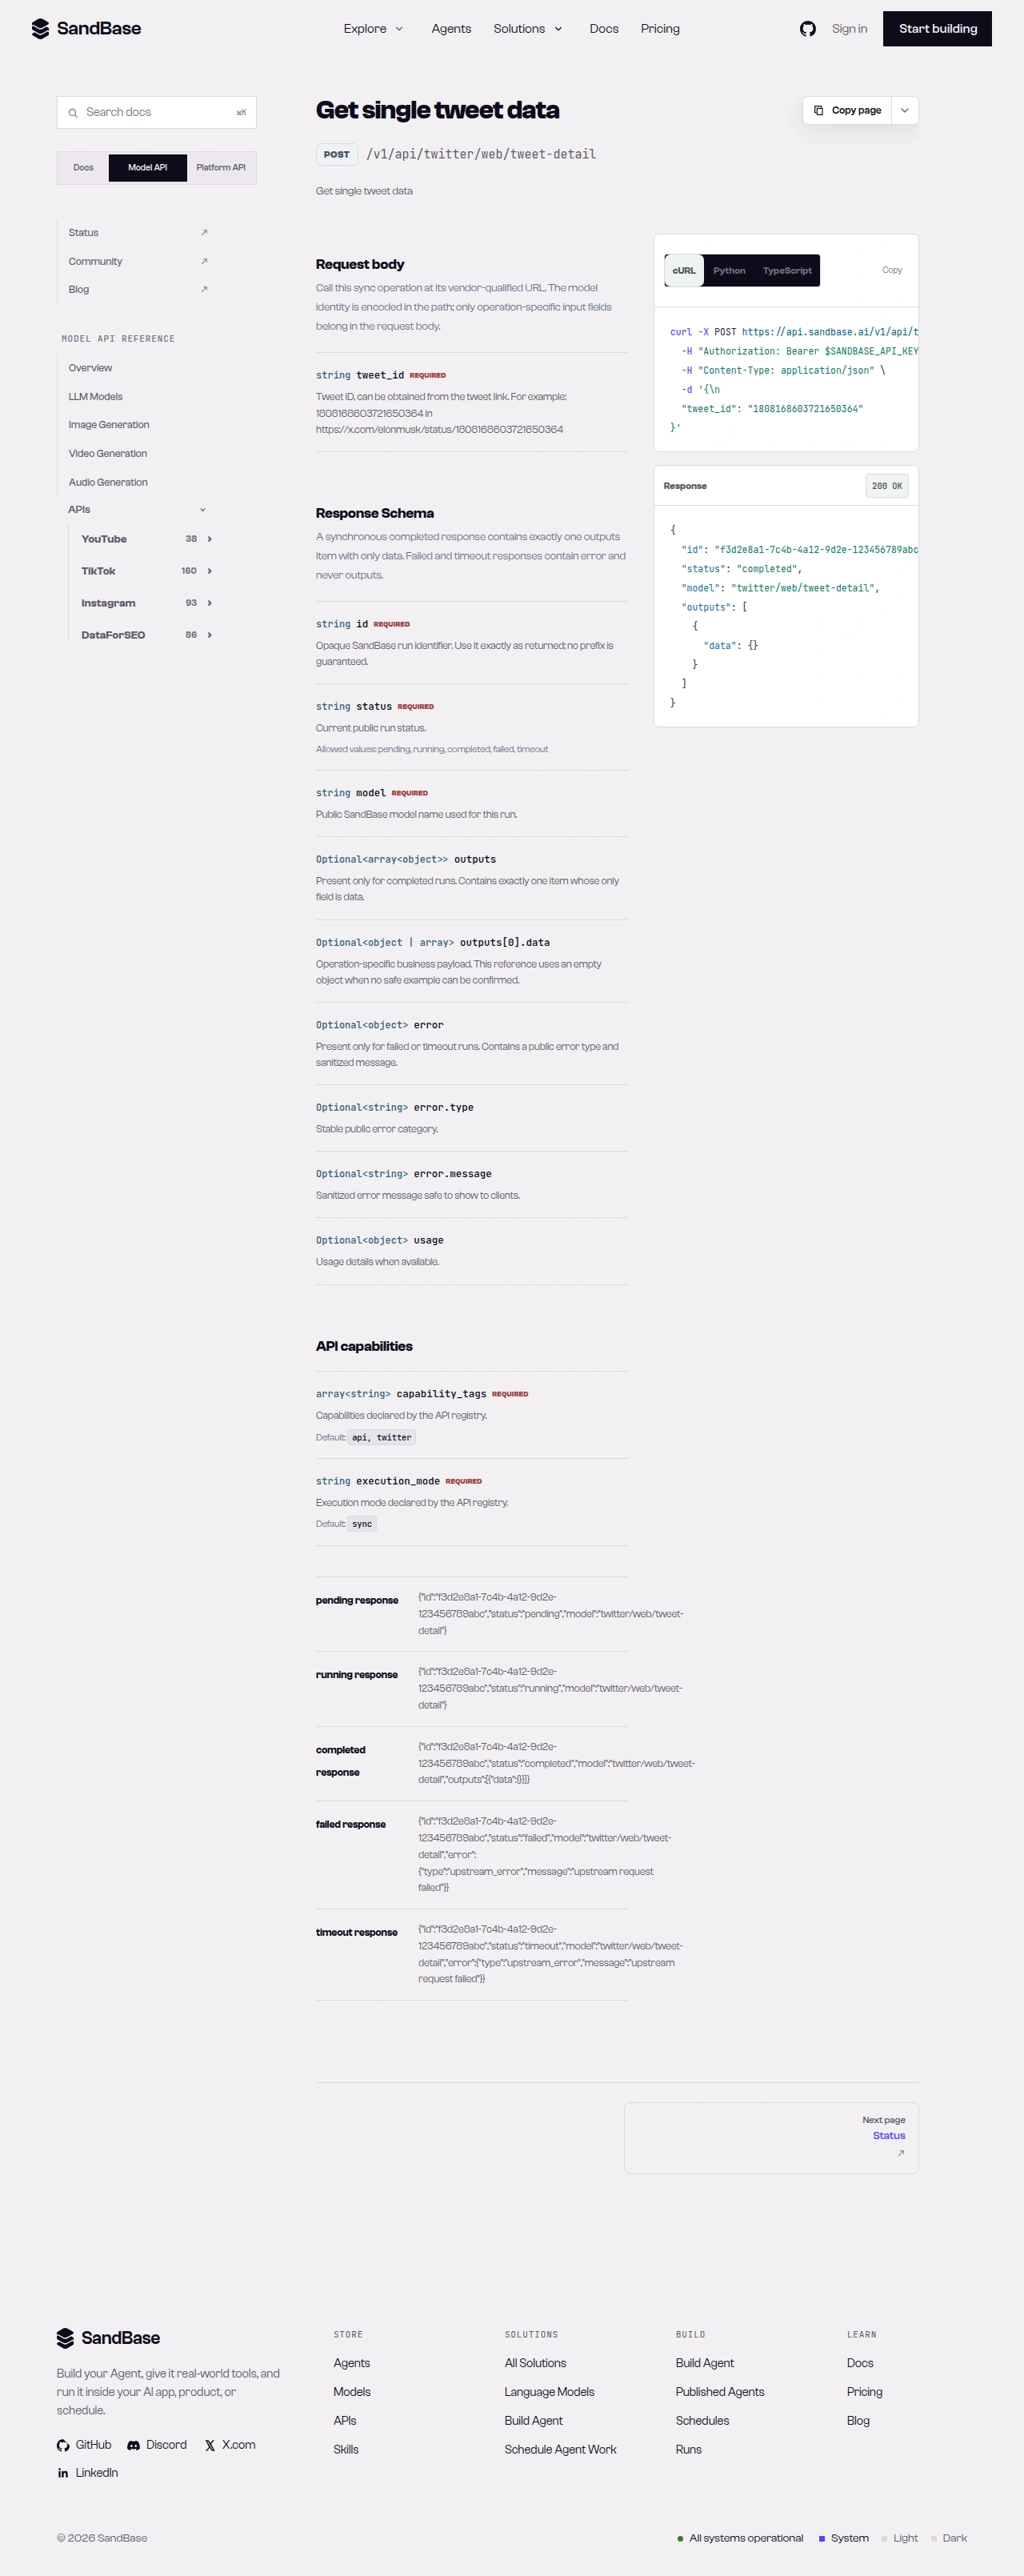 历史 tweet-detail 参数与信封截图,支持核对 tweet_id 字符串输入,不证明互动数或完整作者资料已经返回。旧空业务占位响应不作为成功证据。
准确读取有日期的保存样本
公开捕获中有五份同一帖子 ID 的保存样本,日期均为 2026-08-20,样本时间从 09:23:34.521Z 到 09:28:30.693Z。它们是历史参考记录,不是本轮新执行的区间,也不能证明生产定时任务正在采集。
下面从样本 2c2792e8-2cf0-4cd0-a06d-2f2846c52a60 裁剪,created_at 为 2026-08-20T09:28:30.693Z,保留字段原值与类型:
{
  "status": "active",
  "id": "1808168603721650364",
  "created_at": "Tue Jul 02 15:59:23 +0000 2024",
  "views": "53720642",
  "likes": 284243,
  "retweets": 52539,
  "quotes": 3901,
  "replies": 19281,
  "bookmarks": 6630
}
五份样本的这六项互动值全部相同:views 字符串 53720642、likes 284243、retweets 52539、quotes 3901、replies 19281、bookmarks 6630。完整载荷可以有其他差异,但这组计数不能展示互动增长。数值相同也不能反推出缓存策略、刷新延迟或上游更新频率。
JSON 里的帖子 created_at 是 2024 年 7 月 2 日,属于发布时间,不是目录样本时间,更不是今天的观察时间。以后真正请求成功时,客户端可以记录自己的 UTC 观察时间;现在解析归档再补一个今日时间戳,只能称本地处理时间,不能当成新的帖子观察。
README 是另一份无执行日期的参考:其字段说明提到 views 53722244,裁剪 JSON 中 bookmarks 为 6534,与保存样本不同。不要拼成同一次观测,也不要当作已知时间间隔来计算增长。本轮离线测试把五份完整保存业务载荷送入模拟 HTTP 响应,没有联网刷新计数。
计数、作者和上下文分别解释
views 保持返回的原字符串。若后续产品确需计算,可把纯数字文本精确转换为整数,并单独注明这个本地变换;缺失、空白或非数字值不能默认成零。标识与精确大数都应避免浮点转换。点赞、转推、回复、引用和收藏是各自的计数,不是可互换的受众规模。
replies 只是一项数量,不包含评论列表。conversation_id 表示上下文,回复帖的会话 ID 可以不同于自身 ID。选定保存样本里的 reply_to、initial_tweets 和相关回复目标字段为空,也不能证明无人回复或完整讨论已获取。helper 不沿会话 ID 自动读评论。
内嵌 author 可以提供账号上下文,但 author.sub_count 是作者账号相关计数,不是帖子浏览人数或触达。author 缺失时保持未知,不要直接继续取子字段,更不能补一个默认 false 认证值。徽标只是展示信号,不是独立的身份、付费或合作关系审核。需要资料查询时,再按账号 hub 单独选择接口和预算。
text 与 display_text 在媒体短链的呈现上可能不同。保留来源文本,不把它当作可执行代码或 agent 指令。媒体和实体链接只是引用,不代表已经下载、获得使用权、永久可访问或所有媒体规格都已取回。当前示例不会打开这些 URL。
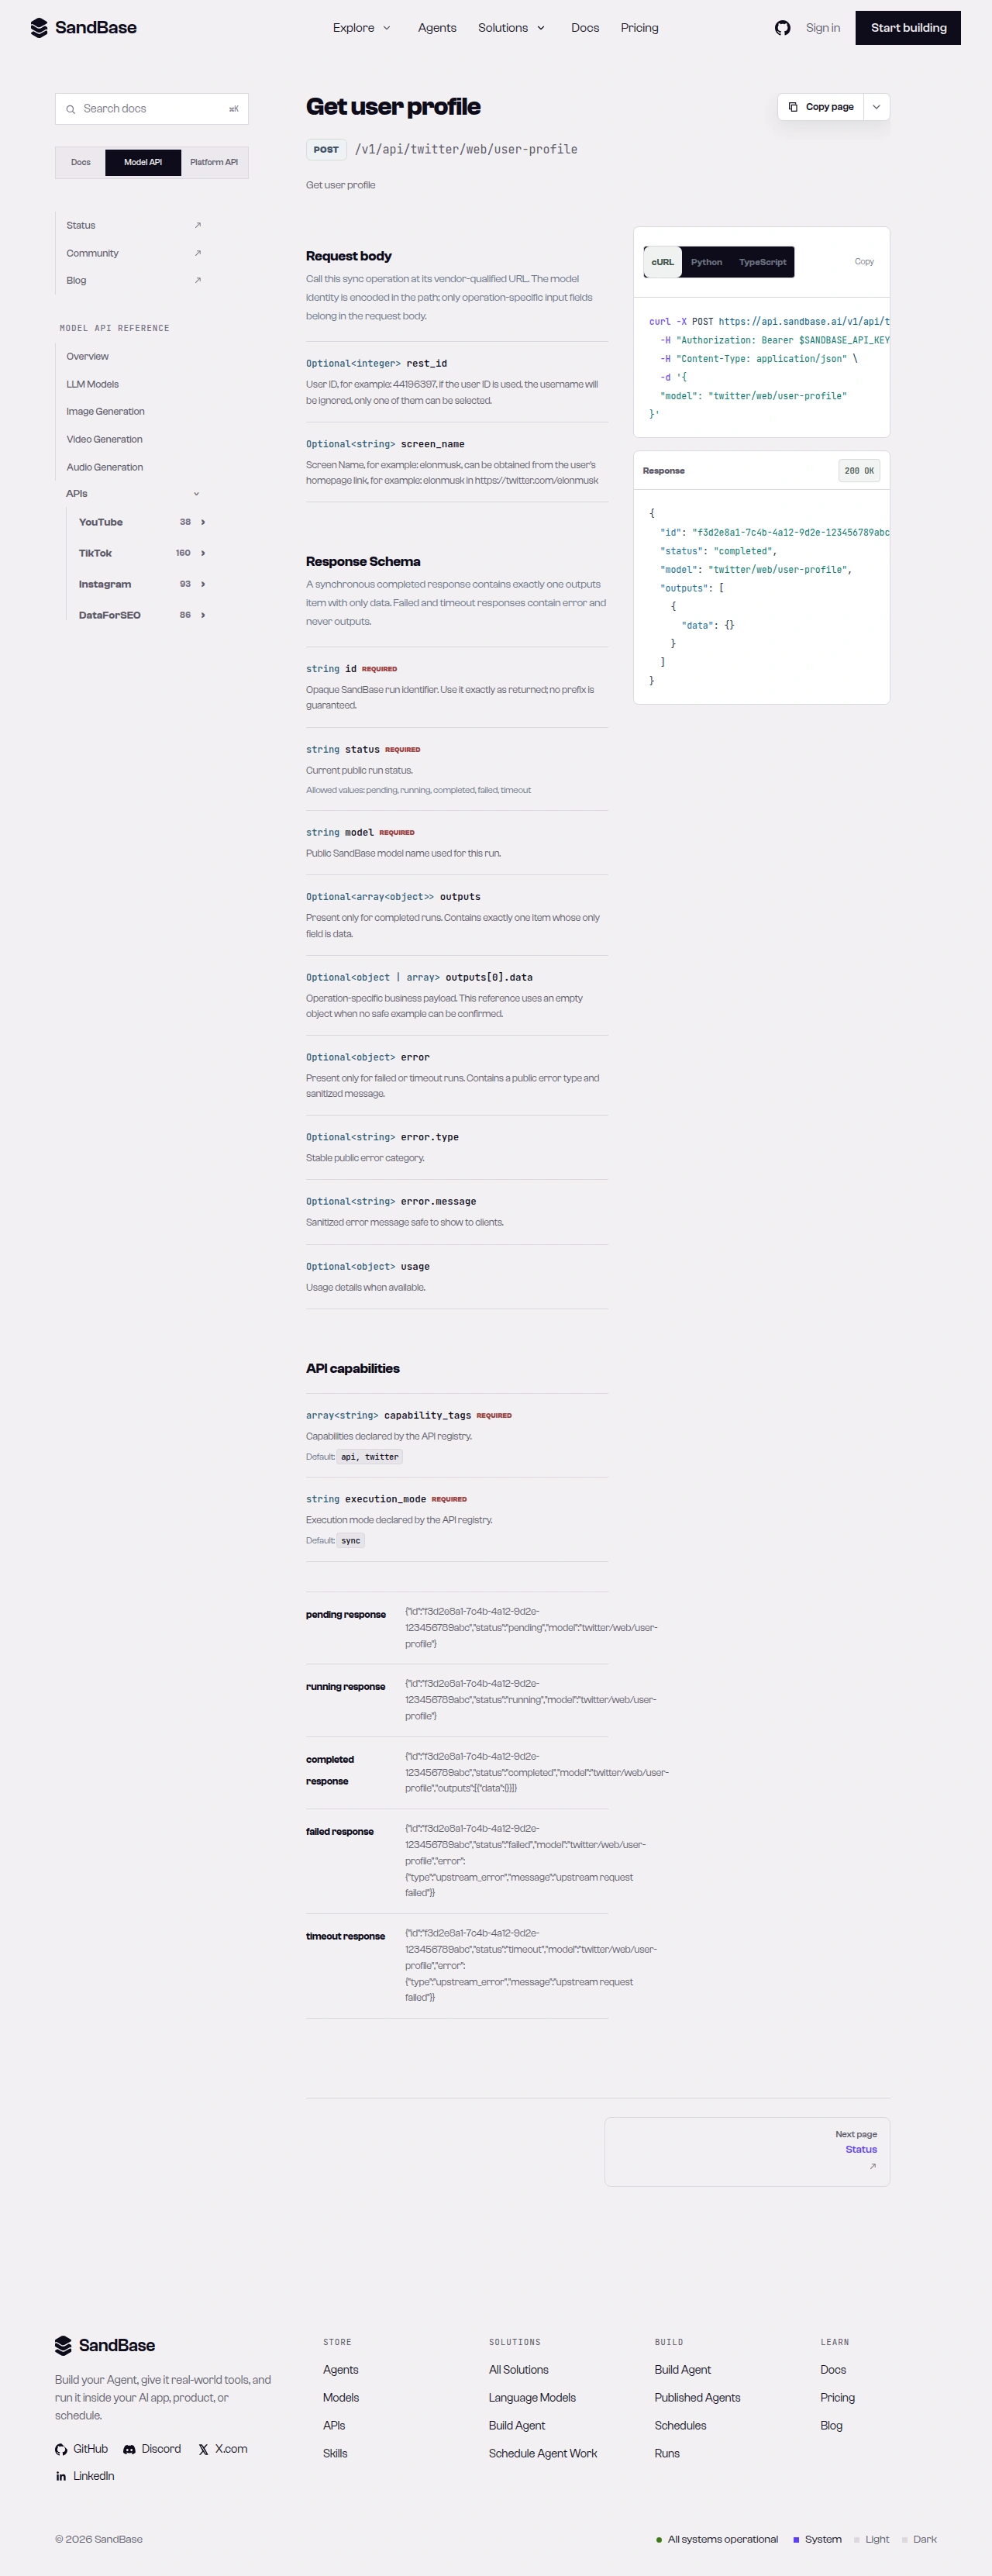 历史 user-profile 参数截图,属于单独的账号查询。图中的 model-only 请求与空业务占位值不是当前执行示例,也不能证明粉丝量、认证或账号年龄已经查到。
后续比较还需要什么
如果以后要比较,先取得同一精确帖子 ID、同一指标定义下的两份有效观察,并分别记录观察时间。先决定预算和间隔,再采集。本文没有创建调度器、验证更新节奏,也没有把任意两份归档追认为受控实验。
计数差值只是观察到的变化,不等于新增独立人数、互动成因或情绪变化。计数可能下调或修订,负差值应保留,不能强制归零。字段消失或类型变化时应报告不确定性,不能写成“没有变化”。请求失败是失败事件,也不是一行全零计数。
原始响应和来源记录应与后续派生分析分开保存,区分帖子计数、账号元数据、发布时间、观察时间和本地处理时间。这样面板就不会给出超出证据的精度。新示例不执行比较公式或采集循环。
保留旧示意与历史代码
原文使用过 run 形状的 ID 117db5dd-1189-4830-9459-98b624960286 和另一个 NASA 帖子。以下 JSON 逐字保留,仍是示意,不是有日期的真实执行,也不是本轮重新核实的账号结果:
{
  "id": "117db5dd-1189-4830-9459-98b624960286",
  "status": "completed",
  "model": "twitter/web/tweet-detail",
  "outputs": [
    {
      "data": {
        "id": "2041690396586090592",
        "created_at": "Wed Apr 08 01:31:37 +0000 2026",
        "display_text": "It's not just a phase 🌕 ...",
        "retweets": 17850,
        "replies": 1173,
        "views": 3880967,
        "author": { "name": "NASA", "screen_name": "NASA", "blue_verified": true }
      }
    }
  ]
}
旧示意里的 views 为整数,不会覆盖当前有日期参考中的字符串类型。旧搜索、帖子、作者片段和按结果循环已逐字放入历史代码归档,并保留哈希。extract_tweet_ids 只是伪代码,而逐项循环会额外发出请求。这些内容用于追溯,当前执行入口改为上面的单次 helper。
价格和失败处理
2026-11-08 免费 inspect 显示此接口每次 0.001 美元,具有组织共享每日 100 次合资格数据 API 调用的资格,00:00 UTC 重置。资格不是剩余额度、账户余额或实际扣费记录,也不承诺免费成功。选定一条帖子只发一次请求,没有自动重试或追加资料、回复、媒体调用。
helper 拒绝重定向、非 2xx HTTP、无效 JSON、未完成信封、缺失业务对象、非 active 状态和身份不符。错误信息不回显上游正文或密钥。即使失败或超时响应意外带着 outputs,也必须停止;不要依赖“失败永远没有输出”的绝对判断。
常见问题
这是实时流吗? 不是,只是一次同步请求。保存样本和本次修订都没有证明刷新延迟或监测调度已经运行。
可以把帖子 URL 直接当 tweet_id 吗? 不可以,应保留 URL 中的精确数字 ID 字符串,也不能先经过可能丢精度的 JavaScript Number。
回复数包含整个讨论吗? 不包含。它是计数,几个上下文 ID 和空回复字段不能组成完整讨论。
失败后自动重试或补抓作者吗? 本例一次响应后停止。后续请求需单独明确目的、schema 和预算。
从选定帖子开始
打开 Tweet Detail,保留精确 ID,先验证一份响应,再规划比较。其他任务分别参考账号资料 hub和关键词指南。
觉得有用?分享给更多人