微博账号发帖研究 API 教程 | SandBase
用五个 SandBase 端点研究一个微博账号:按关键词找到账号、读资料、翻原创微博、按转评赞排序、抽样评论。无需微博登录,只需一个 SandBase API Key。
研究一个微博账号,起点往往不是 uid,而是一个名字。老板丢过来一句“看看这个品牌在微博上什么内容最有人转”,你手里只有一个关键词,搜出来二十个长得差不多的账号,还得先分清哪个才是正主。
这篇教程就从关键词出发:先定位账号、读资料,再翻它的原创微博,按转发、评论、点赞排个序,最后打开排第一的那条,看全文、抽评论。一共五个 SandBase 端点,整条链路可以直接交给 Agent 跑。端点全景请先看微博公开数据 API 总览;如果你关心的是热搜而不是某个账号,可以看微博热搜监测教程。
这里读的都是公开、只读数据。不需要微博账号、不需要申请微博开放平台应用,也不需要 SDK,只要一个 SandBase API Key 做鉴权。下面用到的端点,目前在 SandBase 目录里标的是 Free。
参数和响应信封以端点 API 参考为准,参考只保证信封结构。下文的业务字段名,来自我对「中国国家地理」官方微博跑的真实调用(测试于 2026-10-01,UTC),属于实测观察,不是文档保证。
先说结论
weibo/web-v2/user-search把关键词变成候选账号列表,每条带uid。优先取昵称完全一致的那个。weibo/web-v2/user-info返回认证资料。粉丝数用这里的followers_count,别用搜索结果里那个被抹掉单位的fans。weibo/web-v2/user-original-posts按page翻原创微博,本地按reposts_count、comments_count、attitudes_count(点赞)排序。- 长微博在列表里只有预览。排第一的那条用
weibo/web-v2/post-detail取全文,再用weibo/web-v2/post-comments按max_id翻页抽评论。
什么时候用它,什么时候走官方
微博开放平台主要服务“代表已登录用户操作”的应用。如果你要发微博、管账号,或者需要授权数据,那是正路。但如果只是想读一个公开账号发了什么、反响如何,走一遍开放平台的接入流程就有点杀鸡用牛刀了。
| 你的需求 | 用什么 |
|---|---|
| 研究公开的账号资料、微博和评论 | SandBase 微博公开数据 API |
| 发帖、回复、管理账号,或需要授权数据 | 微博官方开放平台 |
| 私密微博、仅粉丝可见内容、私信 | 两条公开路线都拿不到 |
整体流程
- 用
weibo/web-v2/user-search(query)找账号。 - 用
weibo/web-v2/user-info(uid)读资料。 - 用
weibo/web-v2/user-original-posts(uid、page)翻原创微博。 - 本地按转发、评论或点赞排序。
- 用
weibo/web-v2/post-detail(id)打开排名第一的微博取全文。 - 用
weibo/web-v2/post-comments(id、count、max_id)抽样评论。
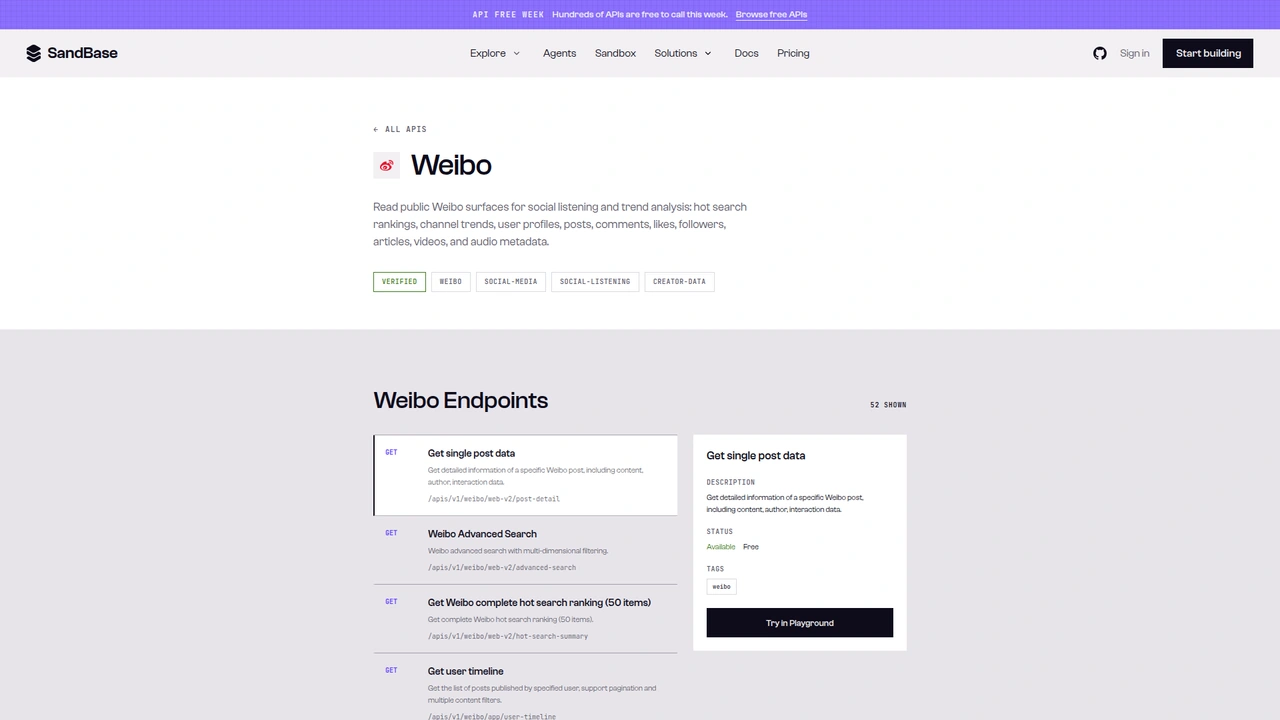 SandBase 上的微博目录页,共列出 52 个端点,路径形式是
GET /apis/v1/weibo/...。右侧选中的“Get single post data”显示 Available、Free。本教程调用的是 Model API 的 POST /v1/api/weibo/... 路由。
写代码之前先把两套入口说清楚。目录页展示的是 GET /apis/v1/weibo/<path>;本教程用的是端点参考里的 Model API:POST /v1/api/weibo/<path>,JSON 请求体里只放这个端点自己的参数。我截到的几个参考页,生成的 cURL 示例也只带端点参数;如果以后参考页里出现了 model 字段,以参考为准。复制代码时别把两套混着用。
第 0 步:一个通用的调用函数
import os
import time
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}


def call(path: str, payload: dict, retries: int = 2) -> dict:
    for attempt in range(retries + 1):
        try:
            resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=90)
            resp.raise_for_status()
            break
        except (requests.ConnectionError, requests.Timeout):
            if attempt == retries:
                raise
            time.sleep(2 * (attempt + 1))
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error", {}).get("message", f"{path} did not complete"))
    # Prefer a top-level `output`; fall back to the documented outputs[0].data.
    output = body.get("output")
    if output is None and body.get("outputs"):
        output = body["outputs"][0].get("data", {})
    return output or {}
参考文档写的是:成功响应的数据在 outputs[0].data。这次测试里,所有微博调用返回的都是这个结构。不过我在 SandBase 其他平台端点上见过顶层 output 的写法,所以函数两路都读,有 output 就优先用它。加重试也不是摆设:有一次 post-detail 在 TLS 握手阶段被重置了连接,重试一次就好了。
再往里一层,五个端点的包装各不相同:搜索结果套在 parsed_data 里,user-info 的资料在 user 下,user-original-posts 的微博在 data.list,而 post-detail 和 post-comments 的字段直接平铺在最外层。后面每一步都按各自的路径去取。
第 1 步:按关键词找账号
def find_account(keyword: str) -> dict | None:
    users = call("weibo/web-v2/user-search", {"query": keyword}).get("parsed_data", {}).get("users", [])
    exact = [u for u in users if u.get("name") == keyword]
    return (exact or users or [None])[0]
搜「中国国家地理」(run 4a509105-eb13-4513-bc6b-9e515167d4c7)返回了 20 个候选,每条有 name、uid、profile_url、avatar 和 fans。排第一的是杂志主账号,后面跟着旗舰店、大遗产、融媒体中心等子账号,再往下就是只沾了点边的无关账号。所以函数先找昵称完全一致的,找不到才退回第一条。
先说个坑:搜索结果里的 fans 千万别拿来算数。主账号显示 fans: 1167,而第 2 步的资料里粉丝是 11,677,520(“1167.8万”)。我又搜了一下人民日报,fans 是 1,实际粉丝 1.58 亿。看起来这个字段就是把展示文案里的“万”“亿”单位直接扔掉了。肉眼扫一扫可以,排序就别指望它了。
第 2 步:读账号资料
def read_profile(uid: str) -> dict:
    user = call("weibo/web-v2/user-info", {"uid": uid}).get("user", {})
    return {
        "uid": user.get("idstr"),
        "name": user.get("screen_name"),
        "followers": user.get("followers_count"),
        "posts": user.get("statuses_count"),
        "verified_reason": user.get("verified_reason"),
        "location": user.get("location"),
    }
uid 1222135407 这次调用(run 59d3b350-2227-49e1-bb25-1790a06950cb)在 outputs[0].data 里的资料,精简后长这样:
{
  "user": {
    "idstr": "1222135407",
    "screen_name": "中国国家地理",
    "followers_count": 11677520,
    "followers_count_str": "1167.8万",
    "friends_count": 373,
    "statuses_count": 28394,
    "verified": true,
    "verified_reason": "《中国国家地理》官方微博",
    "location": "北京",
    "status_total_counter": {
      "repost_cnt": "3,130,409",
      "comment_cnt": "1,820,565",
      "like_cnt": "7,438,106",
      "total_cnt_format": "1238.9万"
    }
  }
}
status_total_counter 是账号累计的转评赞汇总,挺好用,但数字是带千分位逗号的字符串,算之前先去掉逗号。另外还有个 weibo/web-v2/user-basic-info,参数一样是 uid。我跑的那次它只返回了一张轻量卡片,有 followers_count_str,没有数值型的粉丝数,所以这里选 user-info。
第 3 步:翻原创微博
def original_posts(uid: str, pages: int = 2) -> list[dict]:
    seen, posts = set(), []
    for page in range(1, pages + 1):
        data = call("weibo/web-v2/user-original-posts", {"uid": uid, "page": page}).get("data", {})
        batch = data.get("list", []) or []
        if not batch:
            break
        for p in batch:
            if p.get("idstr") in seen:
                continue
            seen.add(p.get("idstr"))
            posts.append({
                "id": p.get("idstr"),
                "mblogid": p.get("mblogid"),
                "created_at": p.get("created_at"),
                "reposts": p.get("reposts_count", 0),
                "comments": p.get("comments_count", 0),
                "likes": p.get("attitudes_count", 0),
                "is_long": p.get("isLongText", False),
                "co_post": bool(p.get("cooperate_info")),
                "text": (p.get("text_raw") or "").strip(),
            })
    return posts
这个端点的 schema 里有 uid、page,还有一个 since_id,说明写着“首页必须从另一个端点获取”。实际上我用不着它,直接传 page 页码就行。第 1 页(run cc08c1c1-9d06-4453-b0b6-35d44d04f1bb)返回 47 条,第 2 页(run 2b5b4795-95ec-4180-96bc-ee397f16ed4a)返回 50 条更早的,两页没有重复,加起来大约覆盖了四周的发帖。响应里没有 since_id,也没有 has_more,所以循环遇到空列表就停,并按 id 去重,防止翻页时内容错位。
每条微博都有字符串形式的 idstr、短码 mblogid(就是微博链接里那串字符)、形如 Sun Sep 27 10:00:33 +0800 2026 的 created_at,以及转评赞三个计数。data.total 在两次调用里一次是 27,299、一次是 27,807,和 statuses_count 也对不上,我建议直接无视它。
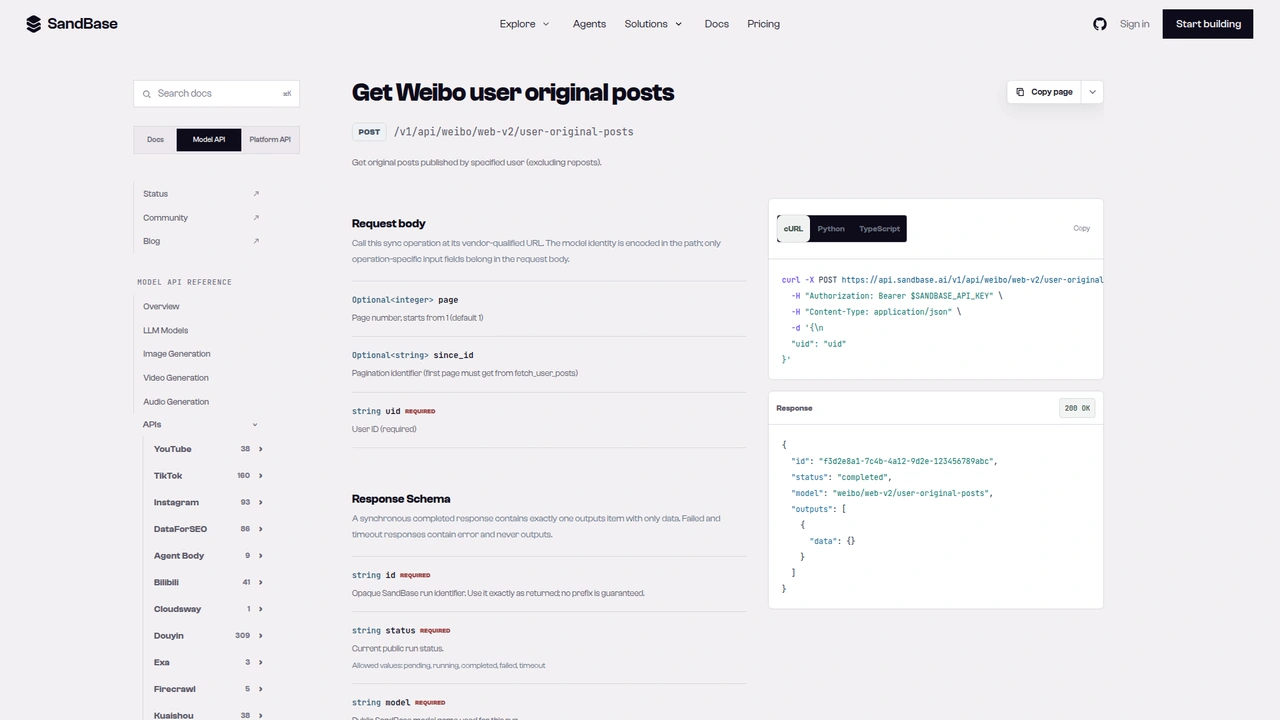
weibo/web-v2/user-original-posts 参考页:POST /v1/api/weibo/web-v2/user-original-posts,page、since_id 可选,uid 必填。页面把它描述为“不含转发的原创微博”,响应示例里的 outputs[0].data 是空的。
第 4 步:排序
def rank(posts: list[dict], key: str = "reposts", top: int = 5, skip_co_posts: bool = False) -> list[dict]:
    pool = [p for p in posts if not (skip_co_posts and p["co_post"])]
    return sorted(pool, key=lambda p: p.get(key) or 0, reverse=True)[:top]
把 97 条微博一排,事情就有意思了。有一条在三个榜上都是第一:转发 6,254、评论 692、点赞 6,879。而转发第二名只有 384。差距这么大,就该停下来仔细看看。点开一看,是和一个外卖平台联合发布的秋季出游推广,记录里带一个 cooperate_info 对象,把两个账号都列为共同作者。97 条里只有这一条有这个字段。这就是 co_post 的由来:传 skip_co_posts=True 就能看到自然流量的排名——第一是一条讲冰川退缩、新生河流的科普(转发 384),后面是两条中秋祝福。
我一开始想用 isAd 判断广告,结果 97 条里有 37 条是 true,连每天早上的问候帖都算在内,显然不能把它理解成“商业推广”。在这个样本里,cooperate_info 是更干净的信号。不过这只是一个账号上的观察,不是规律。
还有一点:97 条里有 67 条 isLongText 为 true。这些微博在列表里的 text_raw 只是预览,这就引出了下一步。
第 5 步:打开排名第一的微博看全文
def full_text(post_id: str) -> dict:
    d = call("weibo/web-v2/post-detail", {"id": post_id})
    long_text = (d.get("longText") or {}).get("content")
    return {
        "text": long_text or d.get("text_raw"),
        "reads": d.get("reads_count"),
        "source": d.get("source"),
    }
那条推广微博,列表里的预览只有 147 个字,句子说到一半就断了。post-detail(run fff2fd24-3225-4ba1-921c-71f54cd4fb72)在 longText.content 里给出了完整的 238 字正文,另外还有列表里没有的 reads_count,大约 594 万。id 参数就是第 3 步拿到的 idstr。is_get_long_text 默认就是 "true",我没传。
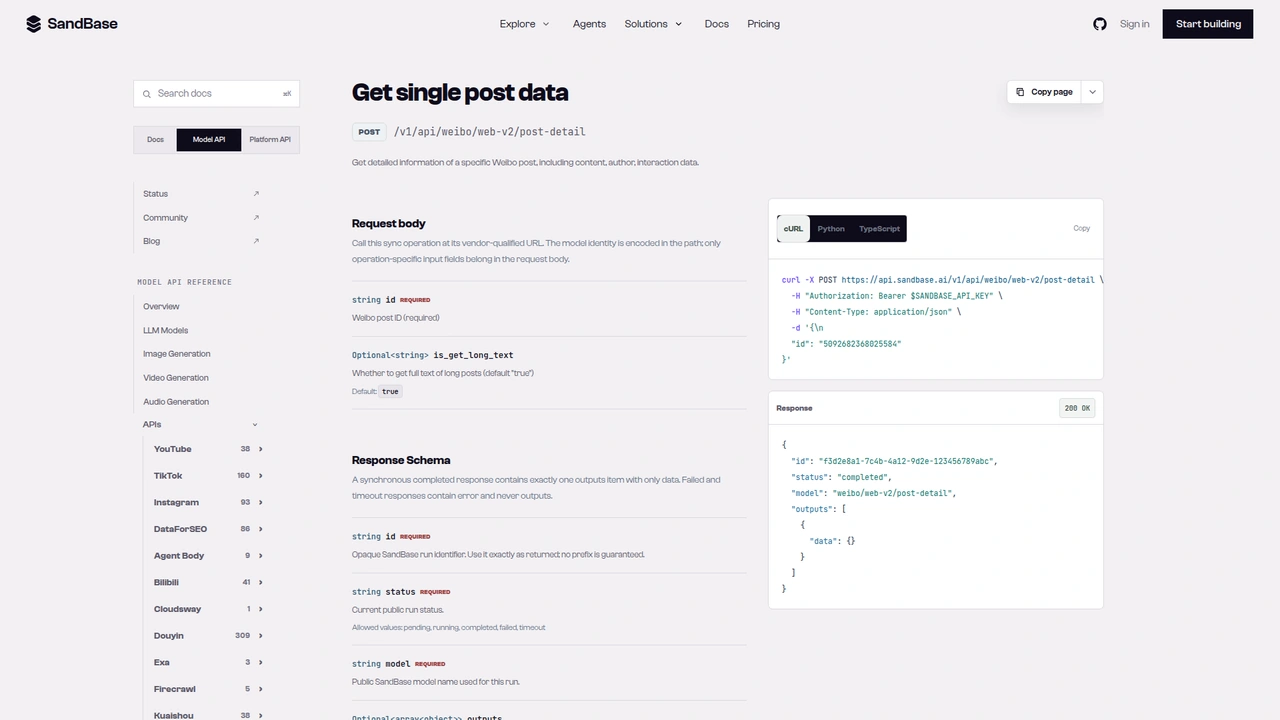
weibo/web-v2/post-detail 参考页:id 必填,is_get_long_text 可选,默认值为 true。
第 6 步:抽样评论
def comment_sample(post_id: str, pages: int = 2) -> list[dict]:
    max_id, out = "", []
    for _ in range(pages):
        page = call("weibo/web-v2/post-comments", {"id": post_id, "count": 20, "max_id": max_id})
        for c in page.get("data", []) or []:
            # Keep only text and like count; drop commenter identity.
            out.append({"text": c.get("text_raw"), "likes": c.get("like_counts", 0)})
        next_id = page.get("max_id")
        if not next_id:
            break
        max_id = str(next_id)
    return out
参考里对 max_id 的说明是:第一次传空字符串,之后传上一页返回的 max_id。实测也是这样。第 1 页(run f62a40cf-d18e-4f6f-b90b-c1c2b30b0f71)返回 20 条评论、total_number: 692,以及一个数值型的 max_id;把它转成字符串传回去(run 5664ad51-897d-4e17-8ef4-052a8f70e2d8),拿到了另外 20 条。count: 20 生效了,默认是 10。
有两个怪地方。第一,每一页都带着 trendsText: "已加载全部评论",哪怕后面明明还有,所以别拿它当停止条件。第二,更早的一次完整运行里,第二页什么都没加进来;之后连跑两次,都正常拿到了 40 条。所以遇到一页偏少,先当成“可能要重试”,别直接认定评论翻完了。
每条评论还带一个完整的 user 对象,函数是故意丢掉的。做这类研究,要的是大家说了什么、共鸣有多大,而不是评论者是谁。这个样本里点赞最多的评论(17 个赞)是在吐槽这次推广的广告味,这种反应光看转发数是看不出来的。
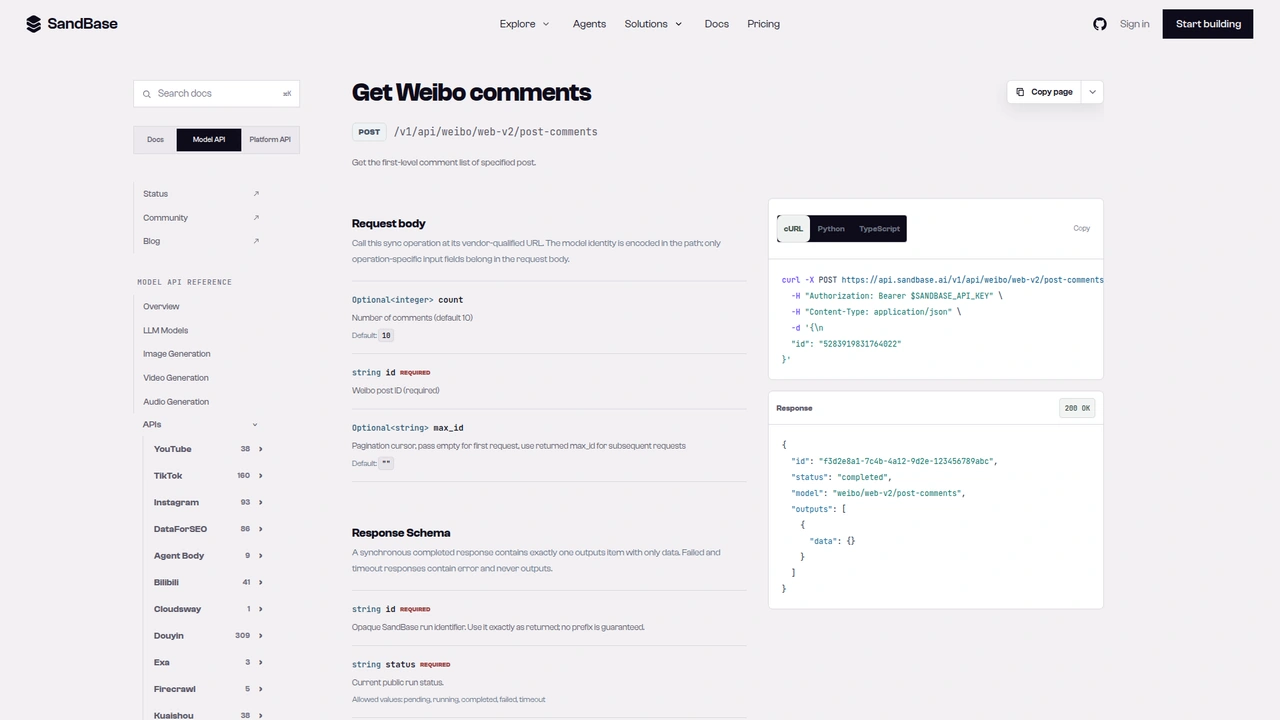
weibo/web-v2/post-comments 参考页:count 可选(默认 10),id 必填,max_id 首次传空,之后传上一页返回的 max_id。
串起来跑一遍
account = find_account("中国国家地理")
profile = read_profile(account["uid"])
posts = original_posts(profile["uid"], pages=2)
for metric in ("reposts", "comments", "likes"):
    print(metric, [(p["id"], p[metric], p["co_post"]) for p in rank(posts, metric, 3)])
print("organic only:", [(p["id"], p["reposts"]) for p in rank(posts, "reposts", 3, skip_co_posts=True)])
top = rank(posts, "reposts", 1)[0]
detail = full_text(top["id"])
comments = comment_sample(top["id"], pages=2)
这一遍一共 7 次调用:搜索 1 次、资料 1 次、微博列表 2 页、详情 1 次、评论 2 页。输出了 97 条样本、三个指标各自的前三名、自然流量排名、列表预览和详情全文的字数对比(147 对 238),以及 40 条抽样评论。把结果交给模型,让它总结这个账号的受众爱转什么、推广帖和自然帖差在哪、第一名底下的评论是什么情绪。
文档保证 vs. 实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/weibo/web-v2/user-search,参数 query、page | 参考有记载 |
POST /v1/api/weibo/web-v2/user-info,参数 uid 或 custom | 参考有记载 |
POST /v1/api/weibo/web-v2/user-original-posts,参数 uid、page、since_id | 参考有记载 |
POST /v1/api/weibo/web-v2/post-detail,参数 id | 参考有记载 |
POST /v1/api/weibo/web-v2/post-comments,参数 id、count、max_id | 参考有记载 |
信封 id / status / model / outputs[0].data | 参考有记载 |
parsed_data.users[].uid / name / fans(单位被抹掉) | 仅实测 |
user.followers_count、statuses_count、status_total_counter | 仅实测 |
data.list[] 中的 idstr、reposts_count、comments_count、attitudes_count、isLongText、cooperate_info | 仅实测 |
详情里的 longText.content、reads_count | 仅实测 |
评论的 data[]、max_id、total_number、like_counts | 仅实测 |
常见用法
品牌内容盘点
拉一个品牌一个月的原创微博,看哪些题材和形式拿转发、哪些拿点赞。把联合推广单独拎出来,别让它把自然内容的排名冲掉。端点:user-original-posts、post-detail。
媒体账号横向对比
对几家媒体账号跑同一套流程,比较单条微博的转发中位数,而不是比粉丝数。端点:user-search、user-info、user-original-posts。
推广复盘
打开推广微博的全文,抽样评论,看看口碑和声量是不是一回事。端点:post-detail、post-comments。
Agent 研究简报
给 Agent 一个品牌名,让它交回一页简报:账号资料、各指标前几名、第一名的评论情绪摘要。五个端点全用上。
实用提醒
- 先把账号认准。 搜索会混进同名子账号和不相干的个人账号。昵称精确匹配,再看资料里的
verified_reason确认。 - 粉丝数看资料,不看搜索。 搜索里的
fans单位被抹掉了。 - 原创微博按
page翻,遇空即停。 这个端点我没见到has_more。 - 长微博要取详情。
isLongText为 true 时,列表里只是预览。 - 评论按返回的
max_id翻,转成字符串再传。trendsText别当真。 - 注意类型。
status_total_counter里是带逗号的字符串,评论的max_id是数字。 - 评论者身份别入库。 一般有正文和点赞数就够了。
- 业务字段只是实测观察。 正式依赖之前,用真实响应再核对一遍。
常见问题
需要微博账号或开放平台应用吗?
不需要。用 SANDBASE_API_KEY 向 SandBase 鉴权即可,这些只读端点不需要你这边有微博登录或 OAuth。
收费吗? 这里用到的端点目前在 SandBase 目录里标的是 Free,具体以目录页当前状态为准。
user-original-posts 会包含转发别人的微博吗?
参考页描述的是“不含转发的原创微博”,我样本里的 97 条也都没有 retweeted_status。如果你也想要转发内容,可以用 weibo/web-v2/user-posts,它覆盖完整时间线。参考页把 since_id 列为可选的翻页参数,我查看的那一次响应(run 16f18948-183c-446d-bbb3-d74731720f4e)里也带着 since_id;拿它翻页之前,先用真实响应确认。
能往回翻多远? 我只测了两页,这个账号大约是四周。再往后能翻多深,我没法打包票。
爆款微博的评论能全拿下来吗?
可以一直按 max_id 往下翻,但建议先抽样。几百条评论的帖子,每一页都是一次调用。
收个尾
一个关键词,就够把一个公开微博账号研究清楚:定位账号、读资料、翻原创、排个序,再打开第一名听听评论区怎么说。这次测试里最值的一个习惯是:看到离群的第一名,先多看一眼,再决定它算不算这个账号最好的自然内容。其他微博端点见微博公开数据 API 总览。准备好了就从这里开始: