Claude Haiku 5.5 详解:API 价格、上下文与使用边界
Claude Haiku 5.5 的阶梯价格、1M 上下文、自适应思考、官方跑分、API 调用与不该替代 Sonnet 的场景。
Claude Haiku 5.5 最容易看漏的不是能力,而是计价分界线:输入不超过 10 万 token 时,每百万输入/输出 token 是 $0.10/$0.50;一旦超过 10 万,两项都涨到 5 倍。它很适合分类、抽取、摘要和子 Agent,但“有 1M 上下文”不等于“塞满也便宜”。
这是 Anthropic 在 2026 年 10 月 7 日发布的小型模型,支持文本与图片输入、自适应思考、1M 上下文和 128K 常规最大输出。下面把官方说法、SandBase 上的一次真实调用和使用边界拆开看。
先说结论
- 10 万 token 以内的价格是 $0.10/$0.50;超过 10 万后是 $0.50/$2.50。
- 上下文 1M,常规最大输出 128K,自适应思考默认
medium。 - Anthropic 公布的 Terminal-Bench 4.0 成绩从 Haiku 4.5 的 0.0% 升到 39.2%,但 Sonnet 5.5 仍有 70.6%。
- 我们 10 月 26 日在 SandBase 上跑了一次 SSO 工单分类,正确返回
technical,消耗 93 个输入和 52 个输出 token。 - 适合明确、重复、量大的子任务;复杂代码仓库和长链路 Agent 仍该升级到 Sonnet 或 Opus。
它到底更新了什么
Claude Haiku 5.5 接替 Haiku 4.5,已在 Claude API、AWS、Google Cloud 和 Microsoft Azure 提供。它是闭源托管模型,没有公开权重与自部署许可。
 Anthropic 10 月 7 日发布页把 Haiku 5.5 定位为高频任务模型,并给出本文引用的跑分表。截图于 2026-10-26。
Haiku 这次第一次加入可调 effort 的自适应思考,还换用了新版 tokenizer。官方称,同一段文本相比 Haiku 4.5 大约会多算 30% token。因此,短提示词单价虽然降了 90%,按典型任务估算的平均成本降幅是约 75%,不能直接把单价折扣当成账单折扣。
| 项目 | Claude Haiku 5.5 |
|---|---|
| 发布时间 | 2026-10-07 |
| Claude API ID | claude-haiku-5-5 |
| SandBase ID | anthropic/claude-haiku-5.5 |
| 输入/输出 | 文本、图片 → 文本 |
| 上下文 | 1,000,000 token |
| 最大输出 | 常规 128K;Batch beta 300K |
| 思考 | 自适应,默认 medium |
| 可靠知识截止 | 2026 年 6 月 |
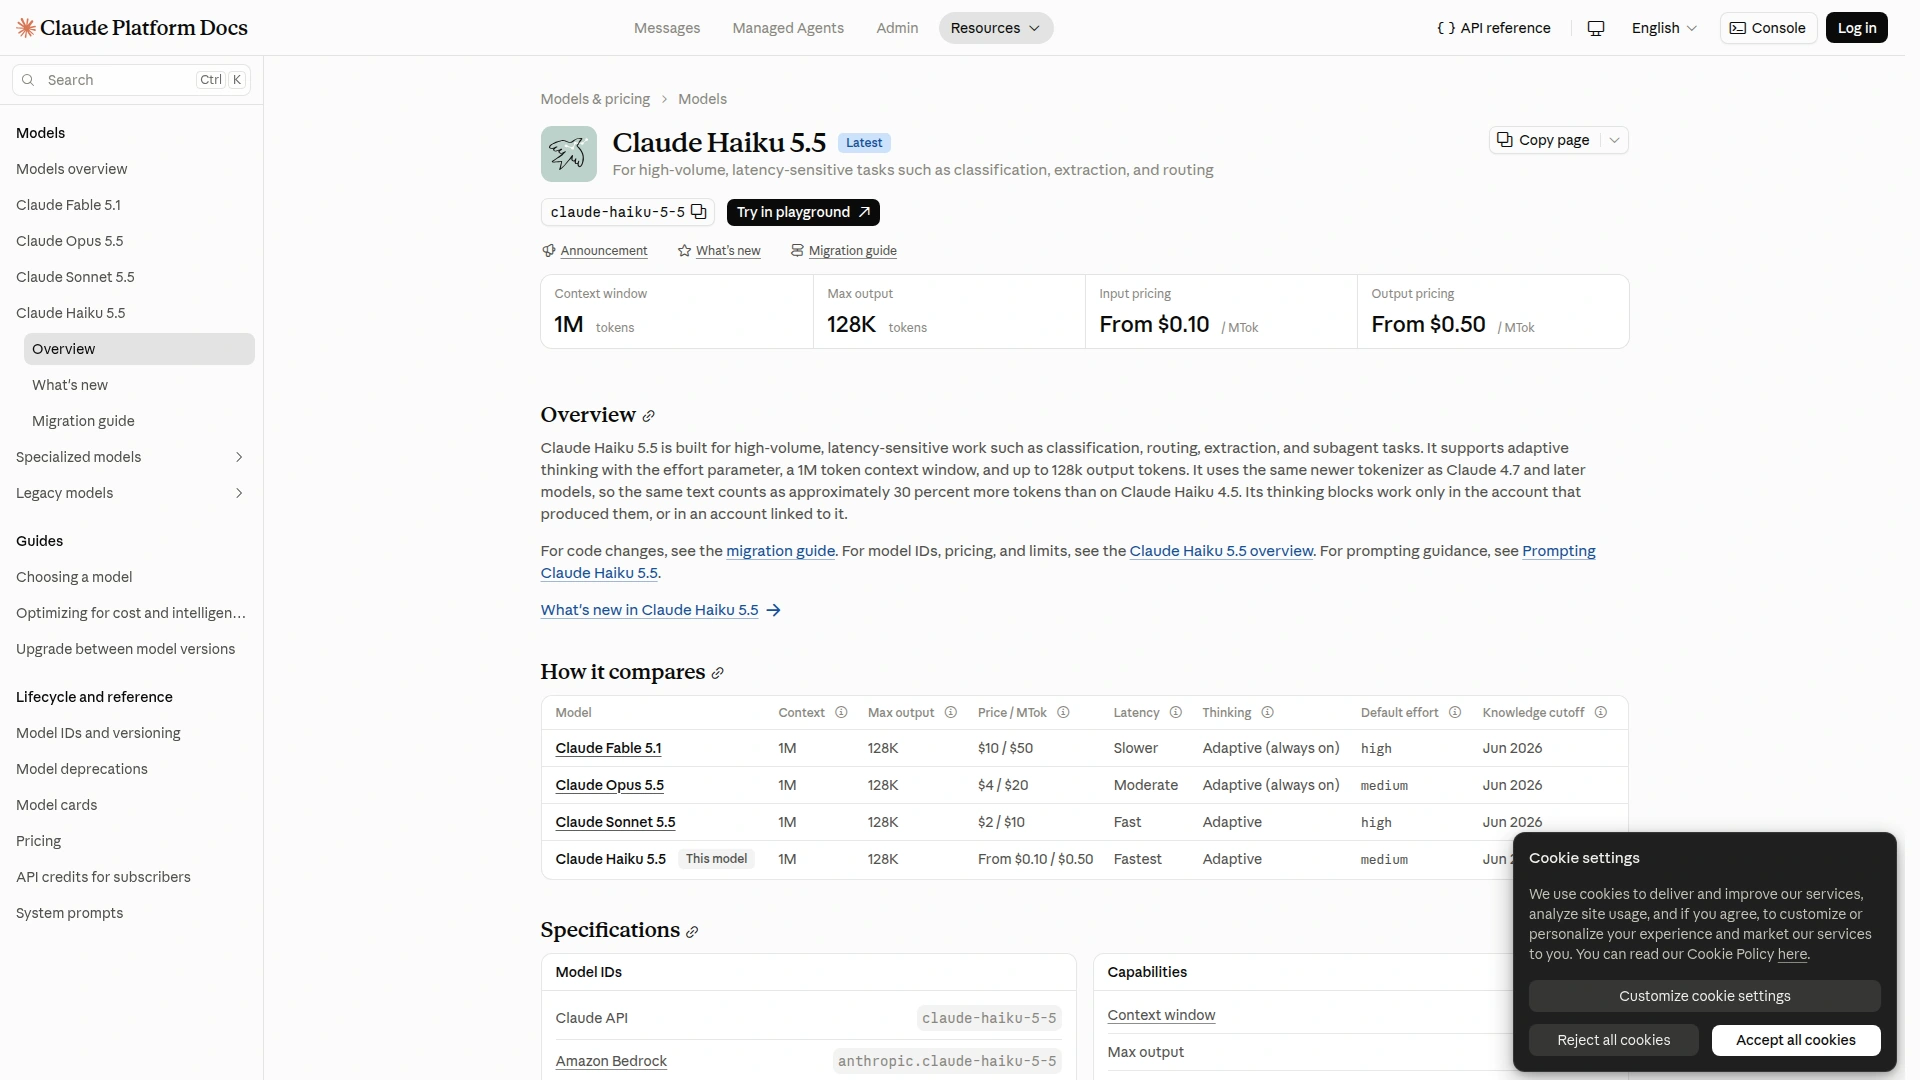 Claude Platform 的规格页给出生产限制和起步价格。截图于 2026-10-26。
10 万 token 的价格断点
| 每百万 token | 输入 ≤100K | 输入 >100K |
|---|---|---|
| 输入 | $0.10 | $0.50 |
| 输出 | $0.50 | $2.50 |
| 5 分钟缓存写入 | $0.125 | $0.625 |
| 1 小时缓存写入 | $0.20 | $1.00 |
| 缓存读取 | $0.01 | $0.05 |
一条 1 万输入、1000 输出的请求约 $0.0015。一条 12 万输入、4000 输出的请求约 $0.07。输入只扩大 12 倍,费用却因为跨档扩大约 47 倍。这里值得停一下:1M 是容量,不是优惠承诺。
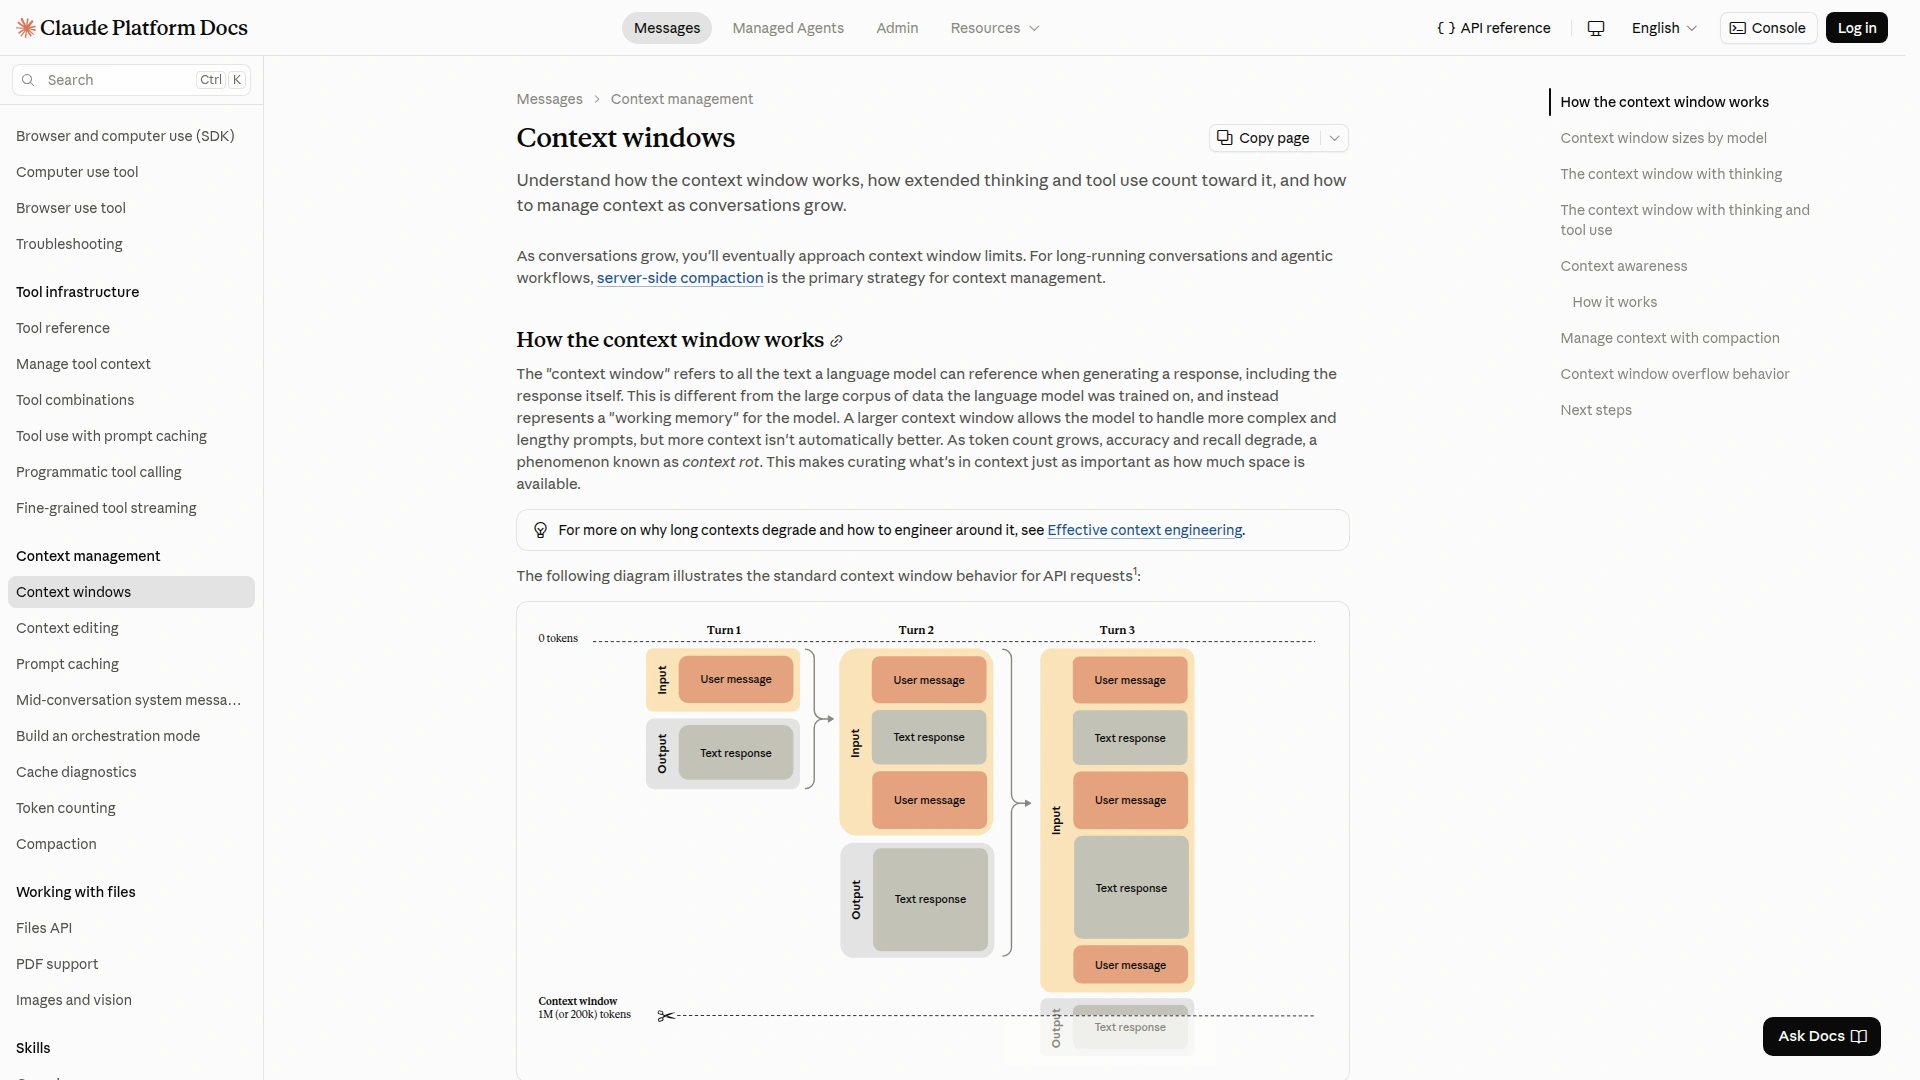 Anthropic 明确把 Haiku 5.5 列为长上下文计价例外:超过 100K 后启用高价档。截图于 2026-10-26。
官方跑分怎么读
| Anthropic 自报项目 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| OSWorld 2.1 离线集 | 72.4% | 15.7% | 48.9% | 83.9% |
| HLE,无工具 | 45.9% | 10.2% | — | 56.9% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 Main | 46.4% | — | 42.4% | 52.1% |
这些数字来自 Anthropic 自己的表,适合看方向,不是独立裁决。更实用的结论是:Haiku 已经能承担不少浏览器和代码子任务,但在开放式终端任务上离 Sonnet 仍很远。让它查资料、摘要、分类、做局部检查;遇到跨文件修改和模糊目标就升级。
一次真实分类调用
我们把一条工单发给 SandBase:“启用 SSO 后,3 位同事无法登录,但发票正常。”要求在 billing、technical、account 之间分类。模型返回 technical,理由是 SSO 配置导致认证失败。此次调用用了 93 个输入和 52 个输出 token。
这只是烟雾测试,能证明 10 月 26 日路由、模型 ID 与响应结构可用,不能推出生产准确率或延迟分布。
curl https://api.sandbase.ai/v1/chat/completions \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model":"anthropic/claude-haiku-5.5",
    "max_tokens":300,
    "messages":[{"role":"user","content":"把这条工单分到 billing、technical 或 account:启用 SSO 后三位同事无法登录,但发票正常。"}]
  }'
SandBase 提供到 Anthropic 模型的路由,并不训练或拥有 Claude。
怎么选
| 模型 | 输入/输出价 | 适合 | 主要代价 |
|---|---|---|---|
| Haiku 5.5,≤100K | $0.10/$0.50 | 分类、抽取、子 Agent | 超过 100K 贵 5 倍 |
| Haiku 4.5 | $1/$5 | 暂时不动的旧流程 | 官方新表中明显落后 |
| Sonnet 5.5 | $2/$10 | 难代码、长链路 Agent | 短请求单价是 Haiku 20 倍 |
| GPT-6 Luna | 以当前路由为准 | 低价通用助手 | Anthropic 表中多项低于 Haiku |
如果你在做分层路由,可参考 GPT-5.6 三档模型说明;要控制实际账单,可接着看 Anthropic SDK 成本看板。
使用边界
- 自适应思考默认开启;官方要求省略
temperature、top_p、top_k。 - 长输入更贵,也不自动更准,仍应先检索或压缩。
- thinking block 与产生它的账号绑定,不能默认跨账号复用。
- 支持图片输入不代表能生成图片。
- 官方跑分不能替代你自己的队列、语种和错误成本测试。
常见问题
Claude Haiku 5.5 多少钱?
输入不超过 100K 时是 $0.10/$0.50;超过后是 $0.50/$2.50,均按每百万输入/输出 token 计。
上下文多大?
1M,常规最大输出 128K。Message Batches beta 可在指定 header 下到 300K 输出。
比 Sonnet 5.5 更好吗?
它在短、明确、高频任务上便宜得多;复杂终端与 Agent 任务的官方分数仍明显落后 Sonnet。
是开源模型吗?
不是。Anthropic 通过托管 API 和云平台提供,没有发布权重。
Haiku 5.5 的价值在于做一个边界清楚的高频执行者。尽量把输入留在 100K 内,为低置信度和复杂任务设置升级路径,再到 SandBase 模型页核对当前价格和路由。