短视频趋势 API:抖音 + 快手热榜聚合
用一个 SandBase 密钥把抖音和快手热榜聚合成一条归一化趋势流——读两个榜、映射到统一结构,无需登录、无需 SDK。
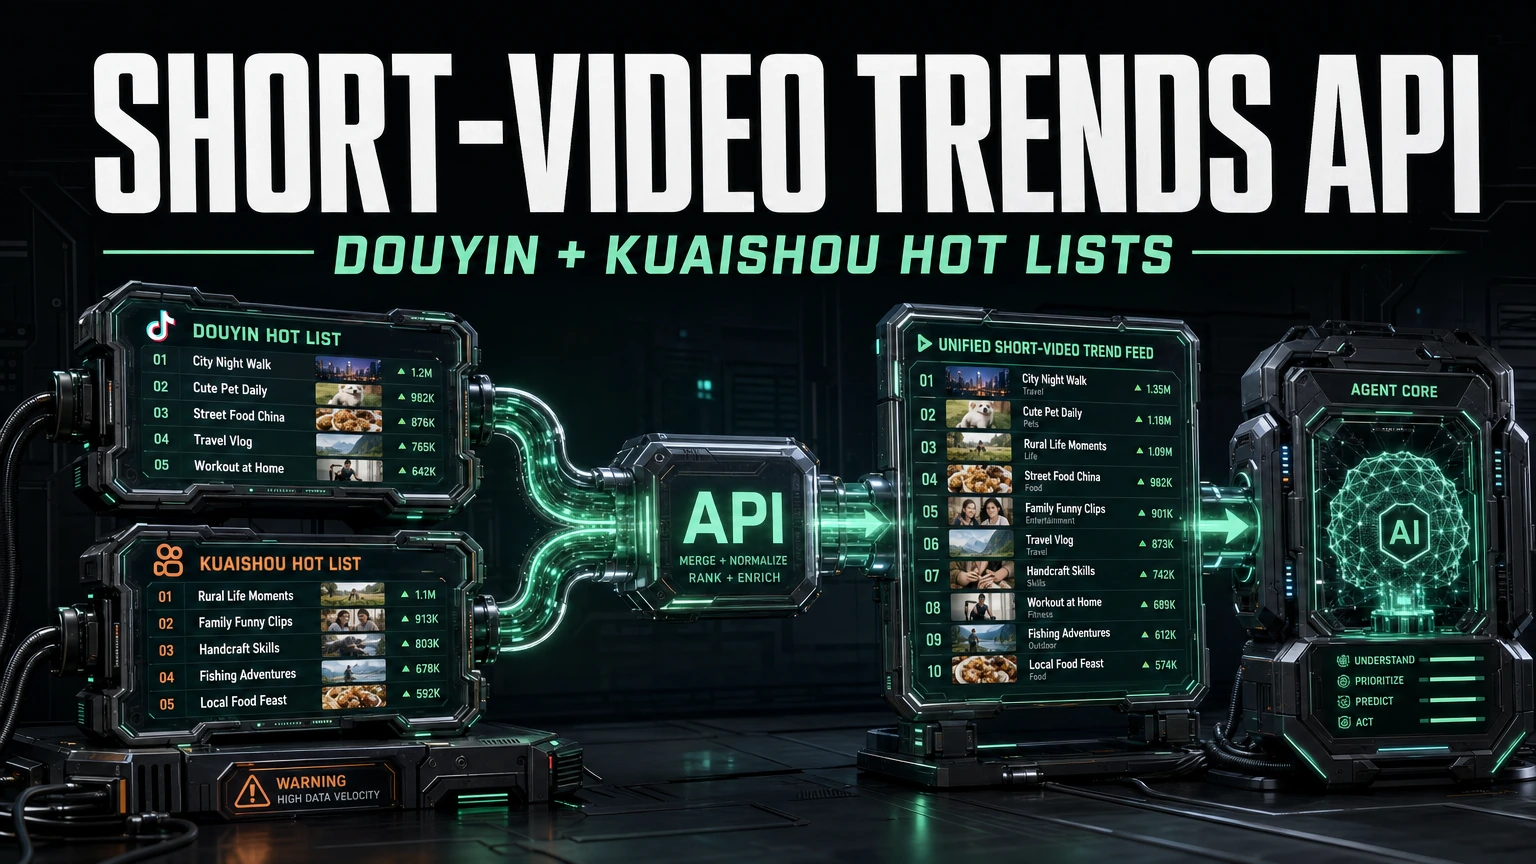
在国内追短视频趋势,你不会只盯一个平台。抖音和快手各有热榜,但两者的负载长得完全不一样——抖音把排名视频包在 code/data.objs 信封里,快手则把榜单以纯 list 返回。手工去调和这些差异,你的时间就花在解析怪癖上,而不是花在趋势信号本身。
这篇教程搭一个小聚合器:一个函数通过 SandBase 公开数据 API 读取两个热榜,把它们归一化成一个统一结构,再把一条排好序的趋势流交给你的 Agent。一个 SandBase API 密钥,不需要平台登录,不需要 SDK。每个端点的 API 参考是其参数和响应信封(id/status/model/outputs[0].data)的权威来源;下面展示的业务载荷字段名只是一个示例结构、并非保证的 schema,请以一份真实响应为准核对。
要了解每个平台背后完整的端点面,见 抖音公开数据 API 和 快手公开数据 API 两个总览。准备动手?获取 SandBase API 密钥。
先说结论
- 两个热榜端点——
douyin/billboard/hot-total-high-like-list和kuaishou/web/hot-list-v1——用同一个密钥读取。- 两者都用相同的
{ id, status, model, outputs }信封,所以一次 status 判断、一个 HTTP 辅助函数就能覆盖两个。- 负载不同:抖音把排名视频嵌在
data.data.objs下;快手把 list 直接放在data下。把两者归一化到同一行结构。- 仅公开、只读数据。你这边无需发帖、无需登录;用 SandBase API 密钥鉴权即可。
方案
三步,每步一个普通 REST 调用加一个小映射器:
- 读抖音榜。 调用
douyin/billboard/hot-total-high-like-list,从data.data.objs取排名视频。 - 读快手榜。 调用
kuaishou/web/hot-list-v1,读data下直接返回的 list。 - 归一化并合并。 把每个平台的字段映射到一个行结构,标注来源,返回一条统一趋势流。
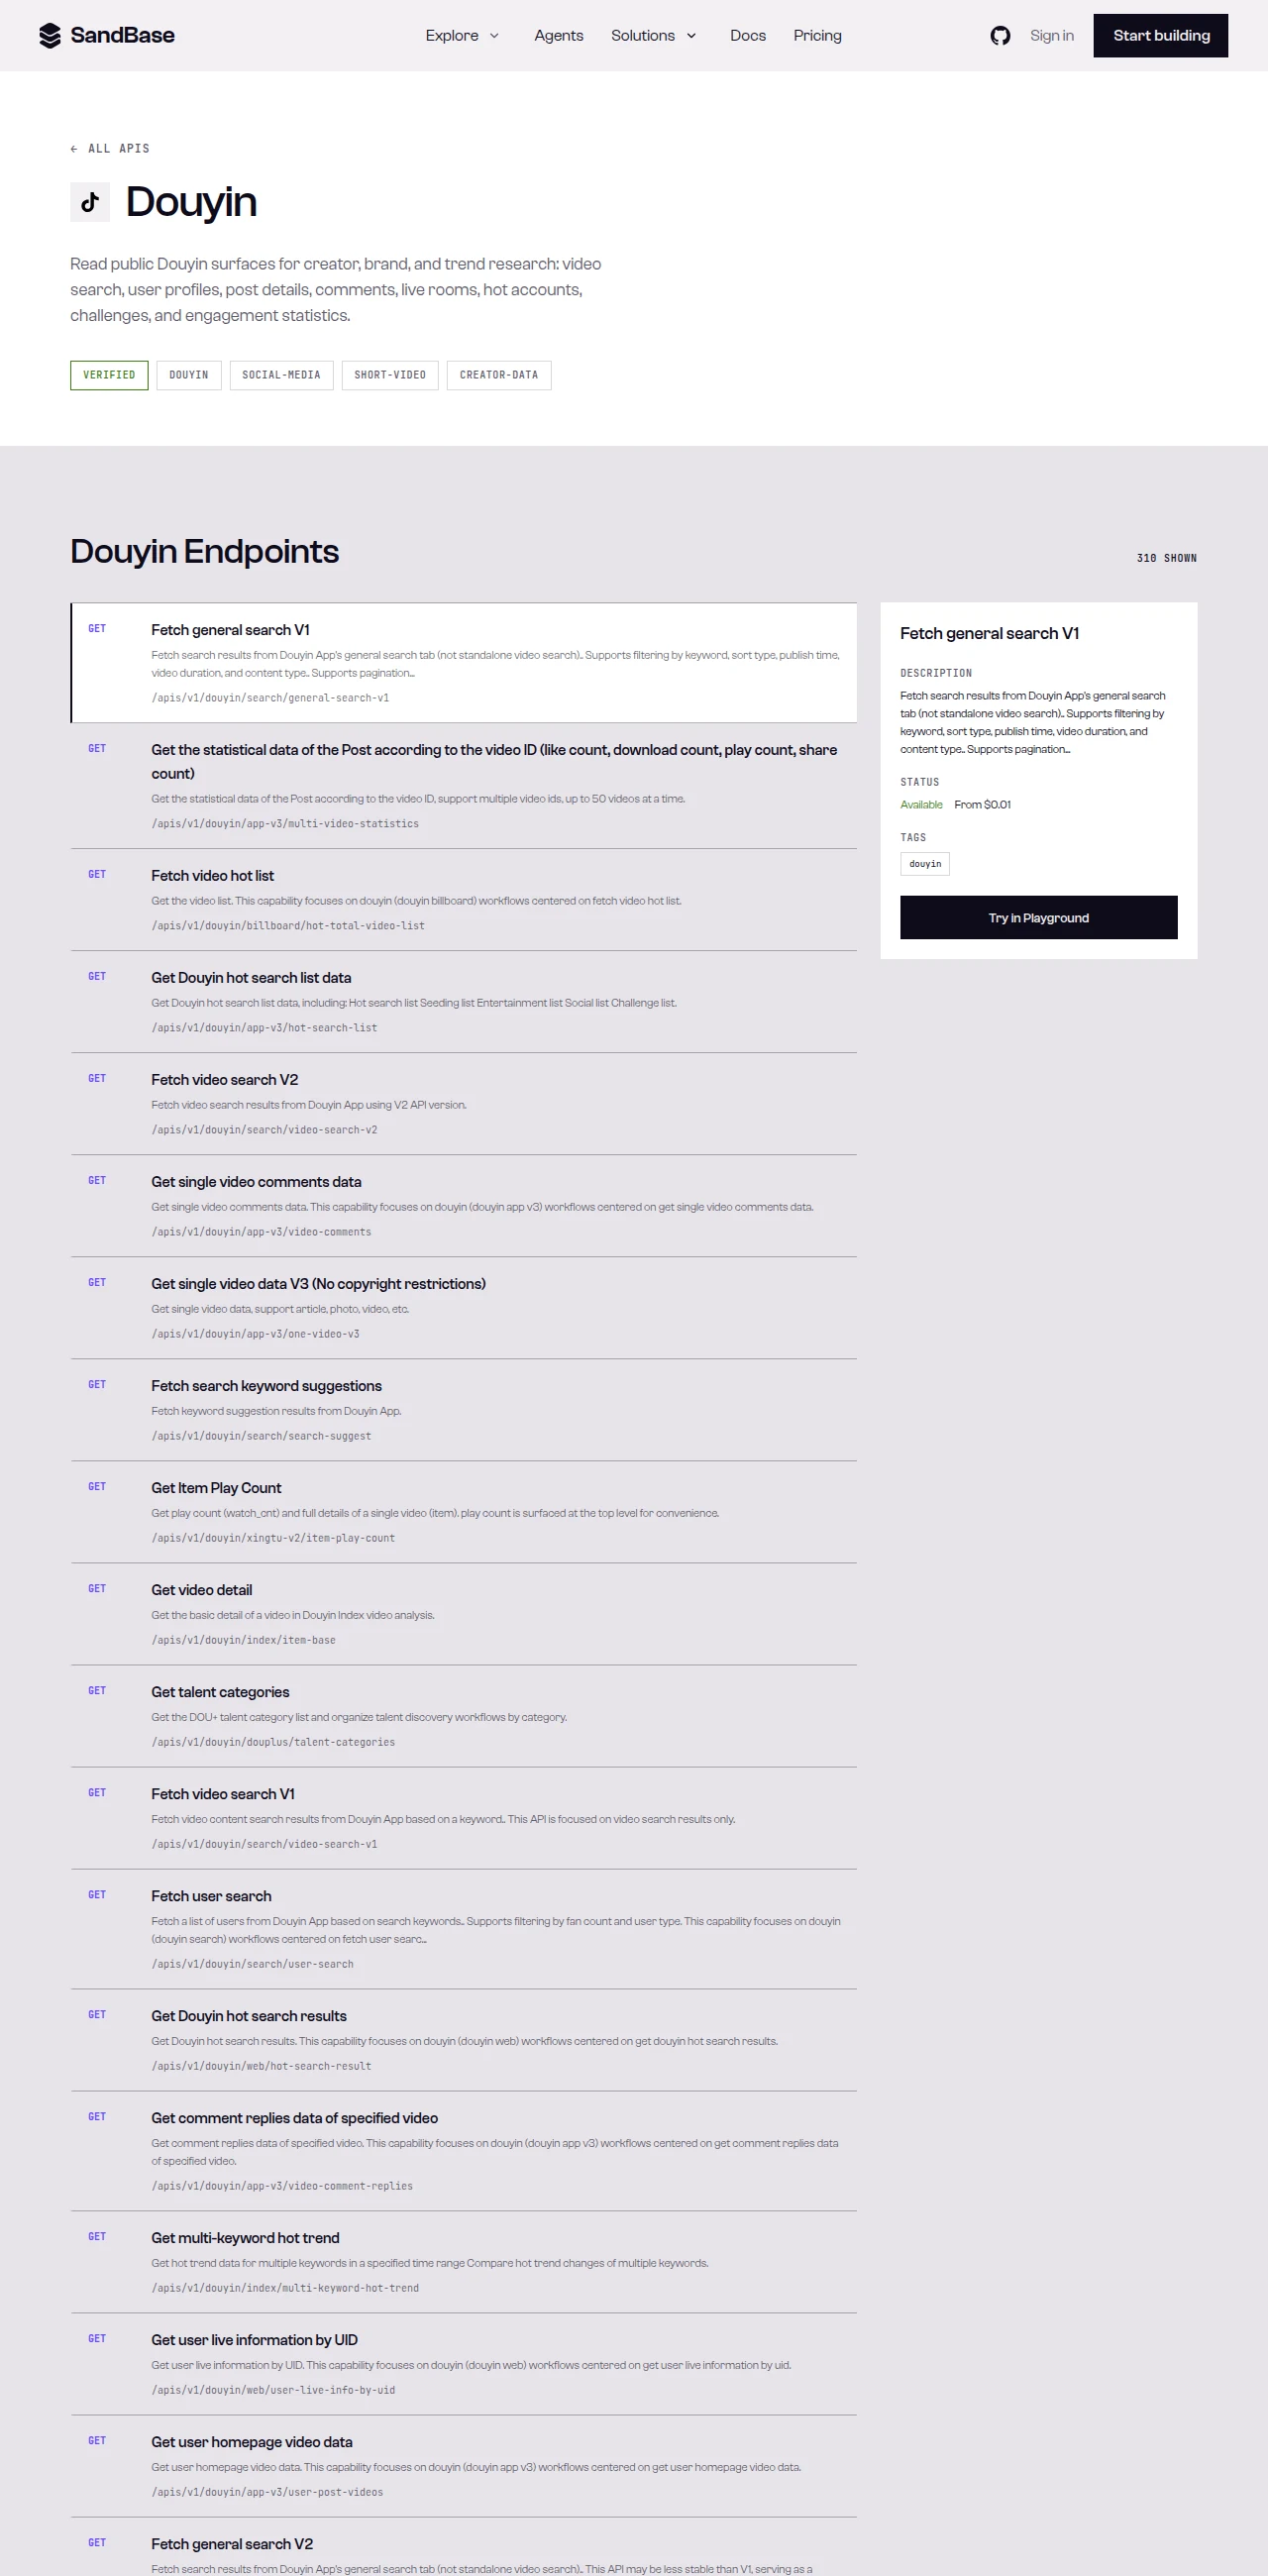 SandBase 上的抖音 API 页面——billboard 簇里包含 hot-total-high-like-list 端点。
第 1 步 —— 读抖音热榜
每个 SandBase Model API 调用都是向 /v1/api/<vendor>/<path> 发一个 POST,把密钥放在 Authorization 头里。读 outputs 前先按 status 分支判断,而且——因为抖音包了一层——读 data.objs 前先检查上游 code。
import os
import requests

SANDBASE = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}


def call(path: str, body: dict) -> dict:
    resp = requests.post(f"{SANDBASE}/{path}", headers=HEADERS, json=body, timeout=90)
    resp.raise_for_status()
    out = resp.json()
    if out.get("status") != "completed":
        raise RuntimeError(out.get("error", {}).get("message", f"{path} 未完成"))
    return out["outputs"][0]["data"]


def douyin_hot() -> list[dict]:
    data = call("douyin/billboard/hot-total-high-like-list", {})
    if data.get("code") != 0:
        raise RuntimeError(data.get("message", "抖音上游错误"))
    # 参考只保证信封,业务字段随端点而定、以真实响应为准。
    objs = data.get("data", {}).get("objs", [])
    return [
        {
            "source": "douyin",
            "rank": i + 1,
            "title": o.get("item_title"),
            "author": o.get("nick_name"),
            "metric": o.get("like_cnt"),
            "url": o.get("item_url"),
        }
        for i, o in enumerate(objs)
    ]
下面是一个示例响应结构——字段名并非保证的 schema、以真实响应为准,请把字段和取值当作示例,并对照真实响应核对,因为负载会随时间变化:
{
"id": "5494b9ed-3c71-4b9b-a1ee-b248ffaa6fae",
"status": "completed",
"model": "douyin/billboard/hot-total-high-like-list",
"outputs": [
{
"data": {
"code": 0,
"message": "…",
"data": {
"objs": [
{ "item_id": "…", "item_title": "…", "nick_name": "…", "like_cnt": 0, "item_url": "…" }
]
}
}
}
]
}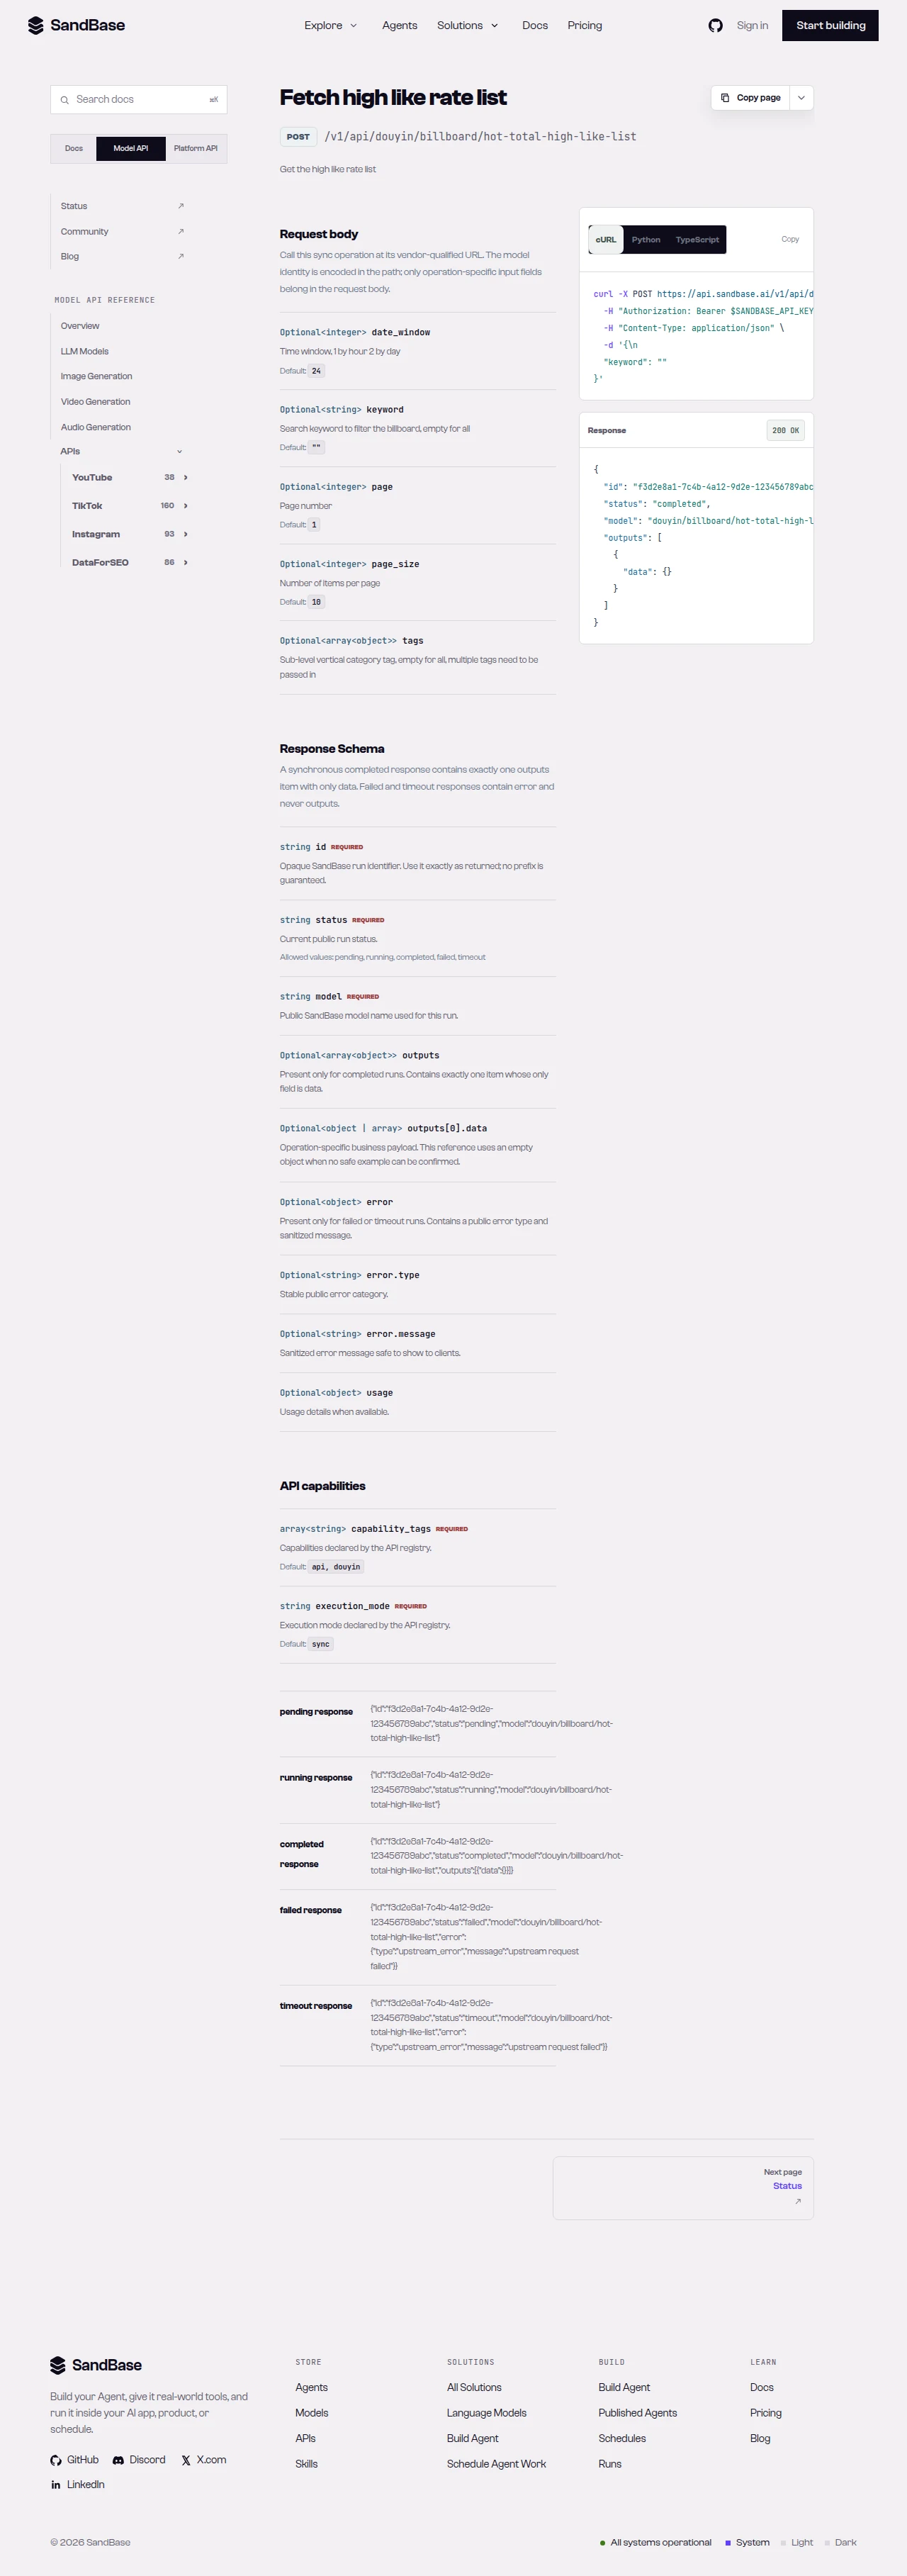 端点 API 参考是每个参数名和响应路径的事实来源。
第 2 步 —— 读快手热榜
快手把榜单以 list 直接放在 data 下——没有内层 code 包裹——所以映射器略简单。复用同一个 call 辅助函数:
def kuaishou_hot() -> list[dict]:
    items = call("kuaishou/web/hot-list-v1", {})
    # 参考只保证信封,业务字段随端点而定、以真实响应为准。
    return [
        {
            "source": "kuaishou",
            "rank": it.get("rank"),
            "title": it.get("name"),
            "author": None,
            "metric": it.get("viewCount"),
            "url": None,
        }
        for it in items
    ]
这里 data 下的负载本身就是排名话题的 list——每个条目带一个 name 和一个 rank。因为 call 已经按 status 分支过了,映射器只负责整形字段。
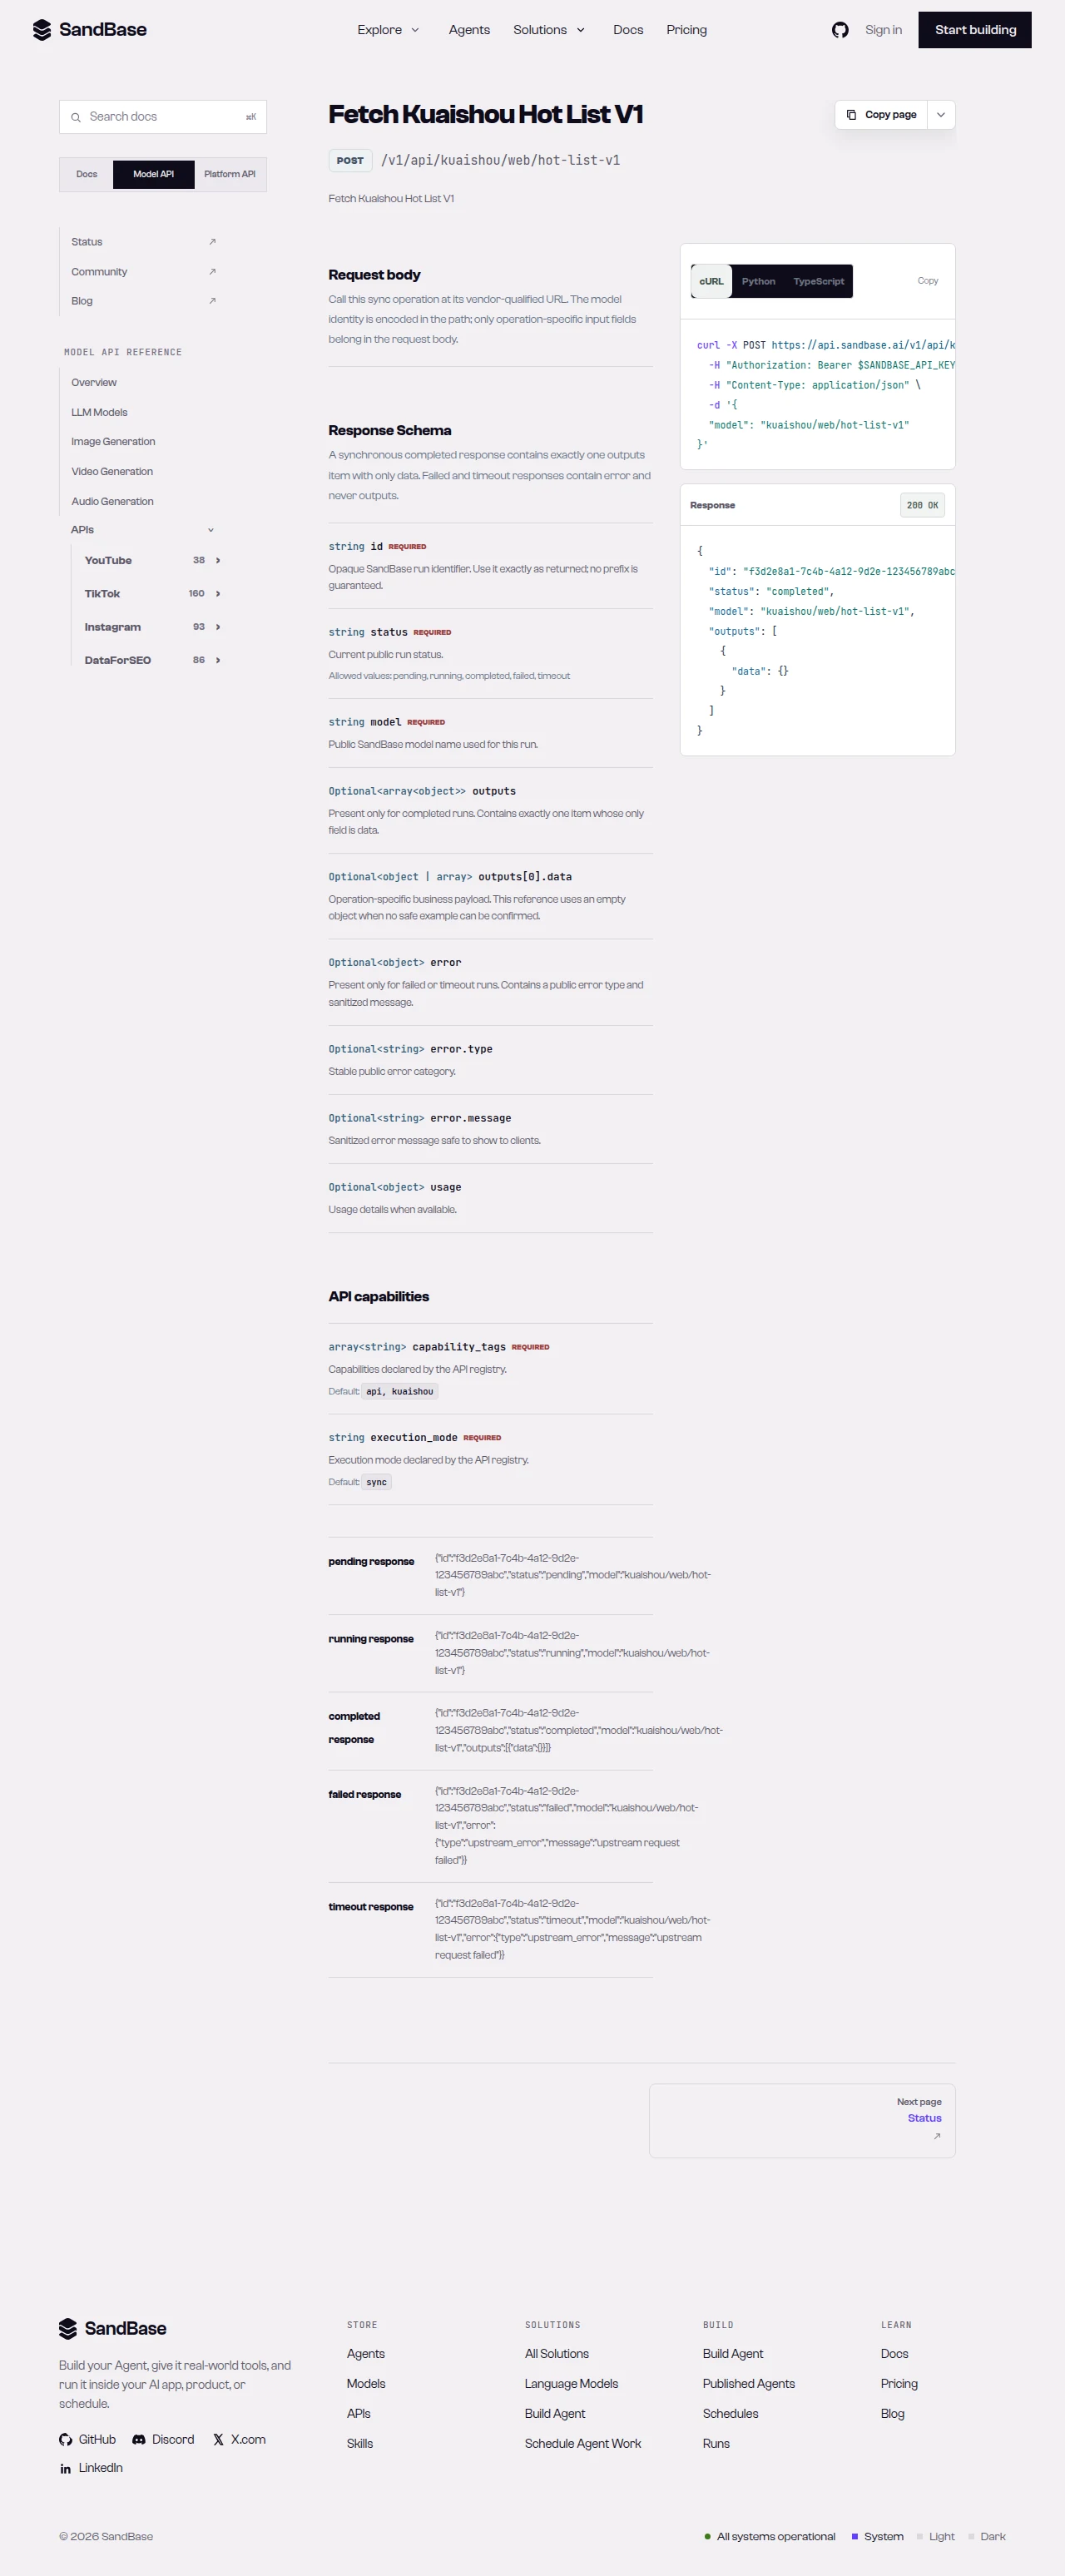 快手的 hot-list-v1 把榜单以 list 直接放在
data 下。
第 3 步 —— 归一化并合并
两个映射器已经输出相同的行结构:source、rank、title、author、metric、url。合并就变得很简单——拼接,再可选按 rank 交错,让每个榜的顶部都升到合并流的顶部:
def combined_trends() -> list[dict]:
    rows = douyin_hot() + kuaishou_hot()
    # 保留各平台自己的排名,按来源分组
    rows.sort(key=lambda r: (r["source"], r["rank"] if isinstance(r["rank"], int) else 999))
    return rows


for row in combined_trends()[:10]:
    print(f"[{row['source']}] #{row['rank']} {row['title']}")
收益在于:你流水线的其余部分——去重、关键词打标、存储、告警——看到的是一个统一行,而不是两种厂商专属负载。以后加第三个平台,它也照样接在同一个 call 辅助函数和同一个行结构后面。
为什么这里统一信封很关键
两个榜在传输层看着不同,但它们回来时用的是相同的 { id, status, model, outputs } 信封。这意味着脆弱的那部分——鉴权、传输、status 处理、重试——只在 call 里写一次,两个都复用。唯一的每平台代码是那个知道各榜把行放在哪里的小映射器:抖音在 data.data.objs,快手在 data 下的 list。当负载变动时,你修一个映射器,而不是一整个采集器。
正是这种分离让聚合器容易生长。换进另一个热榜端点,写五行映射到同一行结构,所有下游消费者原封不动继续工作。你的注意力停在”趋势意味着什么”上,而不是停在调和信封上。当你需要的不止是热榜——某条视频的详情、某个创作者的主页——去各平台的总览里查到合适的端点,并在接入前确认它的参数。
局限与边界
- 仅公开、只读数据。 不发帖、不关注、不涉及私有或仅账号可见的数据。
- 负载结构不同且会变。 抖音嵌在
data.data.objs下并带上游code;快手把 list 放在data下。先看一次真实响应、读一遍各自结构。 - 速率与量级。 把响应当作尽力而为的读取;遇到 HTTP 429 等瞬时错误时按退避策略重试。
- 以线上参考核对端点。 可用性和字段可能变化;在依赖某个具体端点前先确认。
- 这不是官方合作。 SandBase 提供对公开数据的统一访问;请尊重各平台条款和适用规则。
常见问题
我需要抖音或快手登录吗?
不需要。你用自己的 SANDBASE_API_KEY 向 SandBase 鉴权。这些读取端点不需要你这边有平台账号或 OAuth。
为什么抖音映射器检查 code,快手的不检查?
抖音把结果包在上游 code/data 对象里,所以读 data.objs 前先检查 code == 0。快手把 list 直接放在 data 下。每个端点都要检查一次真实响应。
我能加第三个平台吗?
能。复用 call 辅助函数,写一个映射到同一行结构的映射器,再拼接。这正是尽早归一化的意义所在。
动手搭
创建一个 SandBase API 密钥,跑两个热榜调用,归一化成一条流。准备好后: