Qwen4-Max 和 Qwen3.8 Max 怎么选?新的生产流量该不该切换?
新生产从 Qwen4-Max 开始(SandBase $1.67 / $5.00)。需要九折基线时继续用 Qwen3.8 Max($1.80 / $5.40)。
新的生产从 Qwen4-Max 开始。账号已经钉死在 Qwen3.8 Max 上、你要的就是那张九折卡、而且 agent 还没按新的默认力度重新验证过,就继续留在 Qwen3.8 Max。两个模型都已正式可用。Qwen4-Max 在 2026 年 11 月 16 日正式发布,有公开按量价格,SandBase 卡片在线。官方文档现在把 qwen4-max 推荐给优先质量的场景,并把 qwen3.8-max 放进较旧模型。
新 ID 怎么调、输出上限是多少、和阿里自己的标价差在哪,看 Qwen4-Max 已正式发布。11 月 15 日那篇 Qwen4-Max-Preview 和 Qwen3.8 Max 怎么选 是预览期的切换记录,保持原样。在任模型的长文是 Qwen 3.8 Max:阿里巴巴 2.4T 多模态旗舰模型全面解析。
先说结论
- 新生产走 Qwen4 Max,ID
alibaba/qwen4-max。SandBase hero $1.67 / $5.00,缓存读取 $0.08,缓存写入 $2.08,没有九折。新加坡官方标价 $1.50 / $4.50。北京与 Global 官方标价 $1.413 / $4.24。- 已验证的基线留在 Qwen3.8 Max。SandBase hero $1.80 / $5.40,标价 $2 / $6 的九折,缓存读取 $0.23,缓存写入 $2.25。
qwen3.8-max的阿里官方最大输出仍是 128k。SandBase hero 印 131.1K。- 官方上下文两边都是 1,000,000。Qwen4-Max 官方输出是非思考 131,072、思考加回答 262,144。预览期的 393,216 不是正式上限。
- 2026 年 11 月 16 日在 SandBase 上的 9 项小探测,两边都是 8 通过、1 部分、0 失败。这一组里 Qwen4-Max 每一项都更快。这是小规模实用探测,不是公开榜。
- 不要把新生产开在
qwen4-max-preview上。该预览仍在 2026 年 11 月 25 日 24:00(UTC+8)之后下线。
更新(2026 年 11 月 16 日): 同一天在 SandBase 上的流式探测里(并发 1、默认 thinking、固定长度解码),Qwen3.8 Max 往往更早吐出第一个思考 token,但想得更久,所以第一个回答 token 大约比 Qwen4-Max 晚 2.2 秒。这一组里 Qwen4-Max 的解码也更快(中位 93.1 对 54.1 token/s)。这是单机、经网关的探测,不是容量测试,也不是官方基准;和下面已写的 9 项实用探测不是同一组试验。完整表格和方法见 Qwen4-Max 和 Qwen3.8 Max 实测:SandBase 上的首 token(TTFT)、TPOT、吞吐与缓存命中率。
能放进同一张表的差异
官方列的出处是 QwenCloud 最新模型页、QwenCloud 价格页,以及阿里云 文本生成与视觉理解 表,均核对于 2026 年 11 月 16 日。SandBase 数字是当天下午的 hero。
| 项目 | Qwen4-Max | Qwen3.8 Max |
|---|---|---|
| 状态 | 2026 年 11 月 16 日正式发布。Qwen4 家族第一个模型。 | 正式可用。官方文本生成页现在把它放在较旧模型下。 |
| SandBase ID | alibaba/qwen4-max | alibaba/qwen3.8-max |
| 新加坡官方标价 / 1M | $1.50 / $4.50 | $2 / $6 |
| 北京 / Global 官方 | $1.413 / $4.24 | 这篇不另引。上面的新加坡标价是这次对照里重新确认过的。 |
| SandBase hero / 1M | $1.67 / $5.00。没有九折。 | $1.80 / $5.40,标价 $2 / $6 的九折。 |
| SandBase 缓存读 / 写 | $0.08 / $2.08 | $0.23 / $2.25(标价 $0.25 / $2.50) |
| 官方上下文 | 1,000,000 | 1,000,000 |
| 官方最大输出 | 非思考 131,072;思考 + 回答 262,144 | 128k |
| SandBase 上下文 / 最大输出 | 1M / 131.1K | 1M / 131.1K |
| 思考默认 | 开启。reasoning_effort 默认 high。 | 这次核对没有改写旧默认。不要未经重测就把 Qwen4 的新默认抄到旧客户端上。 |
| 模态 | 官方:文本、图像、视频进,文本出。卡片列出 vision。 | 官方表:文本、图像、视频。卡片列出 vision,以及 chat、reasoning、structured output、function calling。 |
| 批量 | 官方模型页:不支持。 | 不拿批量当留下的理由。 |
Qwen3.8 Max 的两个输出标签分开写。阿里印 128k。SandBase hero 印 131.1K。客户端跟自己实际调用的那一端。
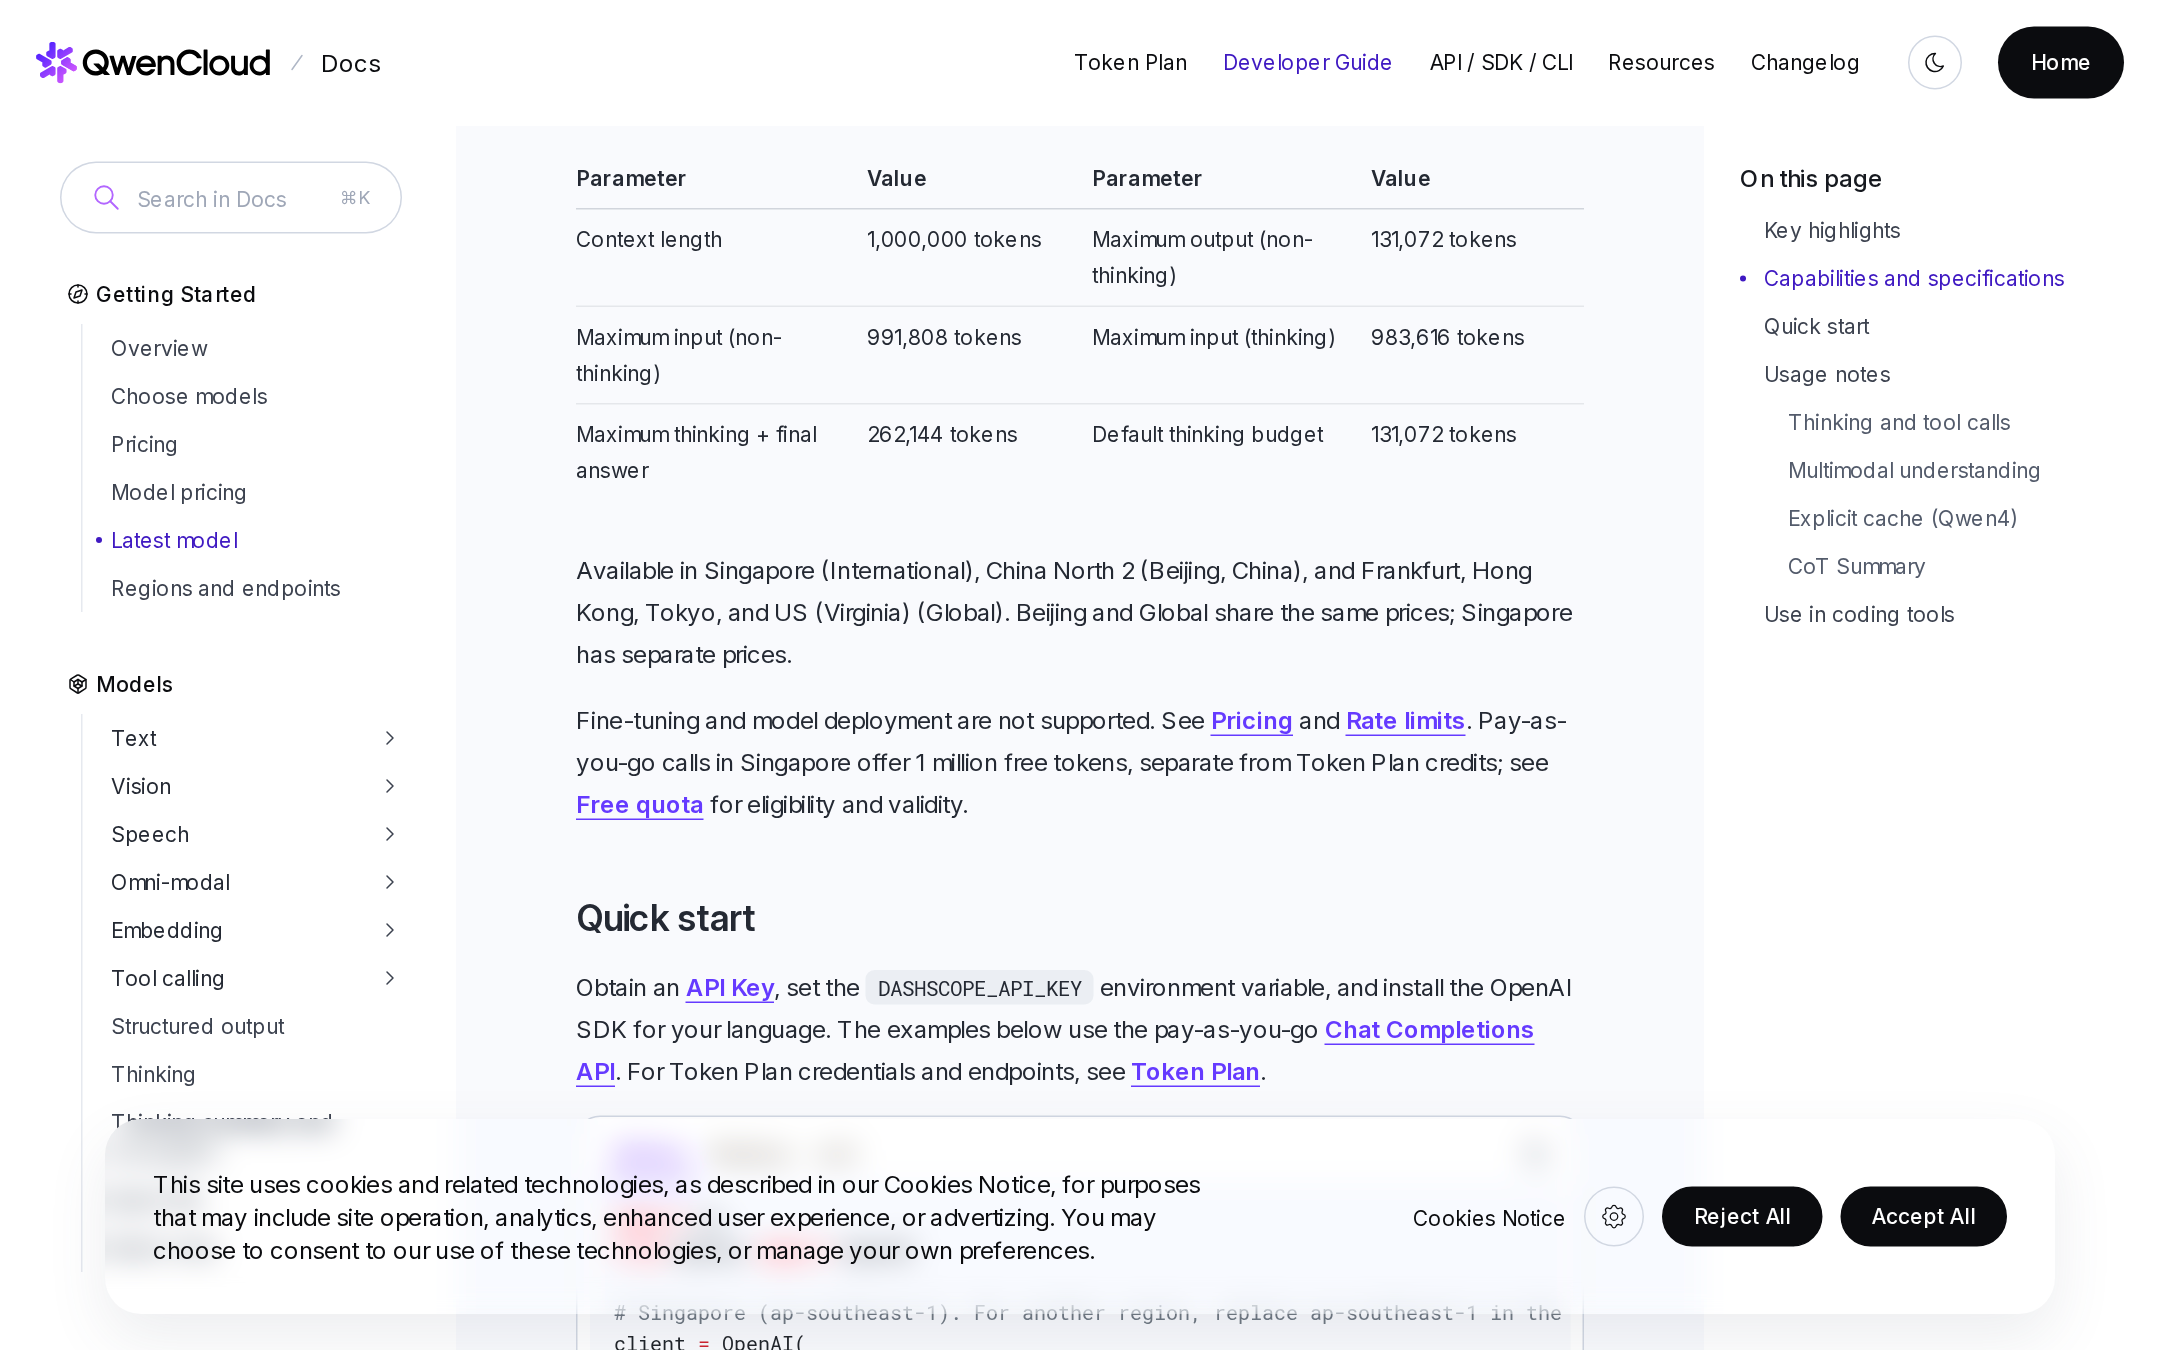
Official QwenCloud latest-model page as of 16 Nov 2026, Asia/Shanghai. Official GA limits are 1,000,000 context, 131,072 maximum output (non-thinking), and 262,144 maximum combined thinking plus final answer. The same page states that fine-tuning and model deployment are not supported, and that pay-as-you-go calls in Singapore offer 1 million free tokens. (A site cookie banner is visible at the bottom of this capture and does not cover the limits table.)
同一天下午,阿里云文本生成页在优先质量时推荐 qwen4-max,最大输出写成 “131,072 (Non-thinking); 262,144 (thinking + output)”,上下文 1M,单图最大 16M 像素,视频最长 2 小时。优先成本时推荐 qwen3.8-flash,并把 qwen3.7-plus 写成平衡、可以先从这里开始的选项。qwen3.8-max 在 “Older models” 下面,上下文仍是 1M,官方最大输出仍是 128k,并注明这些模型不再是第一推荐。qwen4-max-preview 和 393,216 已经不在这张表里。这是官方推荐,不是 SandBase 排名,也不是去编 Qwen4-Plus、Qwen4-Flash 或 Qwen4-27B 卡片的理由。11 月 16 日这张表的截图不可用,上面的数字来自页面文字。
两张卡各自收多少
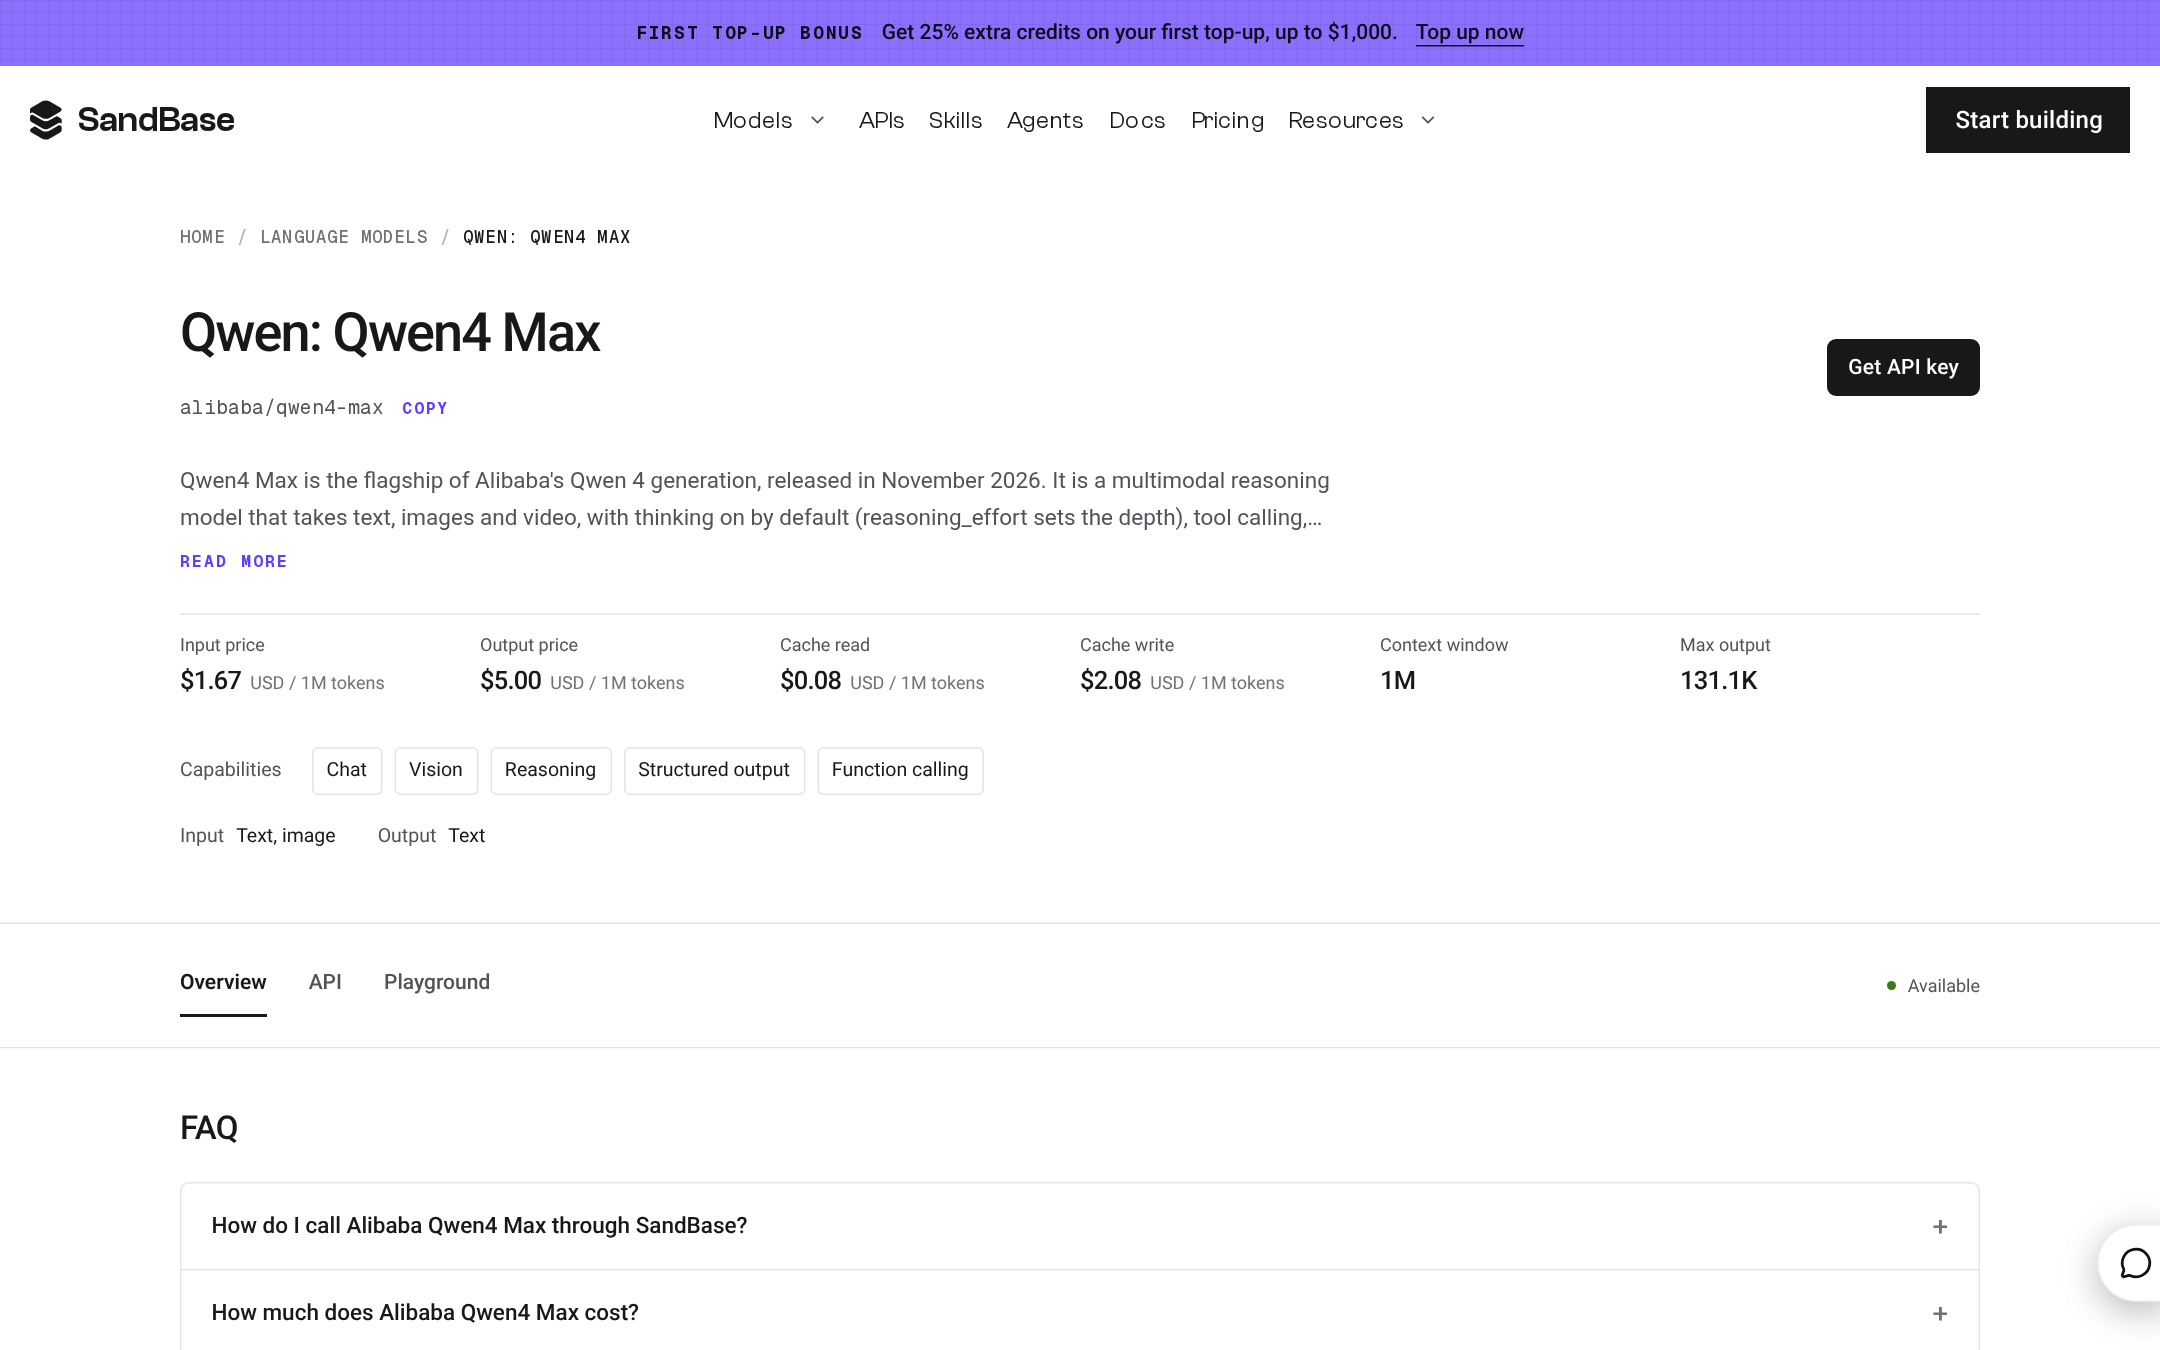
Live SandBase Qwen4 Max card at /models/alibaba/qwen4-max, captured 16 Nov 2026, Asia/Shanghai (HTML and .md both HTTP 200). Hero is $1.67 / $5.00, with cache read $0.08 and cache write $2.08 per 1M tokens, 1M context, and 131.1K max output. There is no 10% off badge. These SandBase prices are above the official Singapore list of $1.50 / $4.50, and above official Beijing / Global $1.413 / $4.24, but still below SandBase Qwen3.8 Max at $1.80 / $5.40. The card hero max output of 131.1K matches the official non-thinking cap; the card description still incorrectly says “up to 393K output tokens shared by thinking and the answer,” which is a preview leftover, not the official GA limit.
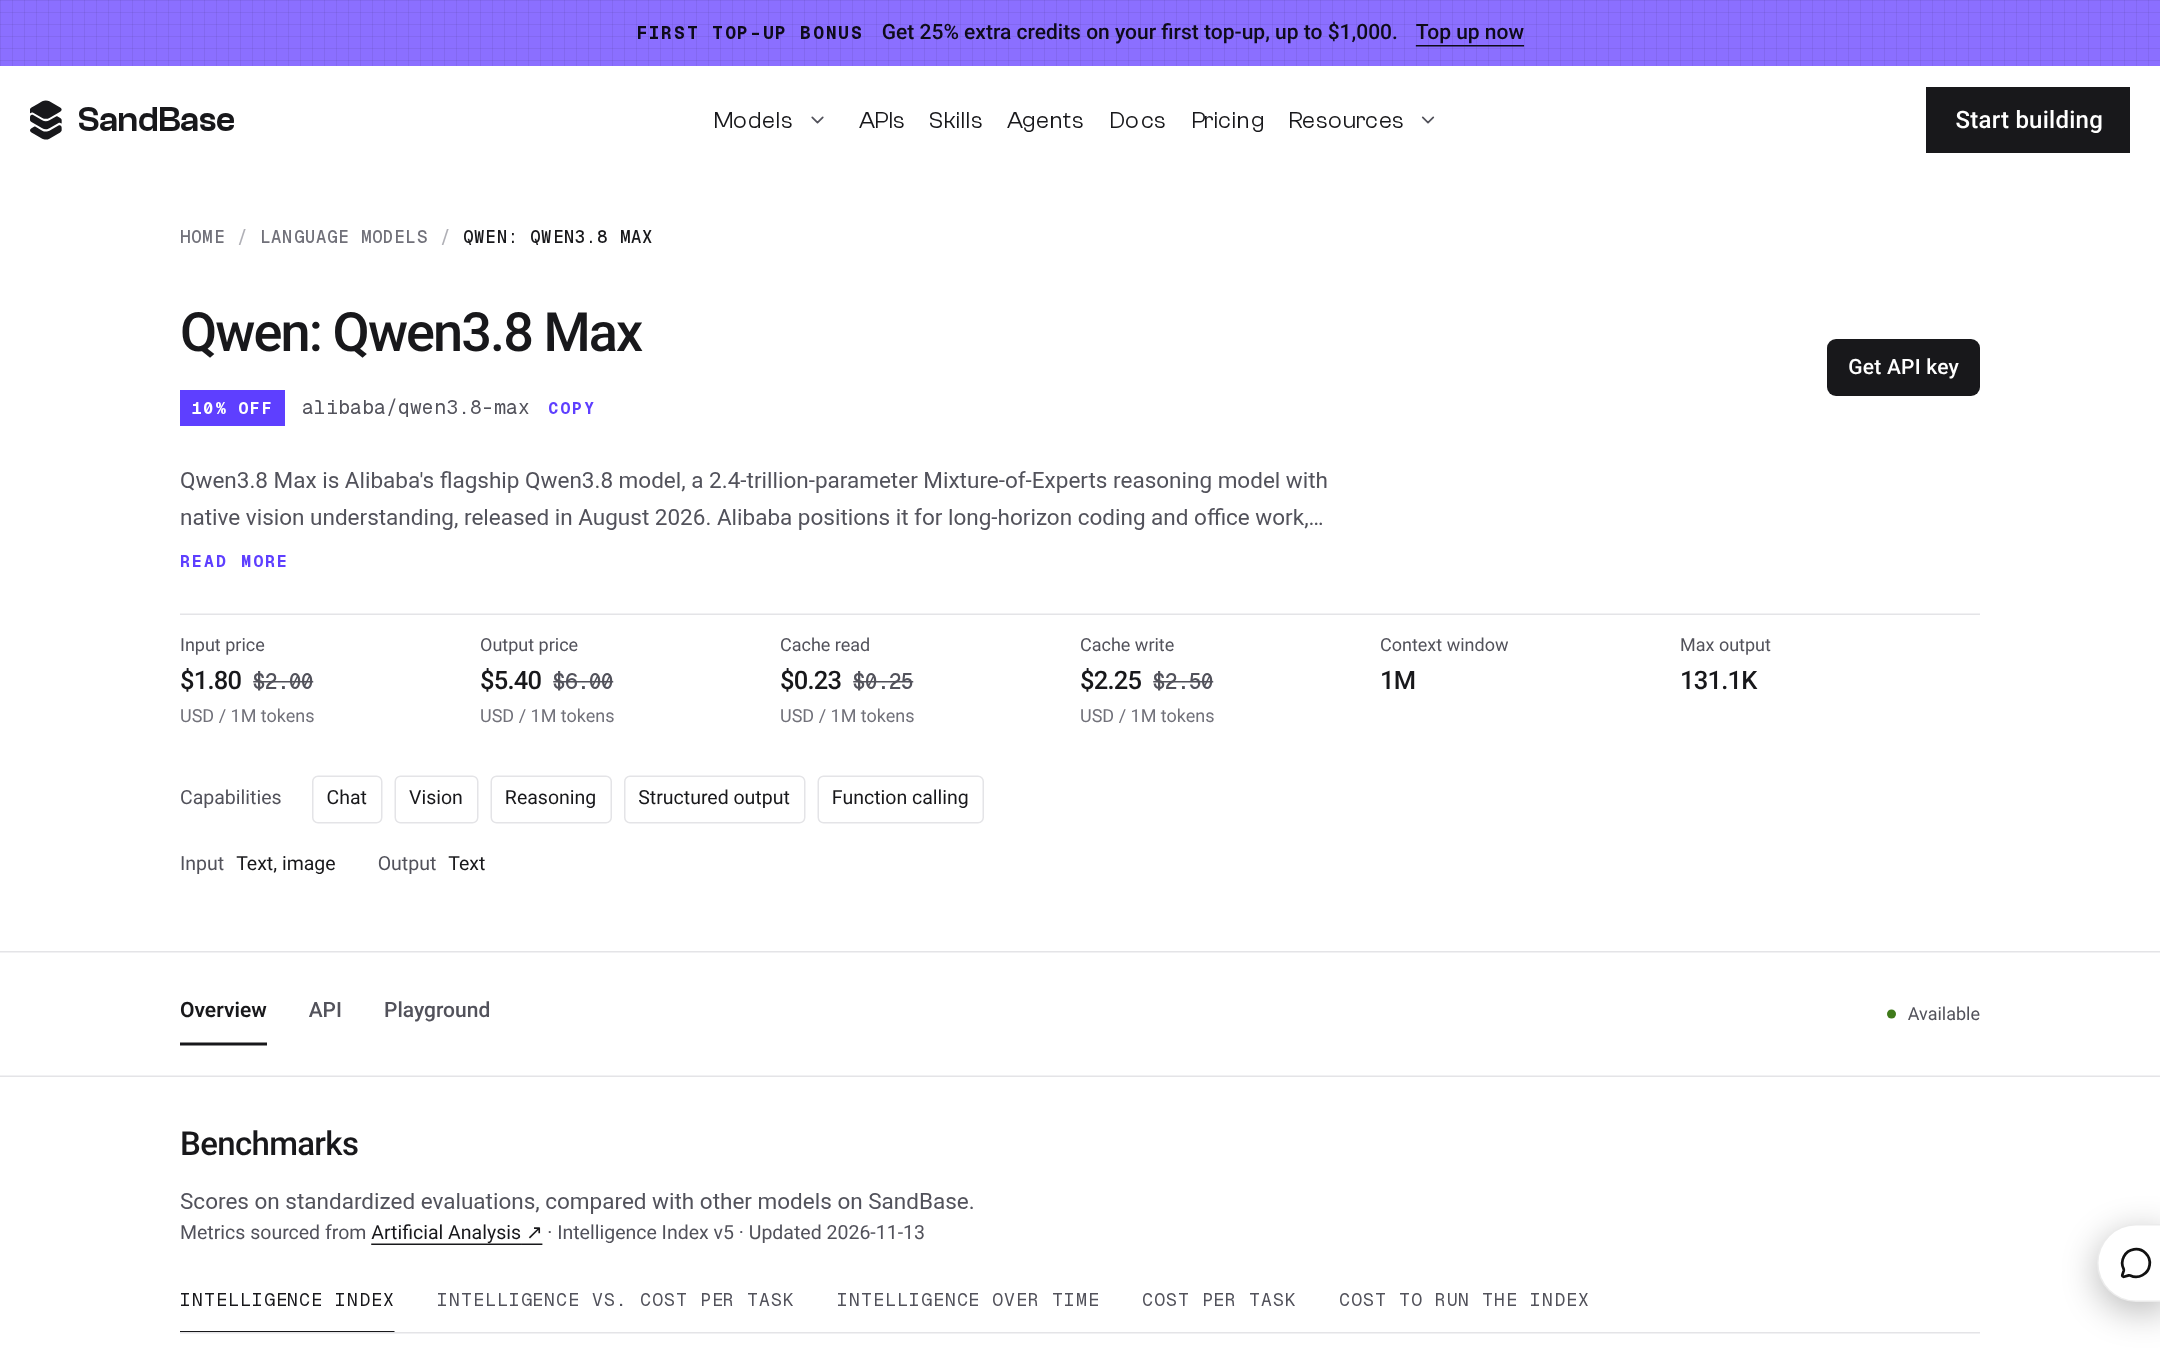
Live SandBase Qwen3.8 Max card at /models/alibaba/qwen3.8-max, captured 16 Nov 2026, Asia/Shanghai. Hero is $1.80 / $5.40 (10% off the $2 / $6 list), with cache read $0.23 and cache write $2.25 per 1M tokens, 1M context, and 131.1K max output. Official Alibaba max output for qwen3.8-max remains 128k; cite both figures and name the source.
在 SandBase 上,两张旗舰 hero 里 Qwen4-Max 更低:$1.67 / $5.00 对 $1.80 / $5.40。九折标记只属于 Qwen3.8 Max。Qwen4-Max 的官方缓存也和卡片不同。新加坡缓存读取 $0.075,写入是 5 分钟 $1.875 或 1 小时 $3。卡片只印一个写入价 $2.08、读取 $0.08。官方价格页把思考 token 按输出计费,Qwen4-Max 没有输入长度分档。那条通用 Batch API 50% 说明套不上:官方 Qwen4-Max 模型页写明不支持批量推理。
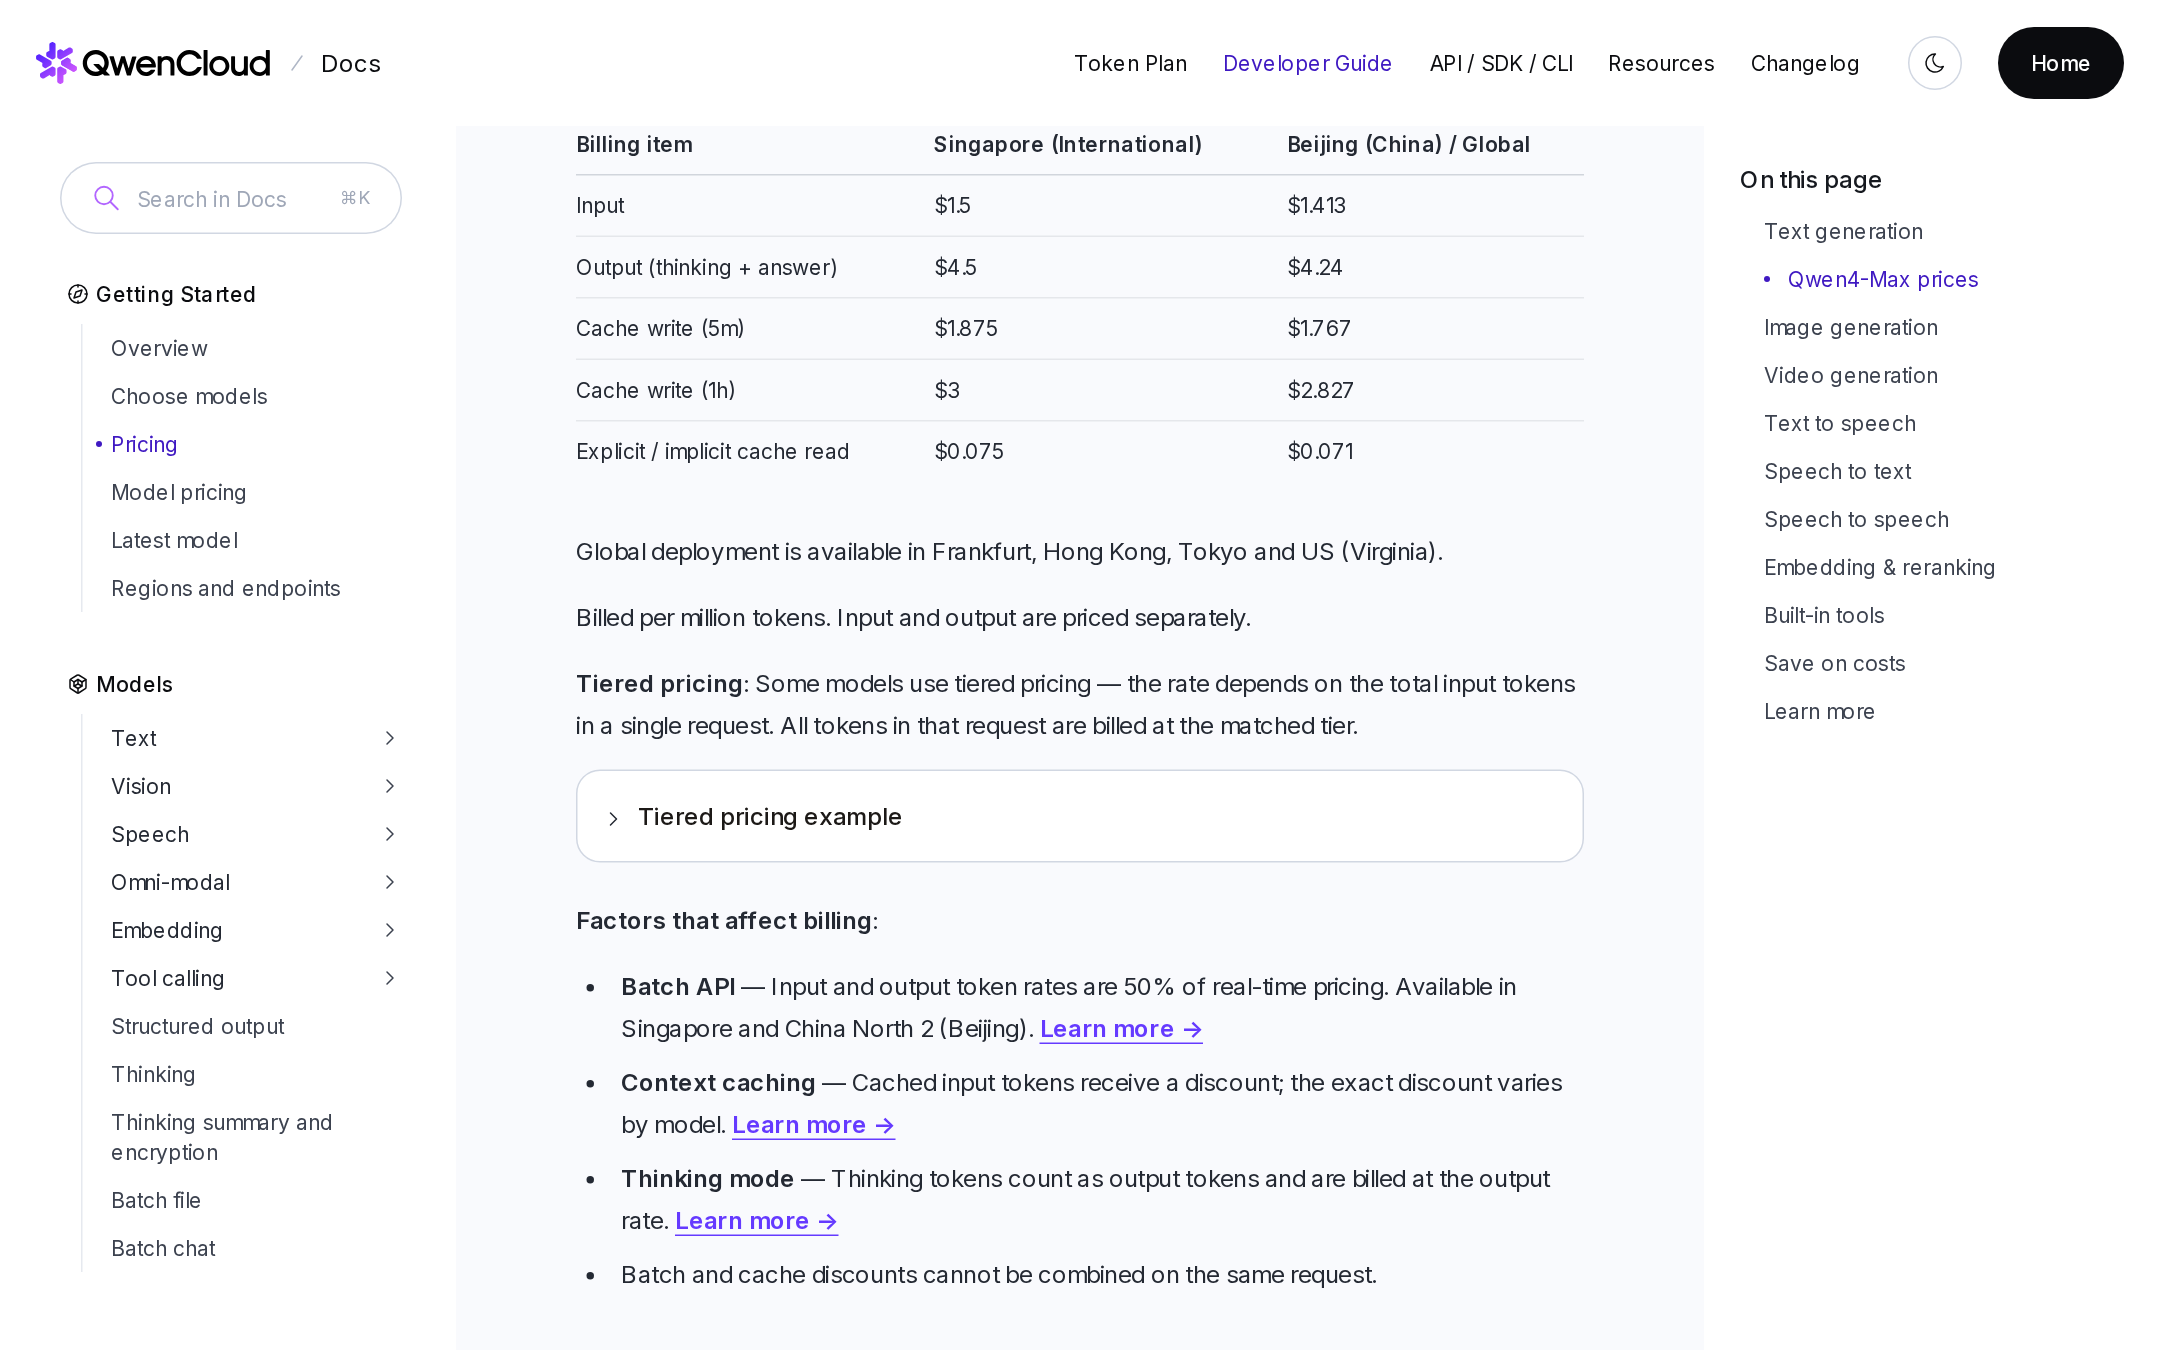
Official QwenCloud pricing page, captured 16 Nov 2026, Asia/Shanghai. Singapore (International) list is $1.5 / $4.5 per 1M tokens (the page prints $1.5 / $4.5, equivalent to $1.50 / $4.50), with cache write $1.875 (5m) / $3 (1h) and cache read $0.075. Beijing / Global is $1.413 / $4.24, with cache write $1.767 / $2.827 and cache read $0.071. The page states that thinking tokens are billed at the output rate, and that Qwen4-Max has no input-length tiers. The “Batch API 50%” bullet on this page is a general billing factor — official Qwen4-Max model pages list batch inference as not supported for this model.
官方 QwenCloud 的新加坡按量提供 100 万免费 token,和 Token Plan 额度分开。其他区域没有。SandBase 卡片没有写这笔额度。
9 项探测:先写方法和边界
2026 年 11 月 16 日(亚洲/上海),同一条 Chat Completions 对 alibaba/qwen4-max 和 alibaba/qwen3.8-max 跑了九项任务。时间窗口是 12:17:28 到 12:19:08(UTC+8)。思考留在 API 默认,也就是开启。max_tokens 为 4096。评分是自动的,对照隐藏的期望答案。这是小规模实用探测。它不是已发布的基准,不是厂商分数,也不是对 Gemini 4 Carbon、GPT-6 Astra 或 Claude Fable 5.2 的排名。那三个模型不在这组里。
| Qwen4-Max | Qwen3.8 Max | |
|---|---|---|
| 得分 | 8 通过,1 部分,0 失败 | 8 通过,1 部分,0 失败 |
| 墙钟 | 33.566 秒 | 66.332 秒 |
| 按 SandBase 卡片价估算的费用 | $0.006376 | $0.012456 |
| 提示 / 完成 token | 971 / 951 | 1394 / 1842 |
这一组里 Qwen4-Max 每一项都更快。完成 token 是 951 对 1842。费用用的是卡片价($1.67 / $5.00 对 $1.80 / $5.40),不是官方标价。
| 任务 | 结果 | Qwen4-Max | Qwen3.8 Max |
|---|---|---|---|
| smoke | 两边精确通过 | 2.959 秒,32/17 | 7.96 秒,71/29 |
| math_mod(3^100 mod 7 = 4) | 两边通过 | 5.748 秒,61/220 | 8.099 秒,100/229 |
| lockers(100 个柜子 = 10) | 两边通过 | 5.688 秒,84/177 | 6.228 秒,123/220 |
| pack_discount($2.40 对 5 件 $10,17%) | 两边通过 | 4.52 秒,86/126 | 5.665 秒,125/186 |
| coding_lis | 两边都是 O(n log n) 的 bisect_left 耐心排序;7 个隐藏测试通过 | 2.379 秒,91/89,9 个推理 token | 4.943 秒,130/175,83 个推理 token |
| json_extract | 两边都是 Maya Chen / 34 / Singapore | 1.868 秒,62/26,单行对象 | 4.439 秒,101/79,美化打印,按正文匹配计分 |
| zh_formula | 两边都只要 H₂O | 2.678 秒,44/31 | 4.508 秒,83/88 |
| vision_probe | 两边部分,4/5 | 6.013 秒,314/223 | 20.867 秒,315/779 |
| tool_weather | 两边都调用了 get_weather,city=Tokyo | 1.713 秒,197/42,空内容加工具调用 | 3.623 秒,346/57,还说了会查东京天气 |
共同的部分分是探测图本身的问题。两边都把 “SB-Q4-42” 读成 “SB-04-42”,因为生成的位图里 Q 看起来像 0。两边都认出了红圈和绿色形状。Qwen4-Max 把 160×140 的色块叫成正方形。Qwen3.8 Max 叫成矩形。这不是模型排名,探测图也不贴在这里。
这组数据支持的是:这九项上准确度相同,Qwen4-Max 用了更少时间、更少完成 token、更低的卡片价费用。它不支持 “Qwen4-Max 总体上更聪明”,也不支持任何关于 Carbon、Astra 或 Fable 的结论。
官方博客对同一对模型说了什么
发布文 说 Qwen4-Max 是 “a significant step up from Qwen3.8-Max, delivering stronger performance across nearly every capability we evaluated.” Work360 上报 52.69,Qwen3.8-Max 是 47.74。相对 Qwen3.8-Max 的 token 用量,它写 Work360 “approximately 24% and 35% at Xhigh and High effort, respectively”,Terminal-Bench 4.0 “approximately 48% and 49%, respectively”。它还说相对 Qwen3.8-Max 降低了 API 价格,“with particularly large reductions in cached-input pricing”,Work360 平均每任务成本 “from $4.43 to $1.67 — a 62% reduction”。
这些句子是厂商对指名评测的说法。它们不是上面的 9 项探测,也不能收成一句 “任意 agent 都省一半 token”。博客里的 $1.67 是 Work360 的平均每任务成本。SandBase 的 $1.67 是 Qwen4-Max 卡片上每百万输入 token 的价格。数字相同,单位不同。厂商分数的脚注在博客上,不在这次探测里。
什么时候仍然调用 Qwen3.8 Max
三件事同时成立时,留在 Qwen3.8 Max:提示词、工具和评分器已经钉在它上面;你要的是九折 hero 和它的缓存价;你还没准备好按 reasoning_effort=high 和新的输出上限重新验证。新的默认力度会改变同一条提示在答案出现之前花掉多少 token。这是一次迁移,不是换个字符串。
旗舰尺寸不合适时,其他在售的 Qwen3.8 卡片:
- Qwen3.8 27B,$0.50 / $3,缓存 $0.10 / $0.63,1M / 131.1K。稠密开源视觉语言模型。卡片列出 vision。
- Qwen3.8 Omni Flash,$0.15 / $0.47,缓存 $0.02 / $0.15,1M / 131.1K。文本、图像、音频、视频进,文本出。官方 Qwen4-Max 文档没有声称音频输入。
- Qwen3.8 Flash,$0.15 / $0.47,缓存 $0.02 / $0.20。SandBase hero 的上下文是 N/A,最大输出 131.1K。不要编 SandBase 上下文。官方文档另行把
qwen3.8-flash写成 1M / 128k。 - Qwen3.8 Max Prime,$4 / $12,缓存 $0.50 / $5.00,1M / 131.1K。同一 Max 模型的更快服务。
- Qwen3.8 2.4T A95B,$2 / $6,缓存 $0.25 / $2.50,1M / 52.4K。卡片列出 chat、reasoning、structured output、function calling。列表里没有 vision。
预览还是当时唯一的 Qwen4 故事时,Max、27B 和 Omni Flash 怎么分流,写在 今天该调用哪个 Qwen?。把它当现状之前,先读那篇开头的 11 月 16 日更新。
不要从预览开新生产
alibaba/qwen4-max-preview 仍在列表里,价格 $2.00 / $6.00,缓存 $0.25 / $2.50。Hero 上下文是 N/A。官方 Token Plan 文案仍写明预览模型在 2026 年 11 月 25 日 24:00(UTC+8)之后下线。生产用的正式 ID 是 alibaba/qwen4-max。两张语言模型卡的端点都是 POST https://api.sandbase.ai/v1/chat/completions。
已确认与未知
| 已确认 | 未知,或不在这篇范围内 |
|---|---|
| 两个模型都已正式可用,并且在 SandBase 上线,价格和上限见上表 | Qwen4-Max 是否在总体上 “更聪明” |
官方质量推荐现在指向 qwen4-max;qwen3.8-max 在较旧模型下 | 上面引文之外的官方博客分数 |
| 9 项探测:同为 8 / 1 / 0,这一组里 Qwen4-Max 更快、按卡片价更省 | 用这次探测给 Qwen4-Max 对 Carbon、Astra 或 Fable 排名 |
官方模型页写明 qwen4-max 不支持批量推理 | 给 Qwen4-Max 编一个 SandBase 九折 |
常见问题
现有的 Qwen3.8 Max 流量这周要不要搬?
新流量要搬,除非你还需要在任模型的提示栈原样不动。旧流量等你用新的默认思考、以及装得下思考加回答的完成上限,把评分器重跑一遍再搬。上面的探测是去跑这次检查的理由。它替代不了你自己的任务。
输出上限抄哪一个?
Qwen4-Max:关思考抄 131,072,思考和回答共用预算时抄 262,144。Qwen3.8 Max:官方阿里文档抄 128k,SandBase hero 抄 131.1K,并写明是哪一端。SandBase Qwen4-Max 描述里仍写着的 393K 是残留。
SandBase 上的 Qwen4-Max 价格就是官方价格吗?
不是。新加坡官方是 $1.50 / $4.50。北京与 Global 官方是 $1.413 / $4.24。SandBase 是 $1.67 / $5.00,没有折扣。它仍然低于 SandBase 上的 Qwen3.8 Max hero。
现在打开哪一页
新生产打开 Qwen4 Max,官方标价和卡片 hero 一起看。Qwen3.8 Max 留给你就是要那张九折基线的时候。注册 之后,先按 第一次调用 文档发一条,模型 alibaba/qwen4-max,再去切队列。
卡片 hero、官方上限和 9 项探测均来自 2026 年 11 月 16 日(亚洲/上海)。Work360 与 Terminal-Bench 的句子只引自官方发布文。这次探测没有纳入 Gemini 4 Carbon、GPT-6 Astra 或 Claude Fable 5.2。
相关阅读
觉得有用?分享给更多人