今天该调用哪个 Qwen?Qwen 4 仍在预览时,Qwen3.8 Max、27B 和 Omni Flash 怎么选
11 月 15 日的 Qwen3.8 Max、27B、Omni Flash 分流。更新(2026 年 11 月 16 日):Qwen4-Max 已正式发布,并在 SandBase 上以 alibaba/qwen4-max 在线。
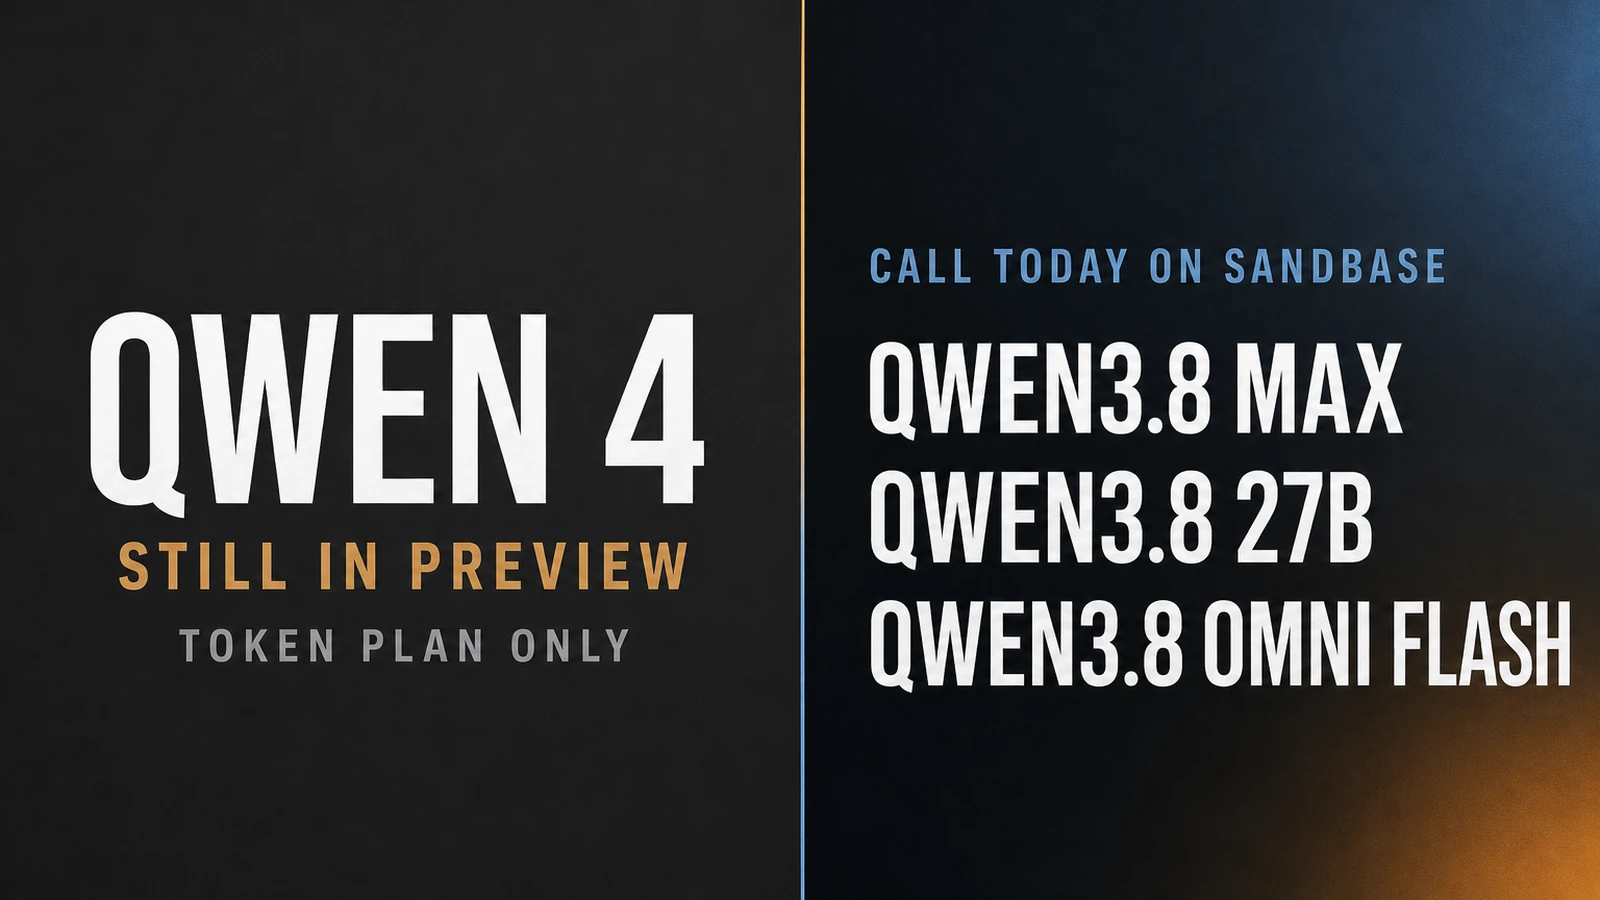
更新(2026 年 11 月 16 日): Qwen4-Max 已正式发布,支持按量,并在 SandBase 上以
alibaba/qwen4-max在线。新的旗舰工作从这里开始。这篇保留 11 月 15 日在 Qwen3.8 Max、27B 和 Omni Flash 之间的分流。正式调用见 Qwen4-Max 已正式发布。要不要离开 Qwen3.8 Max,见 Qwen4-Max 和 Qwen3.8 Max 怎么选。公开计价对照见 Qwen4-Max 和 Gemini 4 Carbon、GPT-6 Astra、Claude Fable 5.2 对比。
2026 年 11 月 15 日晚间(亚洲/上海),Qwen 4 仍是 Token Plan 预览。当晚 SandBase 上能调用的 Qwen 是 Qwen3.8 的 ID。先按任务分流,再看文末的预览旁注。当晚的长程任务、也是这个账号上当时最强的 Qwen,走 Qwen3.8 Max。不需要旗舰账单的稠密视觉模型,走 Qwen3.8 27B。音频,或者要便宜地把图像和视频收成文本,走 Qwen3.8 Omni Flash。到 11 月 16 日,旗舰调用是 alibaba/qwen4-max。
当晚的 Qwen 目录 仍是 Qwen3.8 和 Qwen3.7。当晚没有 Qwen4 卡片可发。单卡上线之后,目录标题在 11 月 16 日仍然过期。预览是什么、不是什么,看 11 月 15 日的 Qwen 4 发布了吗?。11 月 25 日前要不要把生产从 Max 挪走,看 Qwen4-Max-Preview 和 Qwen3.8 Max 怎么选。
先说结论
- 旗舰调用 Qwen3.8 Max。Hero 每百万 token $1.80 / $5.40(标价 $2 / $6 的九折),缓存读取 $0.23,缓存写入 $2.25,卡片上 1M 上下文、131.1K 最大输出。阿里官方文档把
qwen3.8-max的最大输出写成 128k。- Max 对这个任务过重时,调用 Qwen3.8 27B。$0.50 / $3,缓存读取 $0.10,缓存写入 $0.63,1M / 131.1K。卡片把它写成能理解图像和视频的稠密开源视觉语言模型。
- 文本、图像、音频、视频进,文本出,调用 Qwen3.8 Omni Flash。$0.15 / $0.47,缓存读取 $0.02,缓存写入 $0.15,1M / 131.1K。Qwen4-Max-Preview 的官方文档没有音频输入。
- Qwen4-Max-Preview 只在 Token Plan,到 2026 年 11 月 25 日 24:00(UTC+8)。官方写明之后下线。它不是这张分流表的默认项。
- 三个 SandBase ID 都走
POST https://api.sandbase.ai/v1/chat/completions。
三张卡,三件事
下面的价格是 2026 年 11 月 15 日核对的 hero,缓存包括在内。上下文和最大输出是卡片标签,格子里写了「官方」的除外。
| 调用这张 | SandBase ID | Hero 输入 / 输出,每百万 | 缓存读取 / 写入 | 上下文 / 最大输出 | 什么时候选它 |
|---|---|---|---|---|---|
| Qwen3.8 Max | alibaba/qwen3.8-max | $1.80 / $5.40(标价 $2 / $6 的九折) | $0.23 / $2.25(标价 $0.25 / $2.50) | 卡片:1M / 131.1K。官方 qwen3.8-max:1M / 128k。 | 长程任务、原生视觉、SandBase 上目前最强的 Qwen。 |
| Qwen3.8 27B | alibaba/qwen3.8-27b | $0.50 / $3 | $0.10 / $0.63 | 卡片:1M / 131.1K | 稠密开源视觉语言模型。图像和视频。Max 比任务所需更重。 |
| Qwen3.8 Omni Flash | alibaba/qwen3.8-omni-flash | $0.15 / $0.47 | $0.02 / $0.15 | 卡片:1M / 131.1K | 文本、图像、音频、视频进,文本出。要音频,或要便宜的多模态吞吐。 |
九折只在 Max 上。这次核对里,27B 和 Omni Flash 没有折扣徽章。不要把 Max 的贴纸铺到整行。
Qwen3.8 Max:任务就是旗舰的时候
这次核对里,卡片标题是 “Qwen3.8 Max API: Plan Long-Horizon Work with Native Vision”。列出的能力:chat、vision、reasoning、structured output、function calling。文案把它写成 2.4 万亿参数的 MoE,原生视觉,2026 年 8 月旗舰。这段描述来自卡片。长文是 Qwen 3.8 Max:阿里巴巴 2.4T 多模态旗舰模型全面解析。
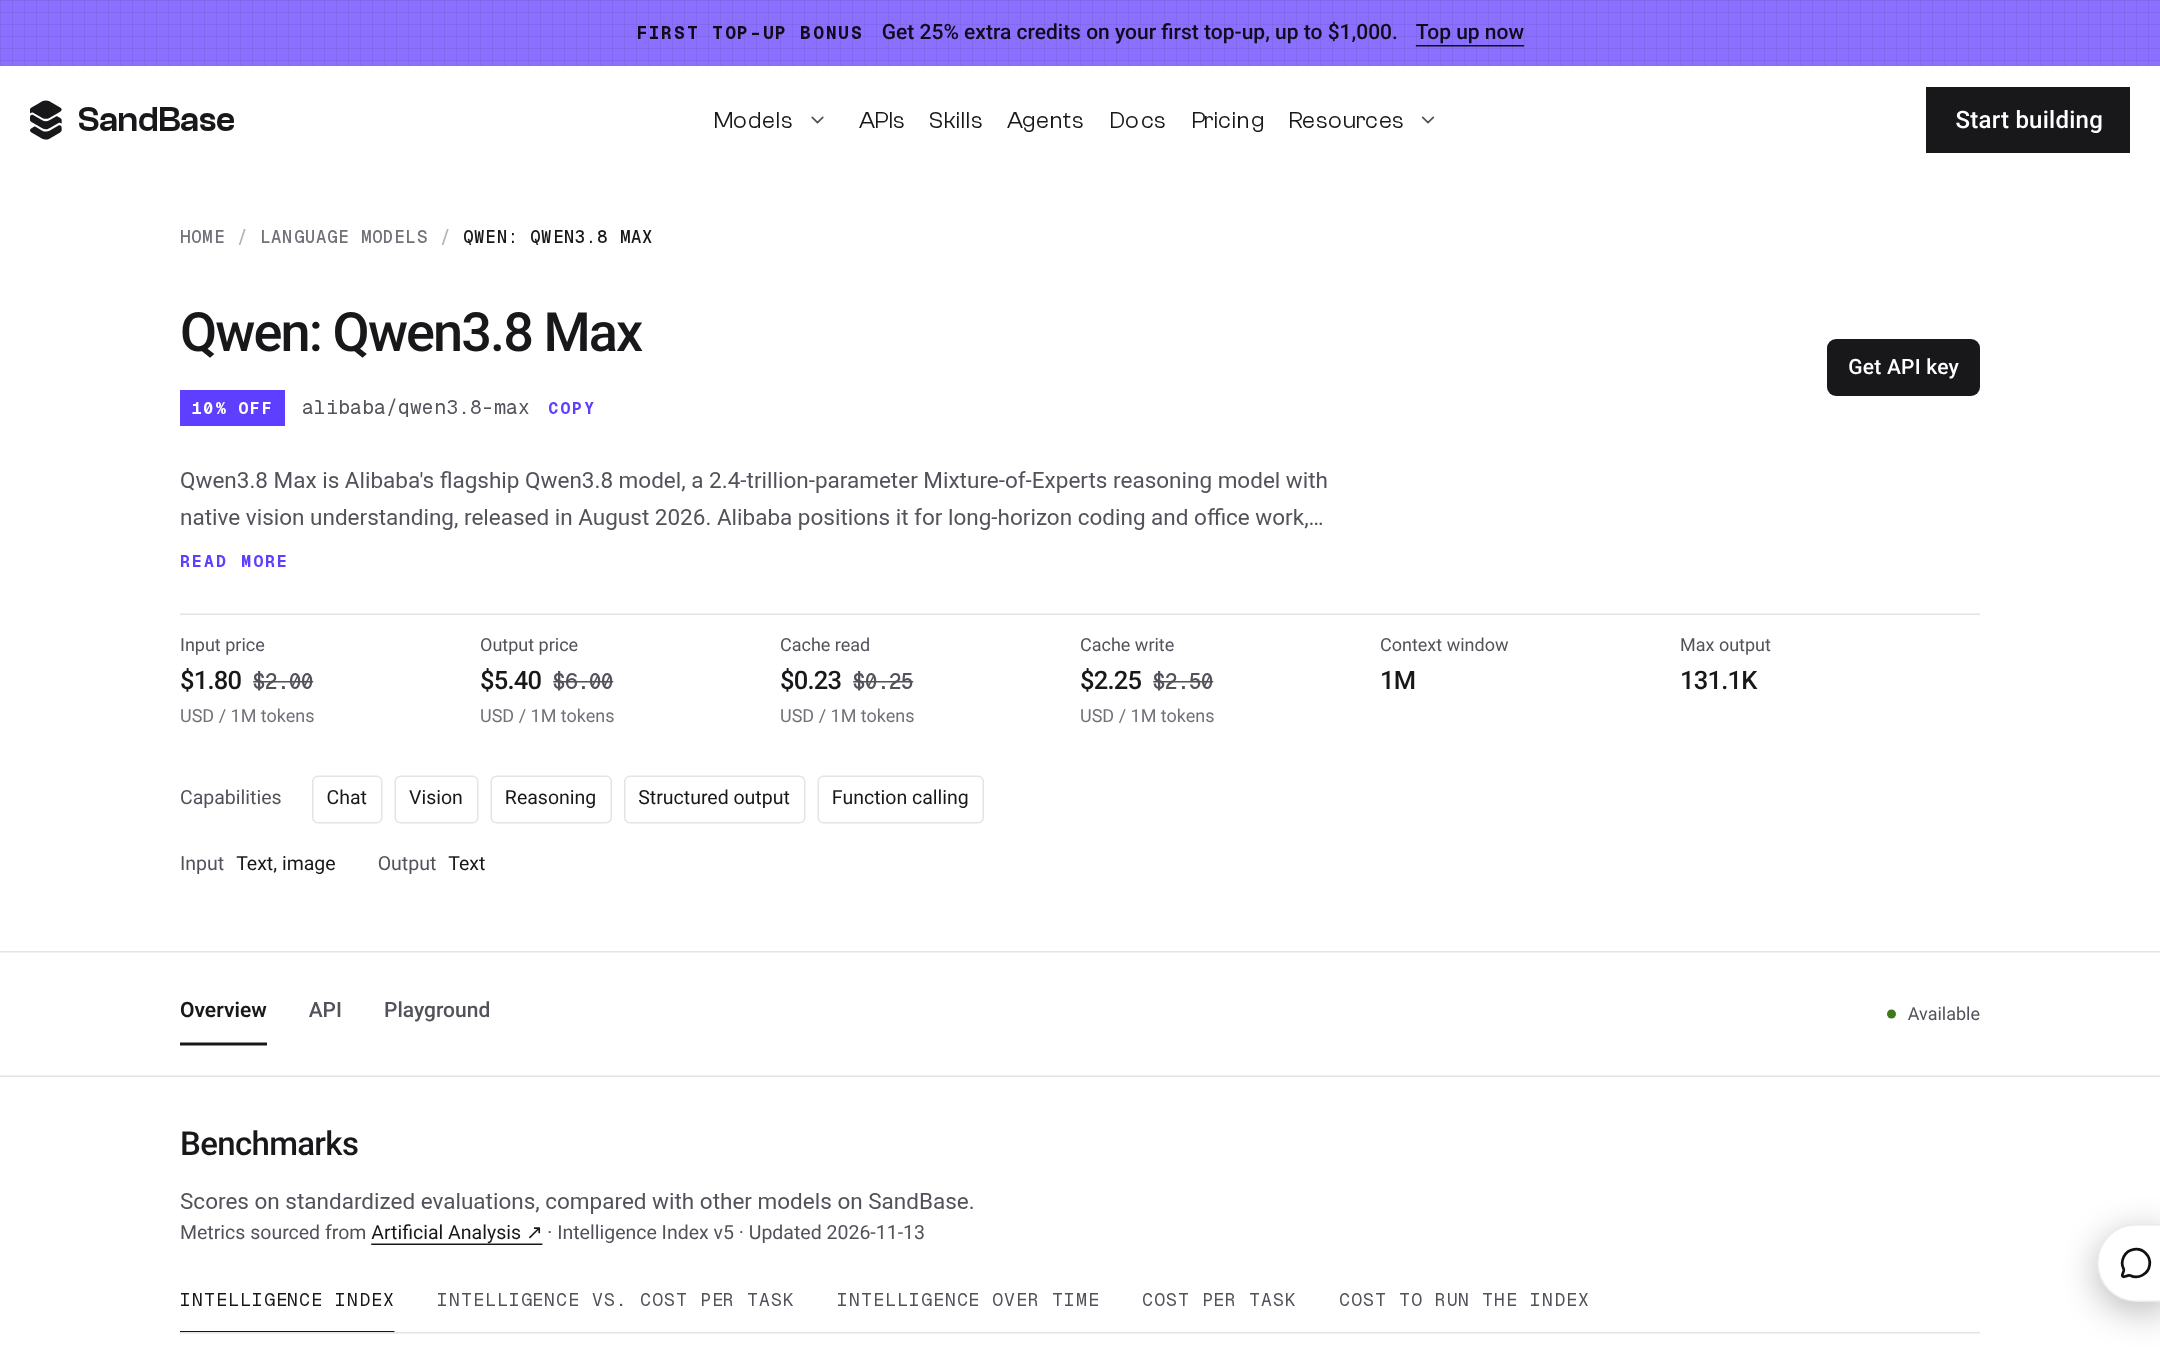
SandBase Qwen3.8 Max 卡片,路径 /models/alibaba/qwen3.8-max,2026 年 11 月 15 日(亚洲/上海)截取,HTML 与 .md 均为 HTTP 200。Hero 为 $1.80 / $5.40(标价 $2 / $6 的九折),缓存读取 $0.23,缓存写入 $2.25(每百万 token)。这是今天可以留在生产里的正式 Qwen。
阿里文本生成表仍把 qwen3.8-max 的最大输出印成 128k。SandBase hero 印 131.1K。在 SandBase 上调用,跟卡片。在阿里自己的 API 上调用,跟官方的 128k。引用上限时写明是哪一面。这张 hero 上容易被漏掉的是缓存:读取 $0.23,写入 $2.25,标价 $0.25 / $2.50。真的打中缓存的提示词,要用这组数字预算,而不是只看未缓存的 $1.80。
Qwen3.8 27B:Max 对任务过重的时候
卡片标题是 “Qwen3.8 27B API: Code and Analyze Vision on a Dense 27B”。文案写它理解图像和视频,思考默认开启。能力包含 vision,以及 chat、reasoning、structured output、function calling。它是这个账号上的小型稠密开源视觉语言模型,每百万 token 输入 $0.50、输出 $3。缓存读取 $0.10、写入 $0.63。不需要 2.4T 旗舰的视觉循环,从这里开始。
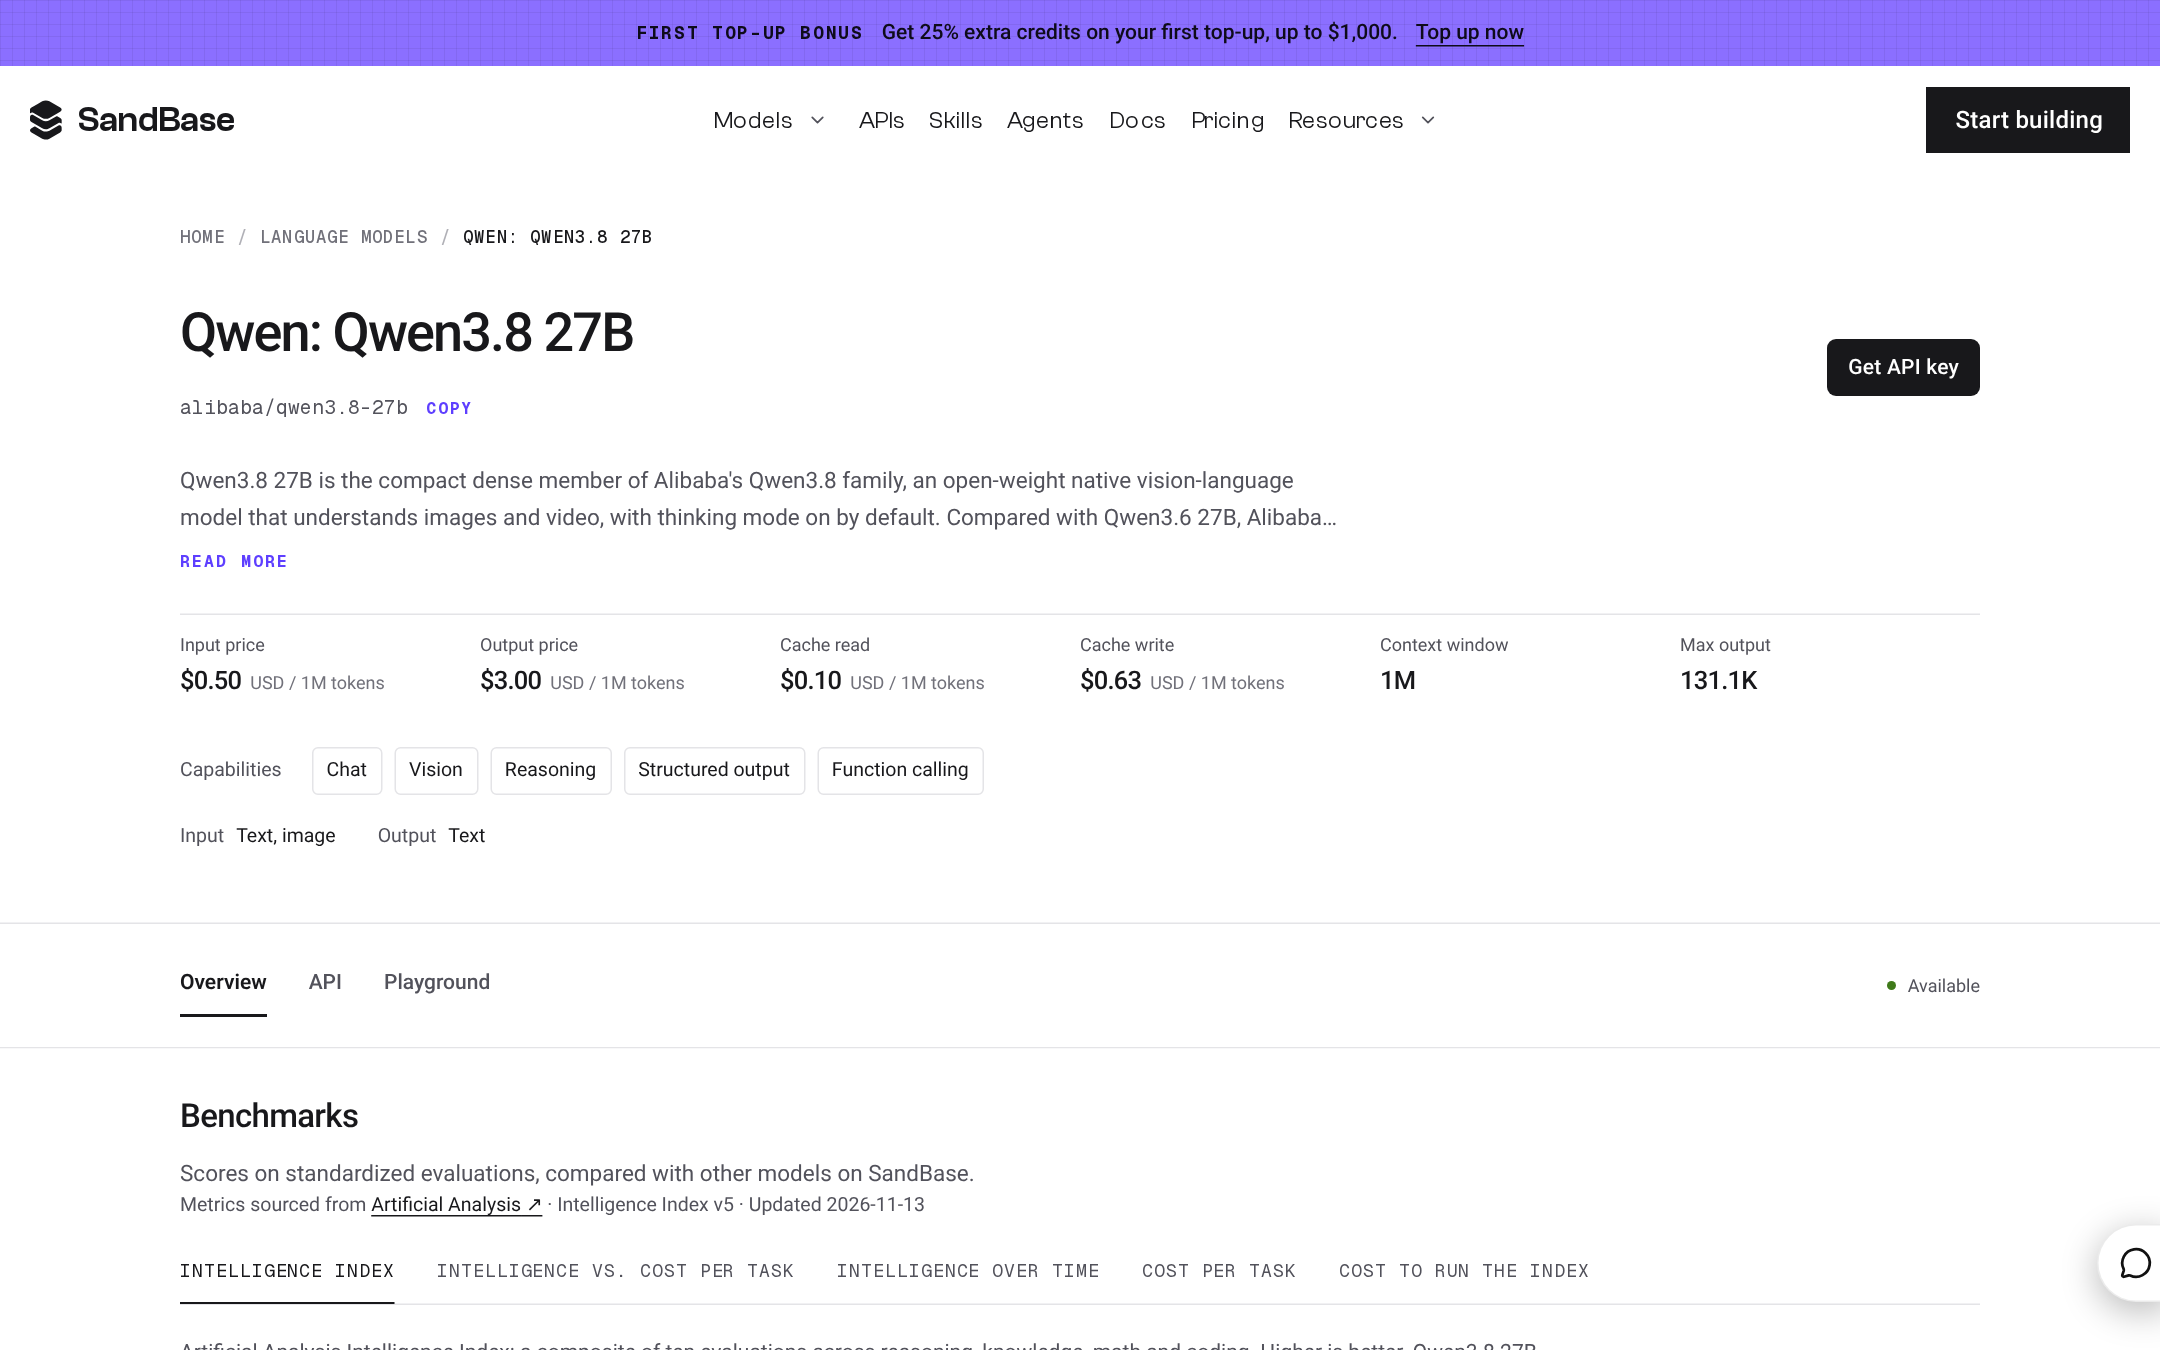
SandBase Qwen3.8 27B 卡片,路径 /models/alibaba/qwen3.8-27b,2026 年 11 月 15 日(亚洲/上海)截取。Hero 为 $0.50 / $3,缓存读取 $0.10,缓存写入 $0.63(每百万 token),上下文 1M,最大输出 131.1K。卡片把它写成能理解图像和视频的稠密开源视觉语言模型。
窗口和 Max 的卡片一样:1M 上下文,131.1K 最大输出。分开的是价格和形态,不是更短的上下文。输入是 $0.50,Max 是 $1.80;输出是 $3,Max 是 $5.40。代码、图像或视频分析放得进稠密 27B 时用 27B。任务就是 Max 卡片标题里的长程工作时,回到 Max。这篇不编造两者之间的跑分差距。官方预览文档也没有给出这个差距。
Qwen3.8 Omni Flash:输入是音频,或者量本身就是目的
卡片标题是 “Qwen3.8 Omni Flash API: Summarize Audio and Video at 1M”。Hero 每百万 token $0.15 / $0.47,缓存读取 $0.02,缓存写入 $0.15,上下文 1M,最大输出 131.1K。卡片上的输入模态:文本、图像、音频、视频。输出是文本。
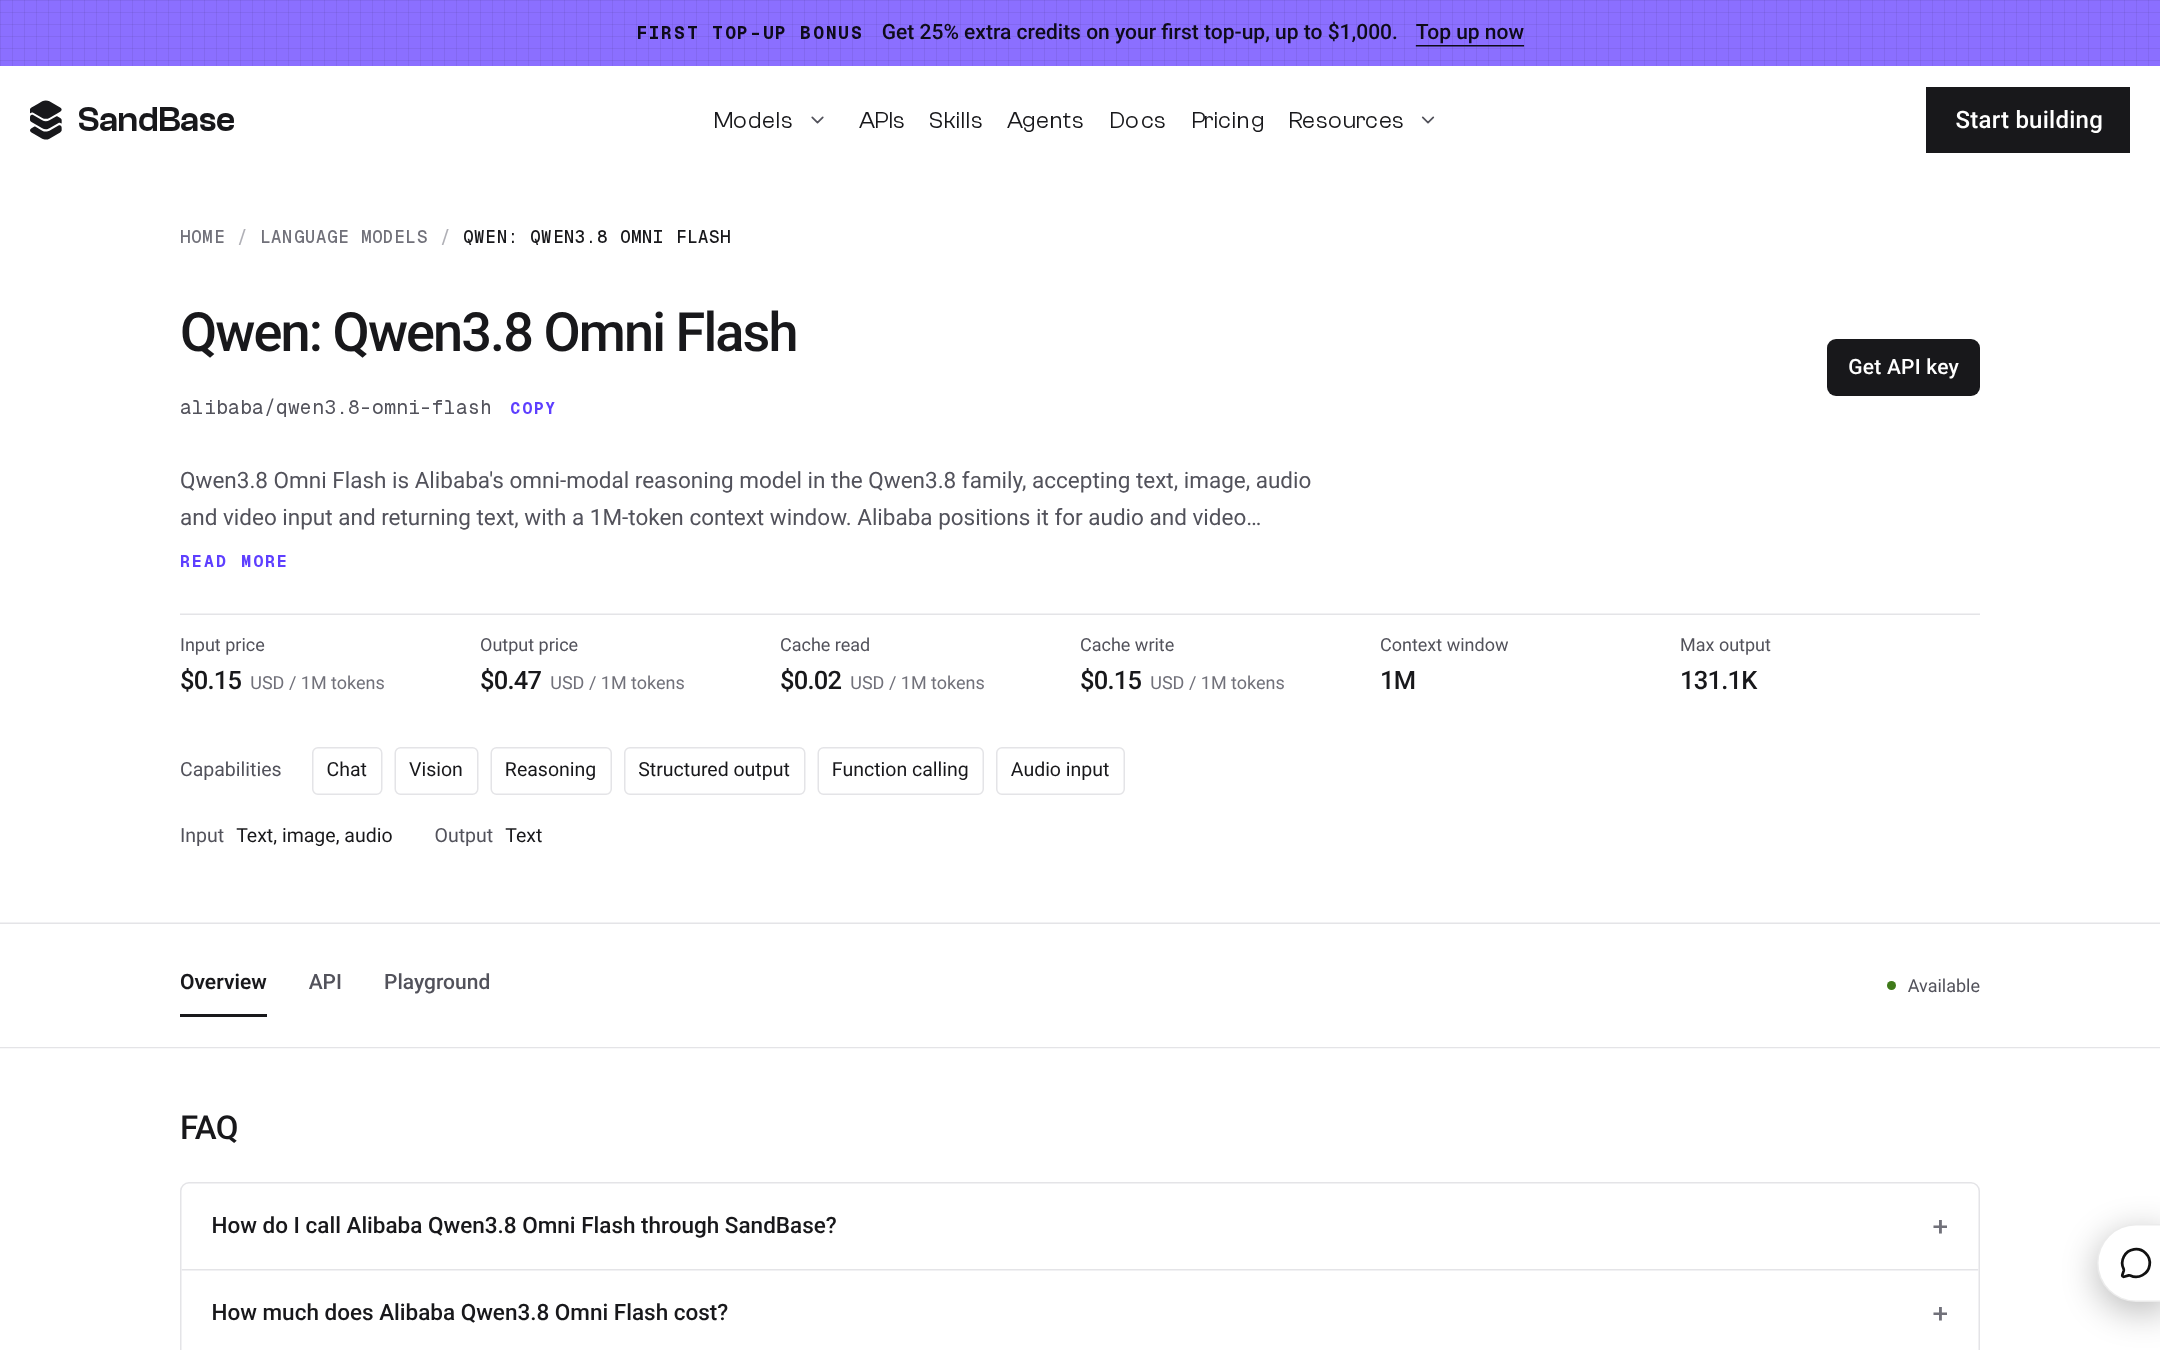
SandBase Qwen3.8 Omni Flash 卡片,路径 /models/alibaba/qwen3.8-omni-flash,2026 年 11 月 15 日(亚洲/上海)截取。Hero 为 $0.15 / $0.47,缓存读取 $0.02,缓存写入 $0.15(每百万 token),上下文 1M,最大输出 131.1K。卡片接受文本、图像、音频和视频输入,返回文本。音频这一项,Qwen4-Max-Preview 的官方文档没有写。
音频是和预览之间最干净的分界。Qwen4-Max-Preview 的官方文档写的是文本、图像和视频理解,没有音频输入。文件是录音时,SandBase 上列出音频的 Qwen 是 Omni Flash。图像和视频只要文本、又不需要 Max 的旗舰账单时,它也是便宜的那条路。这次核对里,$0.15 / $0.47 和 Qwen3.8 Flash 的输入输出贴纸相同。缓存写入不同,Flash 的上下文标签是另一个问题,下面分开写。
上面三张都不合适时,其余 Qwen3.8 卡片
这些卡在账号上。它们不是默认路由。
Qwen3.8 2.4T A95B 是每百万 token $2 / $6,缓存读取 $0.25,缓存写入 $2.50,上下文 1M,最大输出 52.4K。卡片把它写成开源的 Max 级稀疏 MoE,活跃参数大约 95B。列出的能力:chat、reasoning、structured output、function calling。这个列表里没有 vision。不要因为「Max 级」这几个字就给它发图像任务。
Qwen3.8 Flash 是 $0.15 / $0.47,缓存读取 $0.02,缓存写入 $0.20。SandBase hero 把上下文印成 N/A,最大输出 131.1K。这篇不给它编一个 SandBase 上下文。阿里官方文档另行把 qwen3.8-flash 写成 1M 上下文、128k 最大输出。官方文本生成页在优先成本时推荐 qwen3.8-flash,在优先质量时推荐 qwen4-max-preview,质量那一行标明仅 Token Plan。成本优先、又必须留在 SandBase 上的调用,仍然需要一张印得出上下文的卡。Max、27B、Omni Flash 都印了 1M。Flash 的 SandBase hero 没有。
Qwen3.8 Max Prime 是 $4 / $12,缓存读取 $0.50,缓存写入 $5.00,1M / 131.1K。卡片写的是同一 Max 模型的更快服务。它是速度档,不是更聪明的模型,hero 也明显高于 Max 的 $1.80 / $5.40。它不是主路由。
预览放在哪里,短说
11 月 15 日,Qwen4-Max-Preview(qwen4-max-preview)仅 Token Plan,从 2026 年 11 月 11 日 10:00 到 11 月 25 日 24:00(UTC+8)。官方写明该预览模型结束后下线。预览不支持按量付费,也没有公开单价。官方上下文 1,000,000。当晚预览的官方最大输出是 393,216,思考和回答共用,高于 qwen3.8-max 的官方 128k。这个预览上限没有把预览变成生产默认,它也不是 11 月 16 日的正式上限。11 月 15 日 SandBase 没有 Qwen4 卡片。到 11 月 16 日,卡片是 alibaba/qwen4-max。预览的端点配置留在 11 月 13 日的接入说明。
如果你真正要的对比是 Gemini 4 Carbon、GPT-6 Astra 和 Claude Fable 5.2,那一页是 今天真正能比的是什么。比的是入口和上限,不给非官方分数排名。
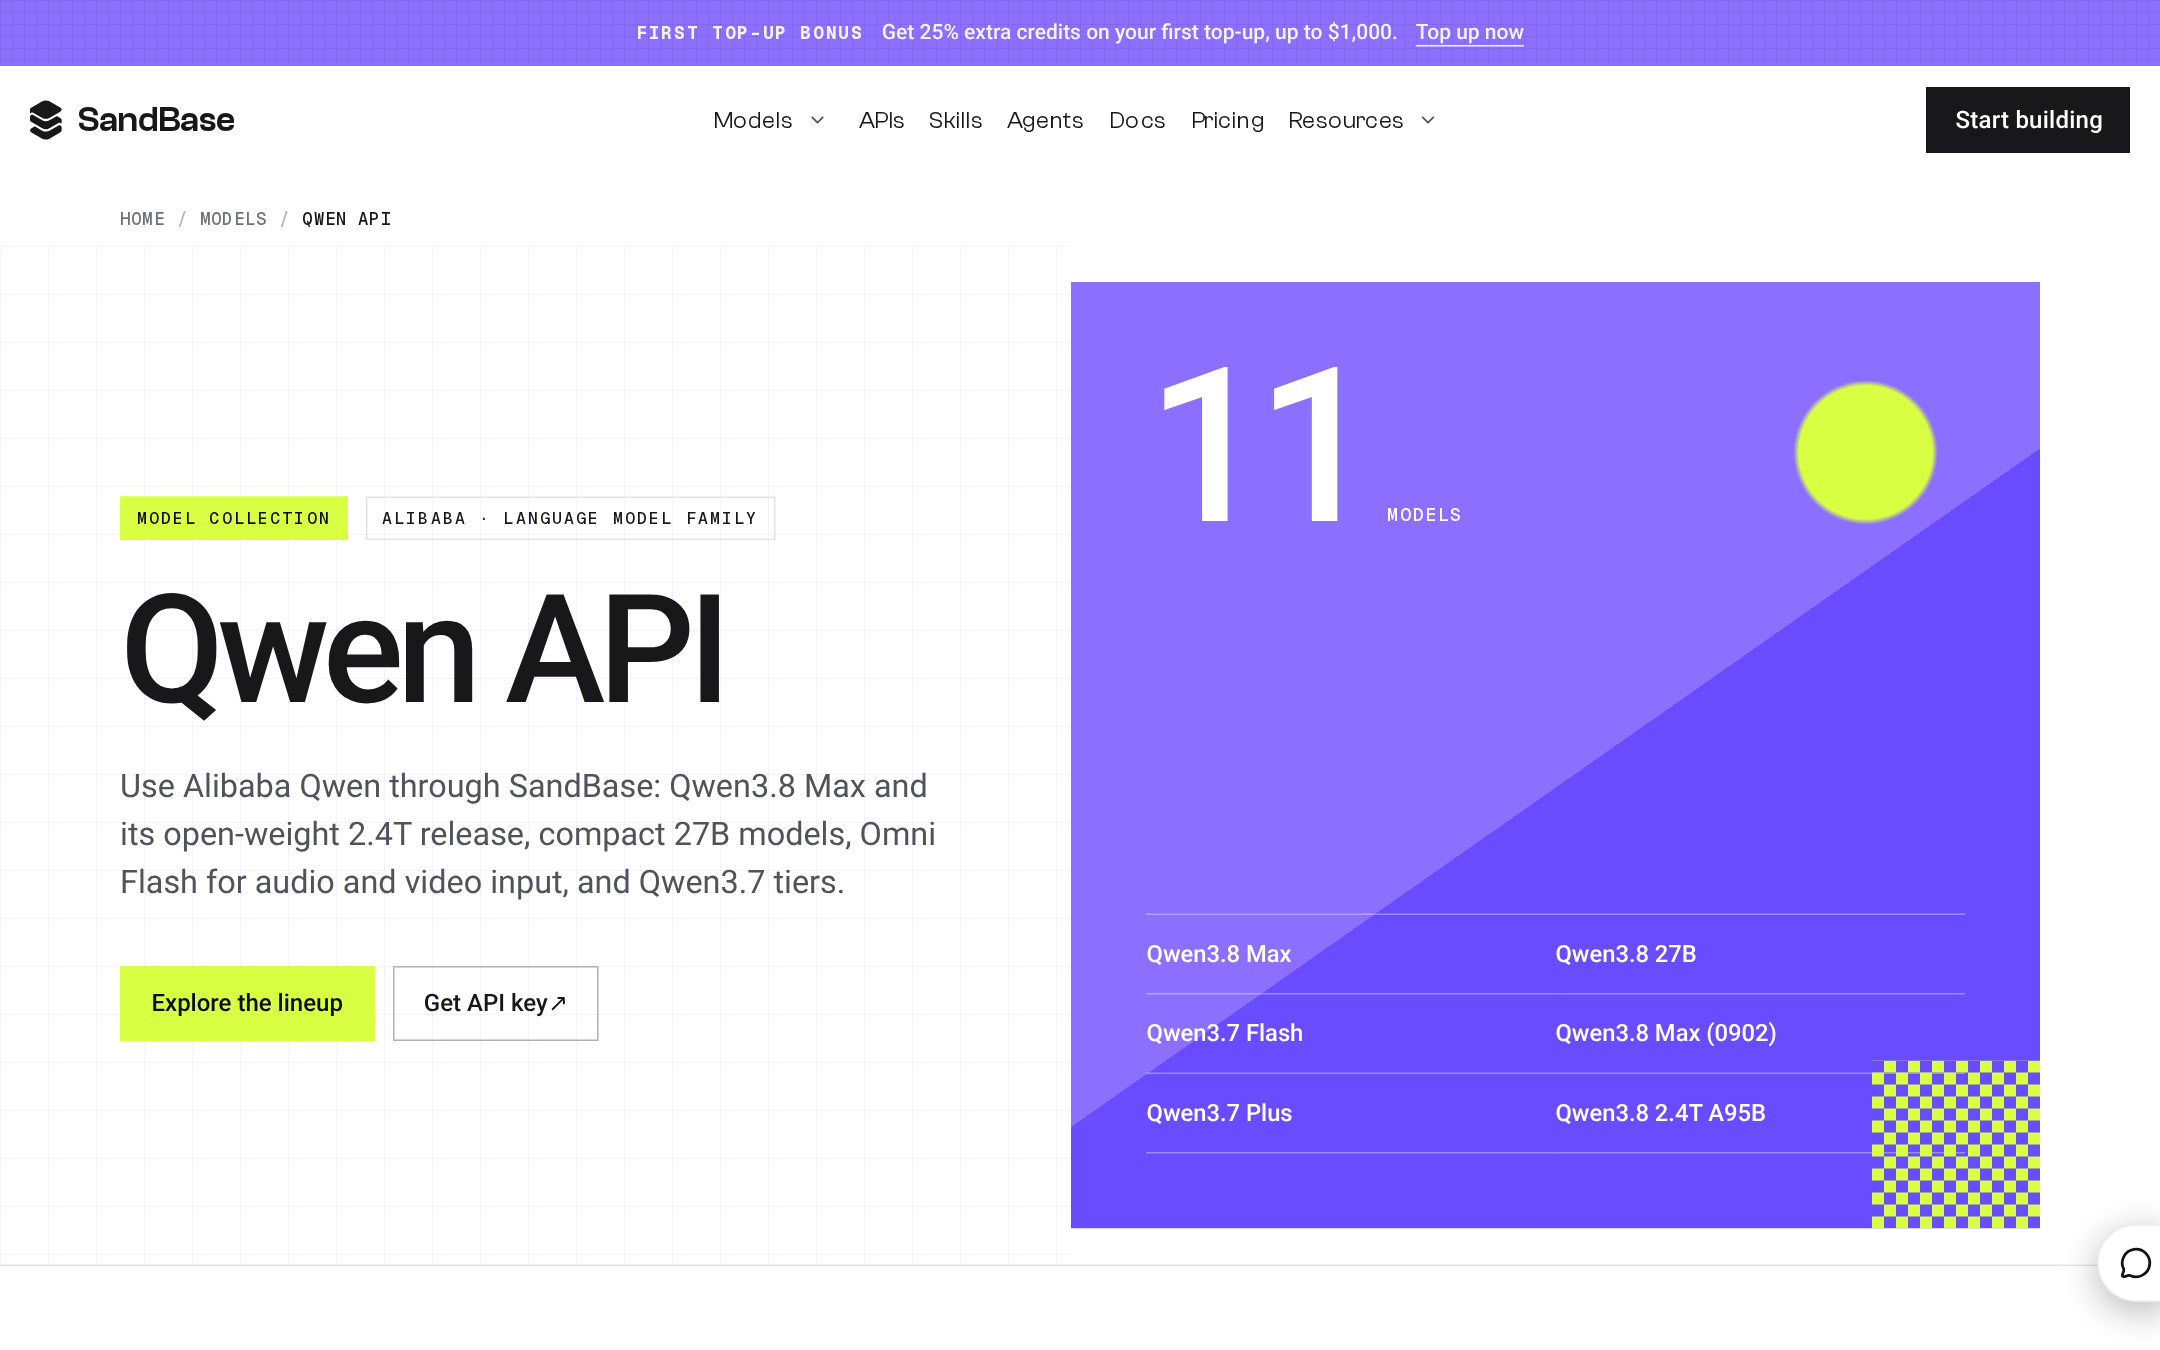
SandBase Qwen 目录,路径 /models/qwen,2026 年 11 月 15 日(亚洲/上海)截取。页面仍是 Qwen3.8 和 Qwen3.7 的阵容,不是 Qwen 4 目录。
这张目录截图是 11 月 15 日的核对。到 11 月 16 日,Qwen4-Max 单卡已经存在,所以这篇分流对旗舰调用已经过期。目录标题仍可以不提 Qwen4。把上面三个 ID 当成唯一调用之前,先读 alibaba/qwen4-max 的 hero。
打开哪一页
长程、又要旗舰上的视觉,打开 Qwen3.8 Max,$1.80 / $5.40(标价 $2 / $6 的九折),缓存 $0.23 / $2.25。稠密 27B 加上图像和视频就够时,打开 Qwen3.8 27B,$0.50 / $3,缓存 $0.10 / $0.63。输入里有音频,或者要便宜的多模态文本输出,打开 Qwen3.8 Omni Flash,$0.15 / $0.47,缓存 $0.02 / $0.15。
注册,然后看 第一次调用。这三张卡的端点是 POST https://api.sandbase.ai/v1/chat/completions。模型字符串是 alibaba/qwen3.8-max、alibaba/qwen3.8-27b 或 alibaba/qwen3.8-omni-flash。
要看产品线而不是今天的路由器:Qwen 3.7 Max 和 Qwen 3.6 做 Agent。
常见问题
新的 SandBase 调用该用哪个 Qwen ID?
到 2026 年 11 月 16 日,旗舰工作从 alibaba/qwen4-max 开始。11 月 15 日的分流仍然成立:上一张旗舰用 alibaba/qwen3.8-max,更便宜的稠密视觉模型用 alibaba/qwen3.8-27b,输入含音频或要压多模态用量时用 alibaba/qwen3.8-omni-flash。15 日那次核对本身没有 Qwen4 ID。
什么时候 27B 就够?
任务放得进能理解图像和视频的稠密 27B,而且不需要 Max 的旗舰账单。卡片是 $0.50 / $3,缓存 $0.10 / $0.63,上下文和最大输出的标签与 Max 相同,都是 1M / 131.1K。这篇不声称质量打平。它声称的是价格和模态合不合适。
什么时候 Omni Flash 更合适?
需要音频输入,或者图像和视频可以以 $0.15 / $0.47 返回文本,缓存读取 $0.02、写入 $0.15。Qwen4-Max-Preview 的官方文档没有列出音频输入,找这个模态不要去预览里找。
2.4T A95B 的卡片包含视觉吗?
2026 年 11 月 15 日的能力列表里没有 vision。列出的是 chat、reasoning、structured output、function calling,价格 $2 / $6,最大输出 52.4K。视觉任务用 Max、27B 或 Omni Flash。
Qwen4-Max-Preview 放在哪?
如果你已经有 Token Plan,它可以作为 2026 年 11 月 25 日 24:00(UTC+8)之前的评测。官方写明之后这个预览模型会下线。这篇不会让你把它放进生产。请求体见 接入说明。
来源
SandBase hero 和 Qwen 目录,核对于 2026 年 11 月 15 日(亚洲/上海):Qwen3.8 Max、Qwen3.8 27B、Qwen3.8 Omni Flash、Qwen3.8 2.4T A95B、Qwen3.8 Flash、Qwen3.8 Max Prime,以及 Qwen 目录。官方 qwen3.8-max 和 qwen3.8-flash 的上下文与输出,以及质量对成本的推荐,来自阿里的 文本生成表。预览窗口和 393,216 的输出上限来自 QwenCloud 最新模型页。
卡片价格核对于 2026 年 11 月 15 日(亚洲/上海)。128k 标签和预览窗口以官方文档为准。分流表里的每个美元数字以 SandBase hero 为准。
觉得有用?分享给更多人