Qwen4-Max 和 Qwen3.8 Max 实测:SandBase 上的首 token(TTFT)、TPOT、吞吐与缓存命中率
在 SandBase 上对 Qwen4-Max 和 Qwen3.8 Max 做的单日流式探测:首 token 时间、TPOT、解码吞吐和提示缓存命中率。不是官方厂商延迟。
2026 年 11 月 16 日 14:44:02 到 14:52:06(亚洲/上海),一台机器经 SandBase 网关,向 alibaba/qwen4-max 和 alibaba/qwen3.8-max 发了流式 Chat Completions。Qwen3.8 Max 往往更早吐出第一个思考 token,但想得更久,所以第一个回答 token 大约比 Qwen4-Max 晚 2.2 秒。固定长度的解码里,Qwen4-Max 明显更快。
这是单机、单日、经 SandBase 网关的探测。不是官方厂商延迟,也不是已发表的基准。
你在意的是可见回答什么时候开始、以及那之后 token 来得多快,这次主解码负载上 Qwen4-Max 更好。你在意的是第一个思考 token,Qwen3.8 Max 往往更早。关掉 thinking 并没有让 Qwen4-Max 的首 token 时间在这组样本里更好。Qwen4-Max 的前缀缓存命中率很高,命中并没有稳定地缩短首 token 时间。
新 ID 怎么调、官方上限和卡片价差多少,看 Qwen4-Max 已正式发布。生产流量该不该切,以及另一组 9 项实用探测(对错、墙钟、token 数,不是这套延迟),看 Qwen4-Max 和 Qwen3.8 Max 怎么选。
先说结论
- 探测在 2026 年 11 月 16 日(亚洲/上海),走
POST https://api.sandbase.ai/v1/chat/completions,流式打开。这是一台机器、一天的网关数据,不是官方延迟。- 主解码负载、默认 thinking、并发 1、n=7:Qwen3.8 Max 到首个回答 token 的中位数是 4670 ms,Qwen4-Max 是 2424 ms,大约晚 2.2 秒。解码吞吐中位数是 93.1 对 54.1 token/s。
- Qwen4-Max 另开一轮
enable_thinking=false。首 token 时间因此等于到首个回答 token 的时间,中位数并没有比默认 thinking 更好(2372 对 1915 ms)。n=7,这个差距不是稳定结论。- 第二次调用的提示缓存命中率:Qwen4-Max 96.2%,Qwen3.8 Max 69.1%,Qwen4-Max 关 thinking 94.8%。命中没有稳定地降低 TTFT。
- 一次发 4 个请求只是很轻的附加探测,不是容量测试,也不是 SLA。
新的生产 ID 就是这一条时,打开 Qwen4 Max。显示名是 “Qwen: Qwen4 Max”,SandBase ID 是 alibaba/qwen4-max,卡片路由只有 Chat Completions。2026 年 11 月 16 日的 hero 是每百万 token 输入 $1.67、输出 $5.00,缓存读取 $0.08,缓存写入 $2.08,上下文 1M,最大输出 131.1K,没有九折。Schema 输入价是 1.666667,也就是 hero 上的 $1.67。新加坡(国际)官方按量是 $1.50 / $4.50。北京与 Global 官方标价是 $1.413 / $4.24。官方最大输出:非思考 131,072,思考加最终回答合计 262,144。Hero 的 131.1K 对的是非思考上限。
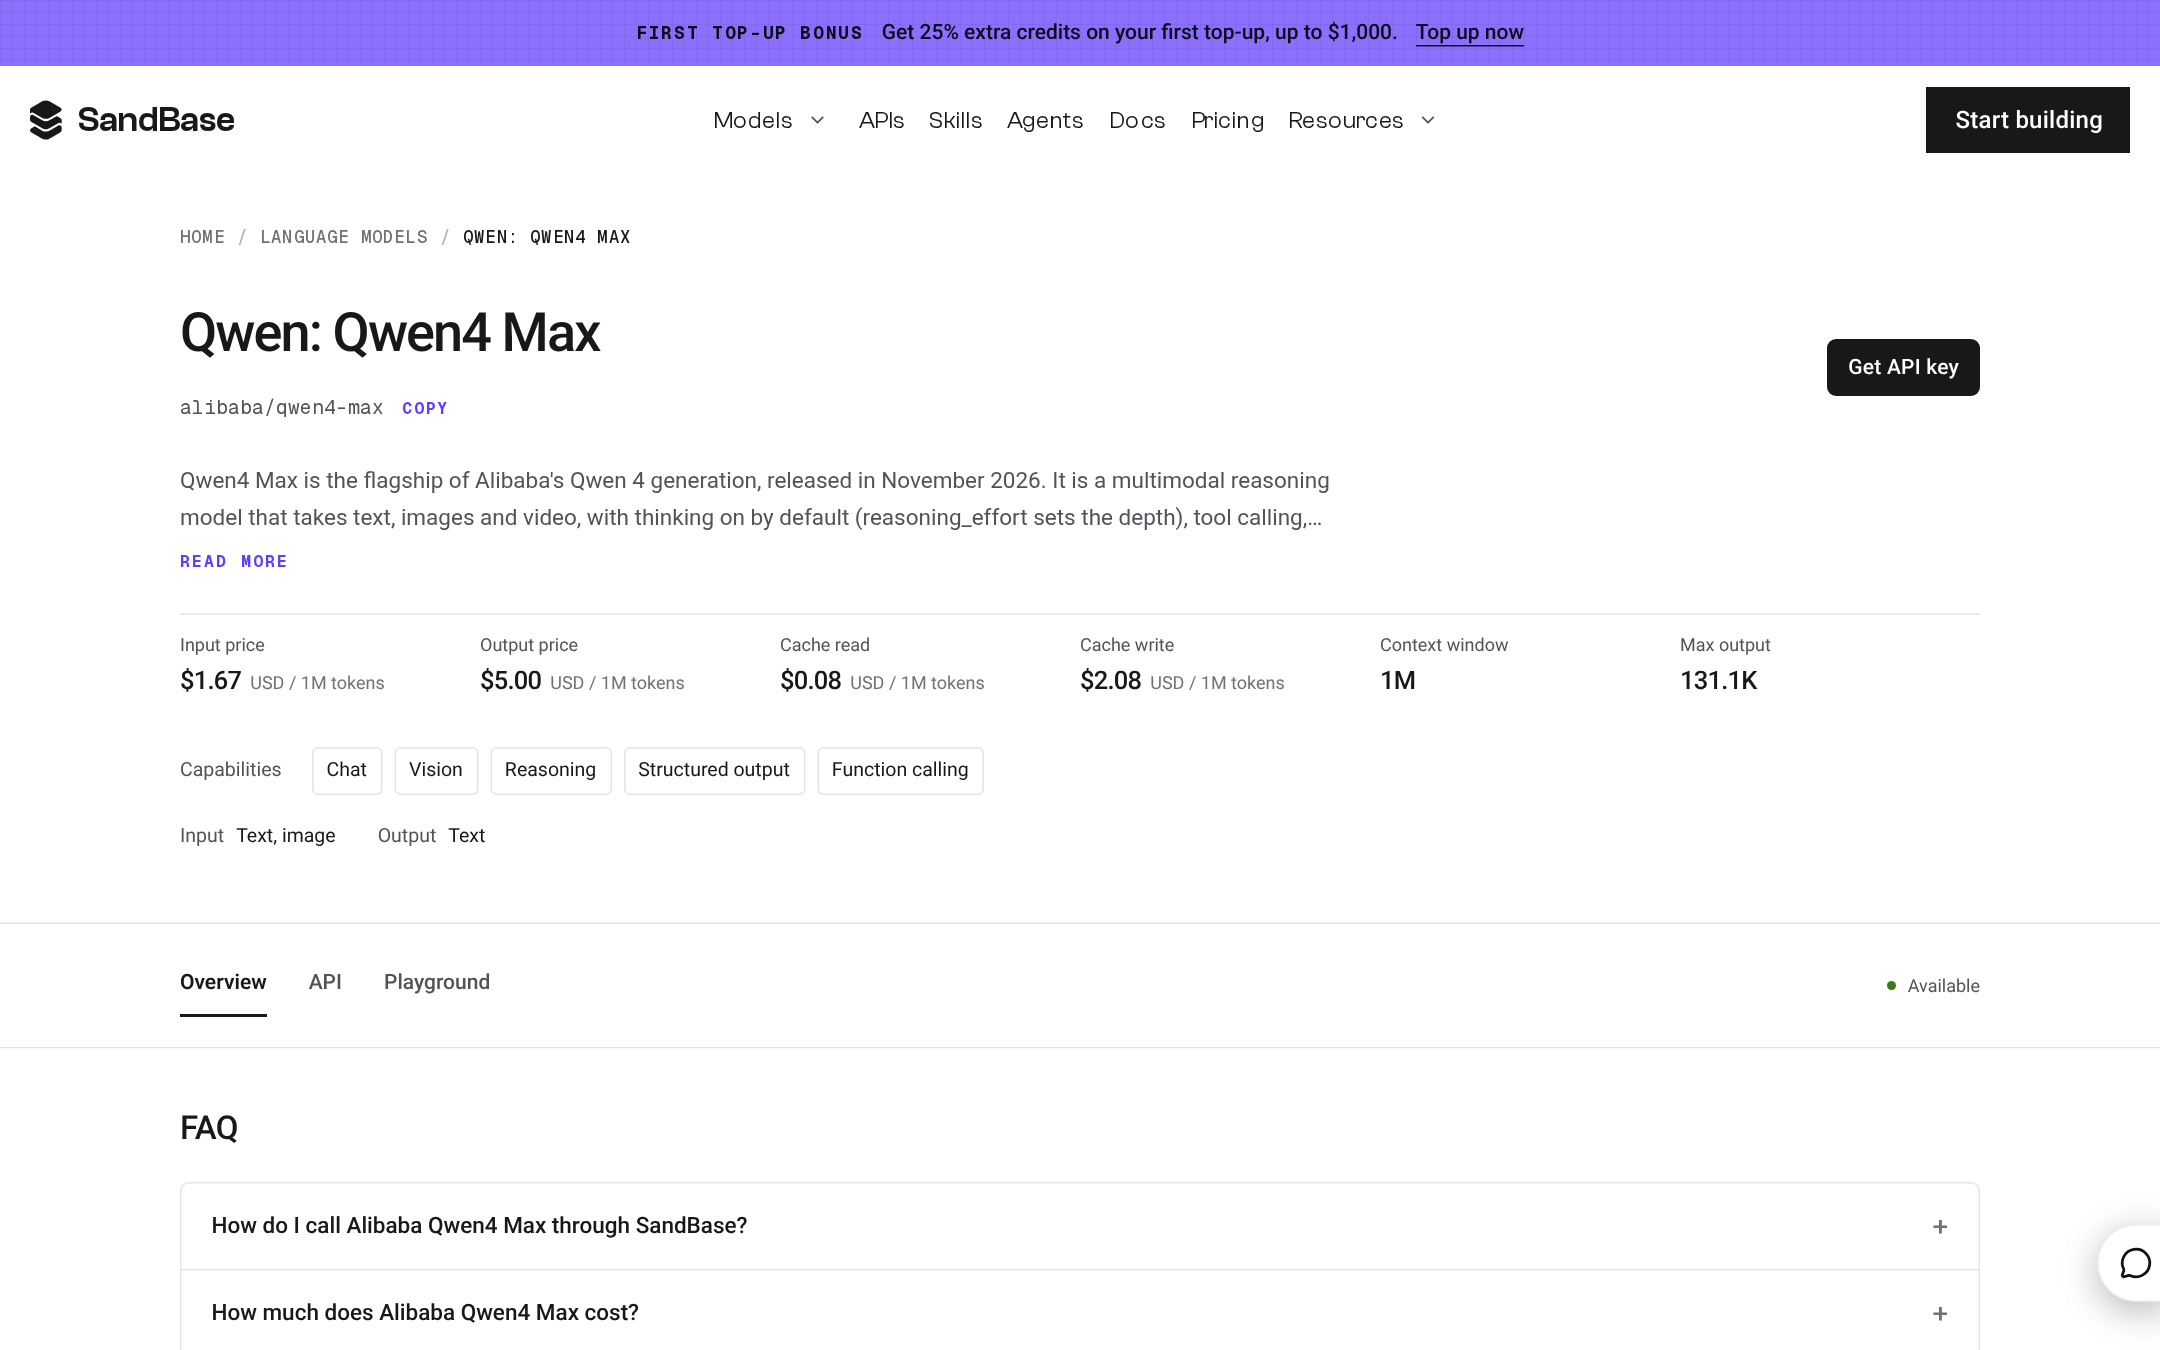
Live SandBase Qwen4 Max card at /models/alibaba/qwen4-max, captured 16 Nov 2026, Asia/Shanghai (HTML and .md both HTTP 200). Hero is $1.67 / $5.00, with cache read $0.08 and cache write $2.08 per 1M tokens, 1M context, and 131.1K max output. There is no 10% off badge. These SandBase prices are above the official Singapore list of $1.50 / $4.50, and above official Beijing / Global $1.413 / $4.24, but still below SandBase Qwen3.8 Max at $1.80 / $5.40. The card hero max output of 131.1K matches the official non-thinking cap.
已确认,以及不要当成已知
下面的数字是这次探测的中位数和 p95。不是厂商的速度声明,也不是对没调用过的模型的排名。
| 这次探测里已确认 | 不要当成已知 |
|---|---|
2026 年 11 月 16 日 14:44:02–14:52:06(亚洲/上海)。窗口里含 14:44:02–14:44:10 的参数检查。套件本身是 14:44:42–14:52:06。端点 POST https://api.sandbase.ai/v1/chat/completions,stream=true,temperature=0,stream_options.include_usage=true。 | 厂商侧原始延迟、另一家网关、另一个地域、另一天。 |
模型:alibaba/qwen4-max(默认 thinking,另有一轮 enable_thinking=false)和 alibaba/qwen3.8-max(只测默认 thinking)。95 条记录全部 HTTP 200,finish_reason=stop。Warmup 在原始日志里,不进汇总。 | Gemini 4 Carbon、GPT-6 Astra、Claude Fable 5.2,或任何没出现在调用列表里的模型的延迟。 |
| 表里的中位数。工作负载 A 是主解码对比。工作负载 B 是缓存对比。并发 4 是很轻的附加项。 | “缓存命中就会降低 TTFT” 的生产承诺。这组样本里,命中并没有稳定地做到。 |
enable_thinking=false 被接受,而且生效:HTTP 200,reasoning_tokens=0,流里没有 reasoning_content。 | “关掉 thinking 的 TTFT 稳定更差” 这条定律。差距来自 n=7,关掉之后的散布更宽。 |
思考文本在 delta.reasoning_content。实际返回的缓存字段是 usage.prompt_tokens_details.cached_tokens 和 usage.prompt_tokens_details.cache_write_tokens。每一次调用的 cache_write_tokens 都是 0,包括 miss。 | 容量、负载下的排队,或任何 SLA。四个并发请求测的不是这个。 |
两个模型都已正式可用,SandBase 卡片都在线。卡片价和官方标价是说明文字里 11 月 16 日的数字。预览 alibaba/qwen4-max-preview 仍在线,仍定为 2026 年 11 月 25 日 24:00(UTC+8)之后下线。 | 给 Qwen4-Max 编一个 SandBase 九折,或编一个 SandBase 免费 token。新加坡按量的 100 万免费 token 是 QwenCloud 的条款。SandBase 卡片没有写。 |
主结果:短提示,固定长度解码
先把四个名字分开。它们不能互相替换。
- TTFT(首 token 时间) 是从发出请求到第一个带文本的流式 token,文本在
delta.content或delta.reasoning_content里。空的 role、keepalive、空字符串不算。TTFT 含排队和 prefill。Thinking 开着时,这往往是思考 token,不是回答。 - 到首个回答 token 是从发出请求到第一个非空
delta.content。Thinking 开着时,这是更有用的产品数字。 - TPOT 是
(t_last_token - t_first_token) / (usage.completion_tokens - 1),单位毫秒。API 把思考 token 算进输出时,completion_tokens含思考。完成 token 少于 2、时间戳缺失、或整段回复打在同一个 chunk 里,这一次的 TPOT 无效。 - 解码吞吐 用同一段时间和同一条有效性规则:
(completion_tokens - 1) / (t_last_token - t_first_token),单位 token/s。端到端吞吐 是completion_tokens / (t_last_event - t_send),所以它把等到第一个 token 的时间也算进去。两个数不要混。
工作负载 A 是短提示加固定 32 行完成:交替的固定句子,不加编号,不加解说,max_tokens=512,并发 1。每个模型设置丢弃 1 次 warmup。表里是 7 次。输出大约 350–530 个 token,流式间隔量得出来。单元格没另行说明时,一对数字是 中位数(p95)。TTFT 和 TPOT 的 p95 是更慢的那一端。吞吐行的 p95 是更高的速率,不是更差的情况。
| 指标 | Qwen4-Max 默认 | Qwen3.8 Max 默认 | Qwen4-Max 关 thinking |
|---|---|---|---|
| TTFT(ms) | 1915(2871) | 1474(2330) | 2372(4350) |
| 到首个回答 token(ms) | 2424(3699) | 4670(5356) | 2372(4350)(= TTFT) |
| TPOT(ms/token) | 10.75(17.05) | 18.48(21.33) | 10.31(12.30) |
| 解码吞吐(token/s) | 93.1(104.6) | 54.1(61.1) | 97.0(100.7) |
| 端到端吞吐(token/s) | 58.3(71.2) | 44.8(50.8) | 56.1(71.1) |
| 中位 prompt / completion / reasoning token | 134 / 369 / 16 | 160 / 483 / 129 | 135 / 352 / 0 |
只针对这次探测的读法:
- Qwen3.8 Max 的第一个思考 token 往往更早。TTFT 中位数 1474 ms,对 Qwen4-Max 的 1915 ms。默认 thinking 也更长:中位 129 个 reasoning token,对 16 个。第一个回答 token 大约晚 2.2 秒(4670 ms 对 2424 ms)。
- 这个负载上 Qwen4-Max 解码更快。TPOT 中位数 10.75 ms 对 18.48 ms。解码吞吐 93.1 对 54.1 token/s。端到端吞吐这里仍是 Qwen4-Max 更高(58.3 对 44.8 token/s)。它是另一个统计量,因为把等到第一个 token 的时间算进去了。
- 工作负载 A 上,从第一个思考 token 到第一个回答 token 的间隔,Qwen4-Max 中位 477 ms,Qwen3.8 Max 中位 2995 ms,关 thinking 为 0。引用的是这组间隔中位数。不要用表头的 TTFT 中位数去减表头的首个回答中位数,那不是同一个统计量。
关掉 thinking
第三列是 Qwen4-Max 单独的一轮,参数是官方的 enable_thinking=false。API 接受了。每一次都是 HTTP 200,reasoning_tokens 为 0,流里没有 reasoning_content。这一列里 TTFT 和到首个回答 token 的时间是同一个数。没有思考文本可先吐出来时,本来就该这样。
TTFT 中位数并没有比默认 thinking 更好:2372 ms 对 1915 ms,p95 也更宽(4350 ms 对 2871 ms)。解码吞吐略高(97.0 对 93.1 token/s)。TPOT 中位数 10.31 ms 对 10.75 ms。样本是 n=7。不要把这个 TTFT 差距当成稳定结论,也不要为了买一个更早的首 token 去关 thinking。这组样本没有显示出那种效果。
Qwen4-Max 官方默认的 reasoning_effort 是 high,不是预览期的 xhigh。除了关 thinking 的那一轮,这次探测没有改这个默认值。
怎么测的
一台机器,一个下午,经 SandBase 网关。时钟是亚洲/上海。参数检查 14:44:02–14:44:10。套件 14:44:42–14:52:06。整次运行记下来的窗口是 14:44:02–14:52:06。客户端在 POST 之前立刻取 time.perf_counter()。
请求是 POST https://api.sandbase.ai/v1/chat/completions,stream=true,temperature=0(已接受),stream_options.include_usage=true。最后一块 SSE 带了 usage。块是 OpenAI 风格的 chat.completion.chunk。思考文本在 choices[0].delta.reasoning_content。回答文本在 choices[0].delta.content。开头可以是空的 role 块,TTFT 忽略它们。短回复、解码、缓存这三类里,72 次非 warmup 试次中有 69 次,HTTP 响应头和第一个 SSE token 几乎同时到(间隔小于 5 ms)。TTFT 仍然包含排队和 prefill。这个“几乎同时”是方法注记,不是标题数字。
模型是 alibaba/qwen4-max 和 alibaba/qwen3.8-max。没标明关 thinking 的轮次,thinking 留在 API 默认。日志 95 条,含参数检查、warmup,以及两条并发批次汇总。每一个请求都是 HTTP 200,finish_reason=stop。Warmup 不进汇总中位数。
上面的工作负载 A 才是 TPOT 和解码吞吐该用的对比。下面的工作负载 B 是缓存:每对一份独立备忘录,大约 2.9k–3.0k token,每个模型设置 5 对 miss/hit,max_tokens=256。工作负载 C 用和 A 相同的提示,先串行 warmup,再同时发 4 个请求,只测默认 thinking。另外还跑过一个短回复(只回答 OK,max_tokens=128)。它的 TTFT 方差放在后面。不用它算 TPOT,也不用它算吞吐。
提示缓存命中率
每一对缓存用的是同一份法律备忘录,只改最后一行(Record tag: Bn-1,然后 Bn-2),再加一个关于通知期条款的一字是/否问题。每一对用自己的前缀,后面的 “miss” 不会被前面的对预热。丢弃一对 warmup。max_tokens=256。每一个回答都是 Yes。命中率是 cached_tokens / prompt_tokens,取网关实际返回的 usage 字段。Miss 是一对里的第一次。Hit 是紧接着的第二次。
| 模型 | 第 1 次(miss)中位命中率 | 第 2 次(hit)中位命中率 | 第 2 次中位 cached / prompt | miss 中位 TTFT(ms) | hit 中位 TTFT(ms) |
|---|---|---|---|---|---|
| Qwen4-Max 默认 | 0%(cached=0) | 96.2% | 2816 / 2926 | 4448 | 3795 |
| Qwen3.8 Max 默认 | 0% | 69.1% | 2048 / 2965 | 2495 | 2616 |
| Qwen4-Max 关 thinking | 0% | 94.8% | 2816 / 2971 | 3160 | 4502 |
前缀缓存在 usage 对象报告的计费意义上是有效的。每一对的第一次 cached_tokens 为 0。紧接着的第二次读到了缓存。
不要把这张表读成 “命中让首 token 更快”。默认 thinking 的 Qwen4-Max,hit 的 TTFT 中位数略低(3795 ms 对 4448 ms)。Qwen3.8 Max 和关掉 thinking 的 Qwen4-Max,hit 的 TTFT 中位数反而更高(2616 对 2495,4502 对 3160)。n=5,散布很大。账单上的命中和网关延迟是两件事。这组样本不能支持 “缓存命中会降低 TTFT”。
每一次试次的 cache_write_tokens 都是 0,包括 miss。Qwen3.8 Max 的第二次刚好缓存 2048 个 token。Qwen4-Max 缓存 2816。这是观察到的长度。探测没有确定它们为什么不同。
短回答不该拿来当吞吐标题。这个负载上有一次 Qwen4-Max 默认 thinking 的 miss,token 打成一次无法当作解码速率的突发,工作负载 B 未清洗的平均解码吞吐因此不是结果。去掉那一次之后,清洗后的解码中位数是 41.4 token/s,清洗后的 TPOT 中位数是 24.2 ms(n=9)。主吞吐对比仍然是工作负载 A。
很轻的并发 4 探测
提示和工作负载 A 相同,max_tokens=512,只测默认 thinking。先串行 warmup,再同时发 4 个请求。设计就这些。
| 指标 | Qwen4-Max | Qwen3.8 Max |
|---|---|---|
| 并发 4 的 TTFT 中位数(p95),ms | 4377(5186) | 1693(2103) |
| 对比工作负载 A、并发 1 的 TTFT 中位数 | 1915(约 2.3×) | 1474(约 1.15×) |
| 单请求解码吞吐中位数(token/s) | 91.3 | 58.6 |
| 批次墙钟(s) | 9.857 | 10.993 |
| 批次合计输出(全部 completion token / 墙钟) | 152.2 token/s(1500 tok) | 170.7 token/s(1876 tok) |
Qwen4-Max 的 TTFT 中位数从并发 1 的 1915 ms 升到并发 4 的 4377 ms。Qwen3.8 Max 从 1474 ms 到 1693 ms。单请求解码吞吐仍是工作负载 A 的格局:91.3 token/s 对 58.6 token/s。Qwen3.8 Max 的批次合计略高(170.7 对 152.2 token/s),是因为这一批吐出的 completion token 更多(1876 对 1500),其中包含更多思考,不是单请求解码更快。
这是很轻的探测。不是容量测试,也不是 SLA。
短回复不进吞吐对比
另一个负载要求只回答单词 OK,不要别的内容,max_tokens=128,1 次 warmup 加 7 次。TTFT 方差很大。p95 常常超过 5 秒。输出只有一把 token。关 thinking 时,两个 token 往往打在同一个 chunk 里,TPOT 记为无效。不要用这个负载算 TPOT,也不要算解码吞吐。
| 指标 | Qwen4-Max 默认 | Qwen3.8 Max 默认 | Qwen4-Max 关 thinking |
|---|---|---|---|
| TTFT(ms) | 2354(5482) | 2047(4606) | 2288(5119) |
| 到首个回答 token(ms) | 3069(6644) | 2482(5219) | 2288(5119) |
| 中位 completion / reasoning token | 13 / 10 | 31 / 28 | 2 / 0 |
这组数字不能告诉你的事
它不能告诉你阿里云自己的原始服务延迟,不能告诉你另一家网关的数,也不能告诉你同一批提示换一天会怎样。它没有纳入 Gemini 4 Carbon、GPT-6 Astra 或 Claude Fable 5.2。这三个模型没有被调用。这里没有任何针对它们的延迟排名。公开标价已经有了之后,那一组能比的价格、上下文和入口,在 11 月 16 日的旗舰对照。11 月 15 日、另一个 slug 上的预览期记录是 预览期真正能比的是什么。
它也不能告诉你:你的生产前缀上缓存命中会让首 token 更快,关掉 thinking 的 TTFT 稳定更差,或者四个并发请求描述了容量。切换文里的 9 项探测(8 通过、1 部分,以及墙钟和 token 数)是旁边的另一组测量。它不是第二张延迟表,这篇也不再贴那张表。
账号已经钉在 Qwen3.8 Max 上,或者你要的就是那张九折卡、agent 还没按新的默认力度重新看过,就留在这张卡。2026 年 11 月 16 日的 hero 是 $1.80 / $5.40,标价 $2 / $6 的九折,缓存读取 $0.23,缓存写入 $2.25,上下文 1M,最大输出 131.1K。qwen3.8-max 的阿里官方最大输出仍是 128k。卡片印 131.1K。引用你实际调用的那一端。这个模型的长文是 Qwen 3.8 Max:阿里巴巴 2.4T 多模态旗舰模型全面解析。
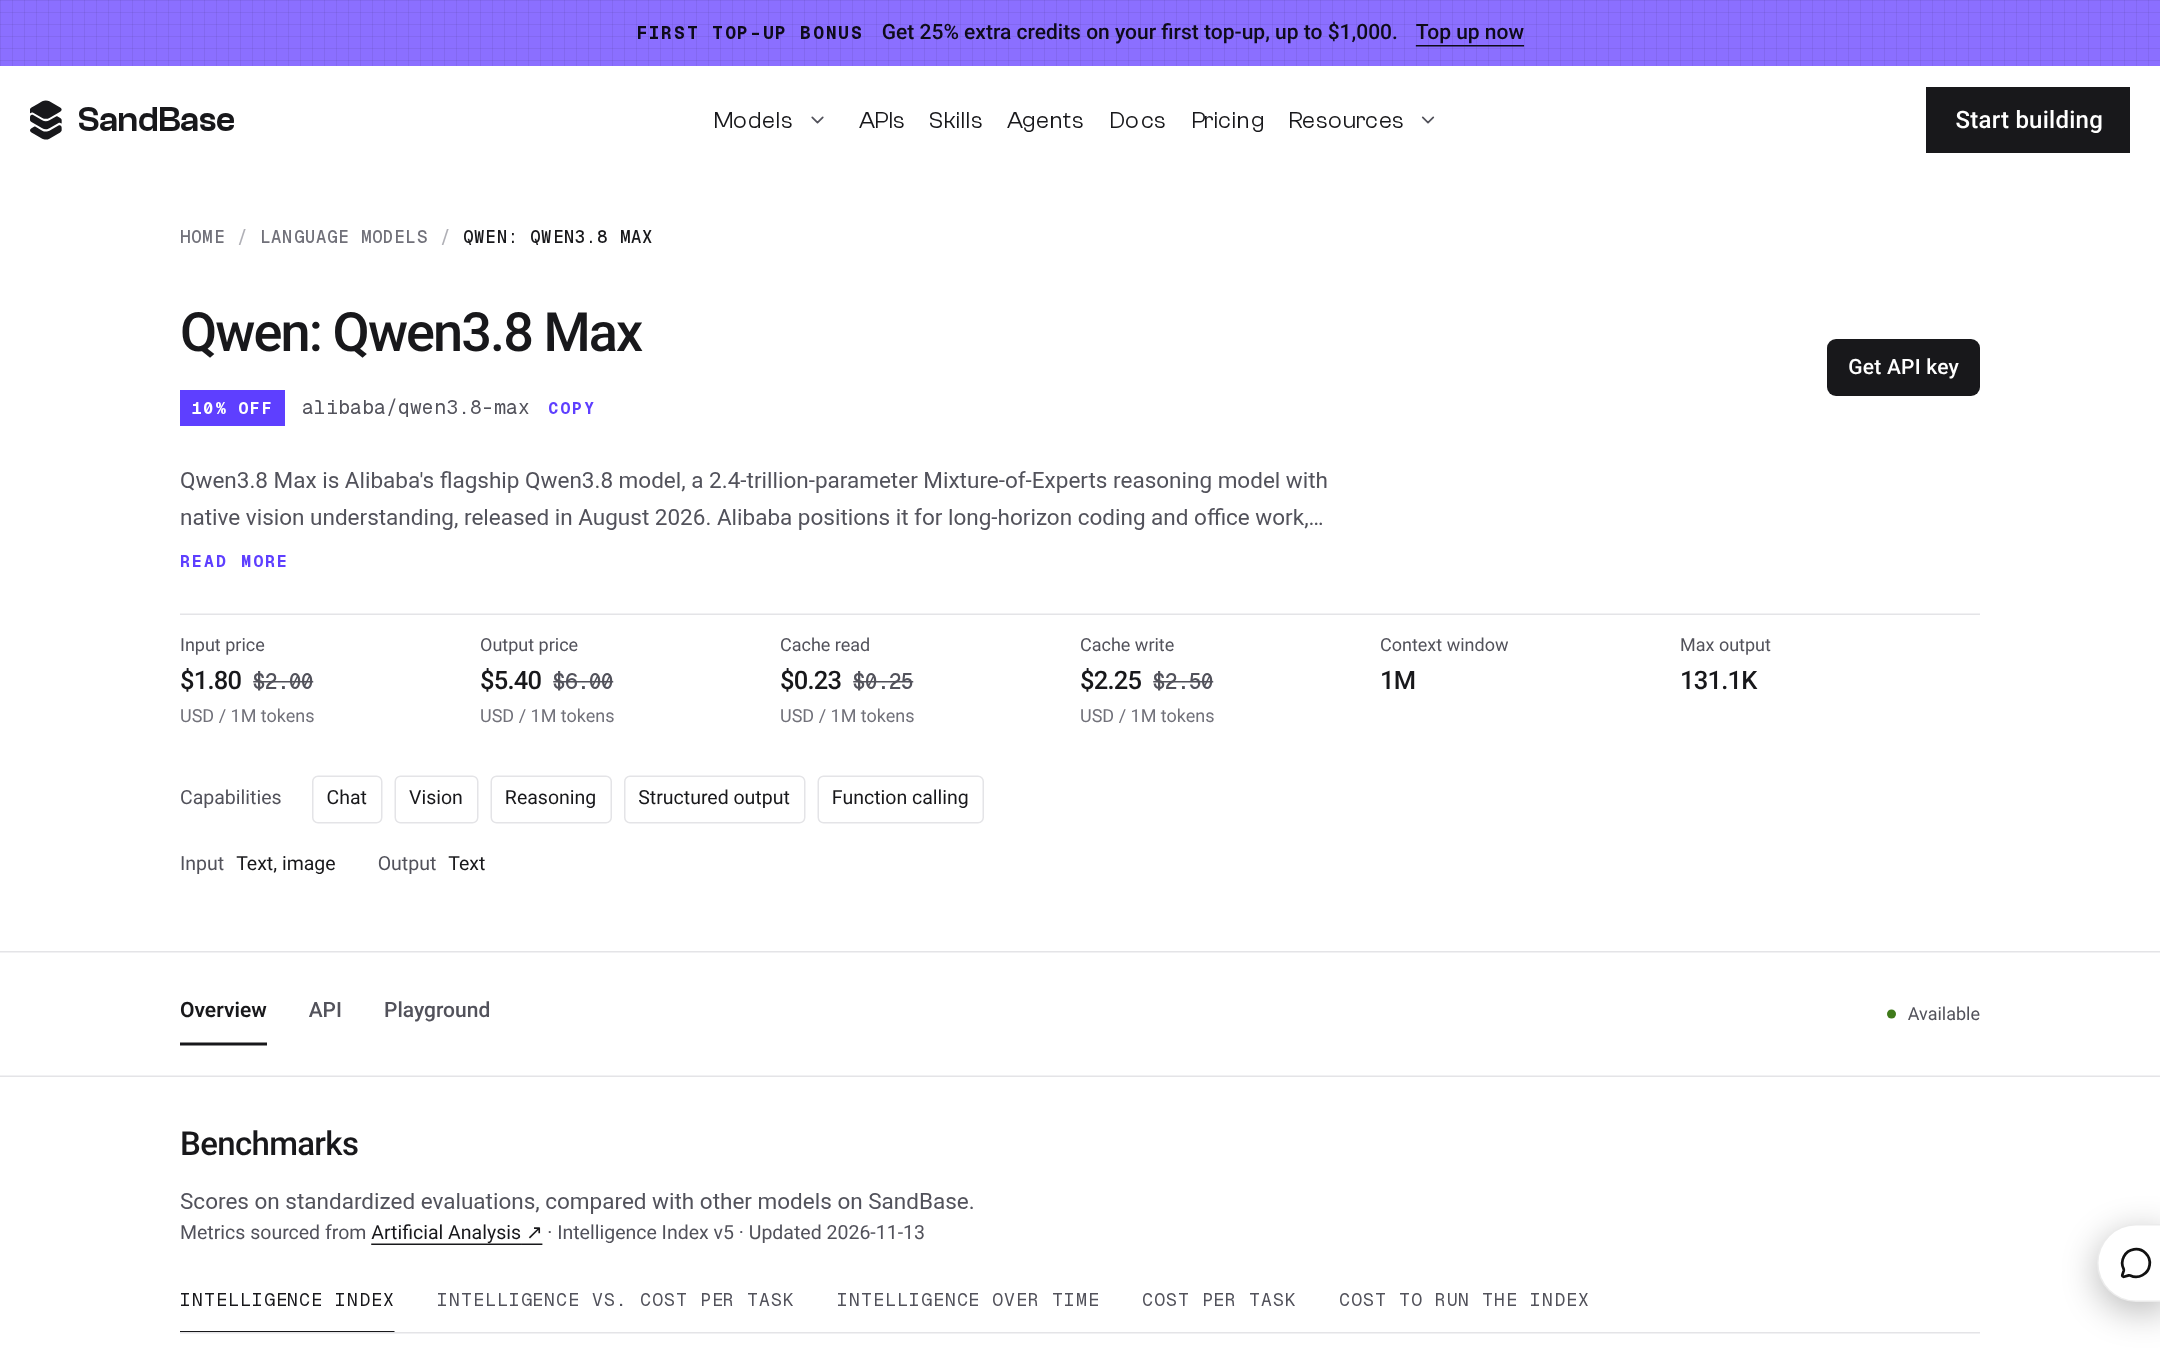
Live SandBase Qwen3.8 Max card at /models/alibaba/qwen3.8-max, captured 16 Nov 2026, Asia/Shanghai. Hero is $1.80 / $5.40 (10% off the $2 / $6 list), with cache read $0.23 and cache write $2.25 per 1M tokens, 1M context, and 131.1K max output. Official Alibaba max output for qwen3.8-max remains 128k; cite both figures and name the source.
今天调用哪一个
SandBase 上的新生产用 alibaba/qwen4-max。预览 ID 还在,它不是默认。 Qwen4 Max Preview 在 11 月 16 日仍在线,hero $2.00 / $6.00,缓存读取 $0.25,缓存写入 $2.50,上下文印的是 N/A,最大输出 131.1K。官方仍把这个预览写成 2026 年 11 月 25 日 24:00(UTC+8)之后下线。Token Plan 的历史接法留在 11 月 13 日的接入说明。11 月 15 日的切换记录 Qwen4-Max-Preview 和 Qwen3.8 Max 怎么选 是预览期的决定,保持原样。11 月 15 日的状态页 Qwen 4 发布了吗? 是预览档案,上面已有当天的正式发布更新。
上面用到的官方标价来自 QwenCloud 价格页。官方上下文和输出上限来自 QwenCloud 最新模型页。两页都是 11 月 16 日的页面。这篇不把发布说明再辩一遍。请求怎么写、131,072 / 262,144 两档上限、官方标价和卡片价的差距,归正式发布那篇。
Qwen 目录 返回 HTTP 200,标题仍是 “Qwen API: Alibaba Qwen3.8, 3.7 and Open-Weight Models | SandBase”。标题过期,不是 Qwen4-Max 缺席的证据。要打开的是单卡。
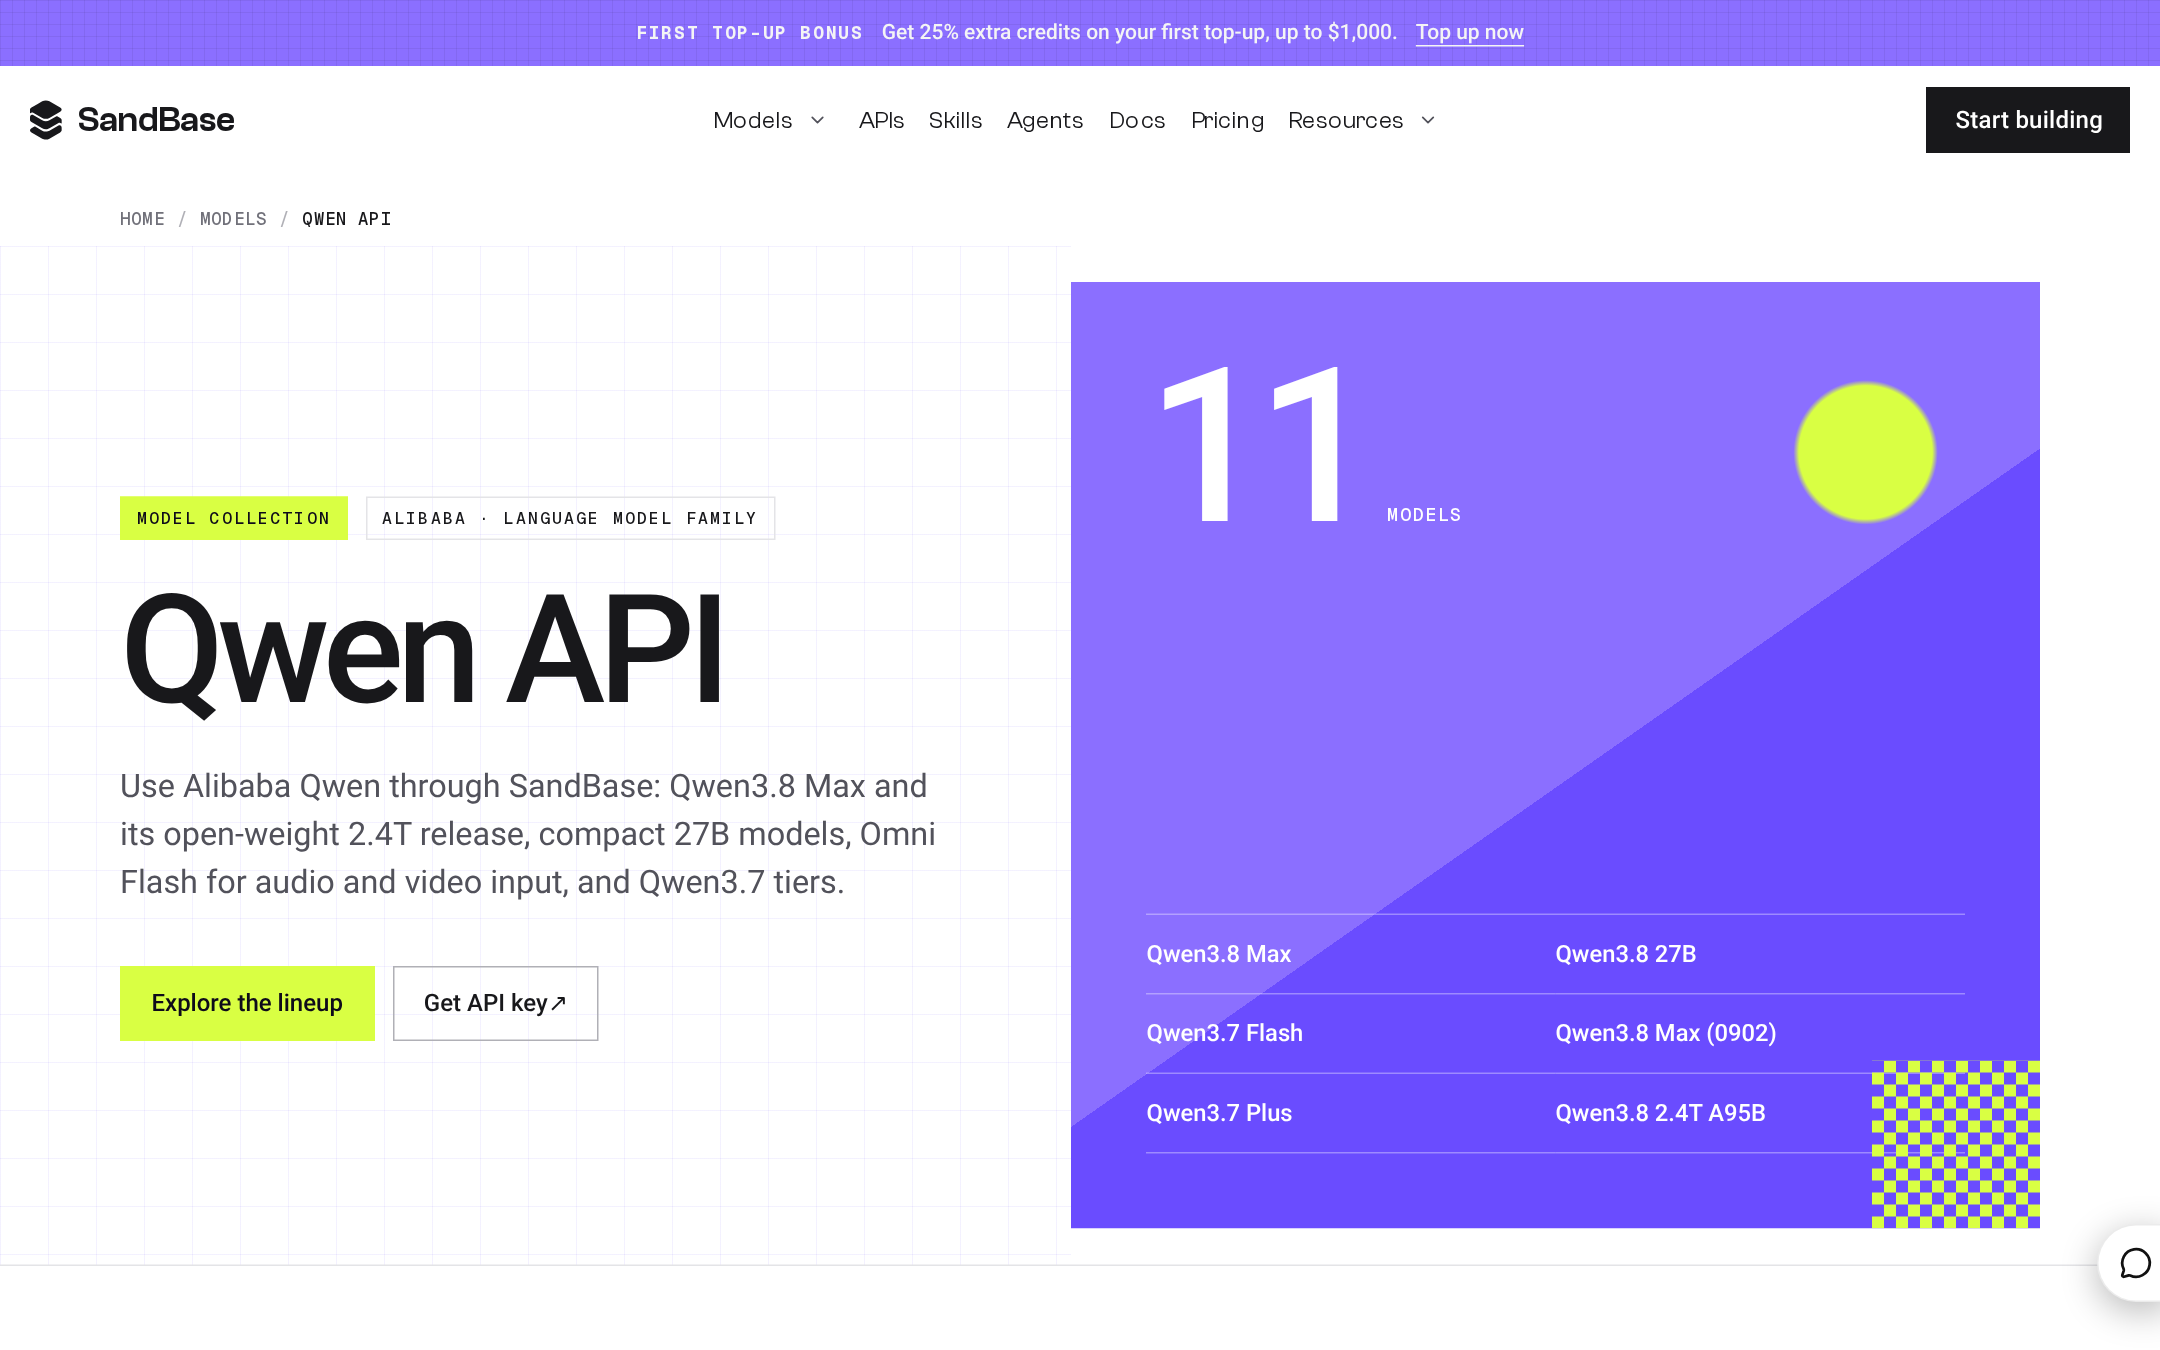
Live SandBase Qwen hub at /models/qwen, captured 16 Nov 2026, Asia/Shanghai. The page title and hero lineup are still Qwen3.8 / Qwen3.7 — they do not yet mention Qwen4-Max, even though the individual Qwen4-Max card is live and listed in the sitemap and llms-full.txt. Use this only to disclose the stale hub, not as a reason to say the model is missing from SandBase.
注册 会跳到登录页。建好密钥,按 第一次调用 文档发一条有边界的流式请求。模型字符串是 alibaba/qwen4-max。先在你自己的前缀上看第一个回答 token 和解码速率,再去挪队列。这篇的中位数,范围就是这次探测量到的那些。
常见问题
这是官方的 Qwen 延迟吗?
不是。这是 2026 年 11 月 16 日在 SandBase 上的单机流式测量。官方文档没有发布这些 TTFT、TPOT 或吞吐数字。不要把表当成厂商基准去引用。
缓存命中有没有让 TTFT 更快?
这组样本里没有稳定地更快。第二次调用确实读到了缓存。Qwen4-Max 默认 thinking 的 hit 中位数略低。另外两轮更高。n=5。账单上的缓存命中,和首 token 更快,不是同一句话。
为了更快的首 token,要不要关掉 thinking?
这里的证据不支持。关掉之后,TTFT 等于到首个回答 token 的时间,中位数是 2372 ms,默认 thinking 是 1915 ms。样本 7 次,散布更宽。解码吞吐只高了一点。
Gemini 4 Carbon、GPT-6 Astra、Claude Fable 5.2 测了吗?
没有。这次只调用了 alibaba/qwen4-max 和 alibaba/qwen3.8-max。上面链到的旗舰对照讲的是价格、上下文和入口。它不是这三个模型的延迟表。
相关阅读
- Qwen4-Max 已正式发布
- Qwen4-Max 和 Qwen3.8 Max 怎么选
- Qwen4-Max 和 Gemini 4 Carbon、GPT-6 Astra、Claude Fable 5.2 对比
- Qwen 4 发布了吗?
- Qwen4-Max-Preview 接入说明
- Qwen4-Max-Preview 和 Qwen3.8 Max 怎么选
- Qwen 4 和 Gemini 4 Carbon、GPT-6 Astra、Claude Fable 5.2(11 月 15 日)
- Qwen 3.8 Max:阿里巴巴 2.4T 多模态旗舰模型全面解析
流式中位数来自 2026 年 11 月 16 日 14:44:02–14:52:06(亚洲/上海)的一次 SandBase 网关探测。卡片 hero 和官方标价同一天核对。工作负载 A 是解码对比。工作负载 B 是缓存对比。并发 4 是很轻的附加项。短回复负载不是吞吐结果。
觉得有用?分享给更多人