Claude Opus 5.5 API 详解:SandBase 5 折、价格与使用边界
Claude Opus 5.5 API 详解:SandBase 当前 5 折后 $2/$10,1M 上下文、128K 输出、跑分、迁移坑与调用代码。
Claude Opus 5.5 现在最值得看的不是榜单第一,而是账单:SandBase 当前打 5 折,输入每百万 token $2,输出 $10。Anthropic 官方原价是 $4/$20,折后正好落到 Claude Sonnet 5.5 的官方价位。
但这不等于“无脑换 Opus”。它的自适应思考始终开启,隐藏的 thinking token 也按输出收费;从 Opus 5 迁移时,强制指定工具、关闭 thinking、默认读取第一个 content block,都可能出问题。5 折只是把验证成本压低了,并没有替你完成验证。
先说结论
- Anthropic 在 2026 年 9 月 22 日发布 Claude Opus 5.5,定位是长时间运行的 coding agent 与知识工作。
- Anthropic 原价为 $4/M 输入、$20/M 输出;SandBase Claude Opus 5.5 页面当前显示 5 折,实付 $2/M、$10/M,cache read 为 $0.10/M,5 分钟 cache write 为 $2.50/M。
- 规格是 1M 上下文、128K 同步输出,支持文字和图片输入、工具调用、结构化输出,以及无法关闭的 adaptive thinking。
- 复杂 Agent 任务可以测;简单分类、短抽取、低延迟高并发任务别急着换。
- 我们新跑了 1 次确定性的代码审查,答案和边界条件都对,但 1 次调用只能证明线路可用,不是模型排名。
Claude Opus 5.5 是什么?
Claude Opus 5.5 是 Anthropic 当前的 Opus 型号,主攻 coding agent、长链路任务和专业知识工作,也是 Claude 5.5 家族的首个模型。它是闭源商业模型,Anthropic 没有发布权重或开源许可证。
Claude 原生 API 的模型 ID 是 claude-opus-5-5;SandBase 上是 anthropic/claude-opus-5.5,既能走 OpenAI 兼容的 Chat Completions,也能走 Anthropic 兼容的 Messages API。
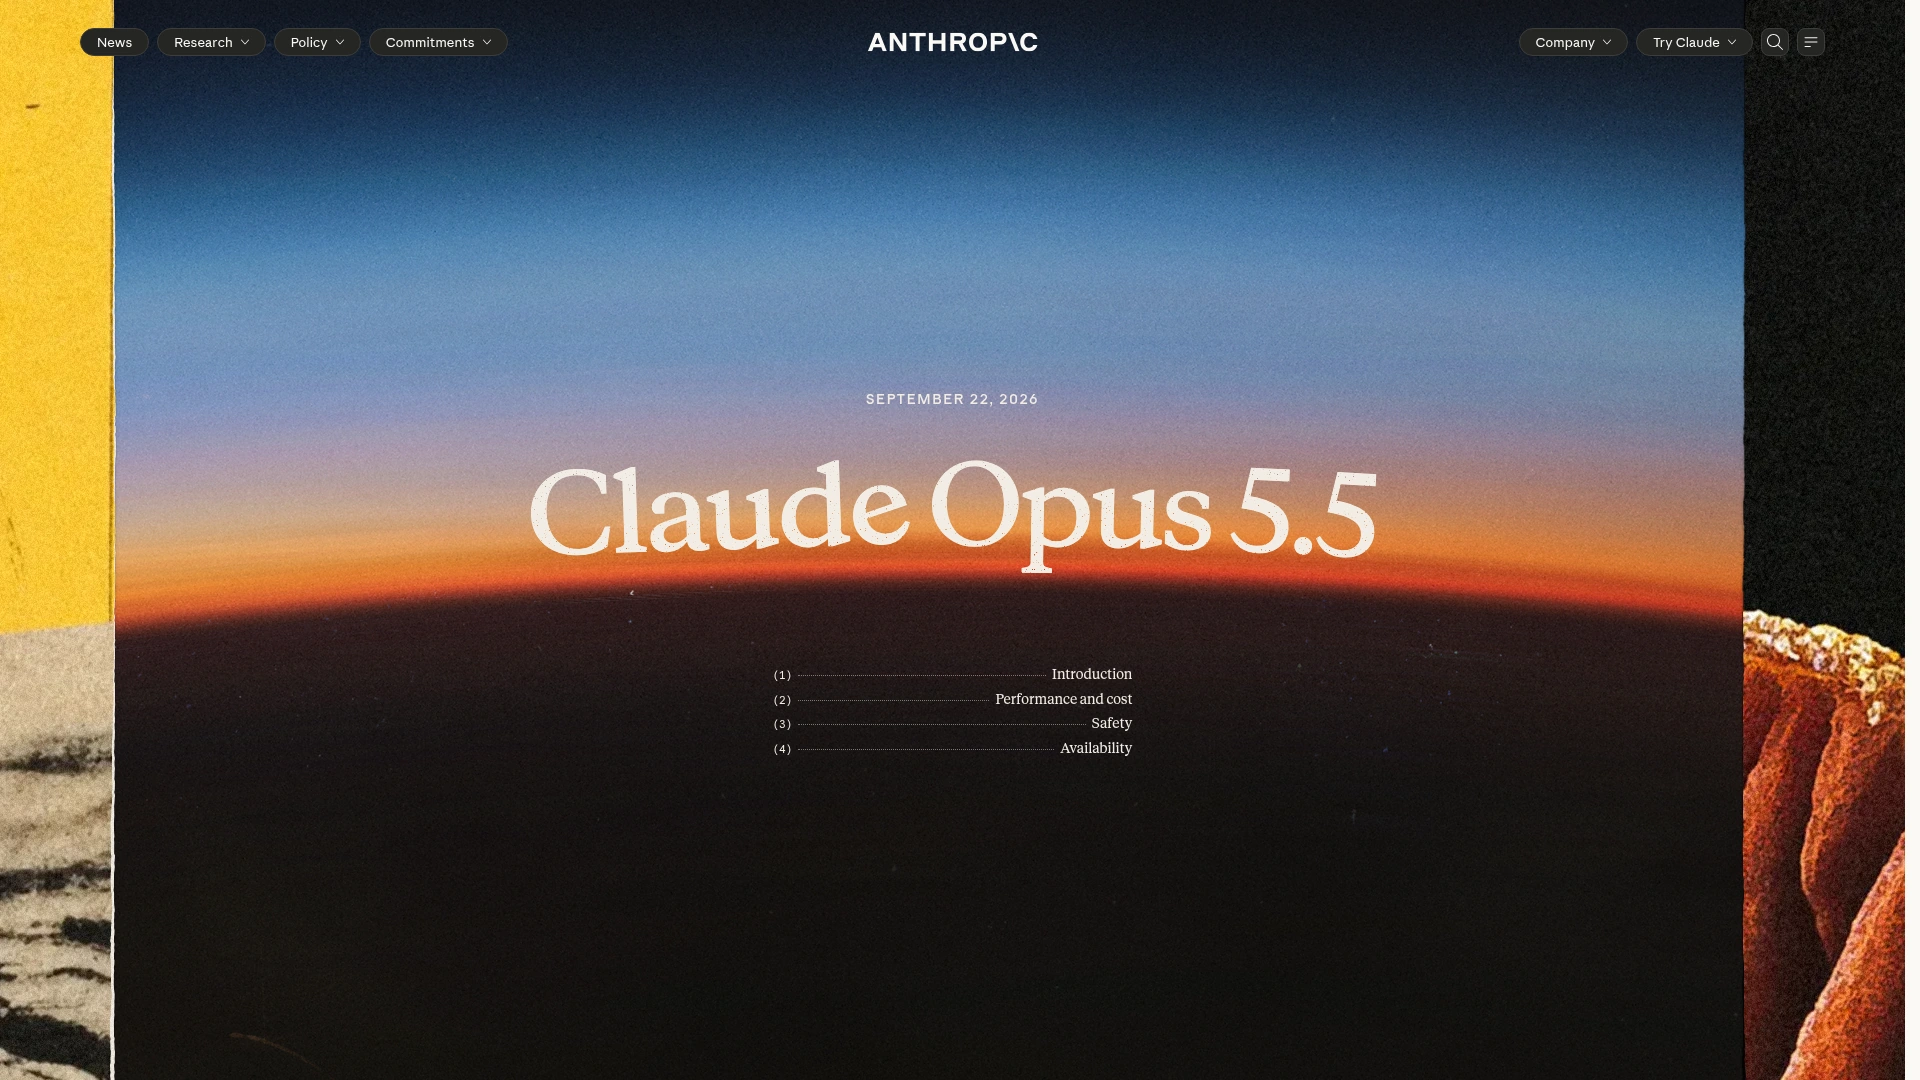 Anthropic 发布页,2026 年 10 月 27 日截取。它能确认名称和发布日期;下文没有标注“实测”的性能数字均为 Anthropic 自报。
从 Opus 5 到 5.5,真正变了什么
官方单价降了 20%,cache read 降得更多
Opus 5.5 官方输入/输出价格从 Opus 5 的 $5/$25 降到 $4/$20,单 token 便宜 20%。Anthropic 还说,默认设置下的典型任务总成本可降 40%,因为新模型完成任务所用 token 更少。这个 40% 是 Anthropic 的工作负载估算,不是每次请求都会自动打六折。
Cache read 从 Opus 5 的 $0.50/M 降到 $0.20/M,降幅 60%。长时间运行的 Agent 往往会重复读 system prompt、仓库地图和规则文档,这个数字可能比输入单价更影响总账单。
Thinking 永远开着
Opus 5.5 不接受 thinking: {"type": "disabled"},也不能再手工设置 extended-thinking budget。它只用 adaptive thinking,思考深度由 output_config.effort 控制,默认是 medium。
这里有个很实在的坑:thinking token 会占用 max_tokens,即使思考文字默认不返回,也照样按输出 token 计费。响应还可能先出现 thinking block;如果代码直接读 content[0].text,迁移后可能炸掉。正确做法是按 type 找文本,并在工具循环里把 thinking block 原样传回。
强制指定工具可能直接 400
Anthropic 文档明确写了:Opus 5.5 不支持把 tool_choice 设成 any 或某个指定工具。要改成 auto,再配合 strict tool schema。电脑操作工具版本、工具间进度文本的返回位置也有变化。生产环境不要只替换模型字符串,先读官方迁移指南。
输出更快,但数字是厂商口径
Anthropic 称 Opus 5.5 的输出速度比 Opus 5 快 30% 以上。发布表里,Terminal-Bench 4.0 是 66.4% 对 52.3%,FrontierCode v1.1 是 54.4% 对 48.0%。这些数字有对应 harness 和误差说明,但仍是 Anthropic 自报;本文没有复现,也不能把它们当成 SandBase 线路延迟。
Claude Opus 5.5 规格
| 项目 | 当前值 |
|---|---|
| 厂商 | Anthropic |
| 发布日期 | 2026 年 9 月 22 日 |
| Claude API ID | claude-opus-5-5 |
| SandBase 模型 ID | anthropic/claude-opus-5.5 |
| 上下文 | 1,000,000 token |
| 最大输出 | 同步 128,000 token;Anthropic Batch API beta 为 300K |
| 输入 → 输出 | 文字、图片 → 文字 |
| 思考 | Adaptive,始终开启;默认 effort 为 medium |
| 工具 / 结构化输出 | SandBase 支持;Anthropic 原生 API 强制指定工具有迁移限制 |
| 知识与训练截止 | 2026 年 6 月 |
| 权重 / 许可证 | 闭源,未发布权重 |
| SandBase 路由 | /v1/chat/completions、/v1/messages |
1M 是容量上限,不是“每一轮都把整个仓库塞进去”的理由。先筛选工作集、缓存稳定前缀,通常更便宜,也更容易追查失败。大量图片、PDF 或文件还可能先撞上请求体限制。
跑分:方向有用,不能直接拿来路由
SandBase 模型页当前展示 Artificial Analysis Intelligence Index v4.3。被测配置是 Claude Opus 5.5 (Max, Default Fallback),得分 57.6,在页面纳入的 87 个 SandBase 模型中排第 1。同图里 Sonnet 5.5 为 56.0、GPT-6 Astra 为 52.7、Gemini 4 Argon 为 52.6、Opus 5 为 50.8。
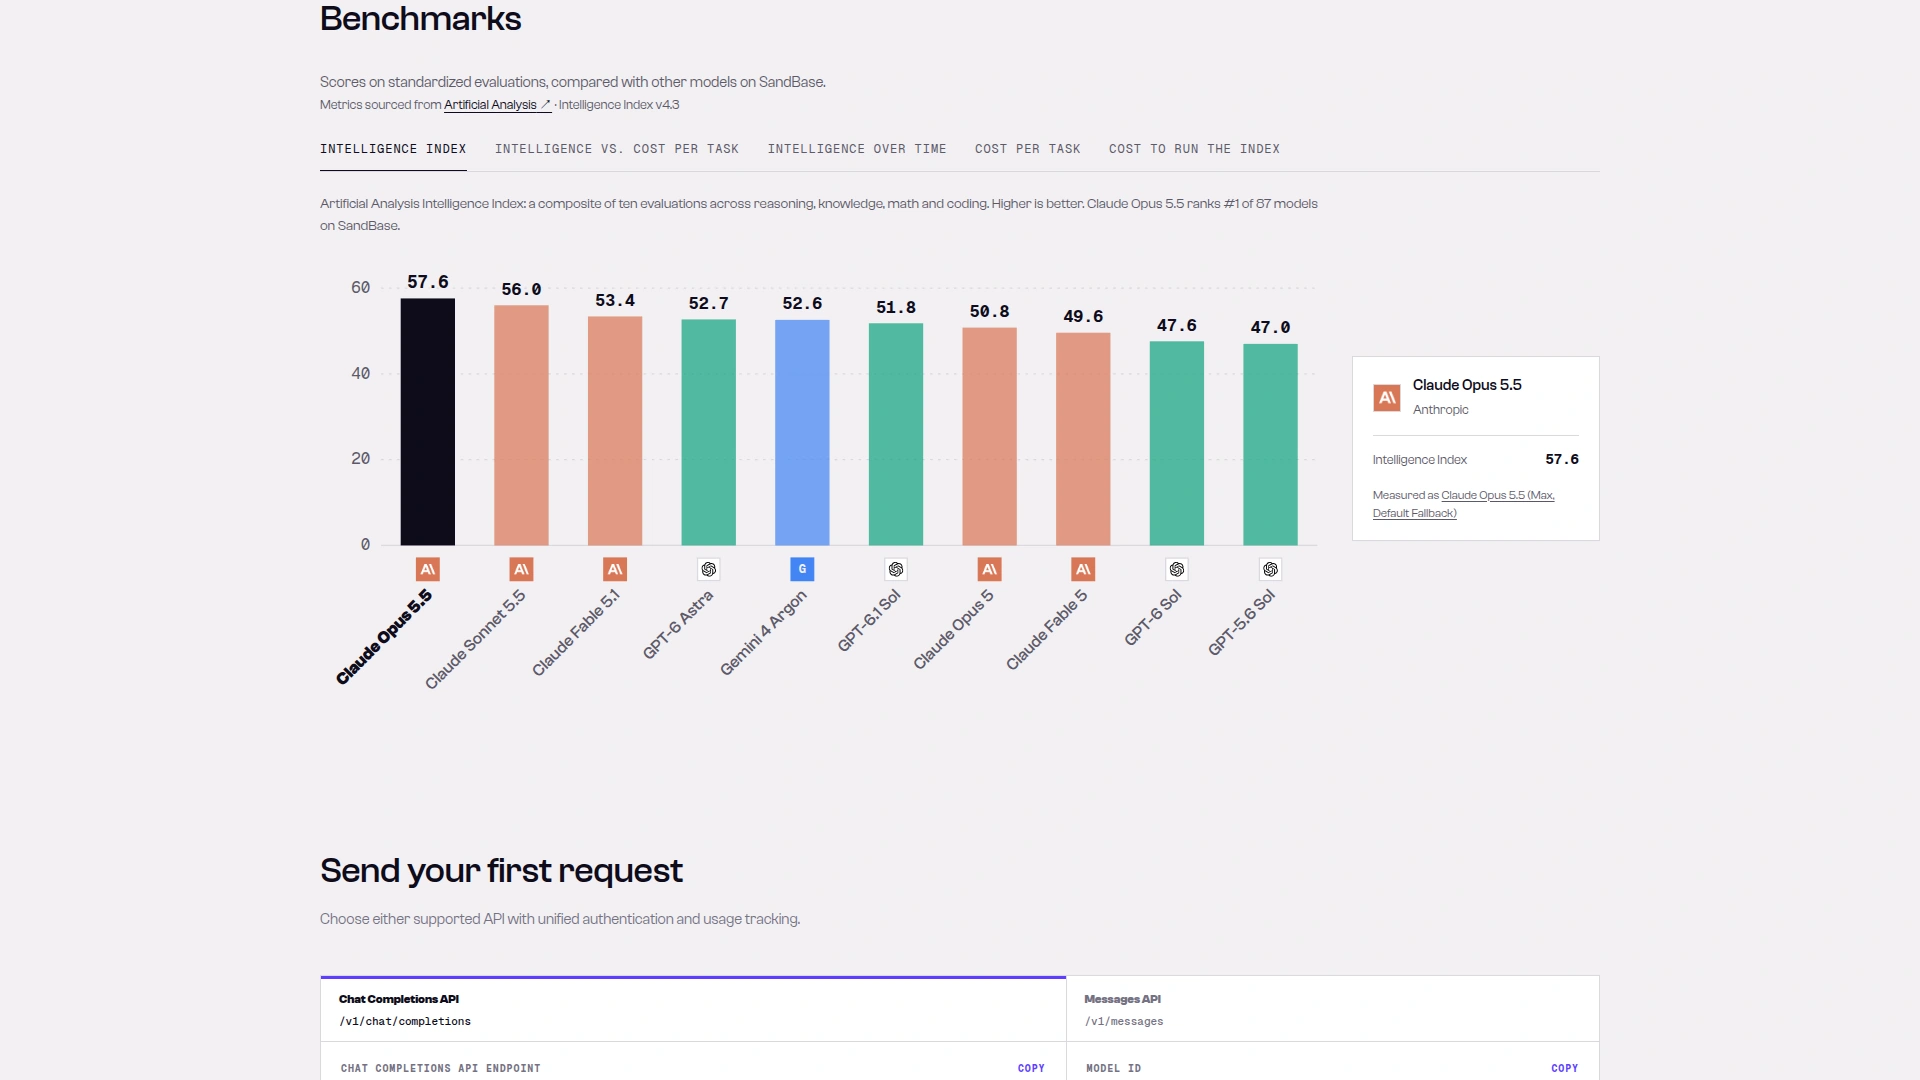 SandBase 模型页跑分区,2026 年 10 月 27 日截取。Artificial Analysis 测的是 Max 配置,不能把 57.6 当成默认
medium 档或所有业务任务的成绩。
配置名比“第一”更重要。要做生产路由,模型、effort、工具、提示词、重试和验收测试都要固定,再比较完成率和每个完成任务的总成本。
Claude Opus 5.5 价格:官方原价 vs SandBase 5 折
| Token 类型 | Anthropic 原价 | SandBase 当前价 | 折扣 |
|---|---|---|---|
| 输入 | $4.00/M | $2.00/M | 50% |
| 输出 | $20.00/M | $10.00/M | 50% |
| Cache read | $0.20/M | $0.10/M | 50% |
| 5 分钟 cache write | $5.00/M | $2.50/M | 50% |
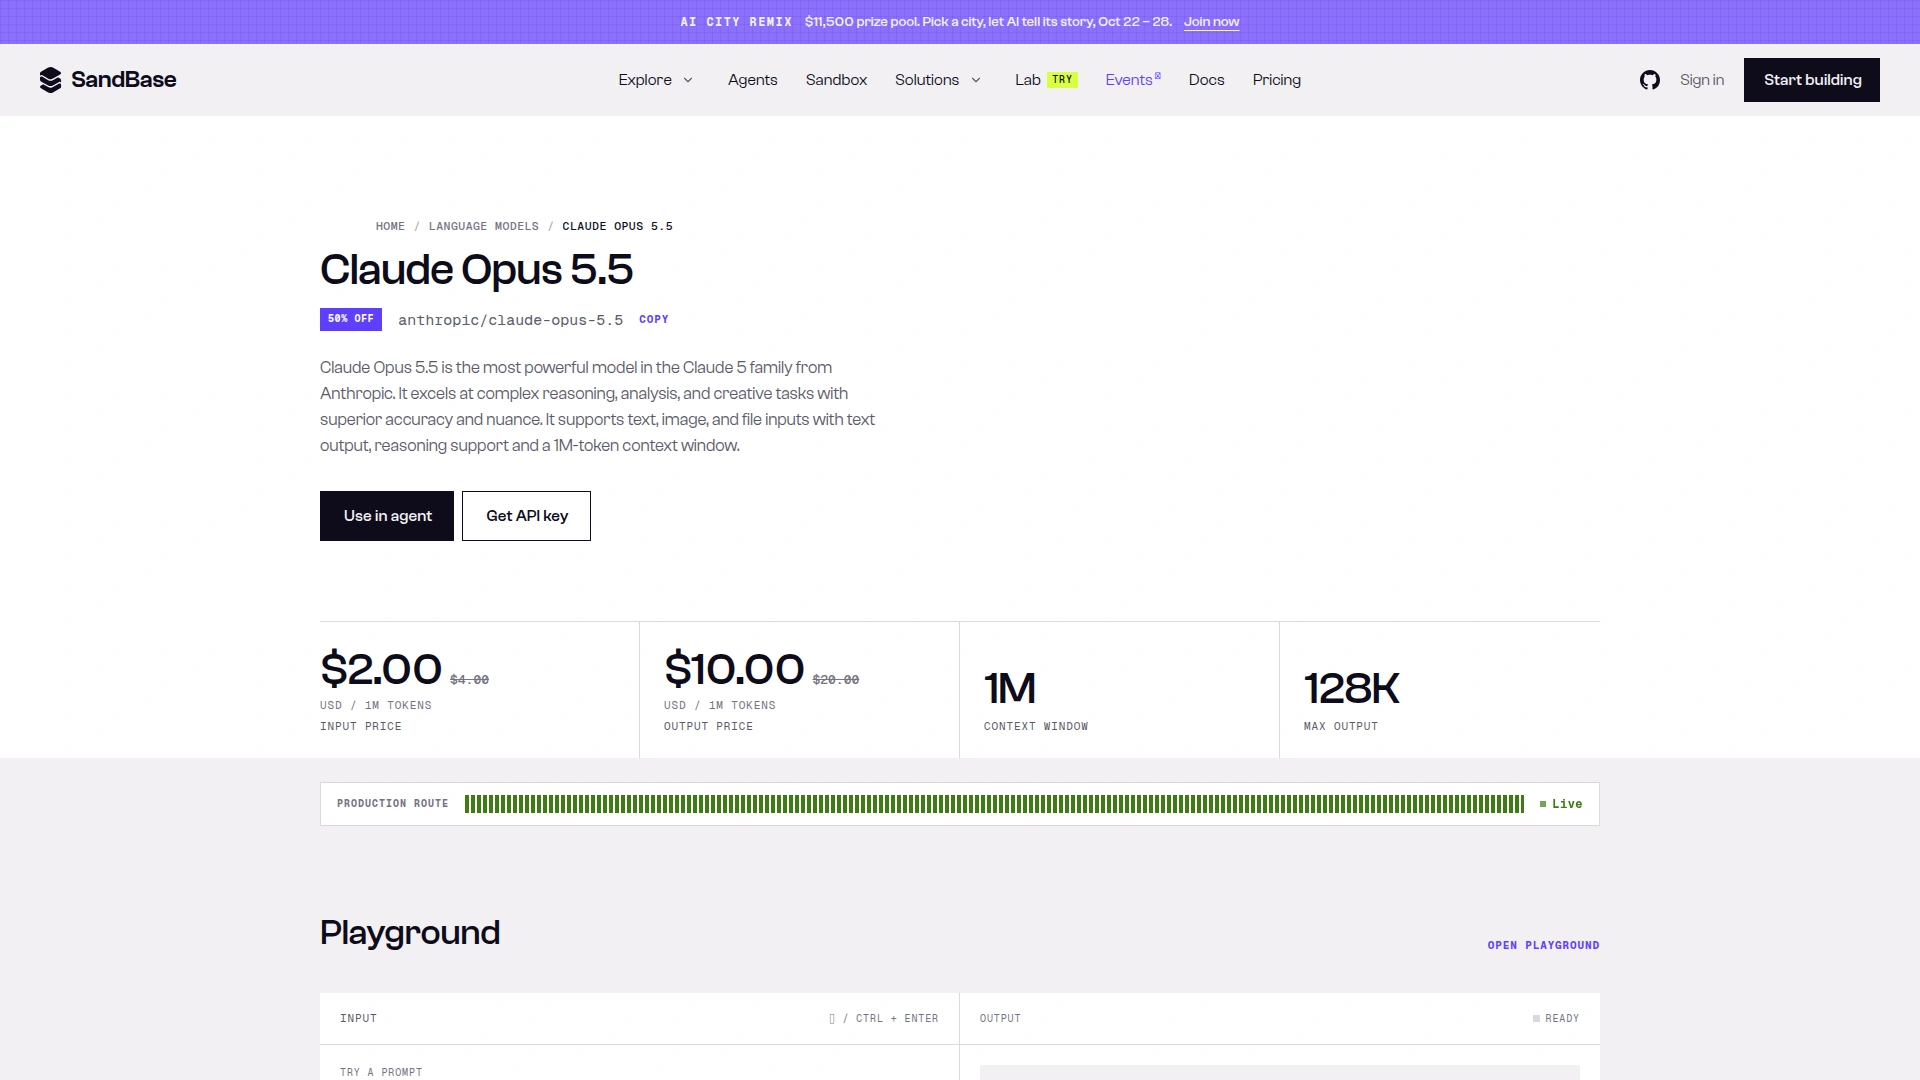 SandBase 模型页,2026 年 10 月 27 日截取;当时显示 50% OFF,生产线路为 Live。活动价格会变,实际购买时以模型页为准。
举个能落到账本上的例子:100K 输入加 5K 输出,按当前 SandBase 价格是 $0.25,其中输入 $0.20、输出 $0.05;Anthropic 原价同样 token 组合为 $0.50。
如果 100K 输入里有 90K 命中缓存,SandBase 计算变成:10K 普通输入 $0.02 + 90K cache read $0.009 + 5K 输出 $0.05,合计 $0.079。注意,thinking token 也算输出,所以生产估价要看 API usage,不能只数最终答案字数。
一次小实测:诊断正确,实扣 $0.008062
我们在 2026 年 10 月 27 日通过 SandBase 发了一道确定性的代码审查题:一个分页函数无论有没有余数都 +1。Opus 5.5 正确指出“整除时出错,total_items == 0 也属于这类”,解释了多出来的空白页,并给出整数向上取整写法。它还把“空数据时 UI 是否至少显示 1 页”单独列成产品规则,没有混进数学修复。
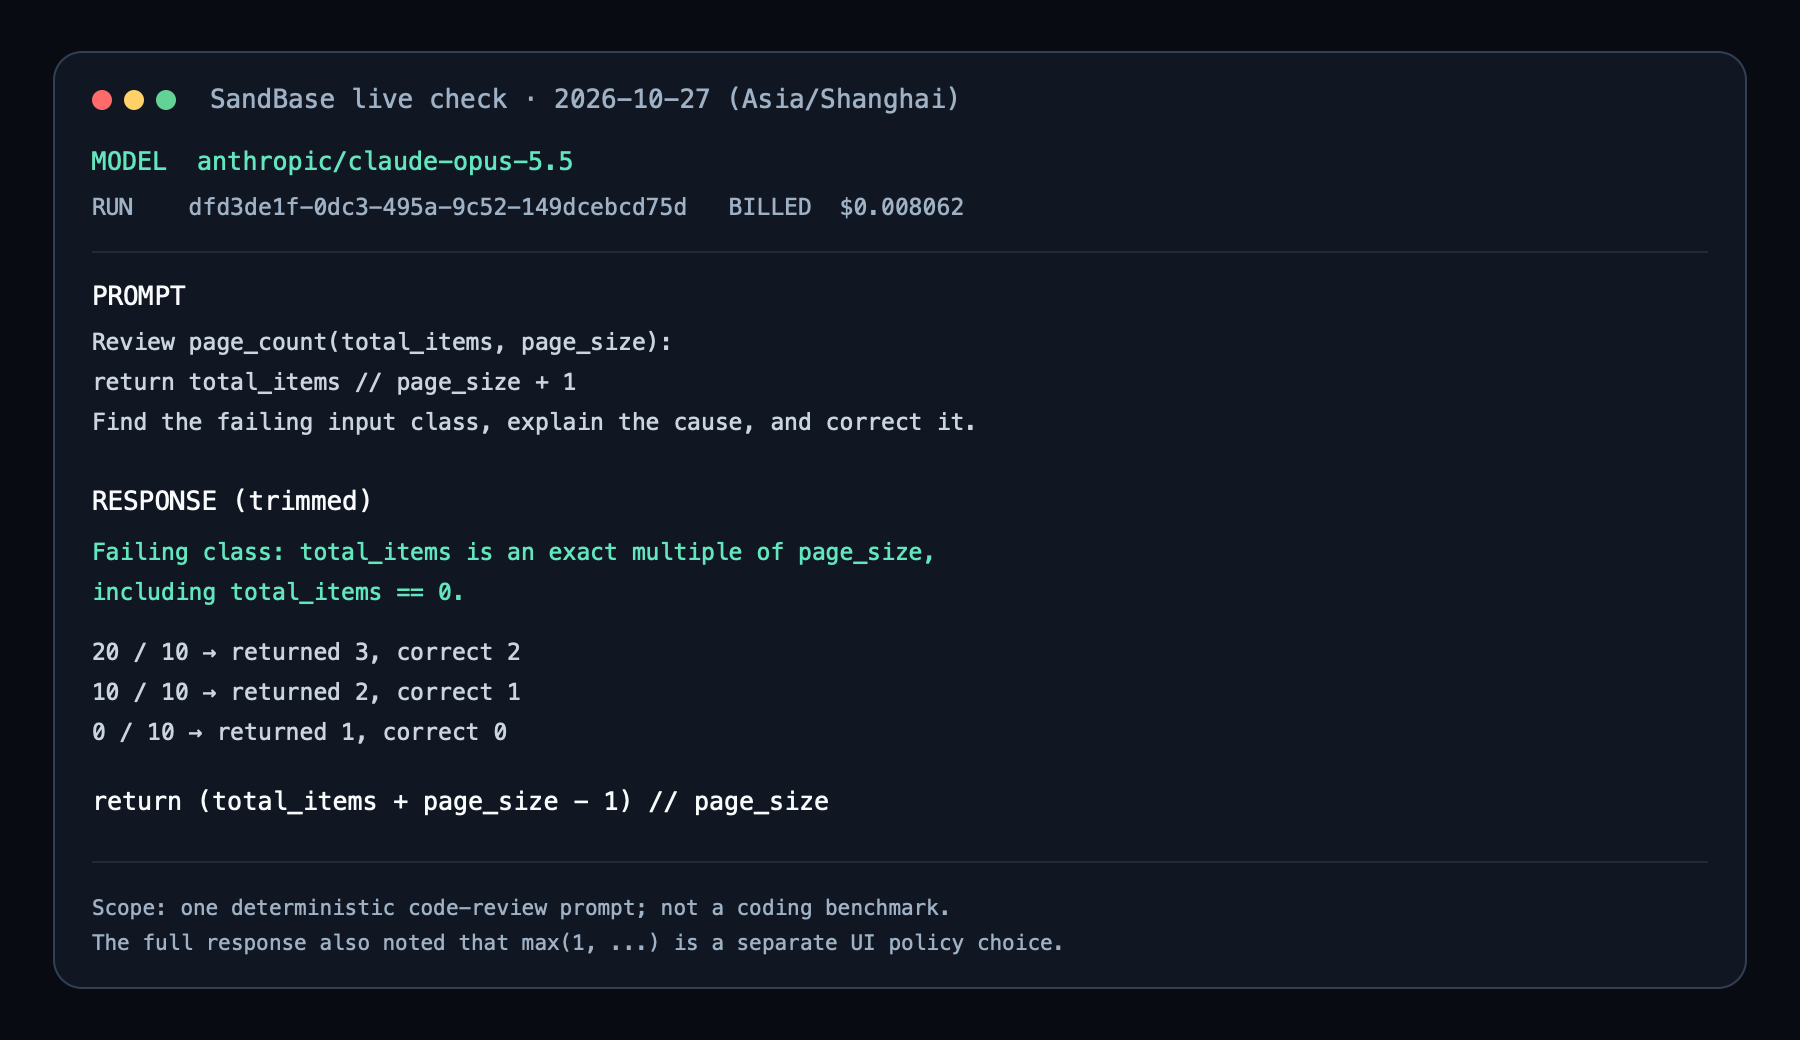 SandBase 单次调用
dfd3de1f-0dc3-495a-9c52-149dcebcd75d,实扣 $0.008062。这能证明线路可用、这道题答对了,不能证明它在编程上必然胜过别的模型。
这次答案真正有价值的地方,不是“会修简单 off-by-one”。多数旗舰模型都能答。它保留了零数据的边界条件,也没有擅自把 UI 惯例当成函数定义。
Opus 5.5 和其他模型怎么选
| 模型 | 官方输入/输出价 | 上下文 | 更适合 | 主要代价 |
|---|---|---|---|---|
| Claude Opus 5.5 | $4/$20;SandBase 当前 $2/$10 | 1M | 长链路 coding agent、高价值知识工作 | Thinking 关不掉,迁移有 breaking changes |
| Claude Sonnet 5.5 | $2/$10 | 1M | 更快的通用生产任务 | Anthropic 自报 Agent 跑分上限更低 |
| Claude Opus 5 | $5/$25 | 1M | 暂时不想改旧集成 | 更贵,发布表成绩更低 |
| Gemini 4 Argon | $4/$20 原价 | 1M | Google 生态与它擅长的评测项 | API 行为不同,要单测格式遵循 |
失败一次的代价明显高于多用一些 reasoning token 时,优先测 Opus 5.5;吞吐和交互延迟更重要时,先用 Sonnet 5.5。想看更宽的同题数据,我们的 Opus 5.5、Gemini 4 Argon、GPT-6 Astra 对比记录了 24 次调用和逐次成本。
在 SandBase 上调用 Claude Opus 5.5
已有 OpenAI 客户端时,Chat Completions 最省事:
curl --fail-with-body --silent \
  -X POST "https://api.sandbase.ai/v1/chat/completions" \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-opus-5.5",
    "messages": [
      {"role": "user", "content": "审查这份迁移计划,指出风险最高的一个假设。"}
    ],
    "max_tokens": 4096
  }'
SandBase 同时提供 /v1/messages。不要想当然地认为 Anthropic 原生参数在每条兼容路由上完全一样。我们更早的三模型对比里,Opus 5.5 在 2 次 response_format 调用中都没有按 schema 返回;在你的集成验证通过前,建议把 schema 同时写进提示词,并对返回 JSON 做严格校验。
适合什么,不适合什么
适合优先测试的任务包括:多文件代码迁移、失败代价高的长 Agent 循环、复杂技术调查、需要专家复核的专业文档。稳定前缀很长、会跨多轮复用时,prompt caching 尤其值得做。
不建议直接换的,是分类、短抽取、低延迟补全,以及便宜模型已经稳定过验收线的高并发任务。如果旧代码会关闭 thinking、强制指定工具、默认第一个 block 是文本,或在工具循环里丢掉 thinking block,也不能只改模型名。
测试范围说清楚:本文新跑了 1 道确定性题,并引用了我们已发布的同题调用。Anthropic 的“快 30%”、300K Batch beta、computer use 和超长时间自治,这次都没有独立验证。
常见问题
Claude Opus 5.5 多少钱?
Anthropic 原价是输入 $4/M、输出 $20/M。SandBase 在 2026 年 10 月 27 日显示 5 折,即 $2/M、$10/M。活动可能调整,实际价格看模型页。
Claude Opus 5.5 上下文多大?
1M token,同步最大输出 128K。Anthropic 另有 300K 输出的 Batch API beta。
能关闭 thinking 吗?
不能。Adaptive thinking 始终开启,只能用 effort 调整思考深度、延迟和费用。
Claude Opus 5.5 开源吗?
不开源。它是 Anthropic 的闭源商业模型,没有公开权重。
要不要用 Opus 5.5 替代 Sonnet 5.5?
只替换那些在你自己的验收集上明显提高完成率的任务。SandBase 当前 5 折抹平了基础 token 单价差,但不保证每个完成任务的总成本相同。
最后怎么选
SandBase 当前 $2/$10 的价格,让 Opus 5.5 更值得进入候选池,特别是能复用缓存的长 Agent 任务。但最后的路由规则仍要靠验收集:先修掉迁移假设,再比较“完成了多少工作”,不要只看榜单和最终答案长度。
可以从 Claude Opus 5.5 模型页直接测试。想看上一代的价格和控制项,可继续读 Claude Opus 5 深入指南。