Telegram 频道搜索 API 教程
用一个 REST API 按关键词搜索公开 Telegram 频道的历史:建基线、频道内检索、按传播度排序——一个 SandBase 密钥。
研究一个公开 Telegram 频道时,你很少想要整条 feed——你想要的是关于某一个话题的帖子。这篇教程用 SandBase Telegram API 在一个频道的历史里搭一个聚焦的关键词搜索:给频道建基线、做频道内检索、再按传播度给匹配排序。一个 SandBase 密钥,不需要 MTProto 客户端,也不需要登录 Telegram。
完整的端点全景见 Telegram 公开数据 API 总览。这一篇是落地的搜索工作流。
先说结论
- 两步:
channel-info(基线)→channel-search(频道内关键词搜索)。- 每次都是
POST /v1/api/telegram/<path>,一个SANDBASE_API_KEY;completed 运行才带outputs数组,failed/timeout 运行带error而没有outputs。channel-search接一个channel用户名和一个query;它返回一个匹配消息列表,你可以按每条消息带的字段排序。- 仅公开、只读数据;你这边不用登录 Telegram,但仍需要一个 SandBase API 密钥。
工作流全貌
| 步骤 | 端点 | 输入 | 你拿到 |
|---|---|---|---|
| 1. 建基线 | telegram/web/channel-info | channel | 订阅数、计数器、认证 |
| 2. 搜索 | telegram/web/channel-search | channel、query | 关键词的匹配消息 |
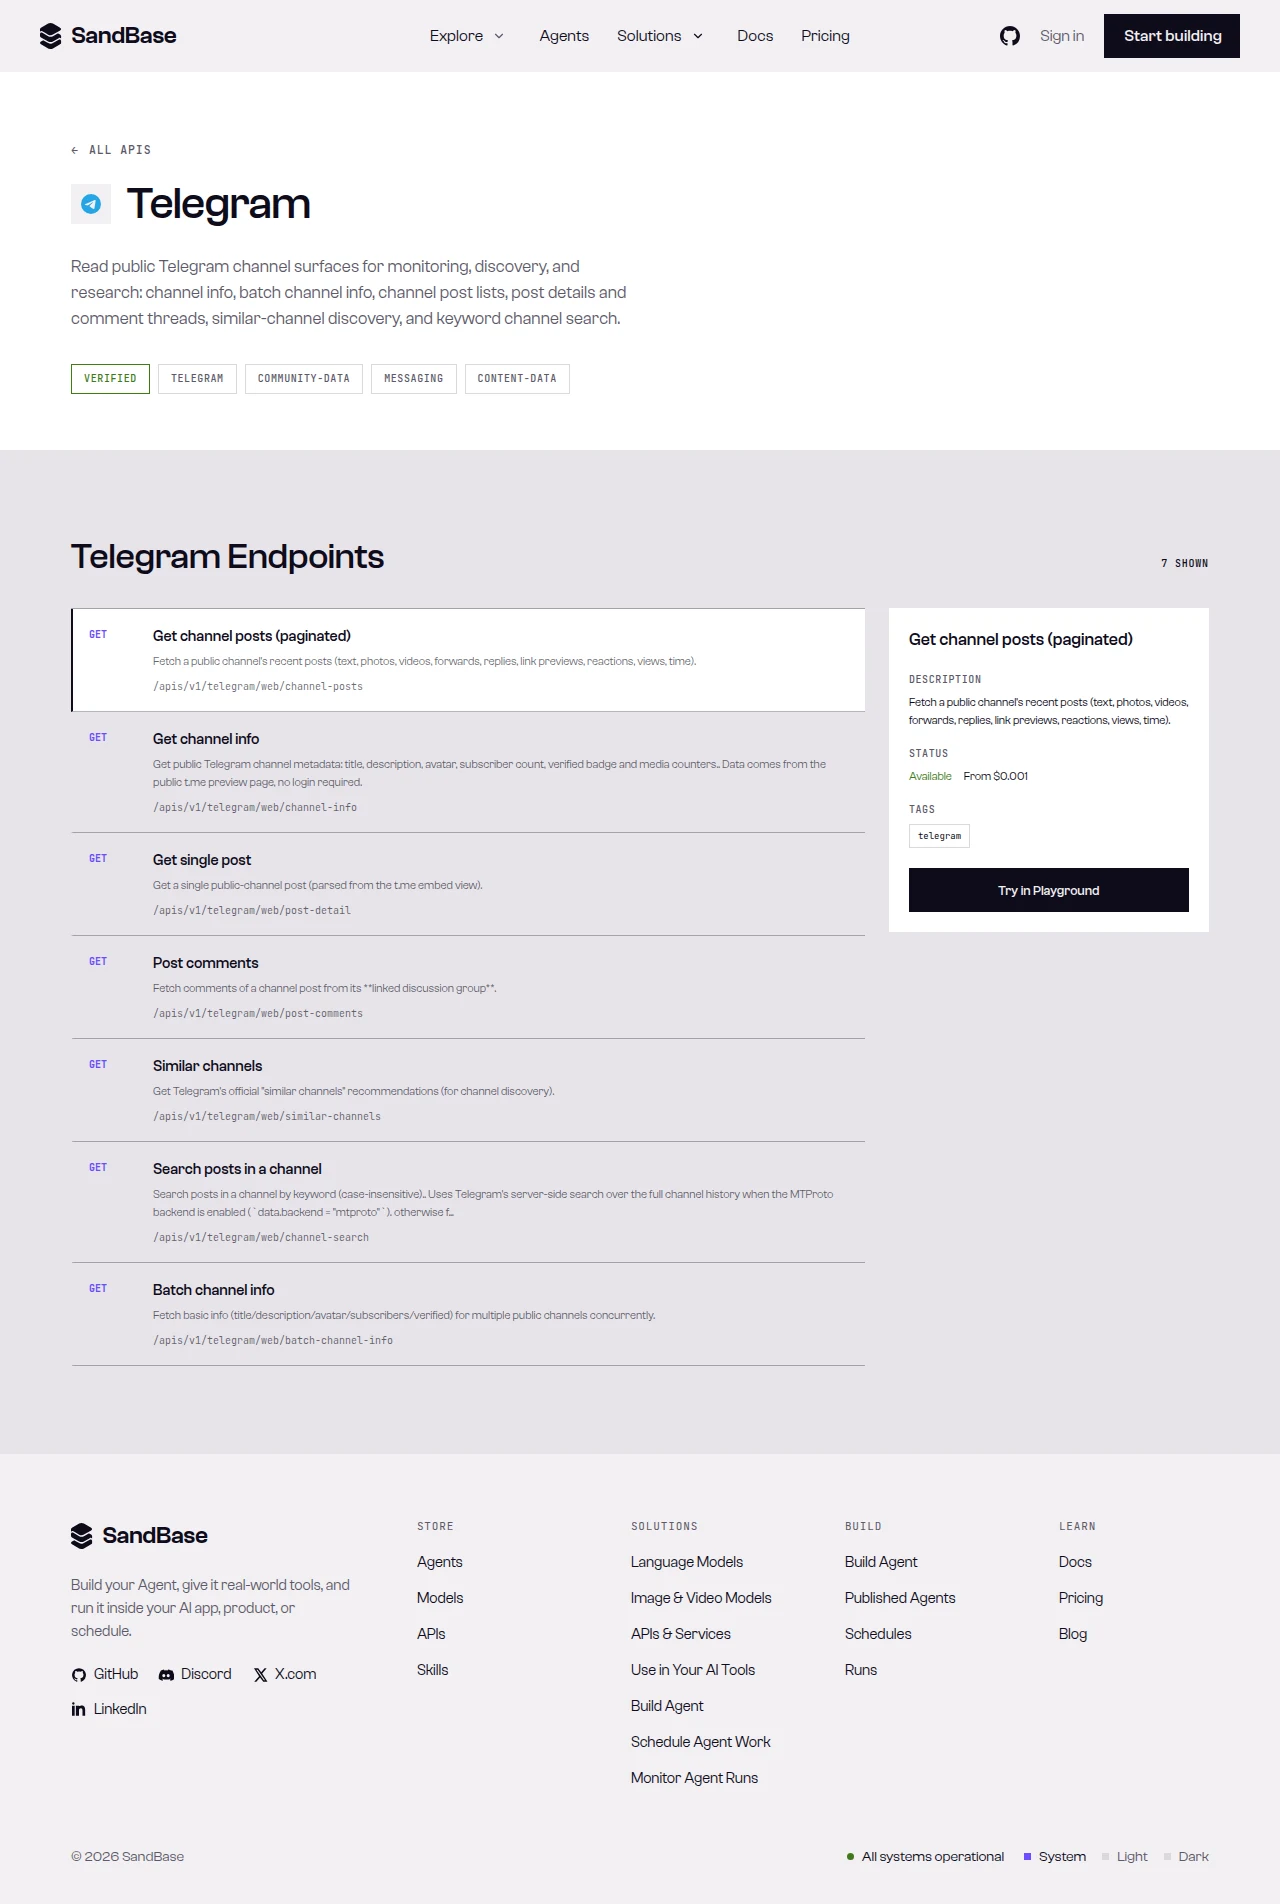 端点 API 参考是每个参数名和响应路径的事实来源。
第 1 步 —— 给频道建基线
先写一个判 status 的辅助函数,再读频道,让你的结果有上下文——在一个千万订阅频道上的匹配,和在一个小众频道上的匹配,意义不同:
import os
import requests

BASE = "https://api.sandbase.ai/v1/api/telegram"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}


def call(path: str, payload: dict) -> dict:
    resp = requests.post(f"{BASE}/{path}", headers=HEADERS, json=payload, timeout=90)
    resp.raise_for_status()
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error", {}).get("message", "请求未完成"))
    # 参考只保证信封;业务字段随端点而定,
    # 用防御式读取,并以一份真实响应核对。
    return body["outputs"][0]["data"]


info = call("web/channel-info", {"channel": "telegram"})
print(info.get("title"), info.get("subscribers"), info.get("verified"))
下面是我测试于 2026-09-27(UTC)的真实响应——completed 运行会把业务字段放在 outputs[0].data 下,所以代码仍对每个字段用 .get() 读取,因为这些数值(订阅数、计数器)会变、以真实响应为准:
{
  "id": "8c815356-e1f6-4668-959c-375f9471822f",
  "status": "completed",
  "model": "telegram/web/channel-info",
  "outputs": [
    {
      "data": {
        "title": "Telegram News",
        "username": "telegram",
        "subscribers": "9.46M",
        "verified": true,
        "counters": { "photos": "16", "videos": "228", "links": "378" }
      }
    }
  ]
}
第 2 步 —— 按关键词搜索频道
做一次频道内搜索。channel-search 接 channel 用户名加一个 query,返回匹配的消息:
def search_channel(channel: str, query: str) -> list[dict]:
    data = call("web/channel-search", {"channel": channel, "query": query})
    return data.get("messages", [])


matches = search_channel("telegram", "update")
for m in matches[:5]:
    print(m.get("id"), m.get("date"), (m.get("text") or "")[:60])
每条匹配消息带 id、date、text、text_html、一个 author、一个 link_preview、views、media、type、url 和转发标记(is_forwarded、forwarded_from、reply_to)等字段。下面是我测试于 2026-09-27(UTC)的真实响应;其中 matched、id、views 等取值会随时间变化,所以要防御式读取,并以真实响应为准:
{
"id": "8c815356-e1f6-4668-959c-375f9471822f",
"status": "completed",
"model": "telegram/web/channel-search",
"outputs": [
{
"data": {
"channel": "telegram",
"matched": 20,
"messages": [
{
"id": 460,
"date": "2026-08-26T19:12:34+00:00",
"text": "…",
"views": "1.48M",
"is_forwarded": false
}
]
}
}
]
}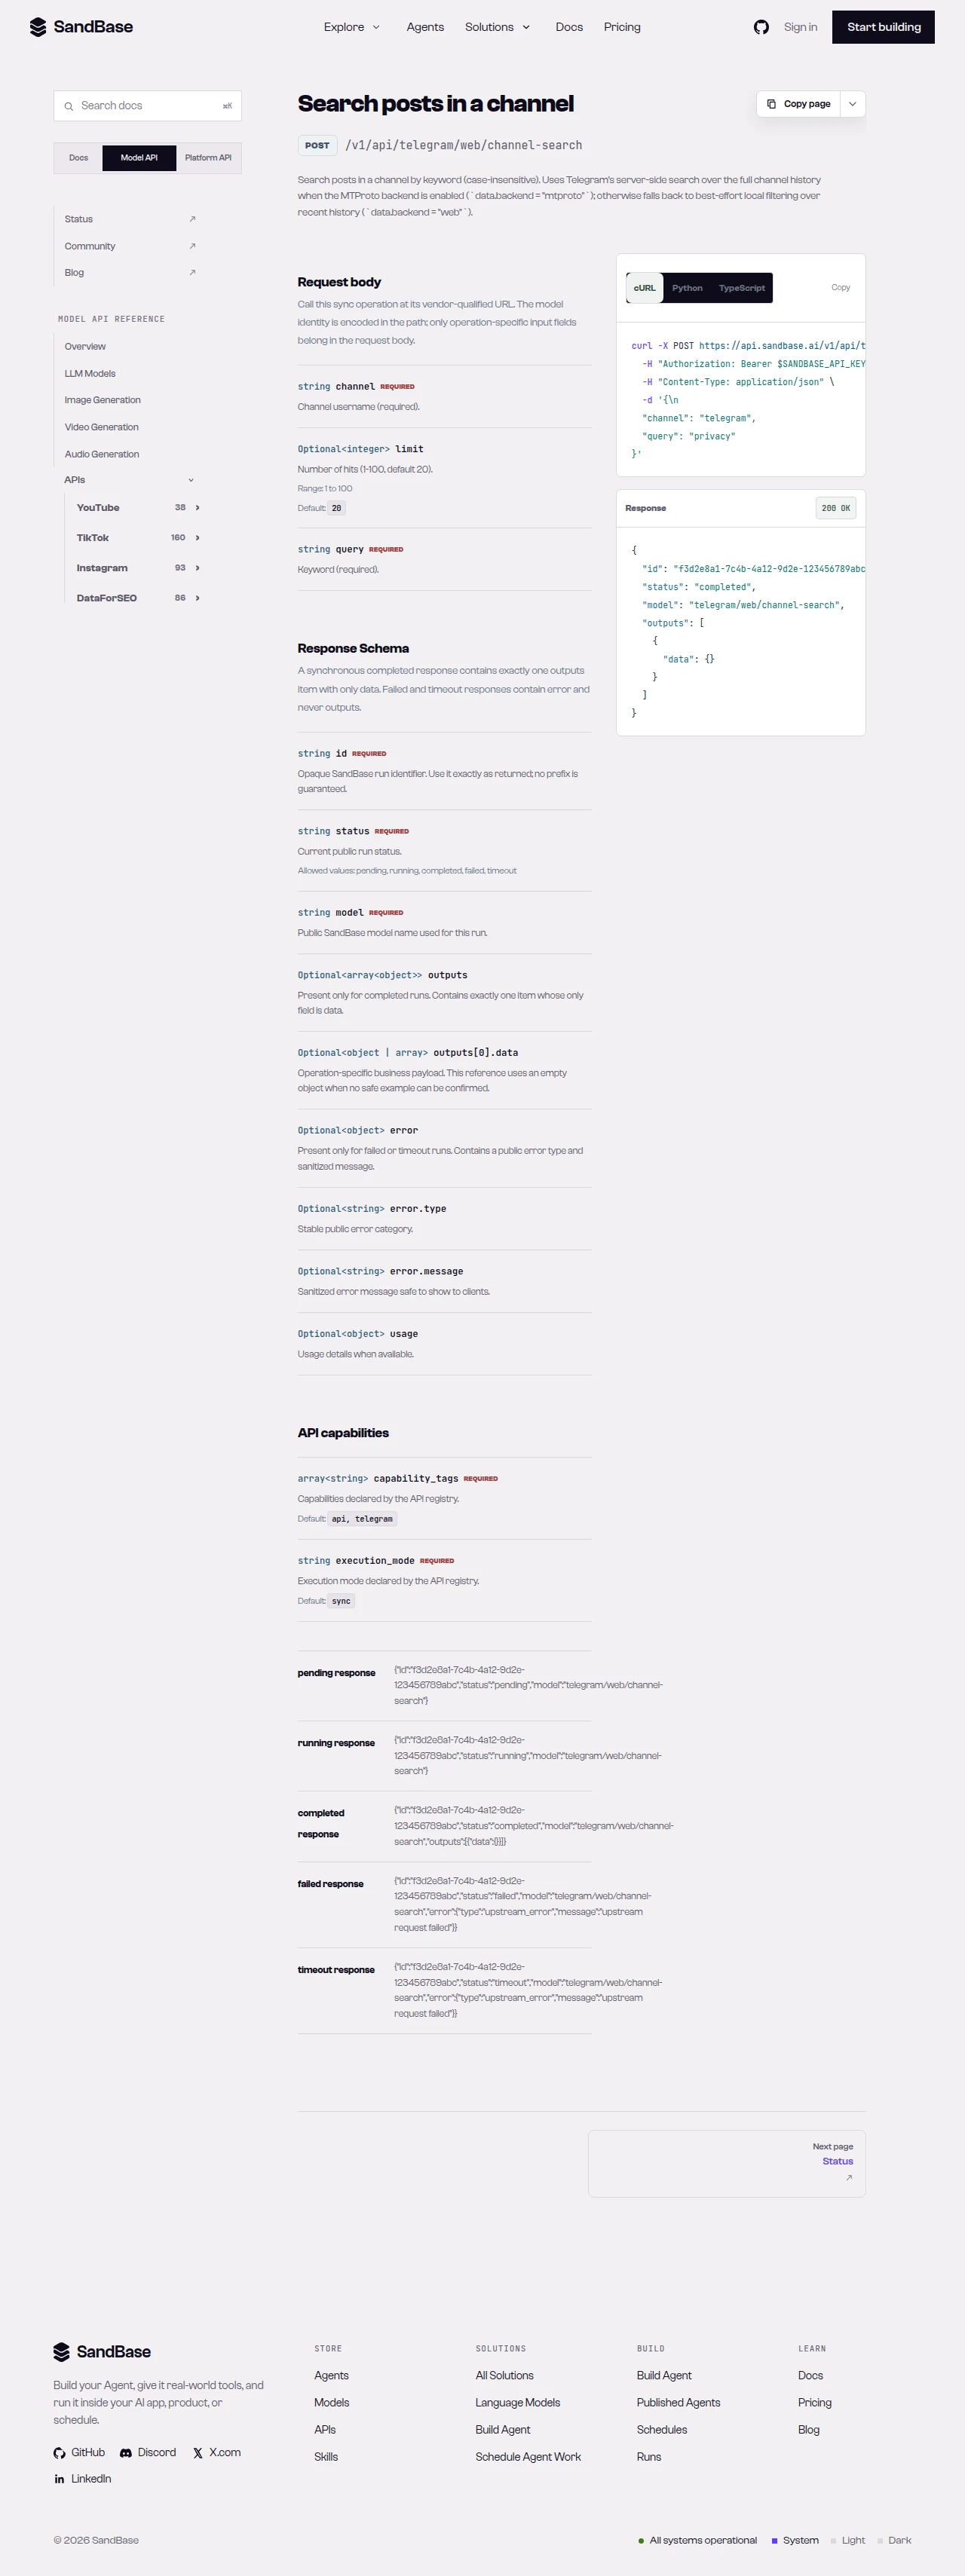 channel-search 接一个 channel 用户名和一个 query,返回匹配的消息。
第 3 步 —— 给匹配排序
原始匹配列表是按时间排的。做研究你通常想要传得最远的那些匹配,所以按每条消息带的传播信号(views,测试于 2026-09-27(UTC))排序,保留头部结果:
def rank_matches(matches: list[dict]) -> list[dict]:
    def views(m: dict):
        # 在实测响应里,views 是像 "1.48M" 这样的格式化字符串;
        # 取值会变,所以防御式解析,缺失时回退为 0。
        raw = m.get("views")
        if isinstance(raw, (int, float)):
            return raw
        if isinstance(raw, str):
            mult = {"K": 1_000, "M": 1_000_000}.get(raw[-1:], 1)
            try:
                return float(raw[:-1]) * mult if mult > 1 else float(raw)
            except ValueError:
                return 0
        return 0

    return sorted(matches, key=views, reverse=True)


for m in rank_matches(matches)[:10]:
    print(m.get("views"), "-", (m.get("text") or "")[:60])
因为传播字段可能是一个人类可读的格式化字符串,这个辅助函数防御式解析它,缺失时回退为 0——在依赖它之前,先以一份真实响应核对确切字段和格式。
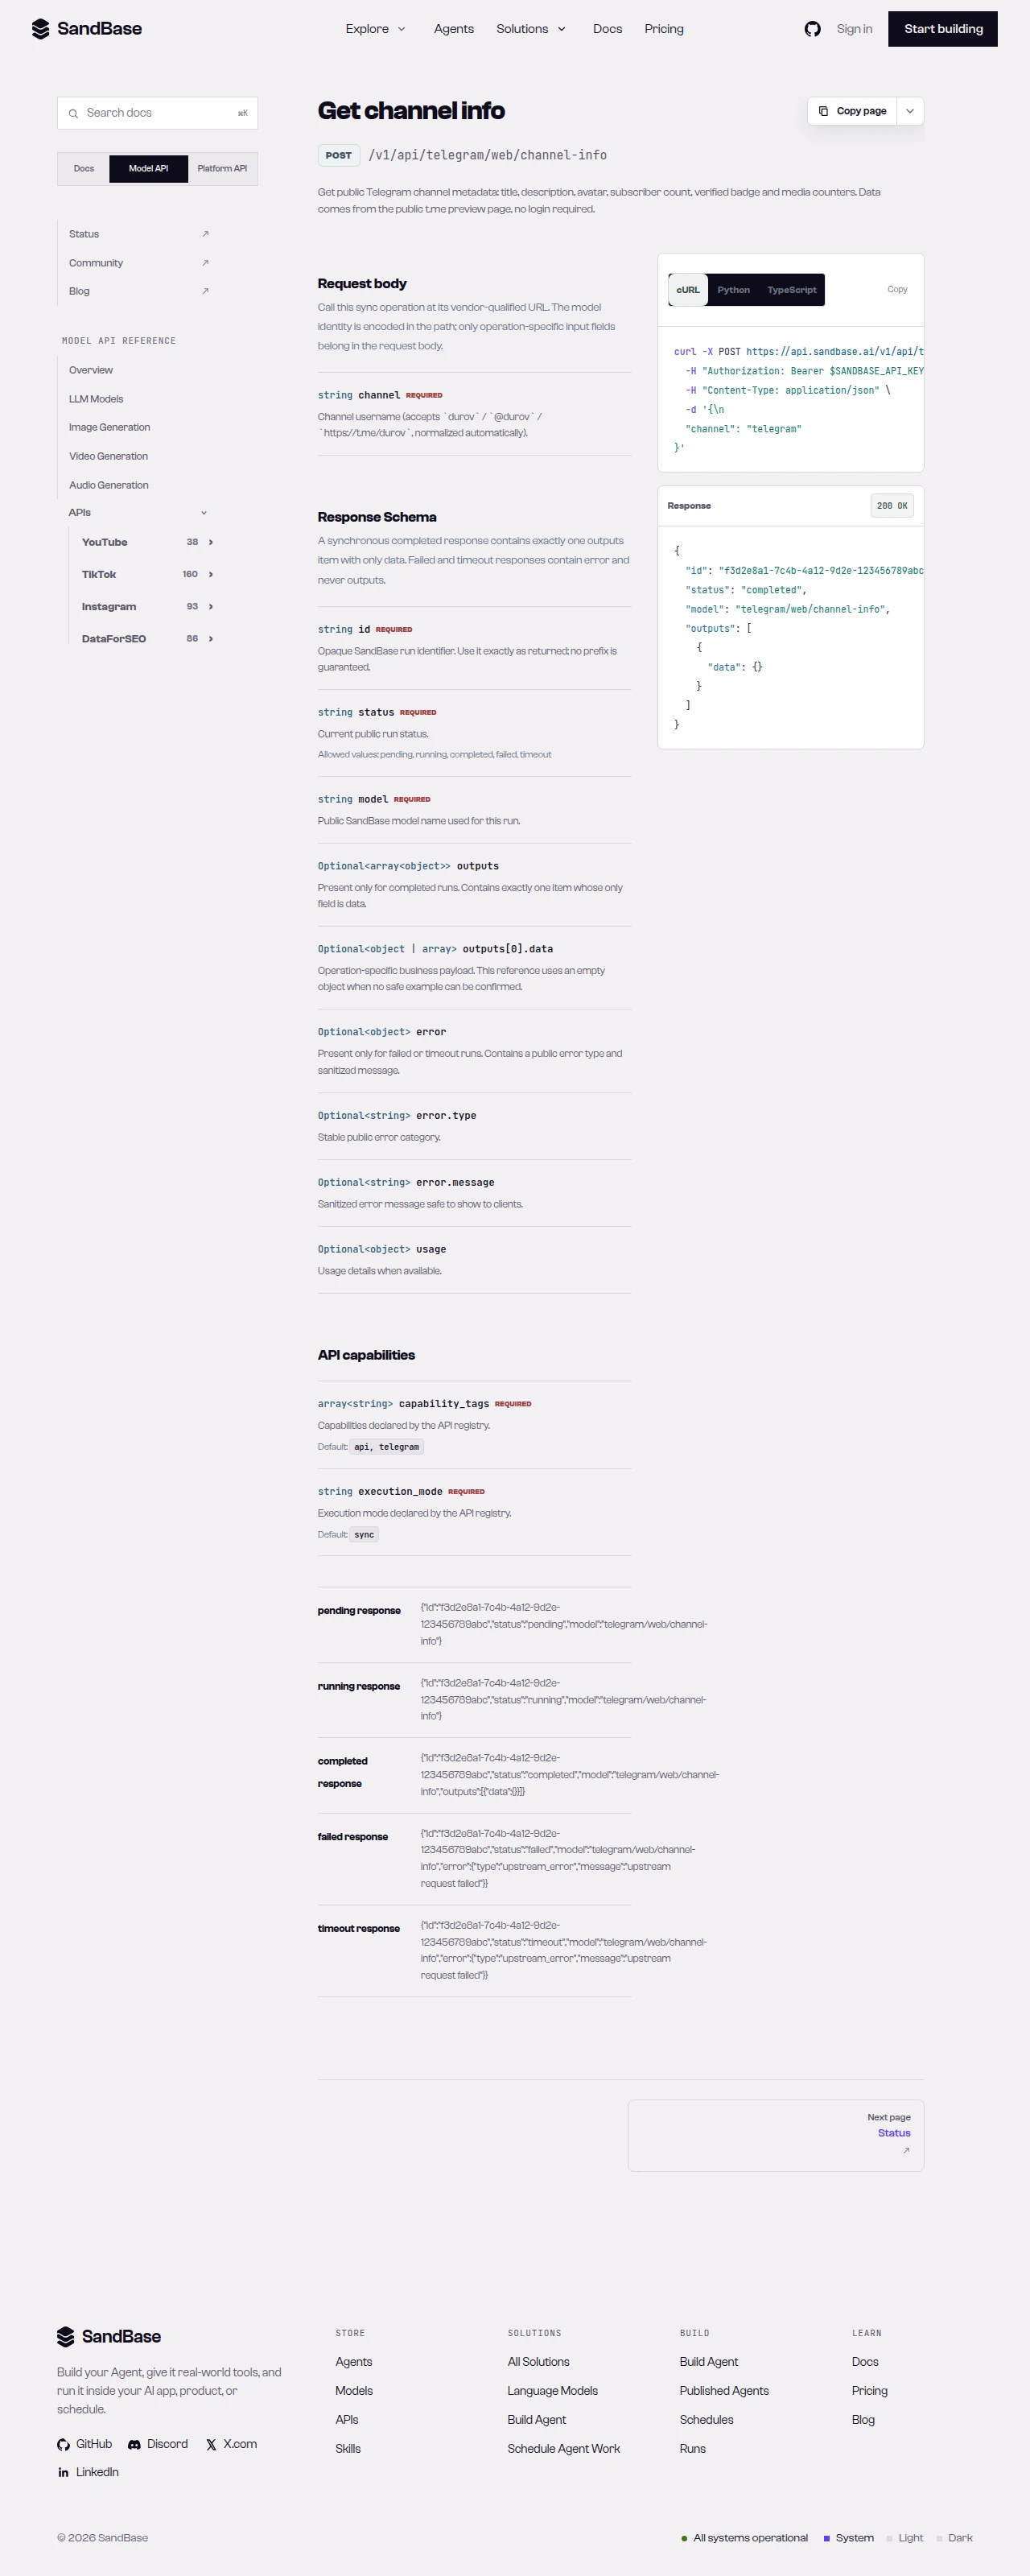 读每个端点的结构;字段名和格式可能因端点而异。
把它串起来
一次最小的频道搜索过程长这样——建一次基线、搜索、再排序:
CHANNEL = "telegram"
QUERY = "update"

info = call("web/channel-info", {"channel": CHANNEL})
matches = search_channel(CHANNEL, QUERY)
report = {
    "channel": info.get("title"),
    "subscribers": info.get("subscribers"),
    "query": QUERY,
    "match_count": len(matches),
    "top": [
        {"id": m.get("id"), "date": m.get("date"), "text": m.get("text")}
        for m in rank_matches(matches)[:10]
    ],
}
因为每次调用共用同一个信封和同一个 call 辅助函数,加重试或速率退避是一处改动的事。当你需要的不止这些读取时,查线上 Telegram 列表找到合适的端点,接入前先确认它的参数。
为什么在 API 层做这件事
你当然可以搭一个 MTProto 客户端自己搜一个频道,但那意味着要管一个会话、处理重连、维护一个解析器。通过一层统一 API 来读,意味着你的代码依赖的是有名字的 JSON 字段和单个响应信封。鉴权是一个密钥,而且因为 completed 运行都返回相同的 { id, status, model, outputs } 结构(failed/timeout 运行则带 error 而没有 outputs),重试、日志和错误处理都在一个你写一次、处处复用的辅助函数里。
这种一致性让工作流可组合。把频道换成任意一个公开频道、把 query 换成任意话题,代码路径完全一样。加一次对相关频道的 channel-info 读取来扩大覆盖,它也照样接在同一个辅助函数后面。你的时间花在”这些匹配对你的研究意味着什么”上,而不是花在维持一个协议客户端上。
局限与边界
- 仅公开、只读数据。 不发帖、不做机器人操作、不涉及私有或仅账号可见的数据。
- 频道内搜索。
channel-search在你指定的频道内搜索;它不是全局 Telegram 搜索。 - 参数与结构随上游面而定。
channel是用户名;query是你的关键词;传播字段可能是格式化字符串。先看一次真实响应、读一遍结构。 - 速率与量级。 把响应当作尽力而为的读取;遇到 HTTP 429 等瞬时错误时按退避策略重试,并控制请求节奏。
- 以线上参考核对。 可用性和字段可能变化;在依赖某个具体端点前先确认。
常见问题
我需要 Telegram 机器人 token 或登录吗?
不需要。你用自己的 SANDBASE_API_KEY 向 SandBase 鉴权。这套工作流读的是公开频道数据,不需要你这边有 Telegram 账号、机器人 token 或 MTProto 会话。
channel-search 是跨整个 Telegram 的全局搜索吗?
不是。它在你指定的 channel 内搜索。传频道用户名加你的 query;要覆盖多个频道,就每个频道各搜一次。
我能读私聊或群组吗? 不能。这套工作流只是公开频道数据。私聊、群组和账号授权内容不在范围内。
动手搭
创建一个 SandBase API 密钥,给一个频道建基线,再按关键词搜索它。准备好后: