今日头条作者研究 API 教程 | SandBase
从文章反查头条作者:用三个 SandBase 端点读取作者卡片、正文和评论样本。无需头条登录、无需 SDK,只需一个 SandBase API Key。
今日头条上发长文的,有新闻媒体,有政务和机构号,也有大量个人作者。做选题追踪、媒体监测或者找合作作者时,问题来来回回就那几个:这篇文章是谁写的?他有多少粉丝?这篇的阅读和互动怎么样?读者在评论区怎么说?
这篇教程就从”一组文章链接”出发,用三个 SandBase 端点把这些问题一次答完,整个流程可以直接交给 Agent 跑。如果你还没看过整体的端点地图,建议先读今日头条公开数据 API 总览。
这里读的都是公开、只读数据。不需要头条账号,也不需要 SDK,只要一个 SandBase API Key 做鉴权。头条这几个端点在 SandBase 上可以免费调用,目录页的状态就标着 Free。
参数和响应信封以端点 API 参考为准。参考只保证信封结构(id/status/model/outputs[0].data),下文出现的业务字段名都来自我自己跑的调用(测试于 2026-10-01,UTC),属于实测观察,不是文档保证。上线前请用真实响应再核对一遍。
先说结论
- 起点是文章链接,里面那串数字
group_id就是唯一需要的输入。toutiao/app/article-info返回作者卡片(昵称、user_id、粉丝数、认证状态),以及这篇文章的阅读、点赞、评论数。toutiao/web/article-info补上标题、发布时间和正文 HTML;toutiao/app/comments按offset翻页抽样评论。- 最后按作者
user_id归并,得到每个作者一条研究记录。只读公开数据。
为什么从文章入手,而不是作者主页
总览里列了 toutiao/app/user-info,最直观的做法是拿到 user_id 再查作者资料。我一开始也是这么做的,结果不太理想。
我测的是一家新闻媒体,它的文章卡片上显示粉丝约 558 万。但 user-info 返回的记录里 name 是空的,粉丝数只有 49。看字段内容,这条记录指向的是关联的短视频账号,不是头条媒体号本身。我没法确定这是上游接口的特性,还是这几个账号的个别情况,但这样的数据确实没法拿来做研究。
反过来,文章详情里自带的作者卡片是完整的,我测的两篇在线文章都是这样。所以这篇教程从文章里读作者。这也符合实际工作的顺序:你手上通常先有文章,可能来自监测任务、阅读清单或者别人转来的链接,然后才想知道作者是谁。
| 你的需求 | 用什么 |
|---|---|
| 做研究用的公开作者、文章、评论数据 | SandBase 头条公开数据 API |
| 发文、管理账号、授权数据合作 | 头条官方渠道 |
| 私密或仅账号可见的数据 | 两条路都不适用 |
流程一览
- 从文章链接(
https://www.toutiao.com/article/<group_id>/)里解析出group_id。 - 用
toutiao/app/article-info(参数group_id)读作者卡片和互动数据。 - 用
toutiao/web/article-info读标题、发布时间和正文。注意,这个接口把同一个 id 叫作aweme_id。 - 用
toutiao/app/comments(参数group_id、offset)抽样评论。 - 按作者
user_id归并,每个作者一条记录。
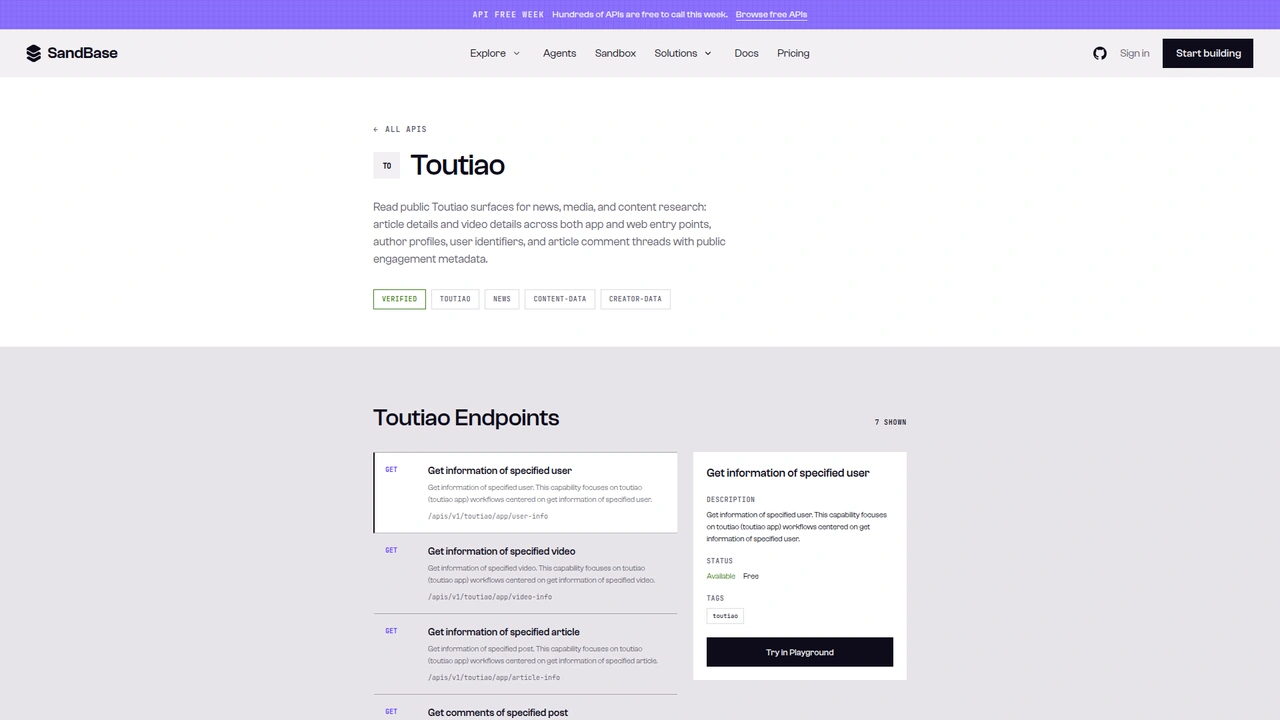 SandBase 上的今日头条目录页:7 个端点以
GET /apis/v1/toutiao/... 形式列出,选中端点状态为 Available、Free。本教程调用的是 Model API 的 POST /v1/api/toutiao/... 路由。
写代码前先说清楚接口面的区别。目录页展示的是 GET /apis/v1/toutiao/<path>;本文用的是端点参考里的 Model API,即 POST /v1/api/toutiao/<path> 加 JSON 请求体。两者别混用,复制示例时请保留 POST 方法和 /v1/api/ 前缀。
第 0 步:一个通用调用函数
import os
import re
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call(path: str, payload: dict) -> dict:
    resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=70)
    resp.raise_for_status()
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error", {}).get("message", f"{path} did not complete"))
    # 文档结构是 outputs[0].data;同时兼容顶层 `output`。
    output = body.get("output")
    if output is None and body.get("outputs"):
        output = body["outputs"][0].get("data", {})
    return output or {}

def group_id_from_url(url: str) -> str:
    m = re.search(r"/(?:article|group)/(\d+)", url)
    if not m:
        raise ValueError(f"no article id in {url}")
    return m.group(1)
参考文档写的完成态结构是 outputs[0].data,这次测试里头条的每次调用也都是这个结构。函数里顺带兼容了顶层 output,因为我在 SandBase 其他平台的端点上见过这种返回;你要是想严格解析,把这段兜底删掉即可。
另外,两个文章接口在 outputs[0].data 里还会再包一层 data,旁边是 message;评论接口里这层 data 直接就是评论列表,has_more、offset、total_number 和它并列。所以下面几步都会再取一次 .get("data")。
第 1 步:读作者卡片和互动数据
def read_author_card(group_id: str) -> dict | None:
    data = call("toutiao/app/article-info", {"group_id": group_id}).get("data", {})
    if data.get("delete") or not data.get("user_info"):
        return None  # 文章已删除或不可用
    user = data["user_info"]
    return {
        "group_id": group_id,
        "author_id": str(user.get("user_id", "")),
        "author_name": user.get("name"),
        "followers": user.get("fans_count"),
        "verified": user.get("user_verified"),
        "reads": data.get("read_count"),
        "likes": data.get("digg_count"),
        "comments": data.get("comment_count"),
    }
我用一篇闪电新闻(山东广播电视台的新闻客户端)的公开文章做了测试,它也是参考文档里的示例 id。run id 是 7ce8965e-01c0-4577-8f27-195eacffe3d3,时间是 2026-10-01 UTC。下面是 outputs[0].data 的节选:
{
  "data": {
    "group_id": 7450114952884503059,
    "read_count": 95,
    "digg_count": 2,
    "comment_count": 1,
    "repin_count": 1,
    "user_info": {
      "name": "闪电新闻",
      "user_id": 51050126444,
      "media_id": 51201073347,
      "fans_count": 5582263,
      "user_verified": true,
      "user_auth_info": "{\"auth_info\":\"闪电新闻官方账号\",\"auth_type\":\"5\"}"
    }
  },
  "message": "success"
}
我又测了一篇新华网的文章(run id a4b82d62-f916-4e48-a6fc-5133965ebd5f),结构一样:作者卡片显示粉丝约 2,937 万,文章阅读约 2.6 万。有两个细节要处理:
user_id返回的是数字。拿它当字典的键之前,先转成字符串。user_auth_info是一段 JSON 字符串,不是对象。想要认证文案的话,用json.loads解析一下。
已删除的文章表现不一样。我试过一个 id(就是评论接口参考里的示例),返回的是 "delete": 1,完全没有 user_info。上面代码里的 None 分支就是为这种情况准备的,避免读空字段时报错。
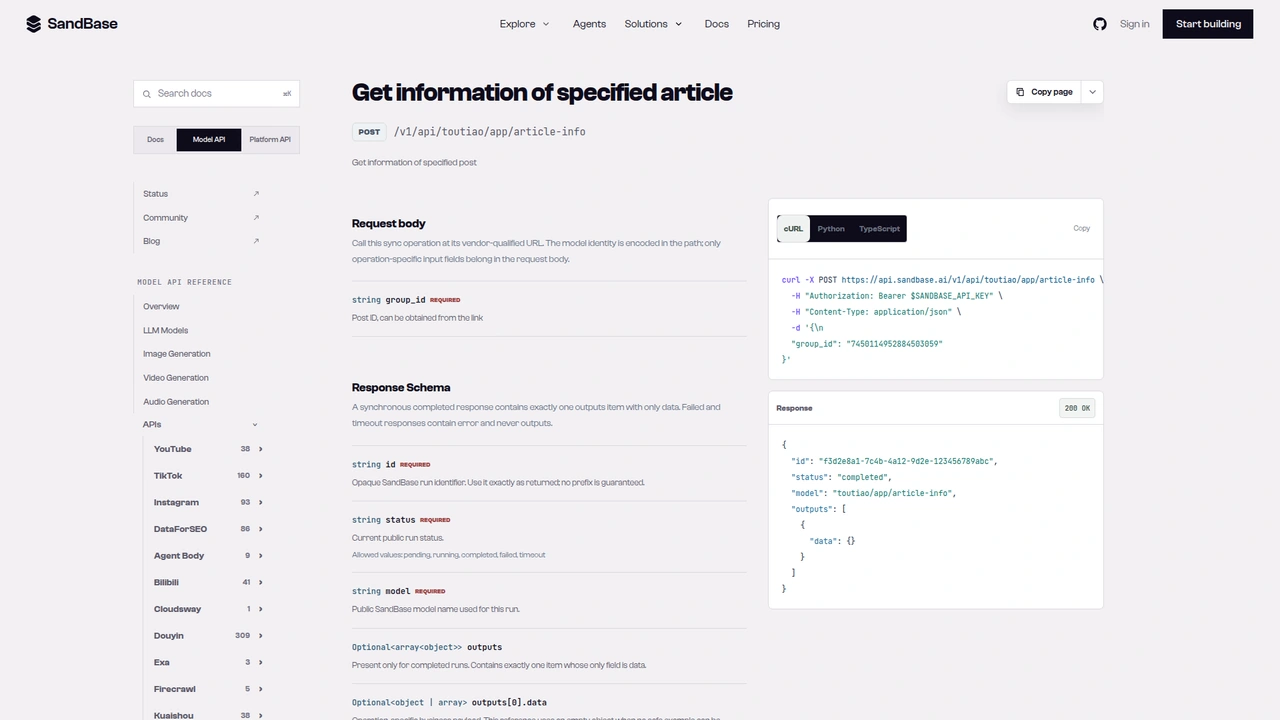
toutiao/app/article-info 参考页:POST /v1/api/toutiao/app/article-info,必填 group_id。文档里的响应示例中,outputs[0].data 是空对象。
第 2 步:读标题、发布时间和正文
我调 app 版文章接口时,返回里没有顶层的标题或发布时间字段,标题只出现在 share_info 里。web 版接口正好补上这块:
def read_article_text(group_id: str) -> dict:
    data = call("toutiao/web/article-info", {"aweme_id": group_id}).get("data", {})
    extra = data.get("h5_extra", {}) or {}
    text = re.sub(r"<[^>]+>", " ", data.get("content", "") or "")
    return {
        "title": extra.get("title"),
        "published": extra.get("publish_time"),
        "text": " ".join(text.split())[:2000],
    }
这个接口的参数名叫 aweme_id,但传的就是同一个头条文章 id。我第一次顺手传了 group_id,直接收到 400,报错信息是 missing properties: 'aweme_id'。
在我记录的这次调用里(19d6214f-a69e-448f-bdff-b0f62ba2c88f),返回内容有:
content:文章 HTMLmedia_user_idh5_extra对象:里面有title、publish_time(例如2024-12-19 21:31)、publish_stamp和source
这些都是实测观察到的字段。其中 media_user_id 和第 1 步拿到的 user_id 一致,可以用来交叉核对两次调用说的是同一个作者。
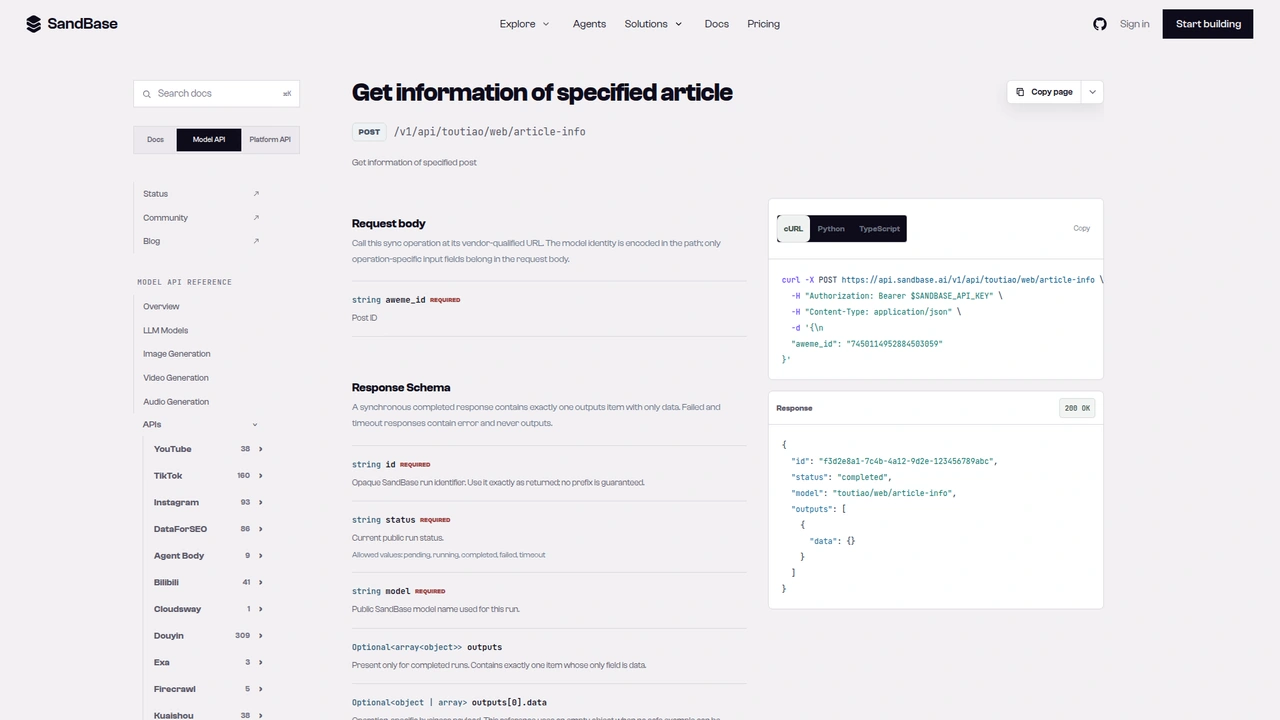
toutiao/web/article-info 参考页:同一个文章 id 填在必填字段 aweme_id 里。
第 3 步:抽样读者评论
def sample_comments(group_id: str, max_pages: int = 3) -> list[dict]:
    offset, comments = "0", []
    for _ in range(max_pages):
        page = call("toutiao/app/comments", {"group_id": group_id, "offset": offset})
        for cell in page.get("data", []) or []:
            c = cell.get("comment", {}) if isinstance(cell, dict) else {}
            if c.get("text"):
                comments.append({"text": c["text"], "likes": c.get("digg_count")})
        if not page.get("has_more"):
            break
        offset = str(page.get("offset"))
return comments参考文档里说,offset 是字符串,从 "0" 开始,每次加 20。实测和文档一致。我拿一条有 1,076 条评论的帖子试了两页:
- 第一页(run
c61a4cd6-8502-44dc-a344-61a88bbe5b8e):返回 20 条评论,has_more: true,offset: 20。 - 第二页(run
0e4c824c-d42c-4d36-9758-fc296c089d61):offset变成 40。
所以直接把上一页返回的 offset 传回去就行,比自己算省事,has_more 变成 false 时循环会自然停下。每条评论里观察到的字段有 text、digg_count、reply_count、create_time。
评论里还带着评论者的昵称和 id。做作者研究,一般只需要评论文本和点赞数,所以函数只保留了这两项,这样也能少存个人信息。
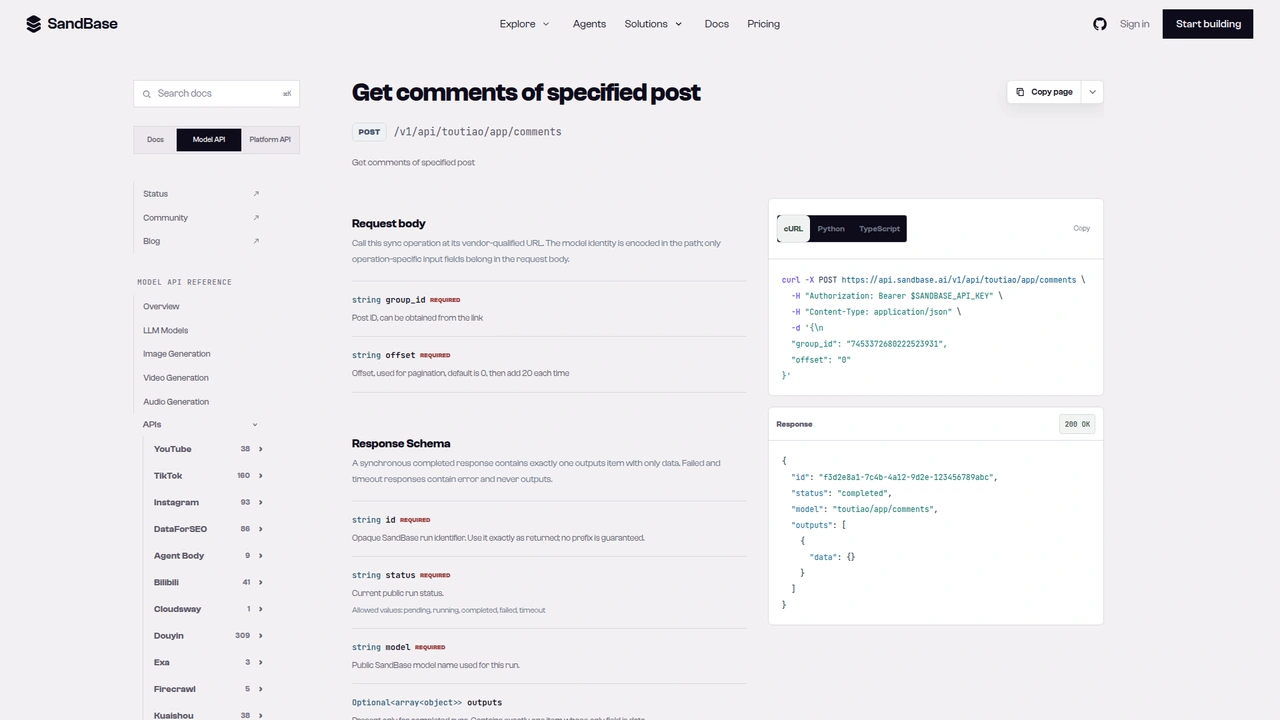
toutiao/app/comments 参考页:group_id 和 offset 都必填,offset 从 0 开始,每次加 20。
串起来:每个作者一条记录
def research_authors(urls: list[str]) -> dict:
    authors: dict[str, dict] = {}
    for url in urls:
        gid = group_id_from_url(url)
        card = read_author_card(gid)
        if card is None:
            print("skipped (deleted/unavailable):", gid)
            continue
        article = {**card, **read_article_text(gid), "comment_sample": sample_comments(gid, 1)}
        entry = authors.setdefault(card["author_id"], {
            "name": card["author_name"],
            "followers": card["followers"],
            "verified": card["verified"],
            "articles": [],
        })
        entry["articles"].append(article)
    return authors
我用三条链接跑了一遍:闪电新闻那篇、新华网那篇,再加上那个已删除的 id。结果是两条作者记录,已删除的 id 被打印为跳过。
每条记录包含一份作者卡片,加上你喂进去的每篇文章:互动数据、标题、正文摘录和一页评论。这个结构很适合直接交给模型处理,比如让它总结每个作者的报道领域、横向比较不同作者的单篇阅读量,或者挑出评论区情绪明显偏离的文章。
每篇文章需要三次调用,评论每多翻一页再加一次。如果要处理几百条链接,建议顺序执行或者只开少量并发,并按 group_id 缓存作者卡片,重跑时就不用再抓一遍。
文档保证 vs. 实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/toutiao/app/article-info,参数 group_id | 参考文档已列明 |
POST /v1/api/toutiao/web/article-info,参数 aweme_id | 参考文档已列明 |
POST /v1/api/toutiao/app/comments,参数 group_id + offset(从 0 起,步长 20) | 参考文档已列明 |
信封 id / status / model / outputs[0].data | 参考文档已列明 |
data.user_info(name、user_id、fans_count、user_verified) | 仅实测观察 |
read_count、digg_count、comment_count、delete | 仅实测观察 |
h5_extra.title、h5_extra.publish_time、content、media_user_id | 仅实测观察 |
评论 has_more、offset、total_number、comment.text | 仅实测观察 |
常见用法
媒体与账号监测
把监测任务按话题抓到的文章丢进来,按作者归并,就能看出哪些媒体和账号在持续报道这个话题,以及它们的受众规模。
- 输入:文章链接
- 输出:按作者归并的记录
- 端点:
app/article-info、web/article-info
作者筛选
做品牌合作或 PR 投放时,用粉丝数、认证状态和近期文章的阅读量来比较候选作者。
- 输入:每位作者的几篇文章
- 输出:排好序的作者名单
- 端点:
app/article-info
读者反馈检查
抽取作者近期文章的前几页评论,让模型总结反复出现的观点或质疑。
- 输入:
group_id列表 - 输出:评论样本
- 端点:
app/comments
领域地图
用 web/article-info 拿到的正文给每篇文章打话题标签,再看哪些作者主要写哪些领域。
- 输入:文章链接
- 输出:作者 × 话题表
- 端点:
web/article-info
实用提示
- 一个 id,两个名字。
app/article-info和app/comments用group_id,web/article-info用aweme_id,传的都是链接里的那串数字。 - 准备好处理已删除文章。 读作者之前,先检查有没有
delete字段、user_info是否存在。 - 统一字段类型。
user_id返回的是数字,user_auth_info是 JSON 字符串,入库前先转换和解析。 - 评论翻页用返回的
offset。has_more为 false 时停止。 - 业务字段属于实测观察。 正式依赖之前,先用真实响应确认。
- 只读公开数据。 不发文,不碰私密或仅账号可见的数据。
- 对偶发失败做重试。 我有一次调用在 TLS 层断开,重试后就成功了。建议给调用加一个带退避的短重试。
常见问题
需要头条账号或者登录吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权就行,这几个只读端点不需要你这边有头条账号,也不用走 OAuth。
收费吗? 头条这几个端点目前在 SandBase 目录里标的是 Free,以目录页当前状态为准。
为什么不直接调 user-info 查作者?
在我的测试里,它返回的记录字段很少,而且和文章上显示的作者对不上。app/article-info 里的作者卡片是完整的,所以本文改用它。
group_id 从哪里来?
就在文章链接里:toutiao.com/article/<group_id>/ 中间那串数字。
怎么拿到更多评论?
把上一页返回的 offset 传回去,只要 has_more 还是 true 就继续翻。
小结
在头条上研究一个作者,有一条文章链接就够了:第一次调用拿到作者卡片和互动数据,第二次拿到标题和正文,第三次抽样读者评论。再按 user_id 归并,就得到可以交给 Agent 排序和总结的作者记录。
其他头条端点的用法,可以看今日头条公开数据 API 总览。准备好了就可以开始: