MiniMax M3.1 Flash 怎么用?API 价格、思考档位与限制实测
MiniMax M3.1 Flash 详解:$0.15/$0.60 定价、1M 上下文、思考无法关闭、五档 effort 实测的 token 差异,以及官方跑分里它强在哪、弱在哪。
我们给 MiniMax M3.1 Flash 写测试脚本时,第一个报错不是模型答错了,而是一个老习惯:想省钱就传 reasoning_effort: "none"。M3.1 Flash 直接返回 HTTP 400。它的思考是关不掉的,你能调的只有”想多少”。
MiniMax M3.1 Flash 是 MiniMax 在 2026 年 10 月 19 日发布的 M3 系列低价档,面向编程、工具调用和 Agent 工作流,输出文本,上下文 1M token,价格统一为每百万输入 $0.15、输出 $0.60。这篇文章写给正在考虑把 Agent 或编程流量切过去的开发者:哪些信息是 MiniMax 官方确认的,哪些只是媒体转述,五档 effort 在我们 10 月 21 日的实际调用里表现如何,以及它在哪些场景比价格看起来更弱。
MiniMax M3.1 Flash,先说结论
- 官方价格:输入 $0.15、输出 $0.60、缓存命中 $0.015(每百万 token),没有长上下文阶梯价,正好是 M3 当前(已打折)价格的一半。
- 思考无法关闭。effort 可选
low、medium、high、xhigh、max,不传就默认max。 - 我们通过 SandBase 跑了 18 次同一道修 bug 题,各档全部通过单测。
low的输出是 93–132 个 token,max则从 233 到 1,605 不等。 - 官方跑分表里,它在 Automation-Bench v1.0.6 上排第一(62.2),但 Terminal Bench 4.0 明显落后 Opus 5(38.1 对 51.8)。这些全是厂商自报数据。
- 官方说权重”稍后发布”。截至 10 月 21 日,Hugging Face 的 MiniMaxAI 账号下还没有 M3.1 Flash 仓库,许可证也没公布。
MiniMax 到底发布了什么
MiniMax 的发布博文讲定位多,讲架构少。核心说法有三条:Agent、编程、Computer Use 和网络安全能力全面提升;线上推理速度提升近 3 倍;Agent 任务整体使用成本比上一代低 70%。博文还确认,之前匿名跑了 200 万亿以上 token 的 Space Bunny,就是 M3.1 Flash 的早期版本。
真正能拿来写代码的信息在模型调用文档里:型号 MiniMax-M3.1-Flash,上下文 1,000,000 token,官方描述是”面向日常工作的超高效开放权重模型”。effort 参数和”思考无法关闭”也写在这一页。
有些流传很广的参数,我们没能在 MiniMax 当前页面上找到原文。SiliconANGLE 写的是总参数 428B,说规模和 M3 相比”几乎没变”;激活约 23B 和 10 月 23 日发布权重这两条,来自 MarkTechPost。这两条都只能算”媒体报道”。官方博文原话只是权重会”稍后发布”,另外更大的 Pro 版本也在路上。
| 项目 | 2026-10-21 状态 | 来源 |
|---|---|---|
| 发布日期 | 2026 年 10 月 19 日 | MiniMax 发布博文 |
| API 型号 | MiniMax-M3.1-Flash | MiniMax 调用文档 |
| 上下文 | 1,000,000 token | MiniMax 调用文档 |
| 输出 | 文本,思考内容单独返回 | MiniMax 调用文档 |
| 图片输入 | 支持,我们实测过 | SandBase 模型页、我们的调用 |
| 视频输入 | 媒体报道支持,我们没测 | SiliconANGLE、MarkTechPost |
| 参数量 | 总 428B(报道);激活约 23B(报道) | SiliconANGLE;MarkTechPost |
| 权重与许可证 | ”稍后”;许可证未公布 | MiniMax 博文、Hugging Face 检查 |
| 调用入口 | MiniMax API、M Plan、MiniMax Code;SandBase 也可调用 | MiniMax 博文、SandBase 模型页 |
在 SandBase 上,它的型号是 minimax/minimax-m3.1-flash,走 OpenAI 兼容的 Chat Completions 接口,页面标注最大输出 512K,支持视觉、推理、函数调用和结构化输出。这是 SandBase 路由到 MiniMax 的模型,不是 SandBase 自己部署的版本。
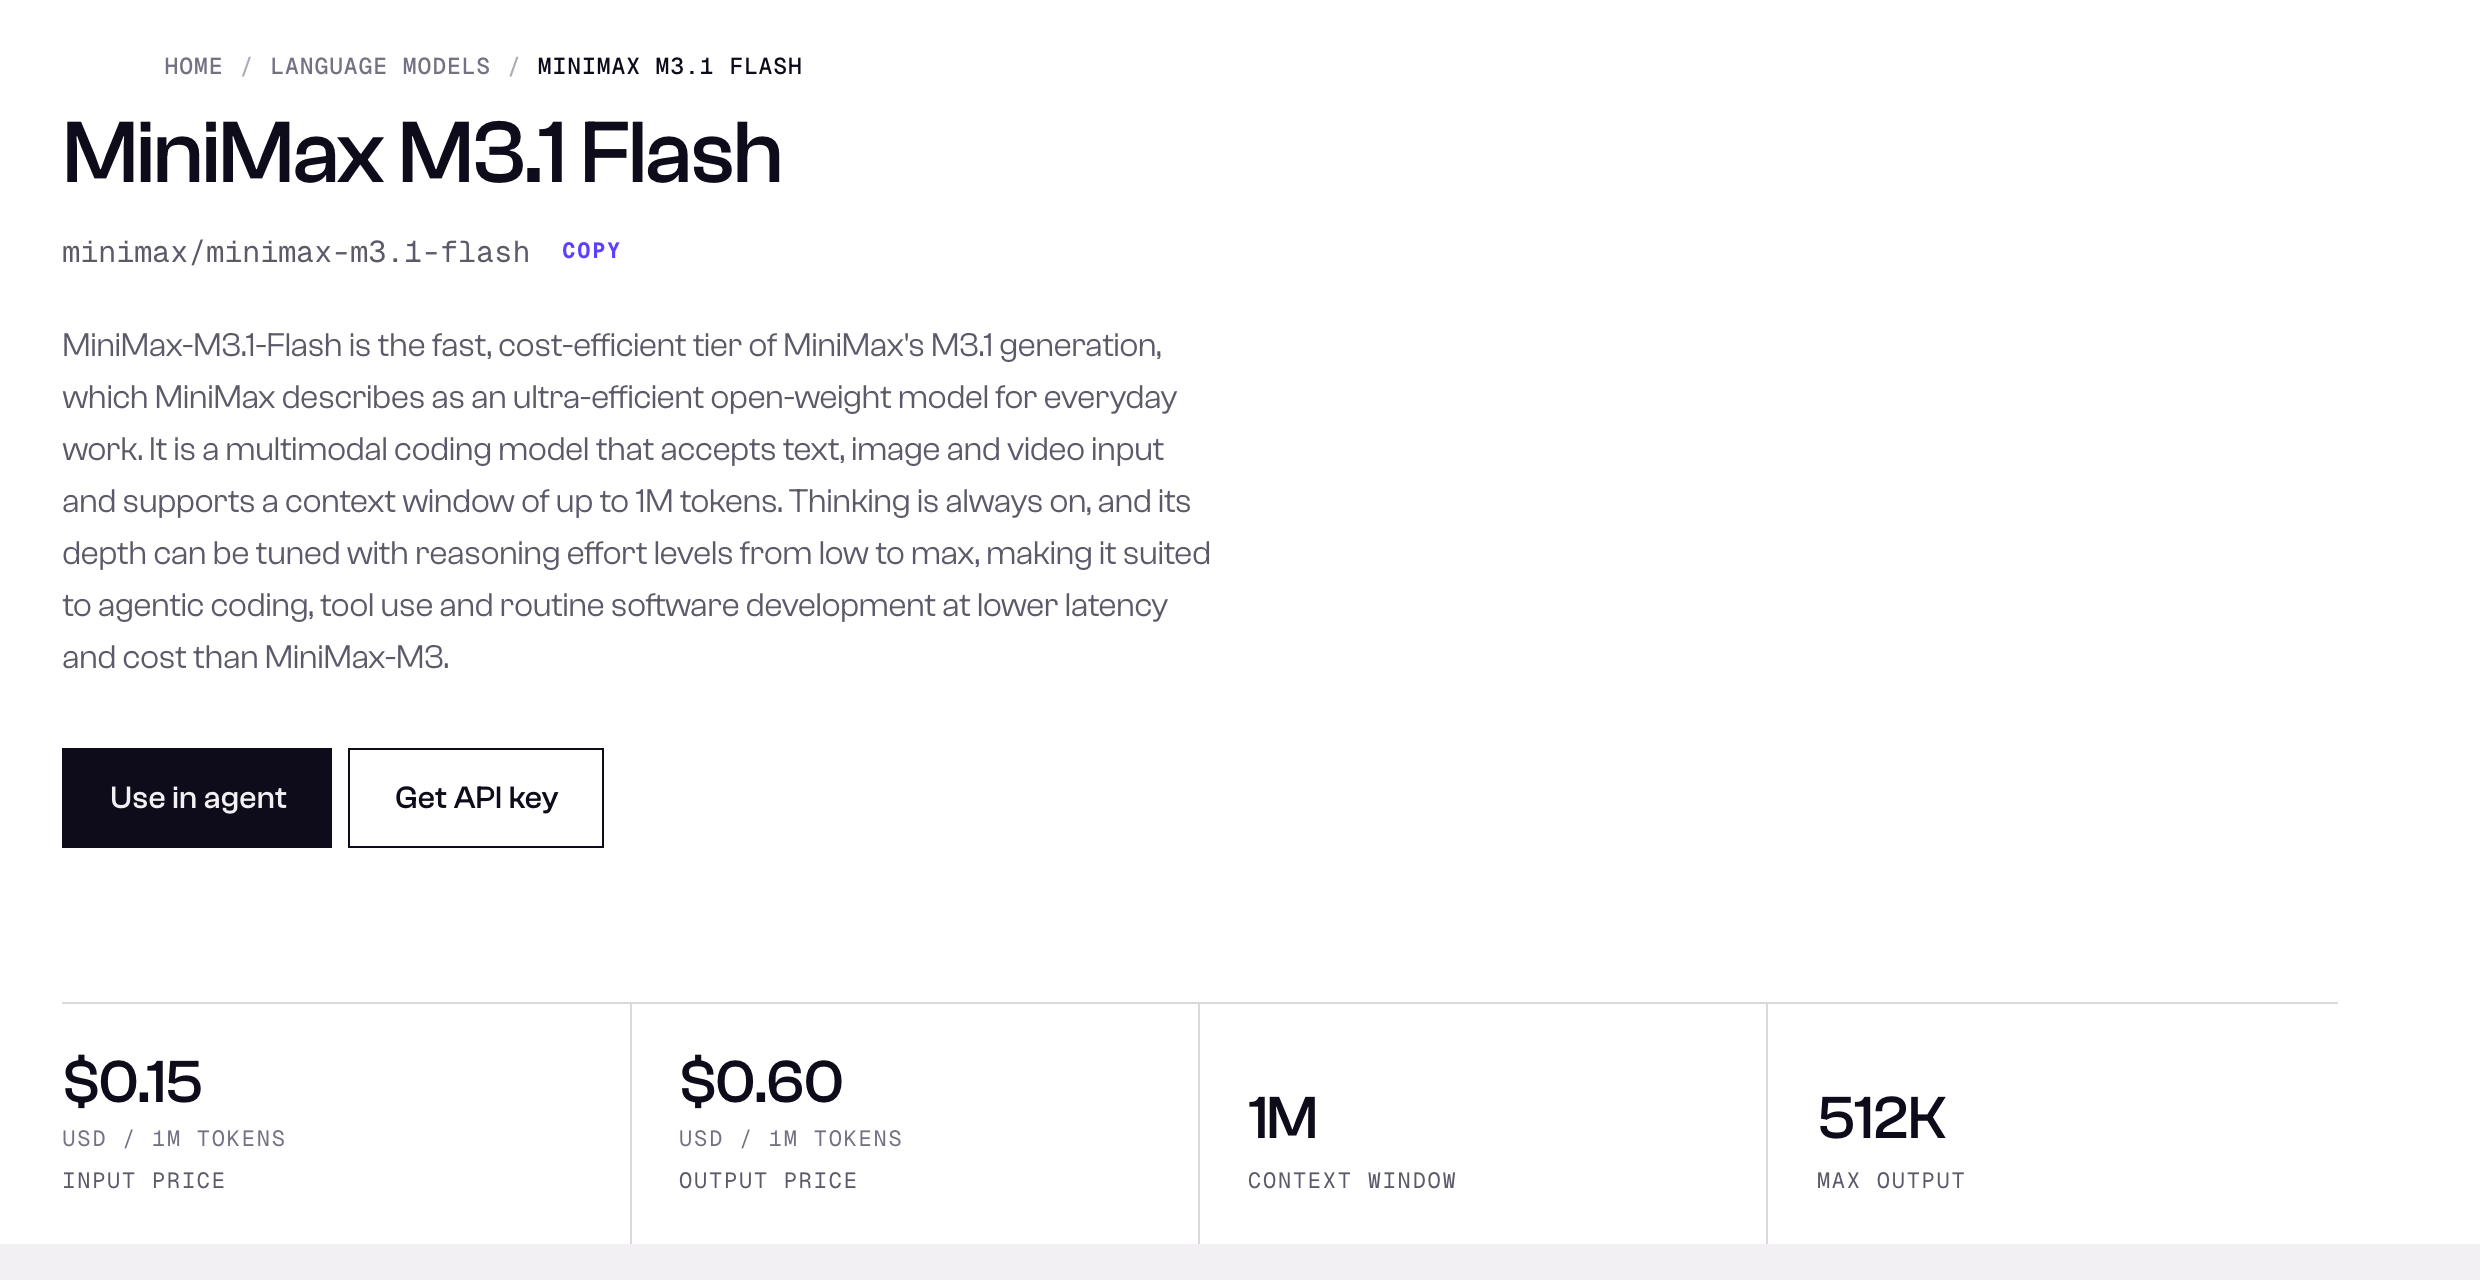 SandBase 模型页
minimax/minimax-m3.1-flash,2026-10-21 截图:输入输出价格与 MiniMax 官方一致,上下文 1M,最大输出 512K。
这里有个小矛盾要先说清楚:SandBase 的模型描述写了”文本、图片和视频输入”,但同一页的规格表只列了文本和图片。我们只验证了图片。如果你的场景依赖视频理解,先在自己的线路上测一遍再说。
思考关不掉,只能调档
这是老代码最容易踩的坑。MiniMax 文档写得很直白:思考无法关闭,传 thinking: {"type": "disabled"} 或 effort: "none" 都会返回 400。在 OpenAI 兼容协议下,思考过程放在 reasoning_content,答案放在 content,不用再从 <think> 标签里往外抠。
不同协议下 effort 的字段名不一样:
| 协议 | effort 字段 | 思考内容返回位置 |
|---|---|---|
| Anthropic 兼容(官方推荐) | output_config.effort | thinking 内容块 |
| OpenAI Chat Completions | reasoning_effort | reasoning_content 字段 |
| OpenAI Responses | reasoning.effort | type: "reasoning" 输出项 |
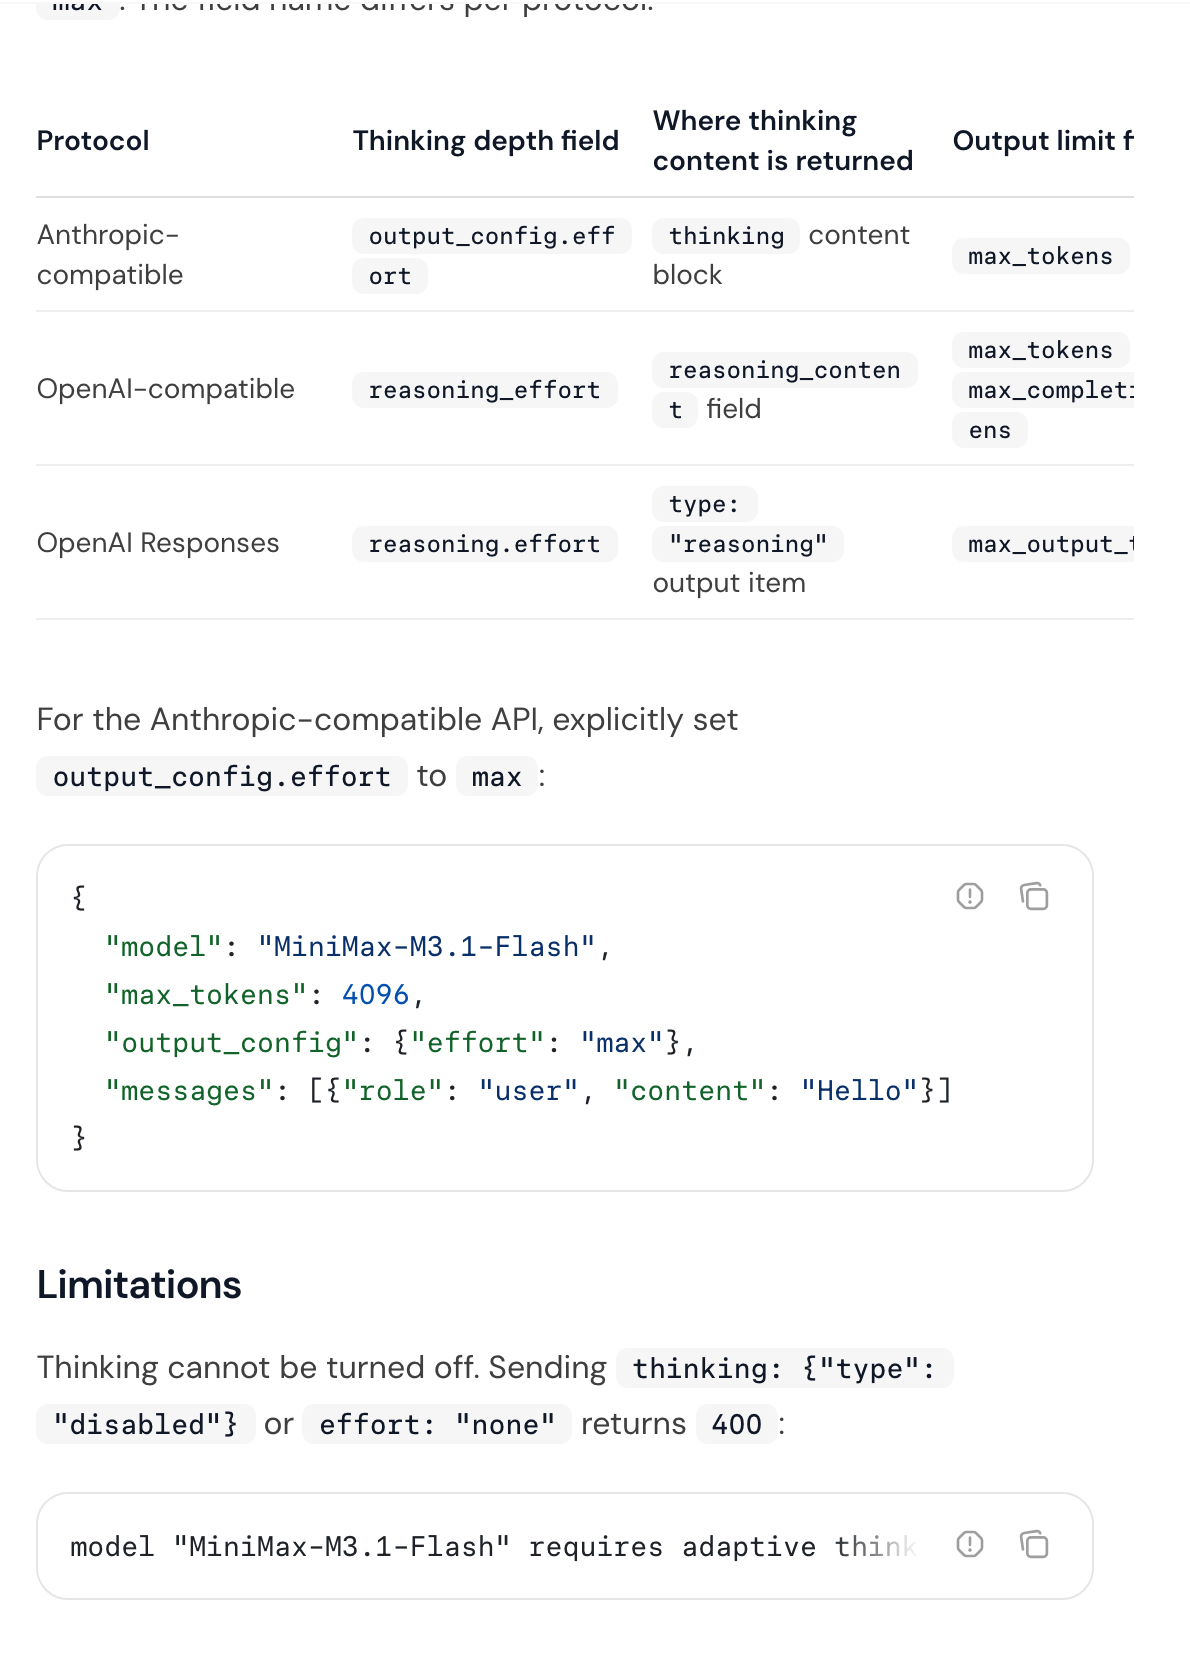 MiniMax 调用文档,2026-10-21 截图:各协议的 effort 字段,以及 Limitations 里”关闭思考会返回 400”的说明。
“档位越低 token 越少”谁都猜得到,但它说明不了每一档的波动有多大。所以我们 10 月 21 日通过 SandBase,拿同一道题(一个有越界 bug 的 median() 函数)在每一档各跑 3 次,返回的代码都用 4 个单测自动判分。
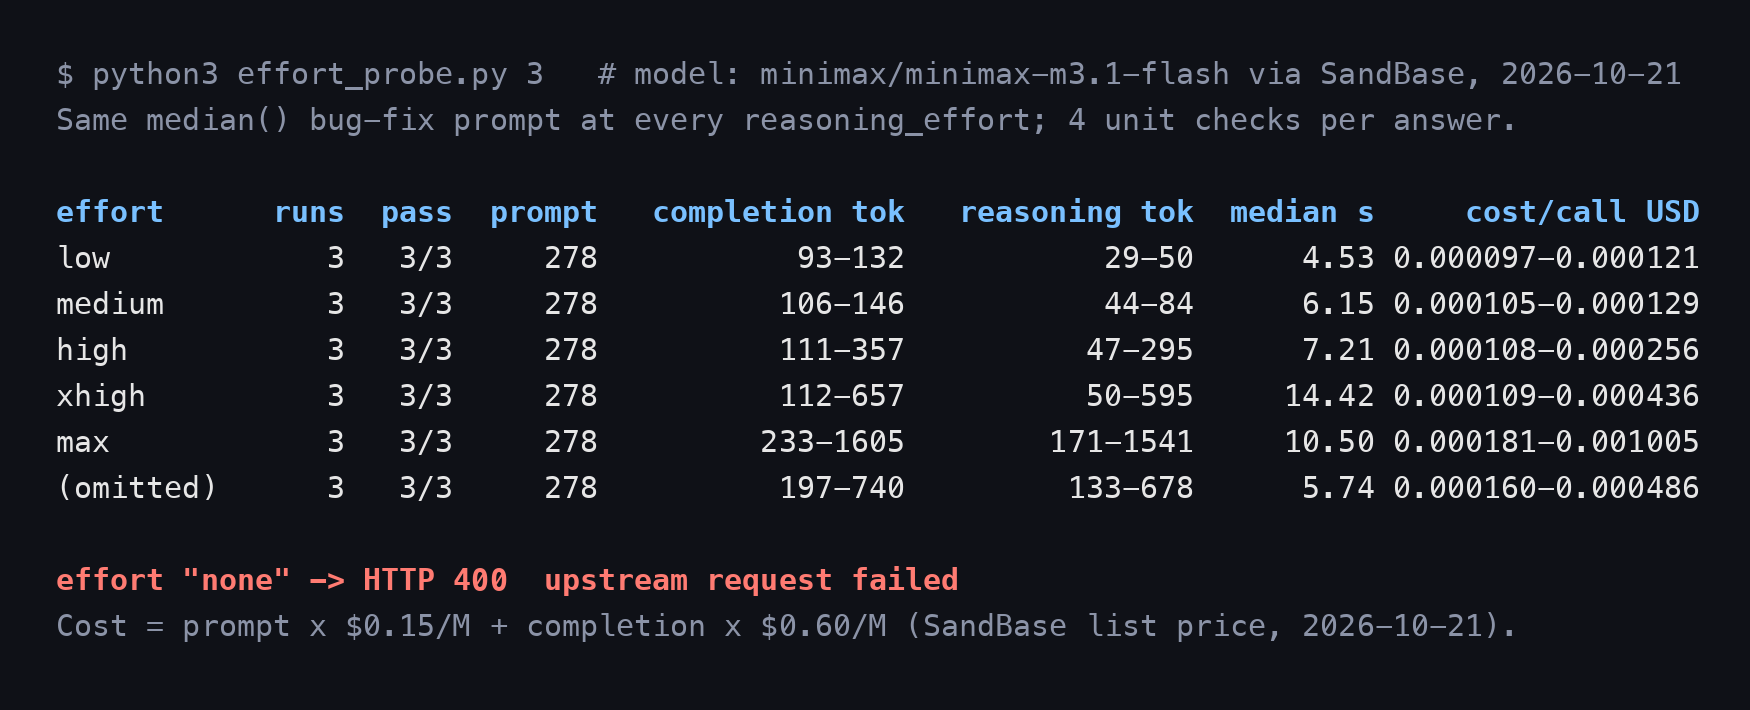 我们的 effort 测试,2026-10-21,由原始 JSONL 日志渲染:18 次成功调用全部通过;通过 SandBase 传
effort: "none" 同样返回 HTTP 400。
结果有三点值得记:
- 每一档都做对了。 但这只是一道简单题,说明不了难题上限,只能说明
low不是摆设。 low很稳,max很飘。 low 输出 93–132 个 token;max 同一道题,一次 233,一次 1,605。按平均值做预算,max 的长尾会让账单出乎意料。- 不传 effort 时表现接近高档位,197–740 个 token,和文档”默认 max”一致。如果你从一个默认很省的模型迁过来,会在不知不觉中用上最贵的一档。
延迟在这么小的样本里波动很大,3.7 到 16.9 秒都有,排不出档位之间的速度顺序。官方说日常输出速度 200+ TPS、P50 稳定在 170+ TPS,我们没测吞吐,这一点既不能证实也不能否认。
测试范围说在前面:一道题、每档 3 次、一天、一条线路。它能告诉你 token 分布的形状,告诉不了你质量天花板。
价格:$0.15 / $0.60 落到每次任务是多少
MiniMax 价格页上,M3.1 Flash 只有一行统一价;M3 则以 512K 输入为界分两档,页面标着”永久五折”,划掉的原价分别是 $0.60 / $2.40 和 $1.20 / $4.80;另有 1.5 倍价格的 Priority 档。
| 模型(MiniMax 当前价,每百万 token) | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | $0.015 |
| MiniMax-M3,输入 ≤512K | $0.30 | $1.20 | $0.06 |
| MiniMax-M3,输入 >512K | $0.60 | $2.40 | $0.12 |
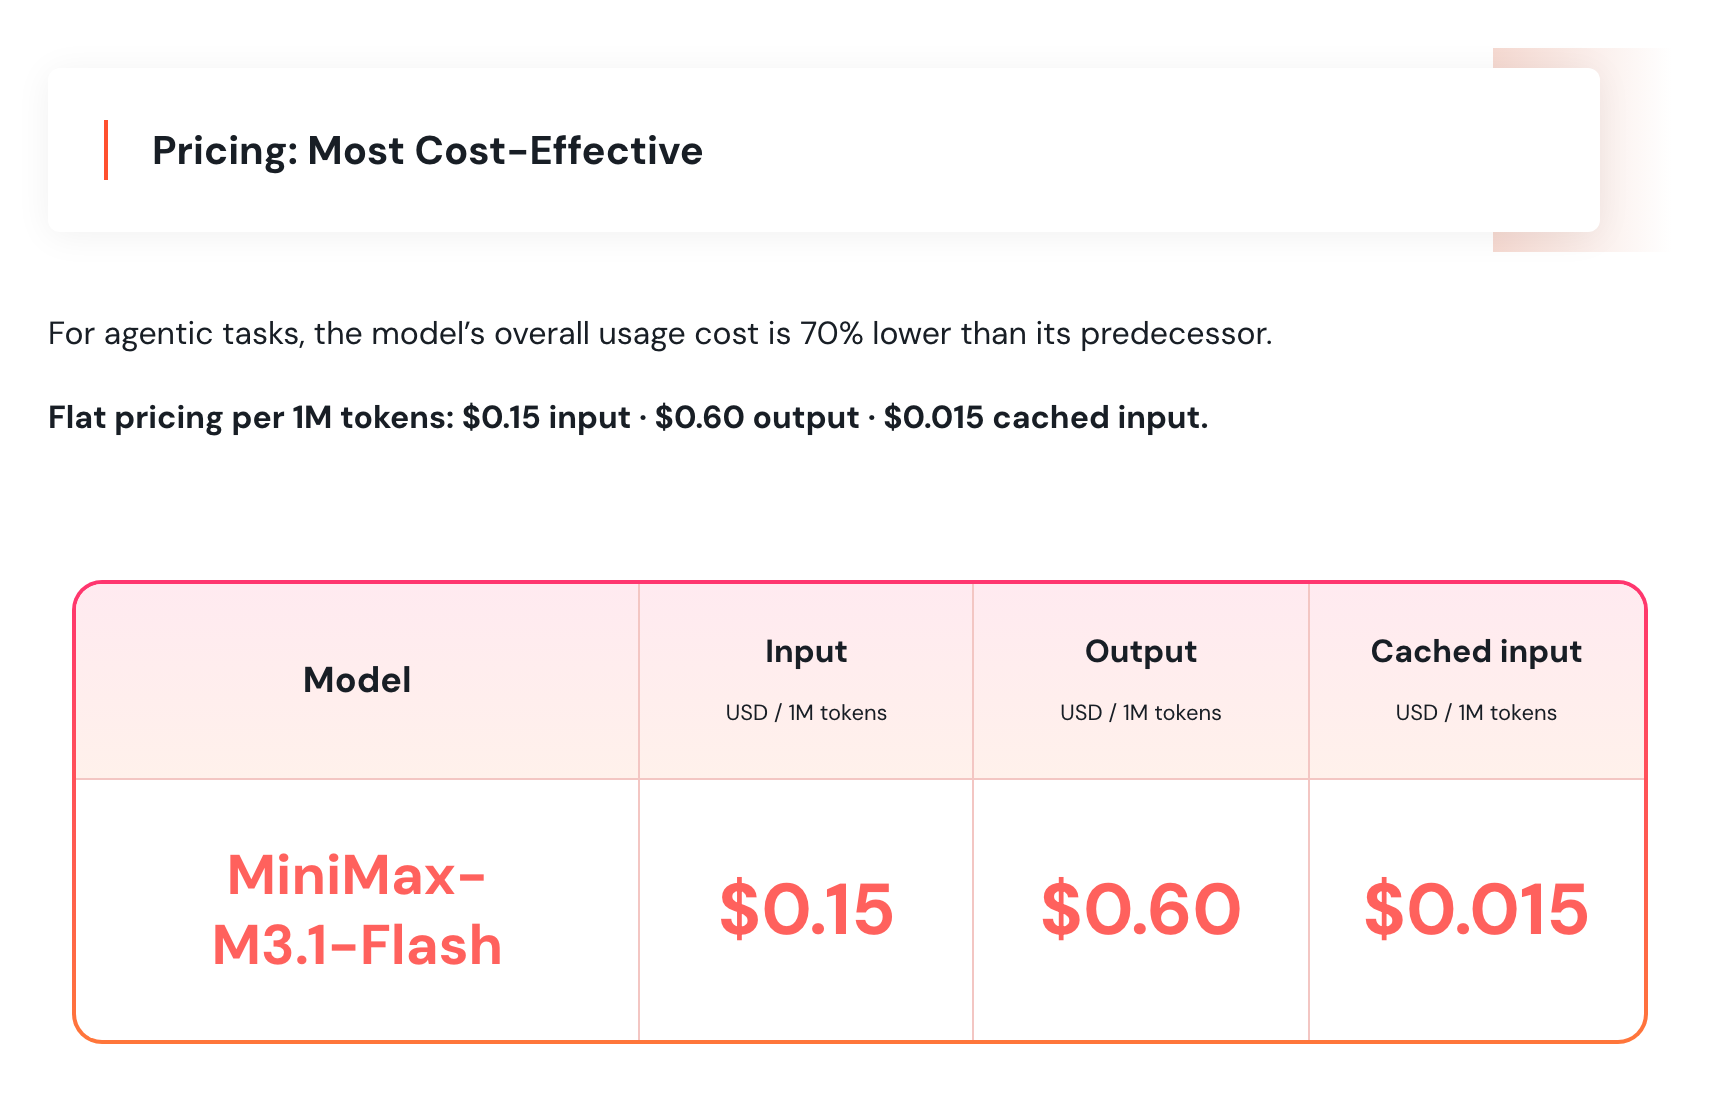 MiniMax 发布博文,2026-10-21 截图:统一定价,输入 $0.15、输出 $0.60、缓存输入 $0.015(每百万 token)。
按 token 算,Flash 是 M3 当前折后价的一半,是 M3 超过 512K 输入后当前价的四分之一。官方说的”成本降低 70%“指的是 Agent 任务的整体成本,还取决于每个任务烧多少 token,MiniMax 没公开具体算法。
我们的数据能把这件事说得更具体。一次 low 档修 bug 调用约 $0.0001,最贵的一次 max 约 $0.0010,同一个答案贵了 10 倍。放到每月一百万次调用,大约是 $100 对 $1,000,还没算重试。最便宜的优化手段不是换模型,而是按路由明确设置 effort。
日志里还有一个细节。一句话的提示词(“Which is bigger, 9.11 or 9.9? One sentence.”),在 SandBase 这条线路上三次调用都被计为 219 个输入 token;我们那道很短的修 bug 题是 278 个。同样的修 bug 题发给 DeepSeek V4.1 Flash,只计 106 个。也就是说,模型看到你的文本之前,已经被加了一段固定开销。按 $0.15 每百万算并不贵,但单次调用的输入成本因此有个约 $0.00003 的底。这段开销从哪来,我们还没查清。
SandBase 列出的输入、输出价格与 MiniMax 官方相同。缓存命中怎么计费,请以你自己的用量记录为准,不要默认它一定等于官方的 $0.015。
跑分:办公类 Agent 强,终端与仓库级编程偏弱
MiniMax 公布了一张 15 项基准的对比表,对手是 DeepSeek V4.1 Flash、Kimi K3、GLM-5.3、GPT-5.6 Sol 和 Opus 5。表里每个数字都是 MiniMax 自己测的,每项都附了评测框架说明。
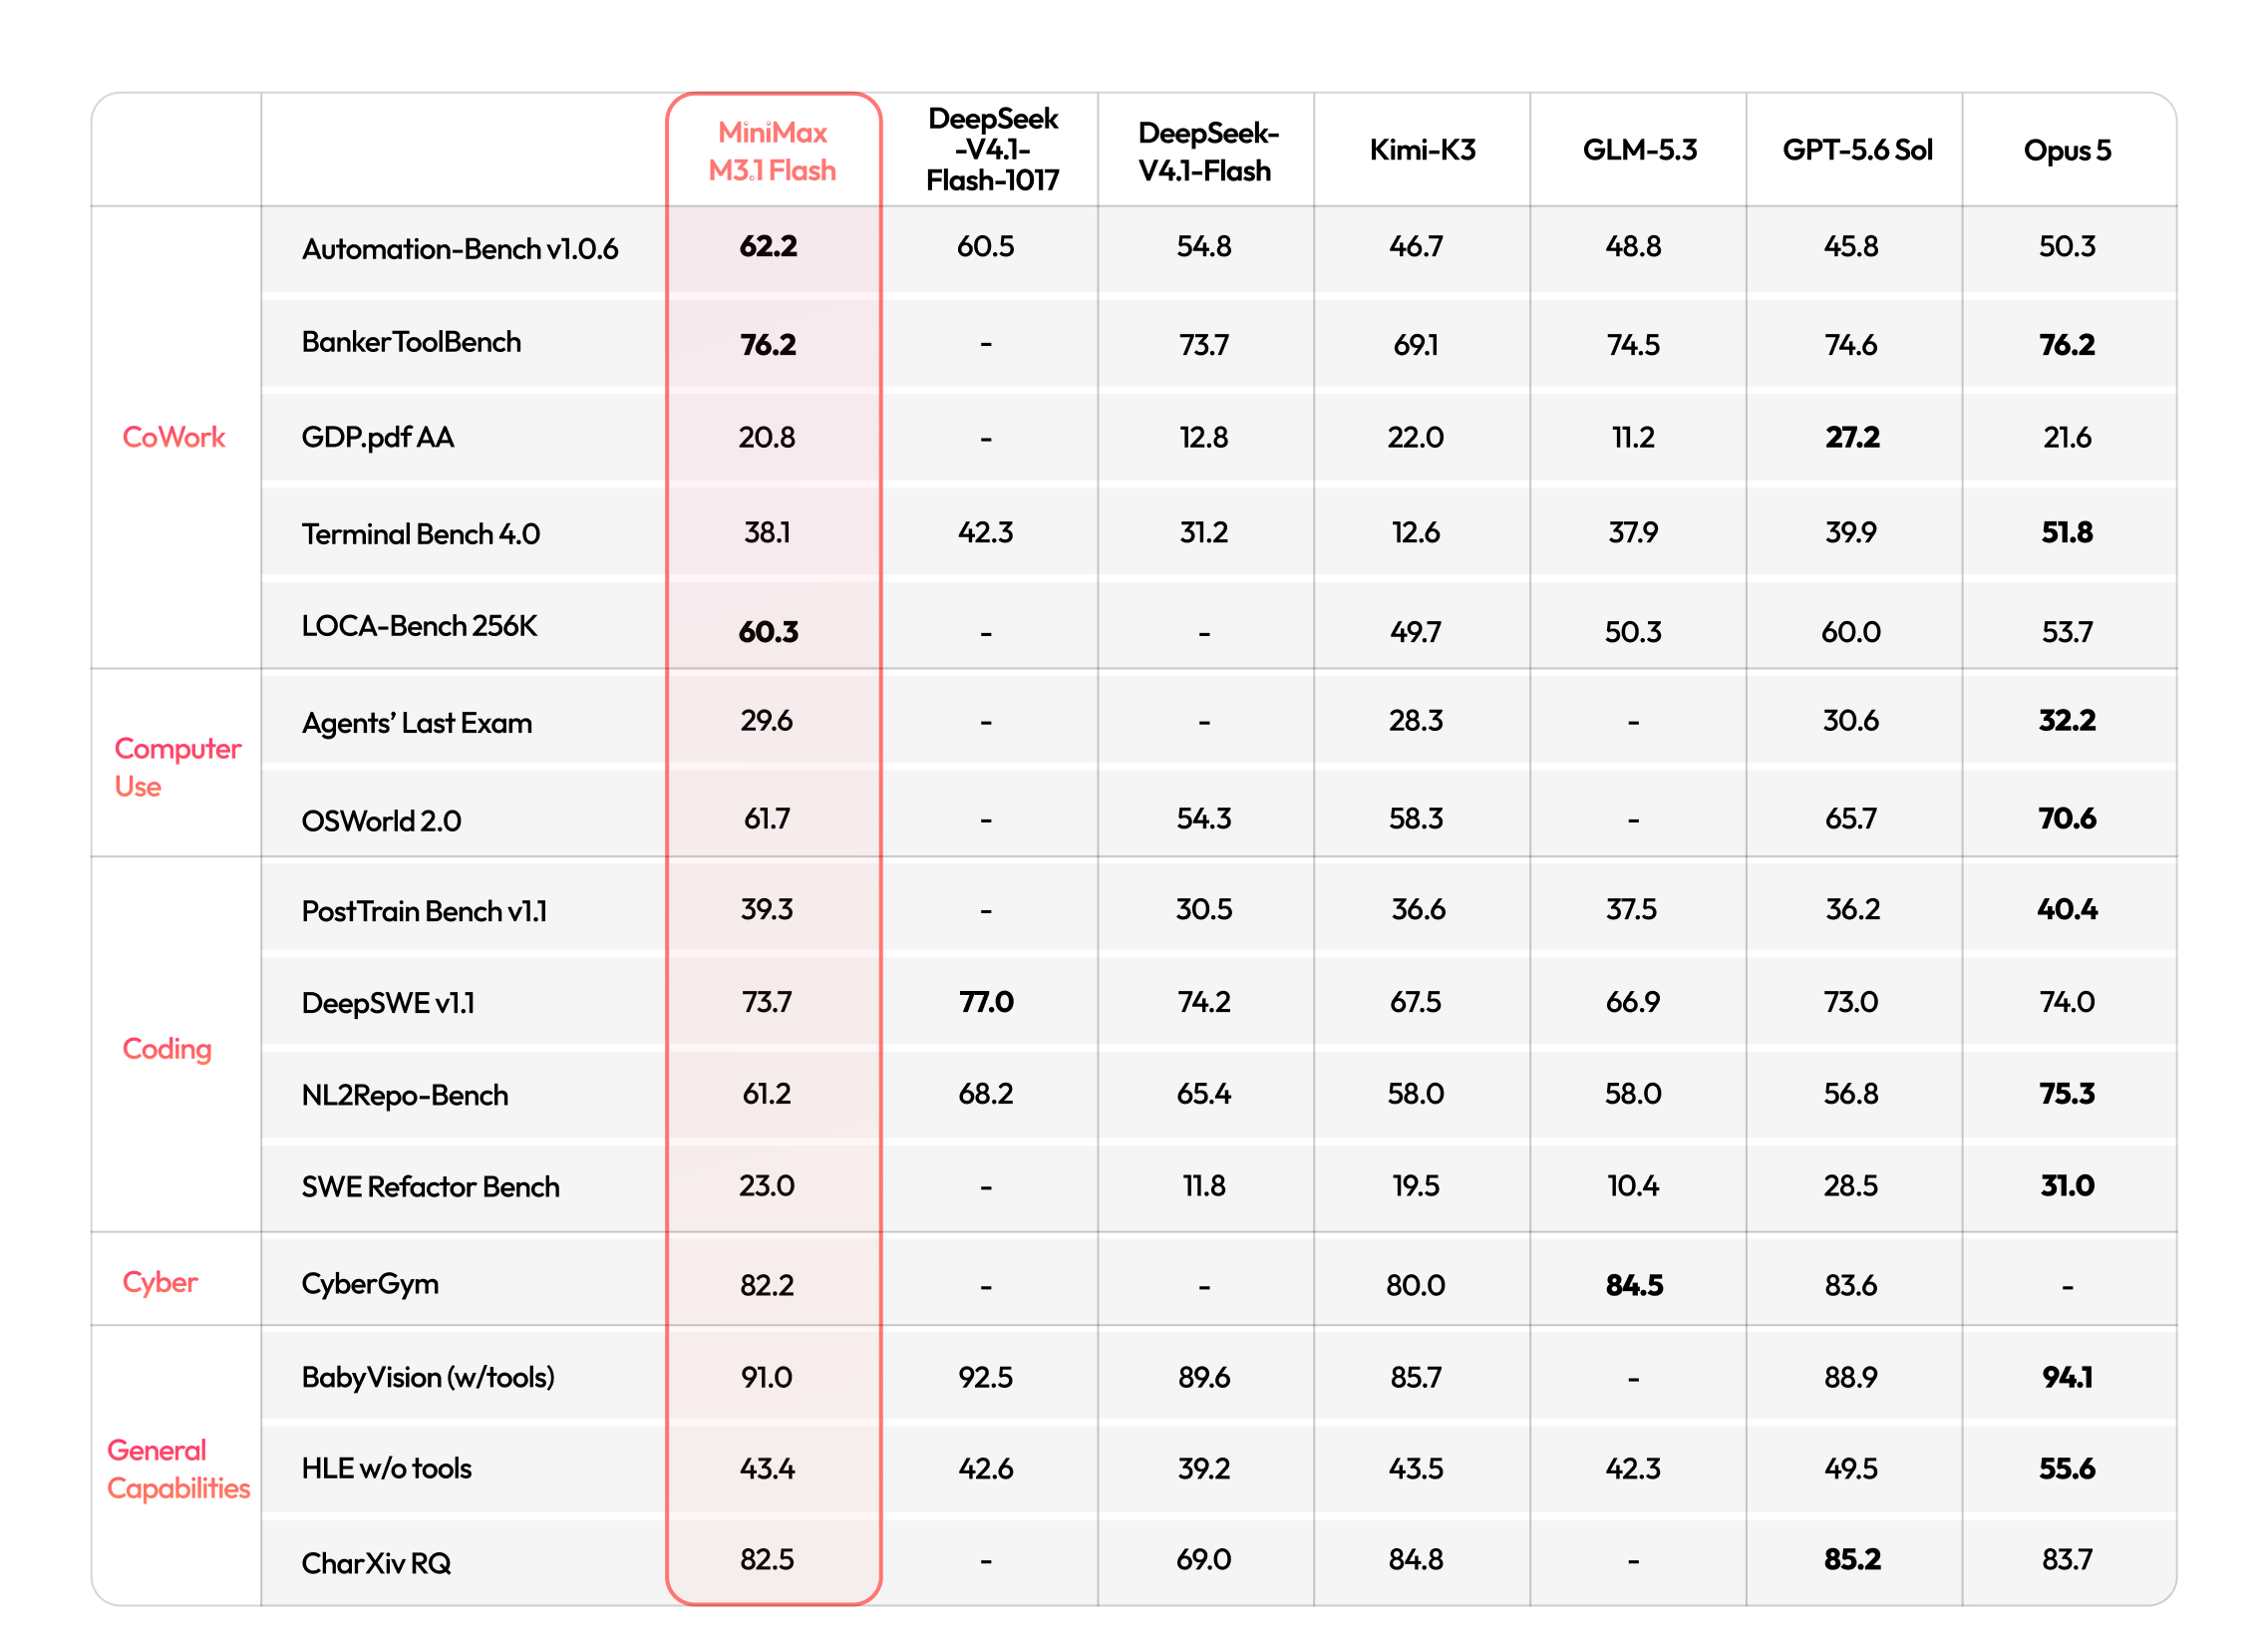 MiniMax 发布博文中的对比表(厂商自报,本截图省略了评测说明),高亮列为 M3.1 Flash。
| 基准(MiniMax 自报) | M3.1 Flash | Opus 5 | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.2 | 50.3 | 60.5 |
| BankerToolBench | 76.2 | 76.2 | – |
| OSWorld 2.0 | 61.7 | 70.6 | – |
| DeepSWE v1.1 | 73.7 | 74.0 | 77.0 |
| Terminal Bench 4.0 | 38.1 | 51.8 | 42.3 |
| NL2Repo-Bench | 61.2 | 75.3 | 68.2 |
| CyberGym | 82.2 | – | – |
| HLE(无工具,纯文本子集) | 43.4 | 55.6 | 42.6* |
*DeepSeek 自己的更新日志里,HLE 无工具是 42.6,纯文本子集是 44.0,所以这一格很可能和 MiniMax 这一行不是同一个子集。
规律很清楚:M3.1 Flash 最接近一线模型的地方,是结构化的业务流程 Agent,比如 Automation-Bench、BankerToolBench、长上下文的 LOCA-Bench。一到开放式的仓库级和终端任务就掉队:Terminal Bench 4.0 是 38.1,Opus 5 是 51.8;NL2Repo 是 61.2,Opus 5 是 75.3。连 MiniMax 自己的表里,DeepSeek 新版 Flash 在 DeepSWE、Terminal Bench 4.0 和 NL2Repo 上也都比它高。两者的详细对比见 MiniMax M3.1 Flash vs DeepSeek V4.1 Flash。
两个提醒。第一,MiniMax 成本图里 max 档的 Automation-Bench 标的是 62.8,表里却是 62.2,所以一两分的差距本身就在厂商数据的误差范围内。第二,独立数据还很少。SandBase 存档的 Artificial Analysis 快照(Intelligence Index v4.3,数据抓取于 2026-10-19)还没收录 M3.1 Flash;它给 “MiniMax-M3” 条目的分数是 29.2,之后出来的 Flash 独立分数可以拿这个当参照。这个指数只是一个综合分,算法见其方法说明。VentureBeat 的标题指出它幻觉率偏高,正文我们没能打开核实。做信息抽取或事实密集型任务时,最好加一道校验。
适合用在哪
| 场景 | 适配度 | 理由 |
|---|---|---|
| 高频工具调用 Agent(CRM、工单、财务运营) | 强 | 厂商最好的分数都在这里;我们实测的工具调用又快又准 |
| 日常修 bug、代码评审意见 | 好 | low 档解出我们的题,每次约 $0.0001 |
| 1M 以内的长文档阅读 | 好 | 统一价,没有 M3 那种 512K 以上加价 |
| 高难度仓库级或终端 Agent | 偏弱 | Terminal Bench 和 NL2Repo 落后 Opus 5 与 DeepSeek V4.1 Flash 1017 |
| 对延迟极敏感的短对话 | 一般 | 思考关不掉,总有一段推理开销 |
| 现在就要私有部署 | 暂不行 | 截至 10 月 21 日没有权重和许可证 |
说白了,M3.1 Flash 是一个便宜耐用的主力模型,适合在规则清楚的业务系统里调工具;它不是你最难那类编程任务的平替。如果你想要一个已经开源权重的 Flash 级选择,可以看我们的 GLM-5.3-Flash 价格分析。
怎么调用
直连 MiniMax:OpenAI 兼容地址 https://api.minimax.io/v1,或 Anthropic 兼容地址 https://api.minimax.io/anthropic,型号填 MiniMax-M3.1-Flash。通过 SandBase:在 /v1/chat/completions 上用 minimax/minimax-m3.1-flash,模型页有完整请求示例和 Playground。无论哪条路,都建议显式写上 effort:
curl https://api.sandbase.ai/v1/chat/completions \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax/minimax-m3.1-flash",
    "reasoning_effort": "low",
    "max_tokens": 4096,
    "messages": [{"role": "user", "content": "Fix the off-by-one bug in this function: ..."}]
  }'
切生产流量之前,先过一遍清单:删掉所有 effort: "none" 和关闭思考的参数;不再解析 <think> 标签,改读 reasoning_content;每条路由单独定 effort;多轮工具调用里保留完整的 assistant 消息,MiniMax API 文档明确说推理链的连续性依赖它。
常见问题
MiniMax M3.1 Flash 多少钱?
MiniMax 官方价:每百万输入 $0.15、输出 $0.60、缓存输入 $0.015,没有长上下文阶梯(2026 年 10 月 21 日核对)。SandBase 列出的输入、输出价格相同。
M3.1 Flash 能关掉思考吗?
不能。关闭思考或传 effort: "none" 会返回 HTTP 400,MiniMax 文档这么写,我们通过 SandBase 也测到了同样的结果。想省推理 token,用 reasoning_effort: "low"。
M3.1 Flash 是开源权重吗?
MiniMax 称它为开放权重模型,并表示权重稍后发布。截至 2026 年 10 月 21 日,Hugging Face 上没有对应仓库,也没有许可证。两者都出来之前,别排私有部署的计划。
上下文窗口多大?
MiniMax 文档写的是 1,000,000 token。SandBase 标注最大输出 512K。
M3.1 Flash 比 M3 更好吗?
按官方说法,它更快、单任务更便宜,单 token 价格也只有 M3 当前价的一半。但 2026-10-19 的 Artificial Analysis 快照里还没有 Flash 的 v4.3 分数,暂时做不了同口径的独立对比。在我们的小样本里,工具调用和发票抽取两类任务上 M3.1 Flash 的延迟中位数明显更低(2.5 秒对 12.2 秒、3.3 秒对 13.1 秒);修 bug 题在默认档位下,M3 反而略快。
M3.1 Flash 最适合的用法,是在你能按路由控制 effort 的前提下,承接大量 Agent 调用。价格是实打实的,限制也写得清楚;但跑分仍是 MiniMax 自己的。上生产之前,先用你自己的工作流测一遍。