用一个 API 挖掘知乎问答:一套实用工作流 | SandBase
用一次请求读取已知知乎问题或首屏回答,校验卡片 target、保留未知字段,不自动串联或使用未经验证的翻页逻辑。
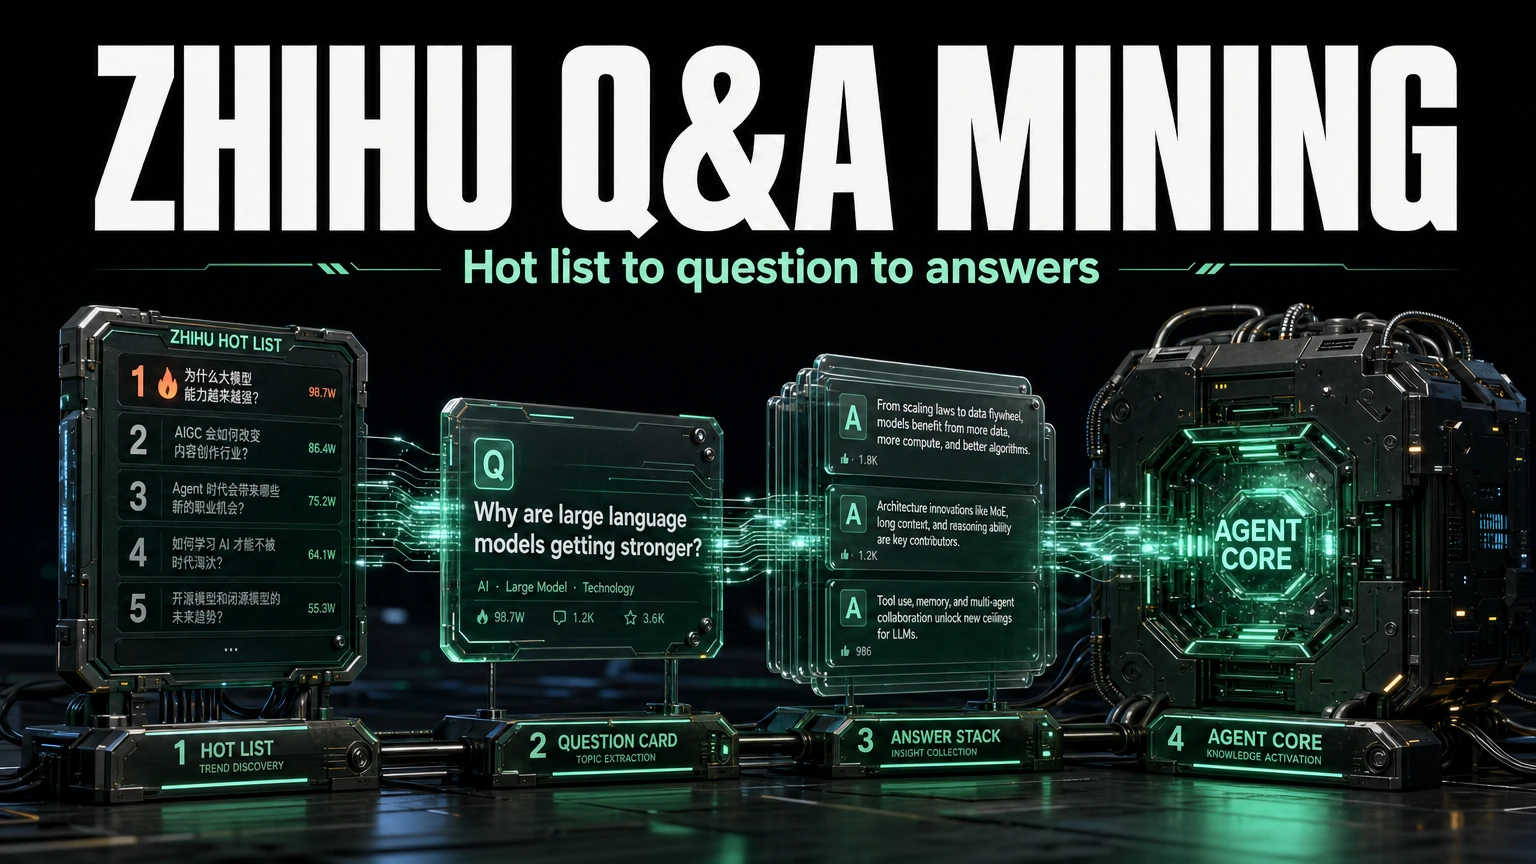
拿到一个知乎问题链接后,可以先回答一个具体问题:要确认题目与讨论规模,还是读取首屏回答?这两个任务对应不同请求。不必先抓热榜、自动挑第一项,再跑完三步链路,才能研究一个已知问题。
本次 2026-11-08 修订通过免费 inspect 和公开响应参考核对问题详情、问题回答两个端点,没有执行付费业务调用,也不声称刚刚跑通新的请求。原文 2026-09-27 的示意 JSON 与 Python 保留在历史部分。更多端点见知乎公开数据 API 总览。
先说结论
- 已有问题 ID,就在详情和首屏回答中选一个请求。
- 详情的
outputs[0].data本身就是问题记录;detail、excerpt为空可以是正常结果。- 回答位于
outputs[0].data.data的信息流卡片中;只有target_type: "answer"的target才按回答提取。- 首屏明确传
limit: 5、offset: 0、order: "default",省略 cursor、session ID,收到响应就停。
先选能回答你问题的读取方式
| 任务 | 精确端点 | 本例输入 |
|---|---|---|
| 确认题目与可用元数据 | Question detail | question_id |
| 检查首屏并提取回答记录 | Question answers | question_id、limit: 5、offset: 0、order: "default" |
例如公开问题地址 https://www.zhihu.com/question/37811449 中的数字是 37811449。传 ID 字符串,不传完整链接。问题 ID 与回答 ID 不是同一个标识,不能因为都是数字,就把回答链接末尾的编号拿来代替。
详情 schema 只有必填 question_id。回答 schema 同样要求该 ID,描述 limit 默认 5、offset 默认 0,并列出 default、updated 排序方式。本例明确选择首屏输入,不搬用其他搜索接口的筛选项。默认排序不意味着严格按时间排列,更不是按观点真伪或专业水平排序;传了 limit 也不代表每次一定得到等量回答。
已有 Key 或 Agent,该怎么接
已有项目就在本地配置 SANDBASE_API_KEY,并在项目的 Python 环境安装 requests。不要把 Key 放进提示词、源码或日志。示例会先检查环境变量,没有 Key 时不会发网络请求。
如果 Agent 已连接 SandBase,就让它检查选定端点并复用连接,同时说明已知 ID、任务和一次请求的范围。例如:“读取这个问题的首屏回答,把回答 target 与其他卡片分开,保留未知字段,不自动查下一页。”不需要重新建项目,也不必搜索所有接口。
新接入可以把 setup skill、Markdown quickstart和具体任务一起交给 Agent。人工快速入门解释账号与 Key 的准备。创建 Key 不能证明目标问题当前可读,也不能证明共享免费额度还剩多少。
一个有限范围的 Python 请求
默认只读取详情。数字输入检查、返回字符串 ID 必须匹配、标题非空,都是参考当前响应形状设置的本地完整性要求,不是对所有上游响应的保证。其他元数据仍允许缺失。
import os
import re
import requests


def first_request(task, question_id):
    if task not in ("detail", "answers"):
        raise ValueError("Choose detail or answers")
    if not isinstance(question_id, str) or not re.fullmatch(r"[0-9]+", question_id):
        raise ValueError("question_id must be a numeric ID string, not a URL")
    params = {"question_id": question_id}
    if task == "answers":
        params.update(limit=5, offset=0, order="default")
    key = os.environ.get("SANDBASE_API_KEY", "").strip()
    if not key:
        raise ValueError("Set SANDBASE_API_KEY locally")
    try:
        response = requests.post(
            f"https://api.sandbase.ai/v1/api/zhihu/web/question-{task}",
            headers={"Authorization": f"Bearer {key}"},
            json=params, timeout=(10, 90), allow_redirects=False,
        )
        if not 200 <= response.status_code < 300:
            raise RuntimeError(f"HTTP {response.status_code}; no retry performed")
        body = response.json()
    except ValueError:
        raise RuntimeError("Response was not valid JSON") from None
    except requests.RequestException:
        raise RuntimeError("Network request failed; no retry performed") from None
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("Request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Missing documented outputs[0].data")
    payload = outputs[0].get("data")
    if not isinstance(payload, dict):
        raise RuntimeError("Missing business payload object")
    if task == "detail":
        if payload.get("id") != question_id:
            raise RuntimeError("Question ID missing or mismatched")
        title = payload.get("title")
        if not isinstance(title, str) or not title.strip():
            raise RuntimeError("Question title missing")
    else:
        cards = payload.get("data")
        if not isinstance(cards, list):
            raise RuntimeError("Missing answer feed array")
        for card in cards:
            if not isinstance(card, dict):
                raise RuntimeError("Malformed feed card")
            if card.get("target_type") == "answer":
                if not isinstance(card.get("target"), dict) or not card["target"]:
                    raise RuntimeError("Missing answer target object")
    return payload


def answer_records(payload):
    # Use only after first_request has validated the feed.
    return [card["target"] for card in payload["data"]
            if card.get("target_type") == "answer"]


if __name__ == "__main__":
    result = first_request("detail", "37811449")
print(result["title"])需要回答时,替换最后两行:result = first_request("answers", "19550225"),然后 print(len(answer_records(result)))。打印的是实际提取的回答 target 数量,不是所有卡片数,也不是该问题的回答总数。两个例子是二选一,不是顺序执行;ID 来自当前公开 schema 示例,本轮没有执行这两次请求。
answer_records 只是对已校验响应做本地提取,不发网络请求、不拉回答全文、不查作者,也不跟随链接或下载图片。函数原样返回载荷,方便你之后检查其他卡片类型和分页元数据。
先检查信封,再理解卡片
代码遇到重定向、HTTP 错误、鉴权或权限问题、额度或支付错误、超时、非法 JSON 就停止。连接和读取都有超时限制,不自动重发可能消耗额度或费用的操作。错误信息不带 Key 或完整响应正文,先查明原因,再决定要不要重试。
已完成响应必须在文档化的 outputs[0].data 提供对象。缺失输出是错误,不回退成空对象或空数组;不兼容旧顶层 output,也不给这两个参考结构强加 code: 0、ok: 1 或 success 标志。
详情载荷本身就是问题记录。当前参考有匹配的字符串 id、标题、部分计数,而 detail 和 excerpt 都是空字符串。这两个字段为空,不能证明调用失败或问题没有回答。函数检查身份和标题,不要求描述一定有字,也不把缺失计数补零。
回答端点则需要另一种读取方式。业务 data 数组包含信息流卡片,target_type 为 answer 时,回答在 target 内。外层 type 可以是 question_feed_card,它不是回答记录。标明回答却没有 target 对象属于错误;其他类型保留在原载荷,但不进入提取后的回答列表。合法空数组表示空信息流,缺失数组表示结构不符。
当前公开参考还有单独的 ad_info 广告信息。它不计作回答,示例也不跟随里面的跟踪链接。未知卡片类型不会被改名成回答;混合信息流中提取出零条回答,也不能直接断言整个问题没有回答。
当前参考能说明什么
详情 README 保留了问题 37811449 的截短真实响应:题目是“有哪些优雅的 Windows 10 壁纸?”,记录为 90 个回答、9 条评论、2,912 名关注者,描述字段为空。这些是公开参考样本的值,不是本次更新重新测得的数字。样本还含创建时间和审核标志;即使字段说明列出 visit_count,样本缺失时仍应保留未知。
问题 19550225 的回答参考展示了卡片与 target 的区别、target 内的作者对象、响应游标、paging.is_end: false 和 session.id。样本经过截短,不能证明全文、全部字段或未截短列表长度。作者粉丝数、身份徽章只是返回的元数据,不等于观点正确,也不能自动变成专家排名。本例没有复制新的个人资料到正文。
存储时应把问题元数据与抽样回答分开,保留问题 ID、观察时间和文本来源。抽到的回答数量不等于页面宣称的总回答数。对样本做总结属于后续分析任务,当前函数既不调用 LLM,也不把一个首屏代表成整个社区的观点。
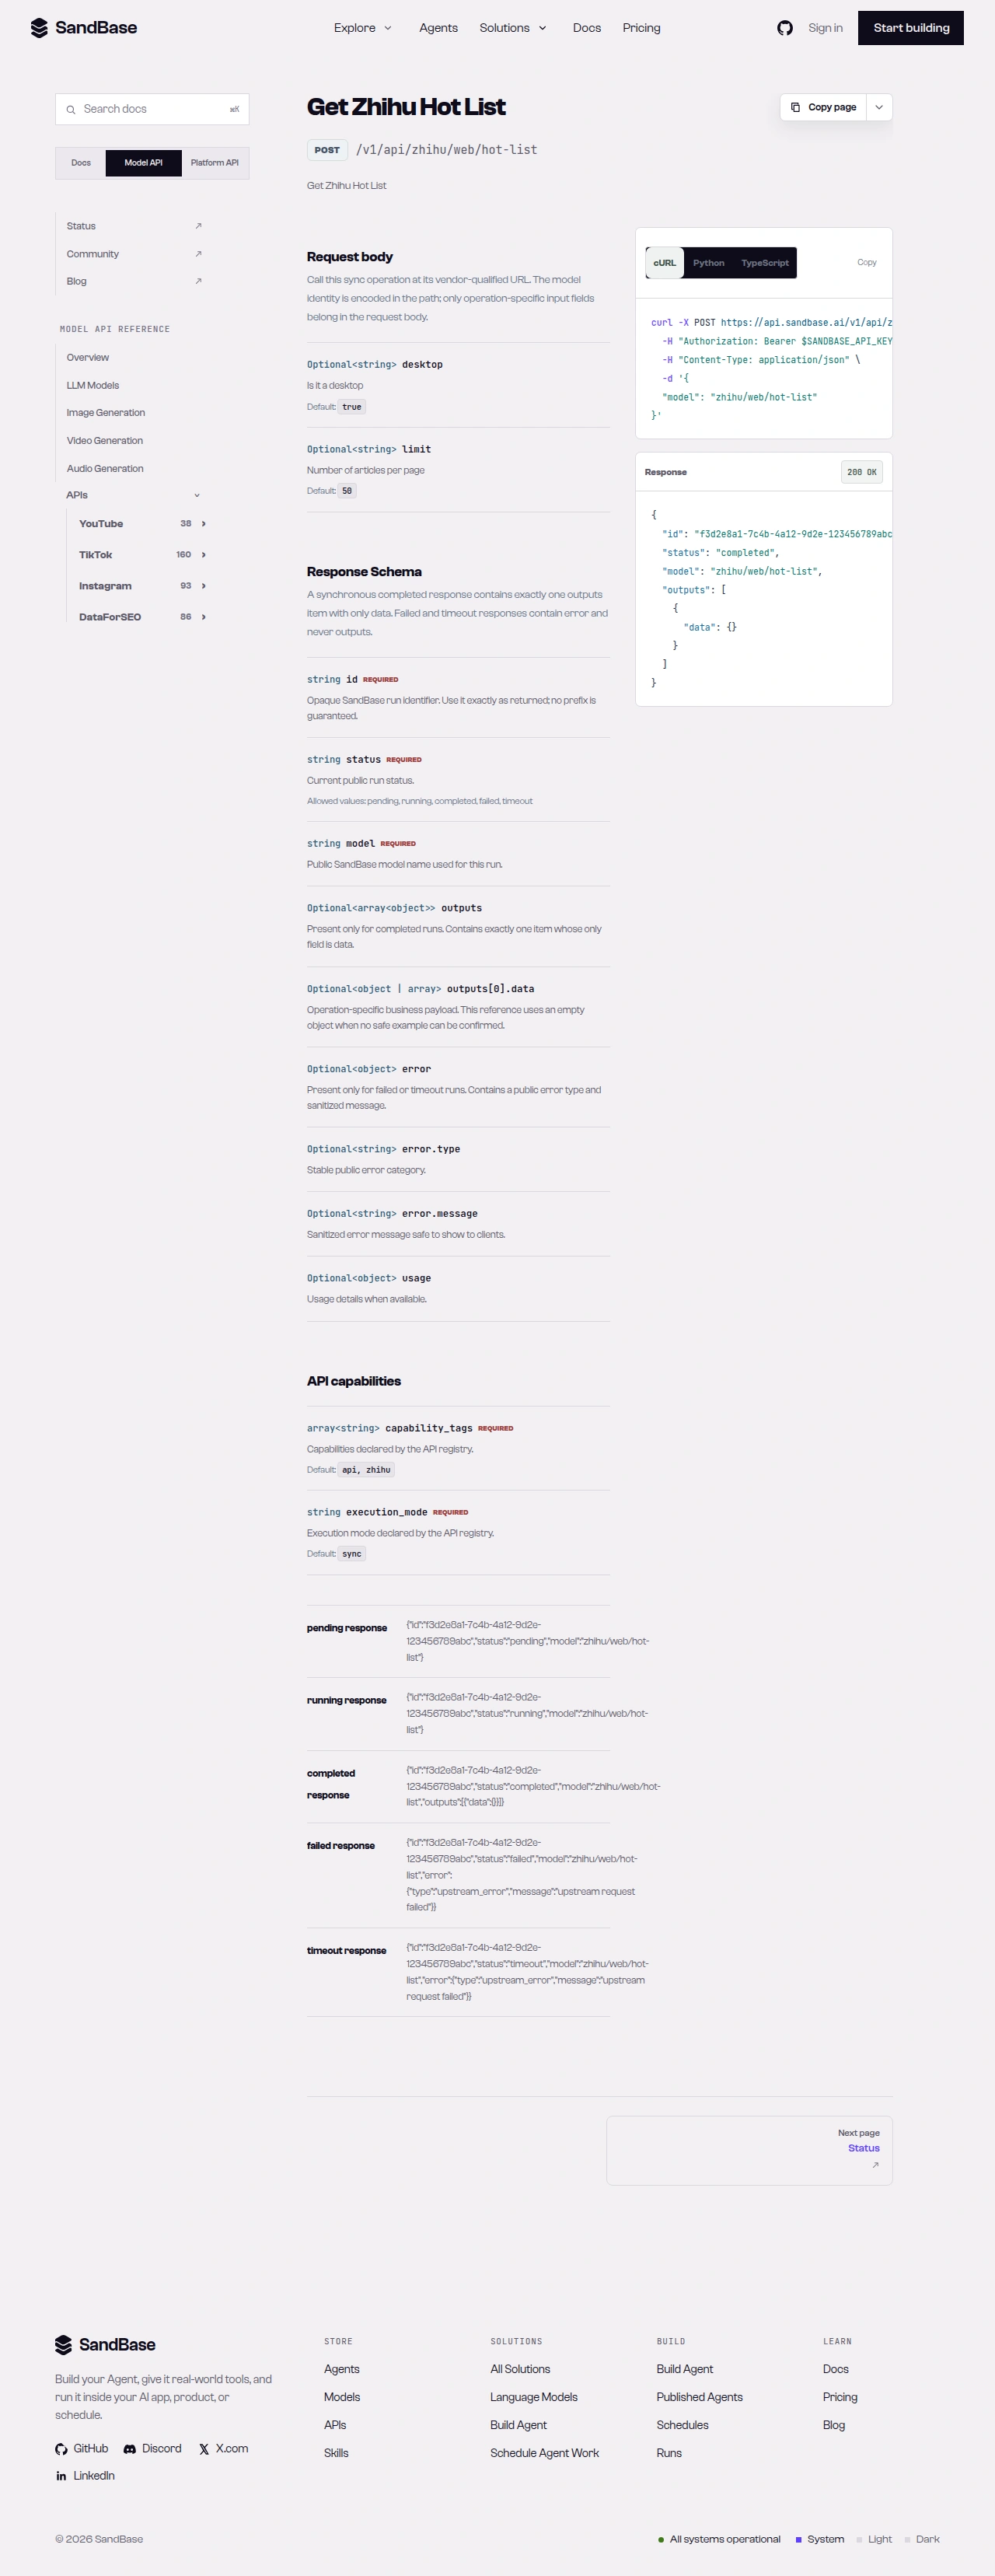 原文保留的历史热榜参考。旧生成 cURL 中的 model 字段不要复制进当前只传端点参数的请求;已知问题不需要先查热榜,本轮未复验热榜业务调用。
为什么要撤掉旧的 offset 翻页建议
旧文曾建议只增加 offset,不读取响应字段。对当前问题回答参考而言,这个做法不充分。schema 把 cursor 和 session_id 都描述为从响应提取;README Notes 把续页关联到返回的游标与 session.id,并指出 paging.is_end 是结束标志。
本轮没有测试续页,所以不提供下一页代码。首屏省略 cursor、session ID,不编造它们、不复用其他问题的状态,也不从截短样本里照抄。如果以后扩展分页,需要先核对实际未截短响应与选定端点契约。被截断的 paging.next URL 不能作为真实请求目标,当前函数也绝不会自动访问它。
旧示例的 limit 为 20,仍原样保留在归档;当前首屏明确用 5。两者都不能保证实际返回数量,也不能用短页直接认定问题结束。offset 这个数字本身,不是续页状态正确的证据。
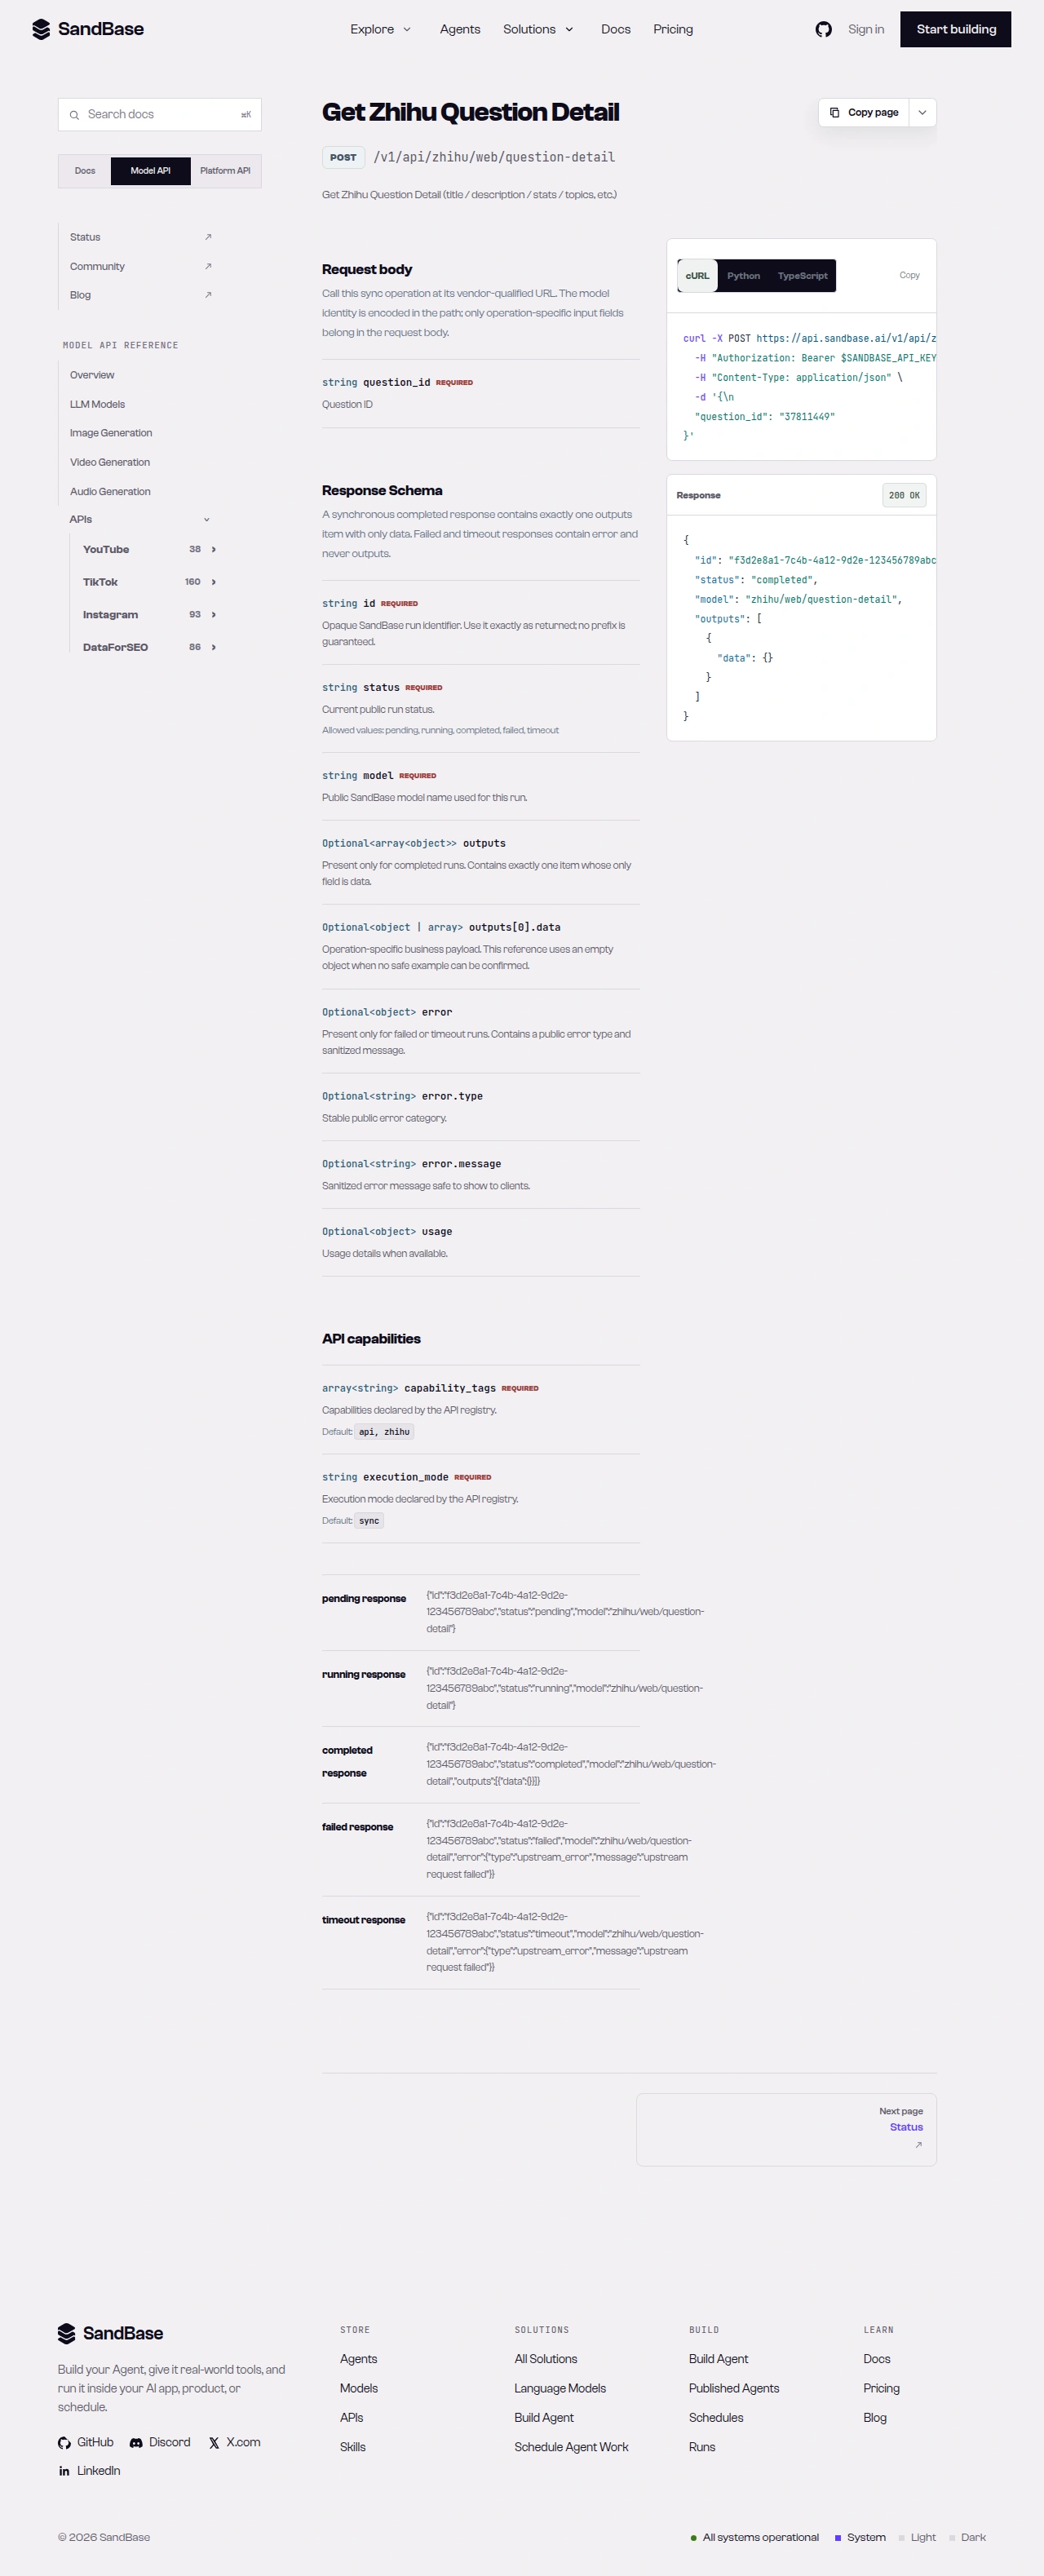 历史 question-detail 参数与响应参考。本轮免费契约核对支持选定的 ID 输入,但这张图不是新请求产物。
费用、额度和边界
2026-11-08 免费 inspect 显示两个选定端点的基础价均为 $0.001/次,都符合组织共享的每日 100 次合资格 API 调用额度,在 UTC 00:00 重置。资格不是剩余额度,本次没有查账户余额或实际扣费,不能承诺一定免费。
默认详情请求只调用一次,改成回答请求也是一次。如果另行决定两者都运行,基础价估算为 $0.002,再考虑额度适用情况;这不是必经步骤,也不是默认代码行为。续页、重试、回答详情和作者资料都需要单独决定与预算。旧的多问题循环不是当前接入成本。
保留旧资料,也保留它的限制
原封面表达“热榜到问题再到回答”的概念;题目、数字和回答文本是插画示意,不是实测榜单或本轮执行过整条流程的证据。2026-09-27 发布的旧文包含下面这段示意 JSON。本次没有为它补造新的实测,其标识也不能证明当前业务调用成功:
{
  "id": "fad23166-43be-45dc-a1e8-8a2e60050349",
  "status": "completed",
  "model": "zhihu/web/question-answers",
  "outputs": [
    {
      "data": {
        "data": [
          { "type": "answer", "target": { "…": "…" } }
        ]
      }
    }
  ]
}
尤其不能用旧示意里的 type: "answer" 代替当前 target_type 判断。现在的公开参考使用 question_feed_card 外壳,回答在 target。保留原 JSON 是为了追溯,不是让它继续当现行解析器的测试样本。
历史 Python 归档逐字保存两种语言各四段原代码,并附哈希。旧函数会把缺失输出补为空;热榜自动取 ID 可能把缺失值变成字符串 "None";组装循环会发一次热榜调用,再最多十次详情调用。原三步示意还需要三次选定读取,未含后续调用。这些自动动作都不属于新的有限首请求。
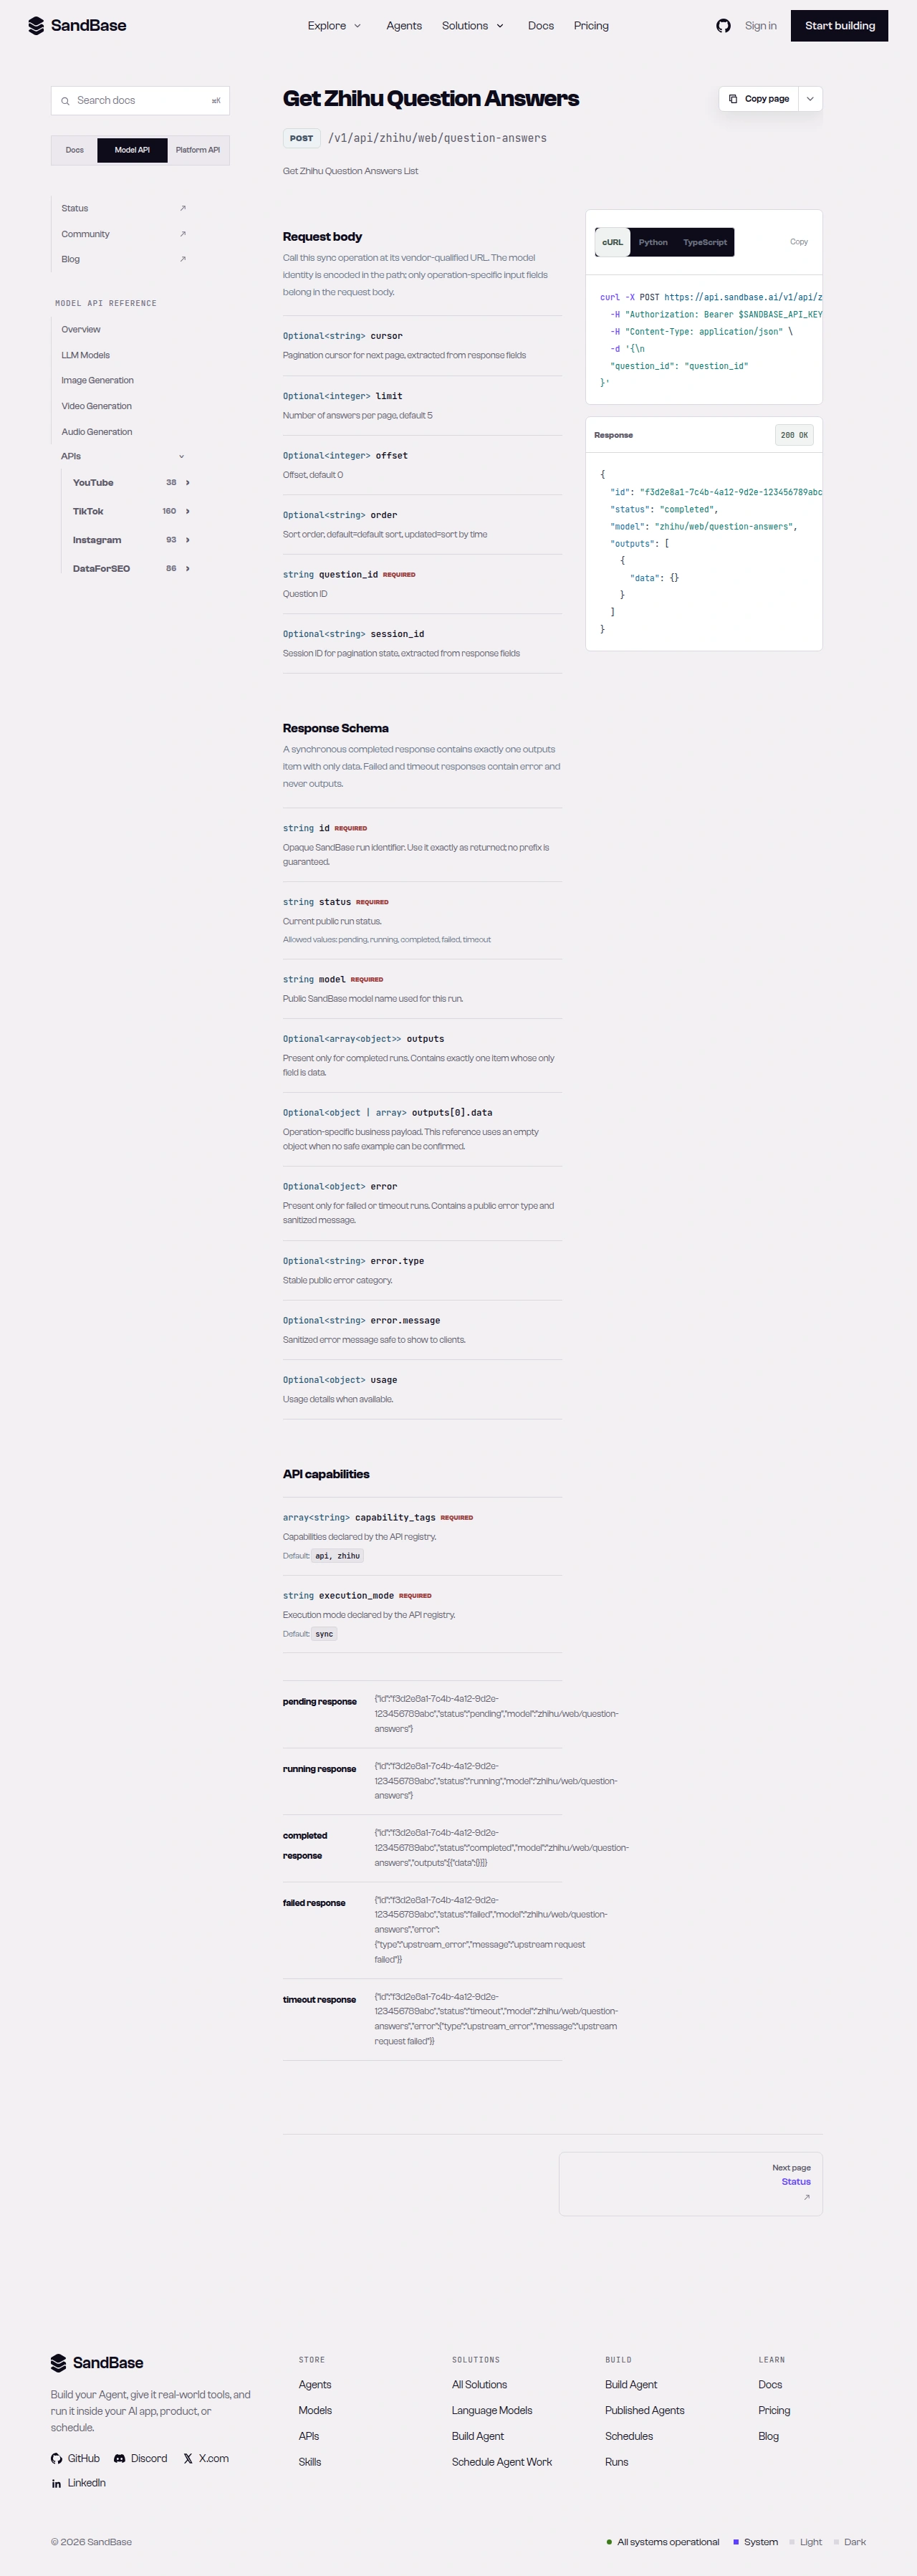 历史 question-answers 参考。参数截图只作导航背景,不能证明只加 offset 可续页;当前续页依赖响应状态,本轮尚未实测。
常见问题
需要知乎登录吗? 选定的公开读取用 SandBase Key,不授权发帖,也不提供私密或账号限定内容。需要账号操作时应走合适的知乎官方授权渠道。
为什么摘要为空也能成功?
当前详情样本同时包含有效问题 ID、标题和空的 detail、excerpt。缺失元数据与失败信封不同,不应凭空补一段文本。
请求五项,为什么提取出的回答更少? limit 是请求参数,不是本次验证过的精确数量保证。代码只提取回答类型的 target,排除其他卡片与广告信息,解释数量之前应先看原始信息流。
能让 Agent 自动收完全部回答吗? 这个例子收到一次响应就停止。全量采集需要另行验证续页、字段读取与预算,不能从首屏成功或总回答数推导出来。
下一步
把已知问题 ID 和单个任务交给 Agent,先验证返回结构,再判断元数据或首屏样本是否足够。可从问题详情、问题回答开始,更多能力见 API 总览。
觉得有用?分享给更多人