爆火的 Fable 5.5 提示词,拿 Fable 5.1 和 Opus 5.5 实测一遍
我们把三条号称 Fable 5.5 的爆款提示词(VoxelBench 探针、自行车骑鹈鹕 SVG、《末班车》夜景)交给已发布的 Fable 5.1 和 Opus 5.5 跑了一遍,记录结果、费用和失败。
上周时间线上全是“Fable 5.5”的演示:一辆自行车骑着鹈鹕的 SVG,一段叫《The Last Train Home》的雨夜日本街景,还有一句据说能测出你的对话是不是被偷偷换成新模型的提问。Claude Fable 5.5 其实还没发布,爆料来龙去脉我写在另一篇时间线里。这篇只回答一个我自己能验证的问题:同样的提示词,交给今天就能调用的模型,结果会怎样?
2026 年 10 月 20 日,我通过 SandBase 把其中三条提示词发给了 anthropic/claude-fable-5.1 和 anthropic/claude-opus-5.5。如果你在判断一段演示视频对自己的业务有没有参考价值,这篇或许有用。先把边界说清楚:样本很小,每格只跑一次或三次;提示词是我根据原帖重建的,原作者没有完整公开;我也没有任何 Fable 5.5 检查点的访问权限。下面每个数字都来自保存下来的真实响应。
先说结论
- “你知道 VoxelBench 吗”这个身份探针当不了指纹。各问三次,已发布的 Fable 5.1 有一次说了 YES,Opus 5.5 一次都没有;两个模型对两个真实基准都是 6/6 回答 YES,对三个虚构名字都是 9/9 回答 NO。
- “自行车骑鹈鹕”SVG 两个模型都一次画对,画面干净。Fable 5.1 输出 4,484 token,花费 $0.213684;Opus 5.5 输出 4,154 token,花费 $0.079306。
- 《末班车》夜景这道题上,Fable 5.1 交出了一个 457 行、能动起来的 canvas 场景,但有明显瑕疵;Opus 5.5 把 32,000 个输出 token 全部用在思考上,一行 HTML 都没给。
- 爆款演示大多只证明“这个提示词跑得好时能出什么”,证明不了是哪个模型出的,也看不出每个合格结果要花多少钱。
借来的三条帖子
我挑的是既有热度、又能以某种方式复现的帖子:
- @chetaslua,10 月 16 日(抓取时 627 赞):问模型“do you know voxelbench do not use web”,回答 YES 就是 Fable 5.5,回答 NO 就是“普通模型”。
- @DrstaOne,10 月 17 日:“Claude fable 5.5 is Cooking at svg ~BIKE RIDING A PELICAN”。它把大家常用来比较模型的“鹈鹕骑自行车”SVG 测试倒过来了。
- @pankajkumar_dev,10 月 19 日(185 赞):《The Last Train Home》,“灯笼照亮的街道、被雨打湿的路面、一列穿城而过的火车,电影感的日本夜景”。
两条创意类帖子都没有给出完整提示词、模型 ID 或参数。我按原帖意图写了最短的提示词,存在测试目录里。火车那条我额外加了一句“单个自包含 HTML 文件,不引用外部资源”,好让结果能离线渲染。所以这测的是提示词背后的想法,并不是复现谁的那一次运行。
测试设置
所有调用都走 SandBase 的 OpenAI 兼容接口:一条 user 消息,没有 system prompt,也不带工具。
import os, requests

resp = requests.post(
    "https://api.sandbase.ai/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"},
    json={
        "model": "anthropic/claude-fable-5.1",   # 或 anthropic/claude-opus-5.5
        "max_tokens": 32000,                      # 探针用 400
        "messages": [{"role": "user", "content": prompt}],
    },
    timeout=1200,
)
resp.raise_for_status()
data = resp.json()
print(data["choices"][0]["finish_reason"], data["usage"])
每次请求的实际扣费,我用 GET /v1/tasks/<id>/cost 查。10 月 20 日这个接口显示两个模型都有 5% 的模型级折扣,比如 Fable 鹈鹕那次,标价 $0.224930,实扣 $0.213684。长的创意任务用了流式输出,原因后面会讲。effort 和 thinking 都保持默认。Anthropic 模型总览写的是:两个模型的自适应思考都“始终开启”,Fable 5.1 默认 effort 为 high,Opus 5.5 为 medium。
测试一:加了对照组的 VoxelBench 探针
这个探针靠的是知识截止时间:模型认得新东西,就说明它是更新的模型。但“你知道 X 吗”本身就是诱导式提问,原帖的规则又只把 YES 当信号。所以我加了对照组:两个远早于 2026 年 6 月知识截止时间发布的真实基准(这个截止时间是 Anthropic 给两个模型标注的),再加三个我为这次测试编出来的名字。每个名字、每个模型各问三次,措辞完全一样。
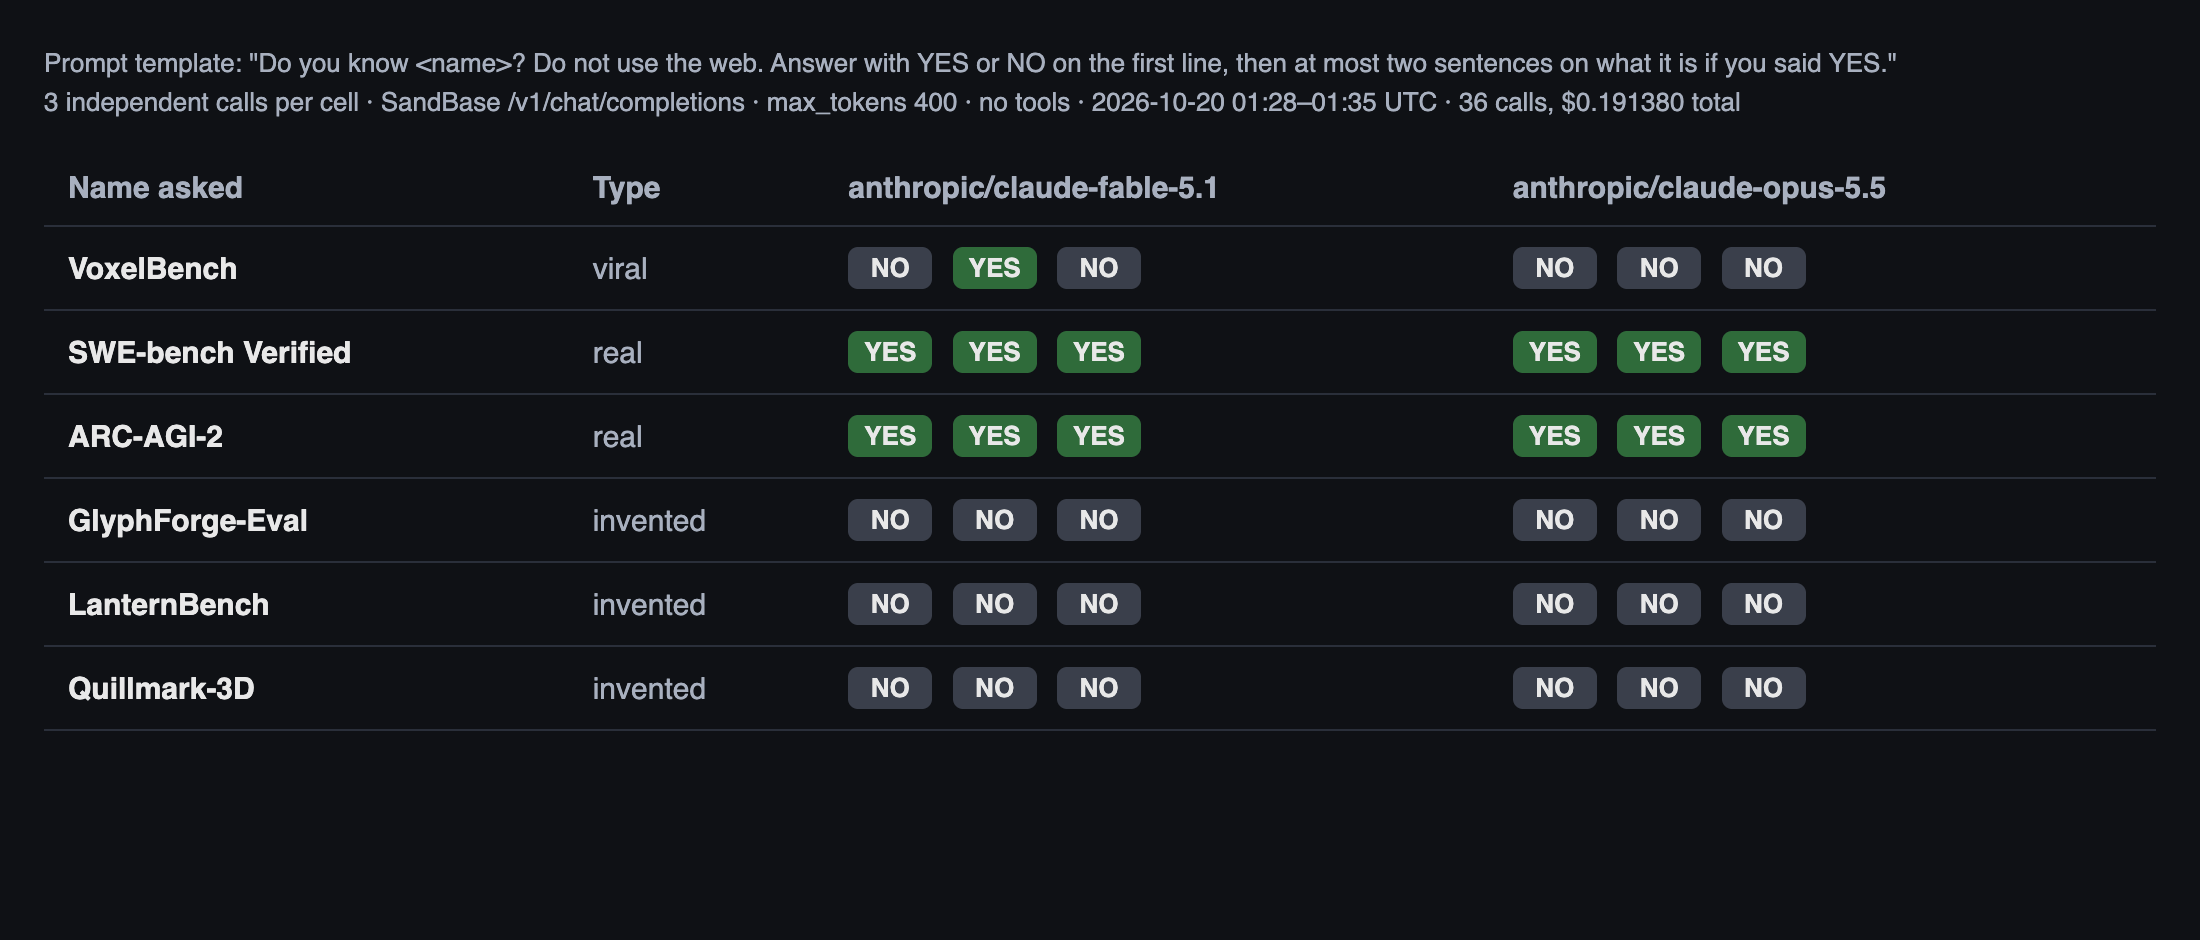 探针结果:2026 年 10 月 20 日 01:28–01:35 UTC,共 36 次调用,合计扣费 $0.191380。每个标签是一次独立响应的第一行,只代表这几次运行,不是稳定比例。
对照组起了作用。SWE-bench Verified 和 ARC-AGI-2,两个模型每次都认得;GlyphForge-Eval、LanternBench、Quillmark-3D,两个模型每次都说不认识,有几次还直接写了“我宁可不猜”。可见这两个模型不会见到像基准的名字就说 YES。
有意思的是 VoxelBench 这一行。Fable 5.1 从 9 月 1 日起就是公开模型,它在第二次回答了 YES:“As far as I recall, VoxelBench is a benchmark for evaluating AI models (LLM”。话没说完,因为碰到了我设的 400 token 上限。另外两次它回答 NO。Opus 5.5 有一次在 NO 之后补了一句,说这个名字“可能和 MC-Bench 类似,那是一个让 AI 在 Minecraft 里搭建筑来比较模型的基准”。
照原帖的规则,我那第二次 Fable 5.1 调用“就是 Fable 5.5”。但它用的是同一个模型 ID,响应里返回的也是 anthropic/claude-fable-5.1。对一个冷门专有名词,回答 YES 还是 NO,光是采样随机性就能让它变。名字在不在训练数据里,说的是语料,不是哪个检查点在给你回话。真要做知识召回探针,就固定一组题、放进虚构对照、多跑几次。即便这样,它也只能估计模型读过什么,回答不了是哪套权重在回答。
测试二:自行车骑鹈鹕
提示词:“Create an SVG of a bike riding a pelican. Return one complete, self-contained SVG file in a single code block.”
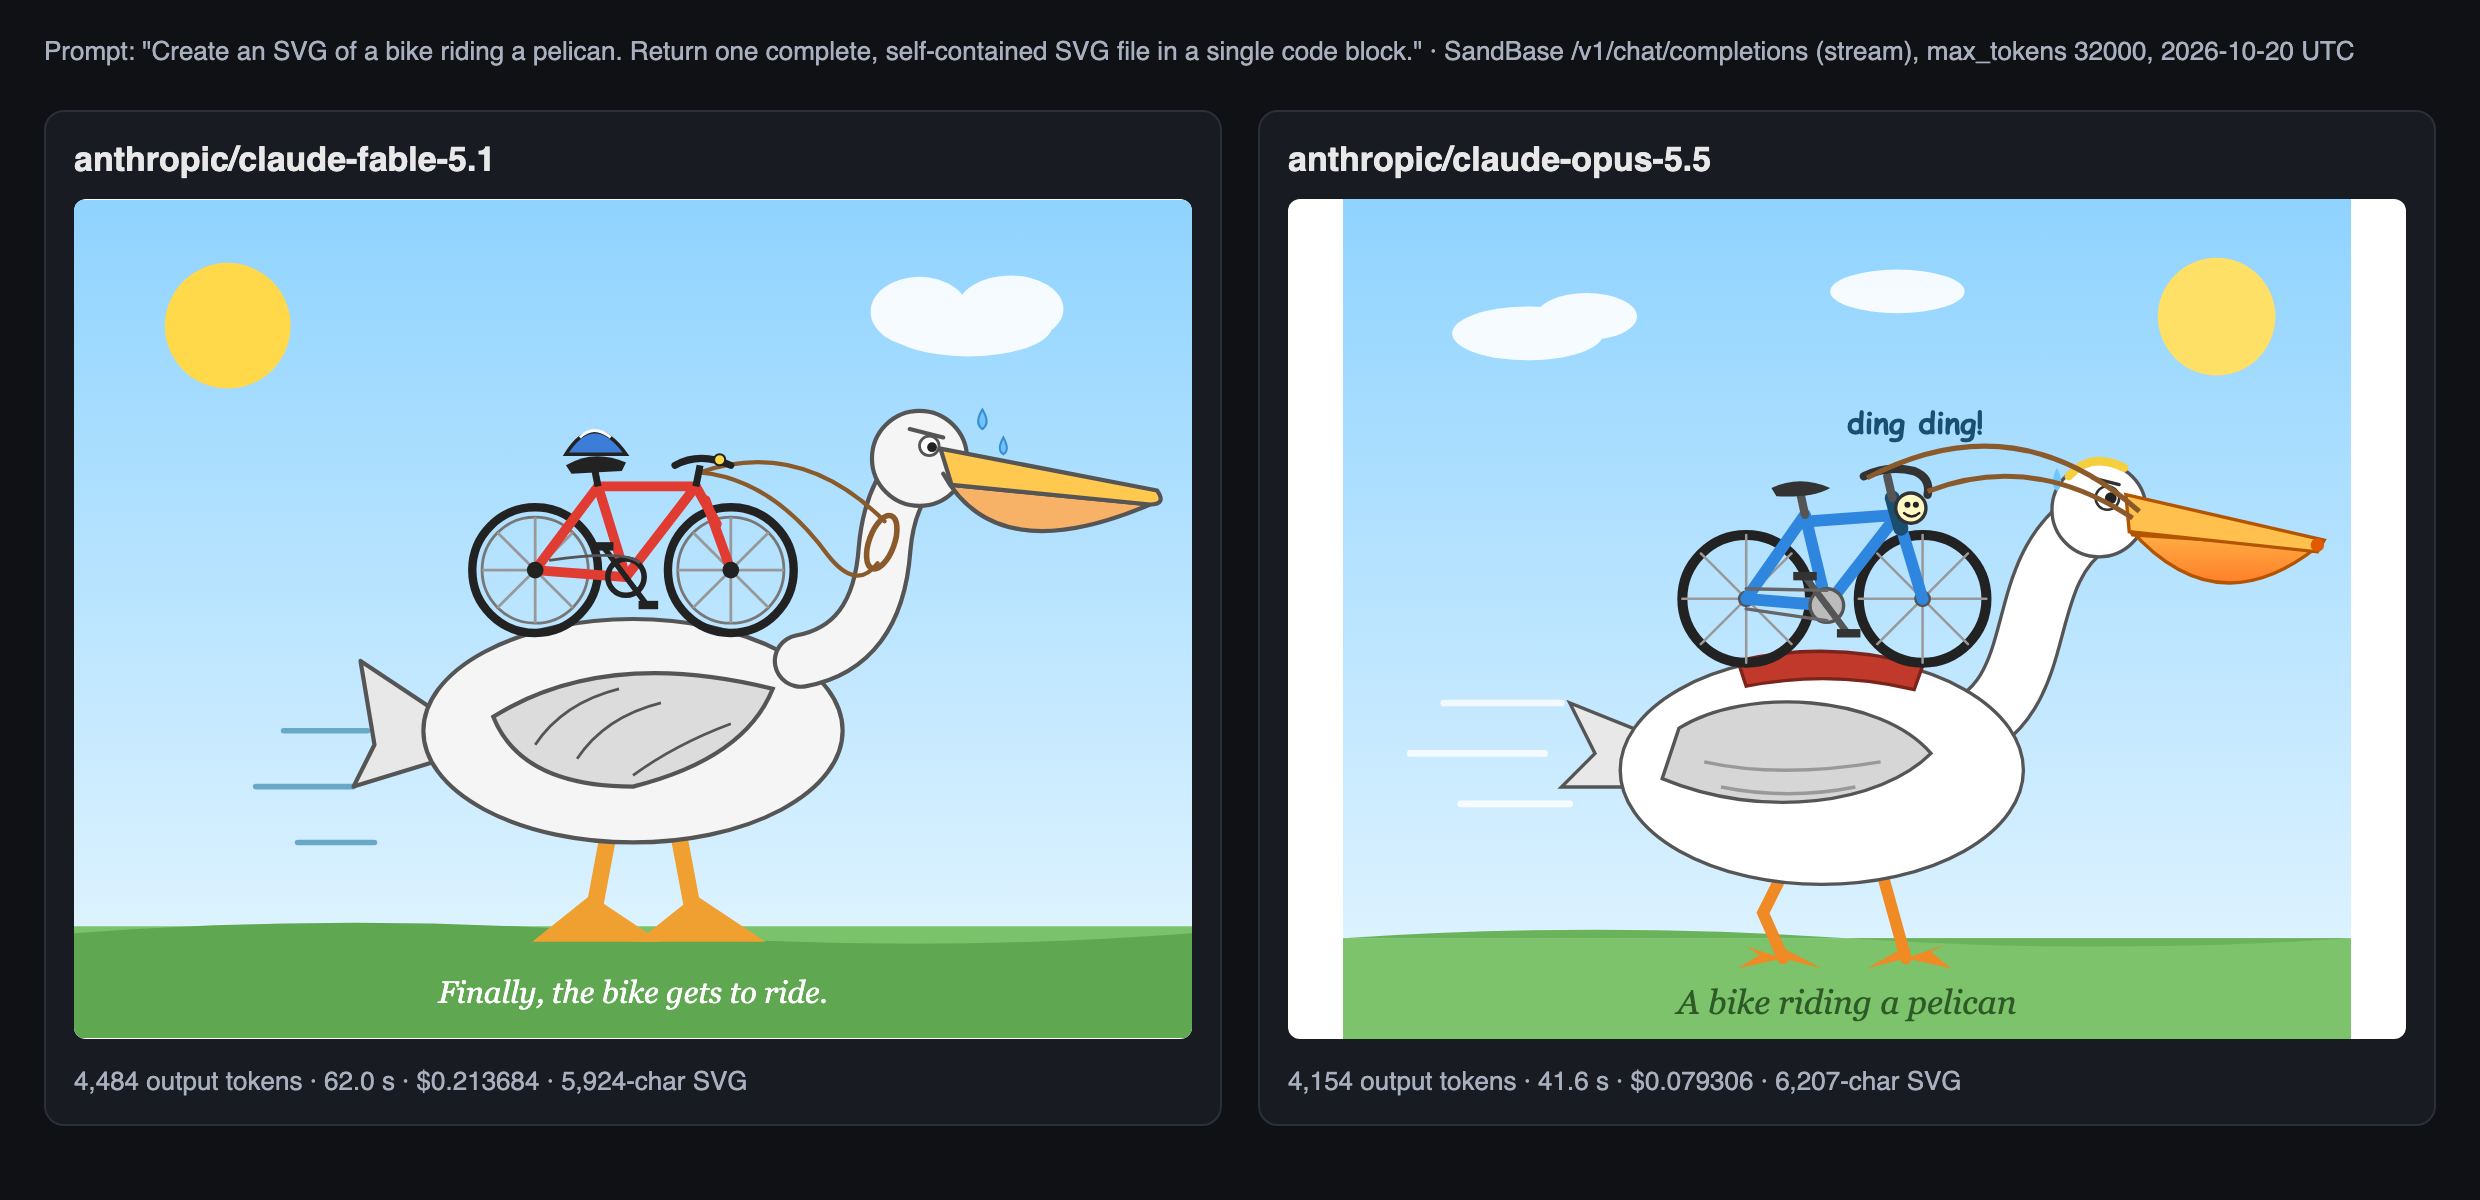 两份 SVG 原样输出,10 月 20 日用无头 Chrome 渲染。token 数、耗时和扣费分别取自每次保存的响应和对应的
/v1/tasks/<id>/cost 记录。每个模型只跑了一次。
两个模型第一次就抓住了这个梗:自行车是骑手,鹈鹕是坐骑。两张图都有从车把连到鸟头或脖子的缰绳、表示速度的线条,还有一句配文。Fable 5.1 在车座上放了顶头盔,鹈鹕皱着眉、头上冒汗,配文是“Finally, the bike gets to ride.”(终于轮到自行车骑一回了)。Opus 5.5 在车把那里画了个小笑脸,给鹈鹕垫了块红色鞍布,还加了“ding ding!”的铃声字样。两份文件都没有断掉的路径,也没有画到画布外的元素。
让我更在意的是两张图有多像。两份文件开头的天空渐变色都是 #8fd3ff,太阳、云和草地的布局也差不多。演示既体现某个模型的能力,也体现同一家族共有的习惯。哪天有一段长这样的“Fable 5.5”视频,它也说明不了出现了新模型。
费用可就不像了。输出长度差不多(4,484 对 4,154 token),Fable 5.1 扣了 $0.213684,Opus 5.5 扣了 $0.079306。两张我觉得水平相当的图,价格差了 2.7 倍。Fable 也更慢,62.0 秒对 41.6 秒。另外,我对这条提示词的第一次 Fable 流式请求只传回 6 个 token 就断了,照样扣了 $0.000978。所以重试次数也得算进成本。
测试三:《The Last Train Home》
这是最难的一题,两个模型也是在这里分开的。
Fable 5.1 输出 5,320 token,里面是一个 457 行的 HTML 文件,一整屏 canvas:雨丝落下,星星闪烁,一排亮着窗的楼,几盏发光的灯笼,电线,标题字,还有一列带红色条纹的银色列车循环驶过屏幕。列车开场时在屏幕外,所以第一帧截图只有一座空城。为了拍下面这帧,我在测试外壳里让页面先同步跑完前 160 个动画帧。模型的代码一行没改。
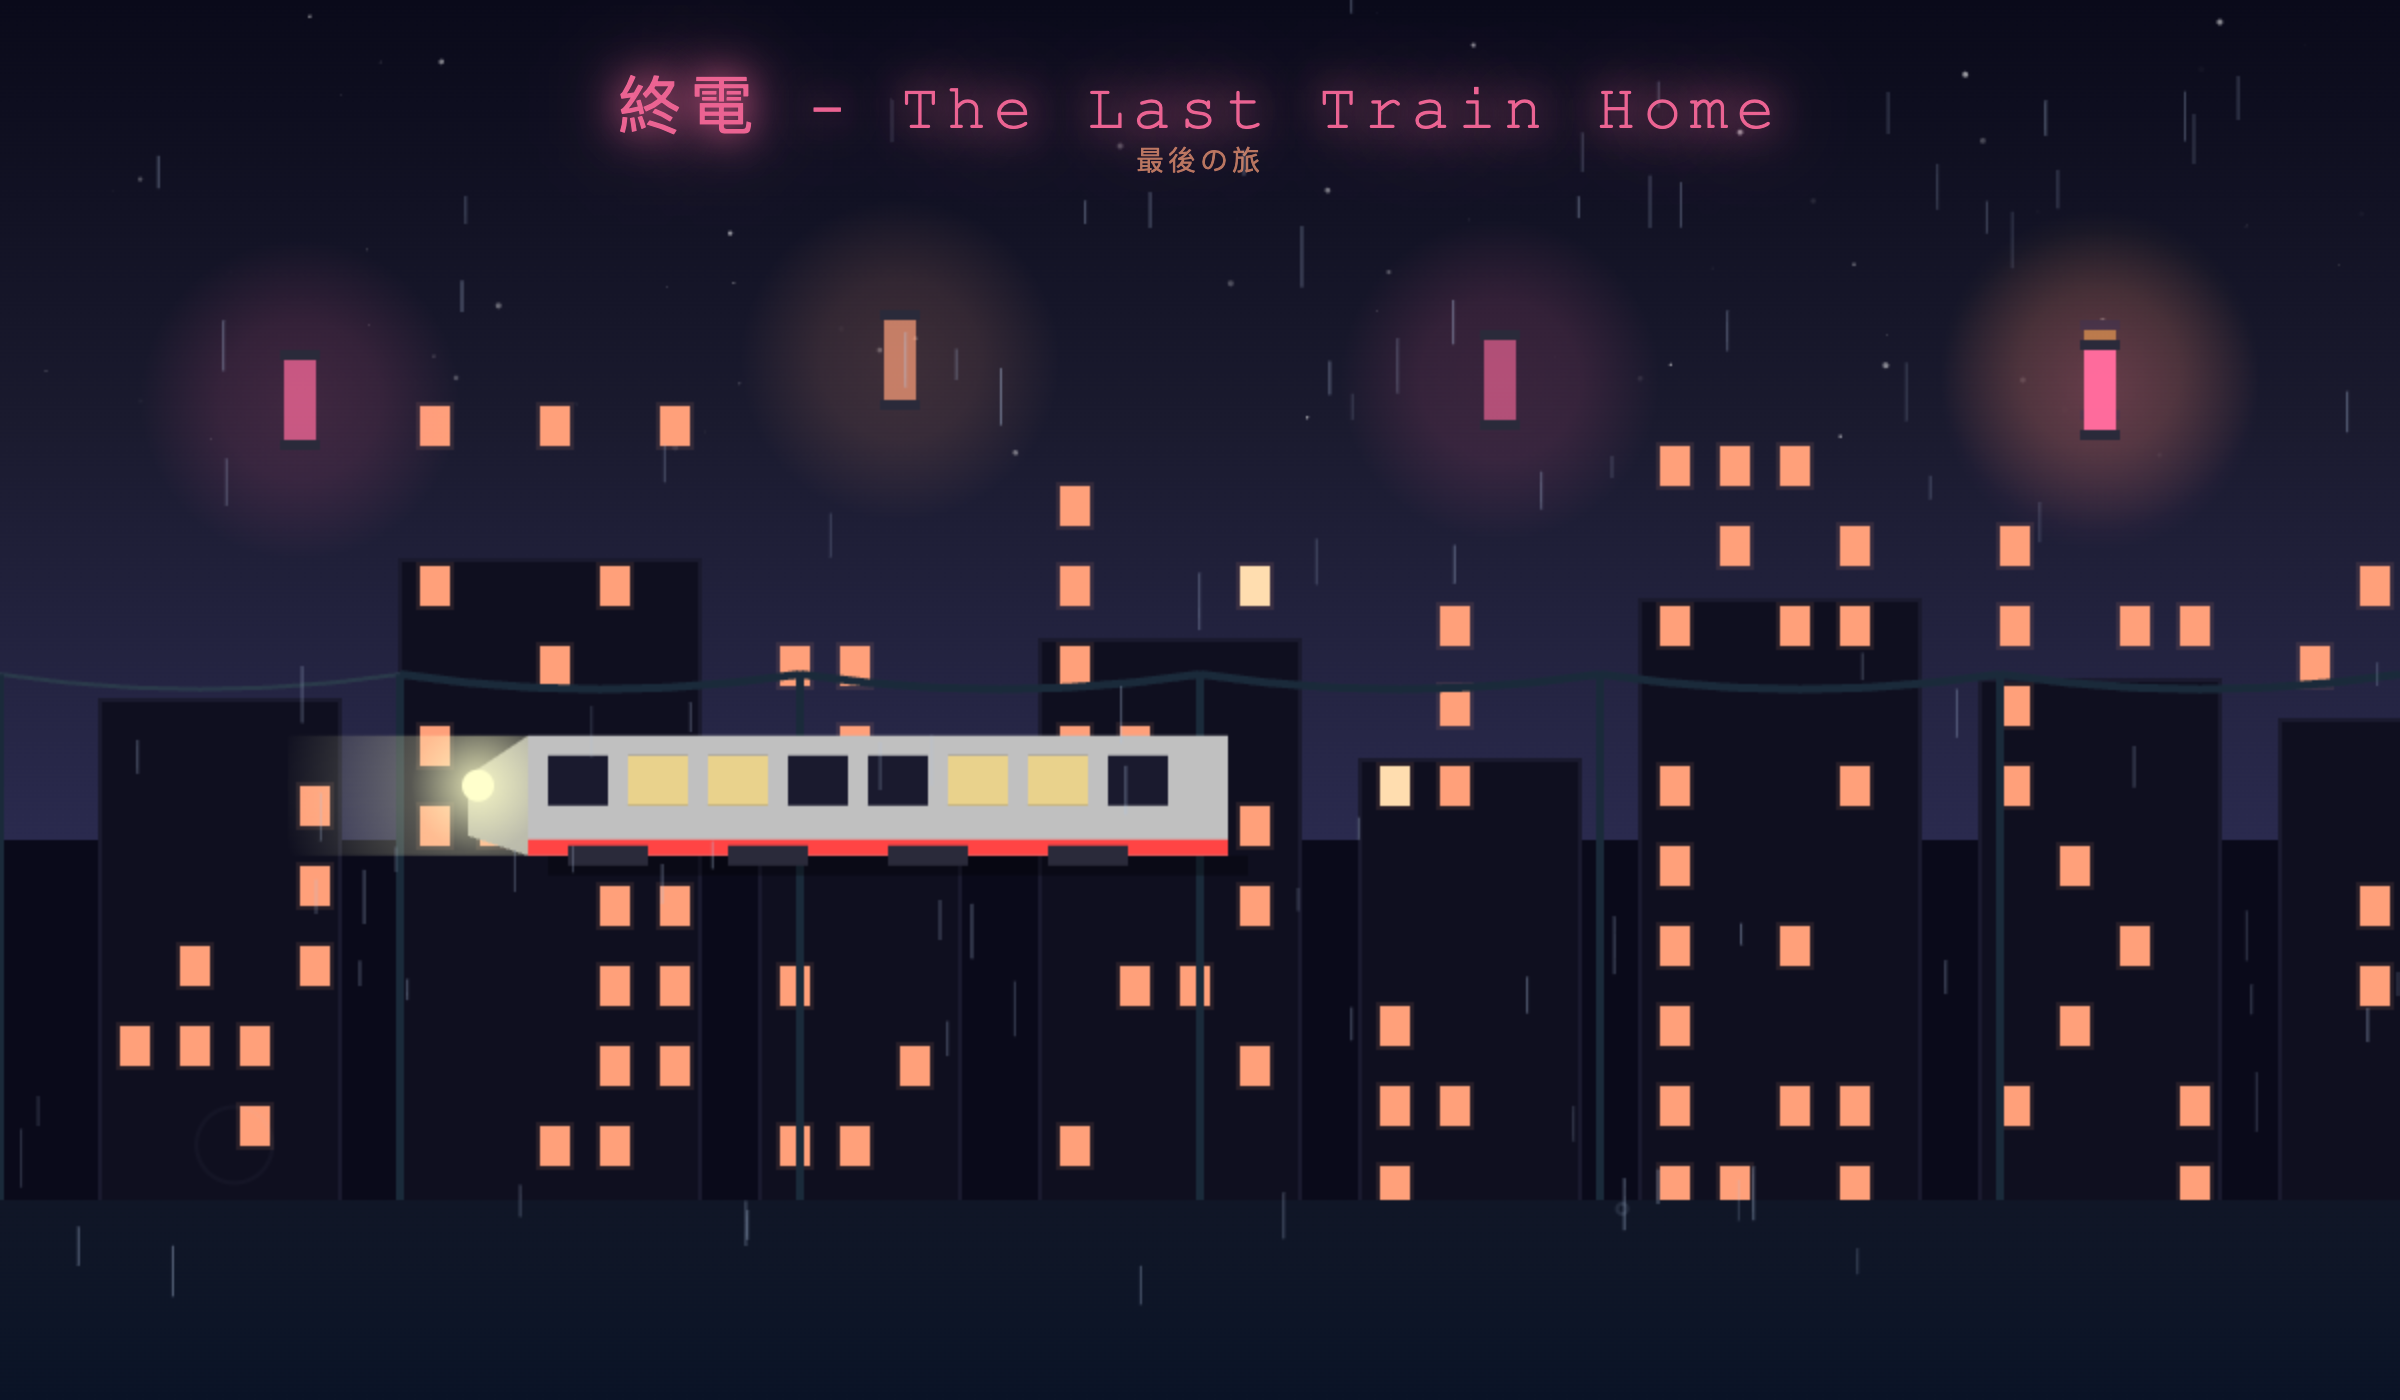 Fable 5.1 输出的第 160 帧,无头 Chrome 1200×700(2 倍像素)渲染。推进帧数的是测试外壳,HTML 是模型原样返回的文件。
乍一看,这符合题目要求。仔细看有三个问题。车头灯和斜车头画在列车左端,可代码让列车每帧向右移动 4 像素,结果它是倒着开的。列车停在屏幕 60% 高度的位置,直接从楼房立面前横穿过去,下面没有轨道,也没有高架。至于“被雨打湿的路面”,只是一条平平的深色带子。代码里写了倒影层,但在我渲染的几帧里,看不到积水,也看不到灯笼的倒影。每一处都能靠下一轮对话一行代码修好,可在一段 10 秒的视频里,这些问题根本看不出来。
这次运行我给不出干净的耗时。第一次流式请求在客户端断开了。之后同一提示词的重复请求,都在 3 秒内返回了逐字节相同的内容,所以那几个耗时反映的是重复返回,不是一次生成。保留下来的那次请求扣费 $0.257400;所有尝试加起来一共扣了多少,我还没有对完账。
Opus 5.5 没有交出场景。走 Anthropic 协议 /v1/messages 流式接口的那次,跑了 361.3 秒,以 stop_reason: max_tokens 结束。usage 里 output_tokens: 32000,全部记为 thinking token,没有任何文本块。按标价(输入每百万 $4、输出每百万 $20)算大约 $0.64,这次调用我没拿到 task 费用记录。在那之前,三次 OpenAI 格式的流式请求都在一分钟左右提前中断;之后把预算调到 64,000 token 又试了三次,全部卡在传输层。前后至少七次,一行 HTML 都没有。其中一部分失败可能出在连接上,不在模型本身,我不把它们算作对模型的判定。
唯一干净的那次数据还是有参考价值:在自适应思考始终开启的情况下,一个开放式创意题,可能在动笔写代码之前就把整个输出预算花光。如果你要用 Opus 5.5 生成大型单文件产物,记得检查 stop_reason,预算要明显高于预期的文件大小;在断定模型做不到之前,先试试调低 effort。发演示的人不会给你看那次想了六分钟、最后什么都没交的运行。
这对看 Fable 5.5 演示有什么启发
| 爆款说法 | 已发布模型上的实测 | 怎么理解 |
|---|---|---|
| “VoxelBench 答 YES 就是 Fable 5.5” | 已发布的 Fable 5.1 三次里有一次答 YES | 探针会误报 |
| “Fable 5.5 画 SVG 很强” | Fable 5.1 和 Opus 5.5 都一次画好了倒过来的鹈鹕 | 不能证明出了新模型 |
| “Fable 5.5 做出了《末班车》” | Fable 5.1 做出了能动、但有可修瑕疵的场景;Opus 5.5 思考耗尽了预算 | 好看的片段可能只是一次跑得好,不一定换了模型 |
Fable 5.5 很可能在这三题上都更强,但它发布之前我没法测。只是眼下这些流传的片段证明不了这一点。这么短的提示词,已发布的模型本来就做得到。对团队真正重要的是每个合格结果的成本、运行失败的频率、要追问几轮才能修好,而这些,片段里一样都看不到。
自己跑一遍
两个已发布模型今天都能在 SandBase 上调用:Claude Fable 5.1 和 Claude Opus 5.5。anthropic/claude-fable-5.5 目前返回 404 model_not_available,有一个即将上线页面。所以现在能做的对比,就是先把基线跑出来。提示词和参数保持不变,等 Fable 5.5 的 ID 上线,只改模型字符串再跑一遍,除了看图,也比一比实际扣费和失败率。
常见问题
现在能测试 Claude Fable 5.5 吗?
公开 API 上不能。截至 2026 年 10 月 20 日,Anthropic 没有公布 Fable 5.5 的模型 ID,SandBase 对 anthropic/claude-fable-5.5 返回 model_not_available。标着 Fable 5.5 的演示,都来自自称有提前访问或被路由到新模型的人,没有一条能核实。
VoxelBench 这个问题能告诉我在和哪个模型对话吗?
不能。在我们的对照测试里,已发布的 Fable 5.1 三次里有一次回答了 YES。模型对自己知道什么的回答是生成出来的文本,每次采样都可能不同。
做创意编程,Fable 5.1 和 Opus 5.5 哪个便宜?
在我们那一次 SVG 测试里,输出长度和质量相近,Opus 5.5 花了 $0.079306,Fable 5.1 花了 $0.213684。但 Opus 5.5 遇到开放式题目也可能把预算全用在思考上,比如这次的火车场景,所以失败的运行也要算进成本。
为什么我的 Opus 5.5 调用没有返回文字?
先看 stop_reason。我们那次是 max_tokens,32,000 个输出 token 全是思考。可以调高 max_tokens、调低 effort,或者把题目收窄。
测试材料,包括提示词、原始响应、usage 与费用记录、渲染脚本,都保存在本文的工作目录里。运行时间:2026 年 10 月 20 日 01:28–02:57 UTC。