Exa vs Tavily vs Firecrawl:Agent 该用哪个网页 API,何时串联(2026)
给 Agent 选网页 API:Exa 做语义搜索,Tavily 是研究工具箱,Firecrawl 负责抓取和爬取。讲清何时单用、何时串联,以及 SandBase 目录一把密钥怎么按次计费。
搜 Firecrawl vs Exa vs Tavily,出来的多半是三家放在一张表里打分。Agent 真正卡住的地方不是名次。问题还没有 URL,这是发现。URL 或文档站已经在手上,这是抓取。两步都要,才值得串联。SandBase 目录把三家放在一把密钥和同一余额上,但不替你选冠军。要日期明确的命中率和延迟,看 每月实测榜。要把 SerpAPI、Google Custom Search 和「已知 URL 转 Markdown」放进同一张矩阵,看 五工具选型(2026-07-30 发布,2026-11-06 更新)。这篇不重跑那两页,也不封一个放之四海的最佳搜索 API。
先说结论
- 先看输入。没有 URL 的问题,用语义搜索或研究向搜索。已经知道页面或站点,用网页抓取、站点爬取或批量抓取。搜索不等于抓取。
- 同一家的下一步已经能交出模型要读的正文,就不要再买第二家。
- 串联只发生在「发现」和「深读」是两件活的时候。多一个 logo 不是方案。
- 2026-11-08 读到的卡片:符合条件的数据 API,每个组织每个 UTC 日共享 100 次免费调用。下面有几条端点不在这份额度里,成功调用从第一次就按目录价计费。
- 这篇没有发请求,没有测延迟,没有排行,也没有搜索量。
三家不是同一件活
把「能上网」买成一个 SKU,后面就会用标题充正文。搜索交出来的是候选页。Scrape 和 Crawl 交出来的是页面本身。演示里看起来完整的摘要,上线后经常只够模型编一段不存在的细节。
| 你手里有什么 | 要完成的事 | 这份目录上的默认 |
|---|---|---|
| 一个问题,还没有 URL | 找页面 | Exa Search,或 Tavily Search |
| 要一段带来源的回答,并且你会回看出处 | 和搜索分开的问答 | Exa Answer |
| 已知 URL,普通页面正文就够 | 抽取或抓这一页 | Tavily Extract,或 Firecrawl Scrape |
| 已知站点、很多页,或一批 URL | 画站点、爬站或批量抓 | Firecrawl 的 Map、Crawl、Batch Scrape。Tavily Map 只发现 URL,不交全文 |
| 搜索引擎自己的结果页 | 经典 SERP | 不是这三家。去五工具那篇 |
Crawlfolio 的对照 在 2026-10-31 核过各家标价,也不做质量排名:Tavily 和 Exa 按问题找页,Firecrawl 读你已经点名的页。那页上的积分算术不是 SandBase 的账单。下面的美元数只来自 SandBase 卡片。
Exa:语义搜索,再加上 Contents 和 Answer
2026-11-08 读到的 Exa 搜索文档 写的是:搜索端点既能搜网页,也能从结果里抽出内容。到了 SandBase,这是三次 POST,不是一个大包。Exa 目录页 把三条都列出来,并写明:用 Answer 之前,先核对它引用的页面。
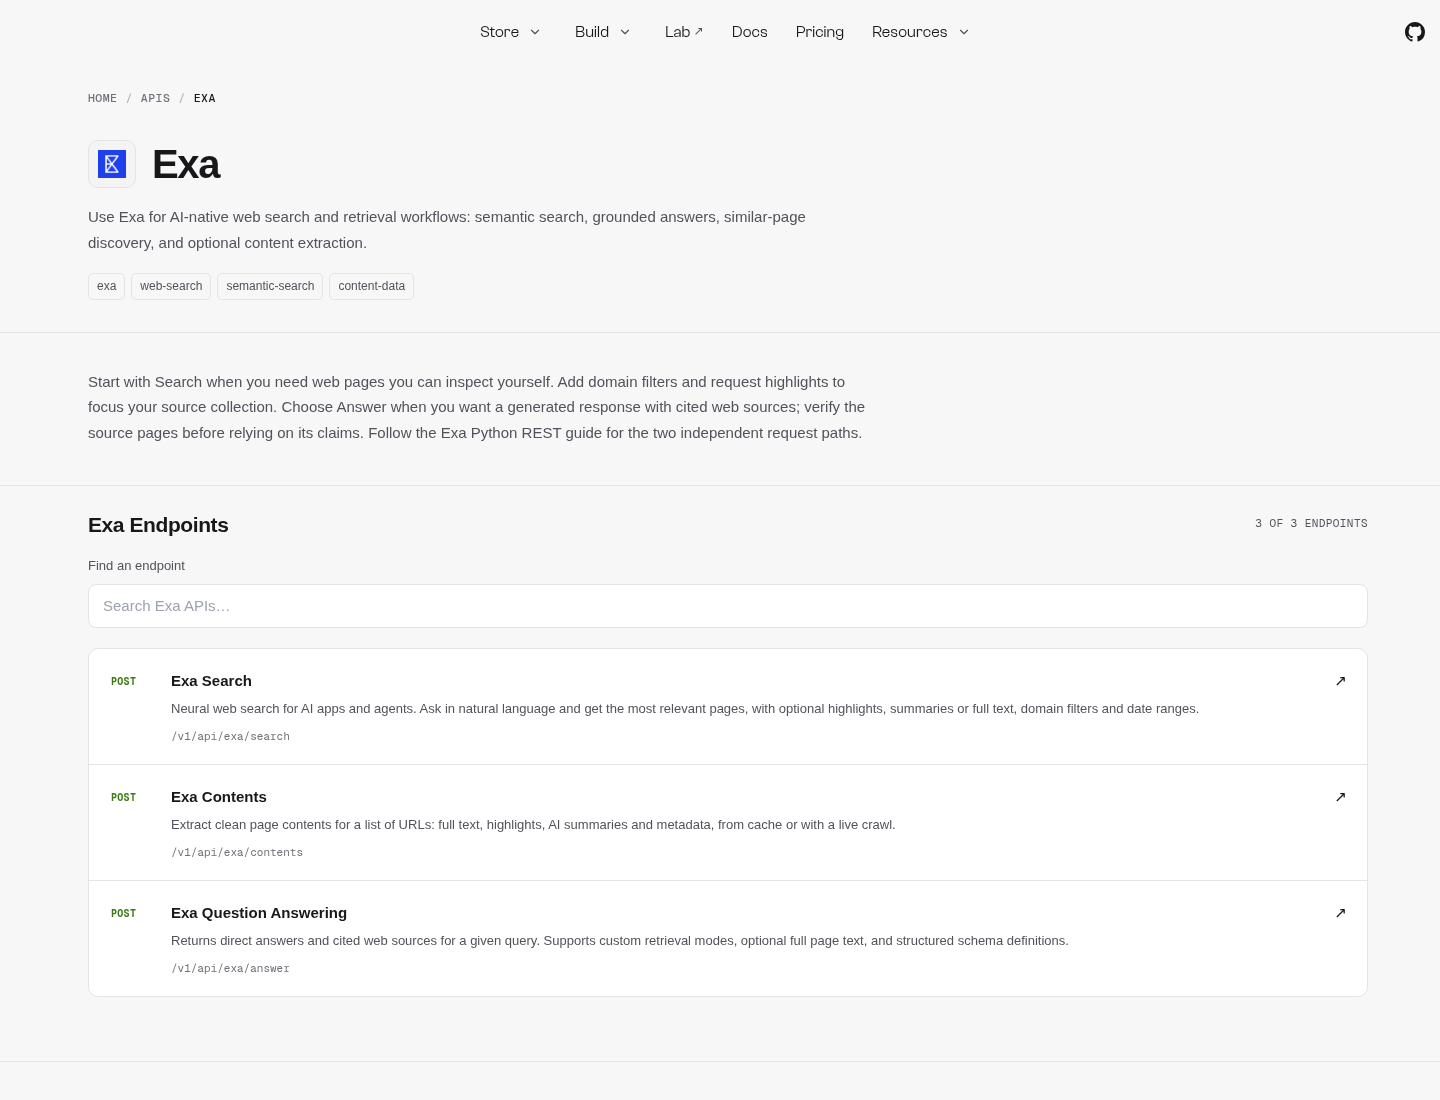 SandBase Exa 目录页:一把密钥下的 Search / Contents / Answer,面向语义发现。
POST /v1/api/exa/search 做自然语言检索,可以要 highlights、摘要或全文。Exa Search 卡片 的示例体是 query、type、numResults 和 contents.highlights,结果在 outputs[0].data。这篇没有发出这条请求。Search 的过滤不会带进 Answer。POST /v1/api/exa/contents 按 URL 列表取正文。POST /v1/api/exa/answer 给引用回答,省事,但不能代替打开那些页面。
Tavily 自己的对比文 承认:语义或专项发现是核心时,Exa 够用;然后他们把自己写成那一组里的整体首选。这是厂商结论,不是这篇的实测。
Tavily:目录里实际列出的研究工具箱
同一篇 Tavily 文章说,他们自己的平台把 Search、Extract、Crawl、Map、Research 放在一起。2026-11-08 的 SandBase Tavily 页 只列了三条。Crawl 和 Research 不在里面。目录没写的产品,不要默认这把密钥已经买到了。
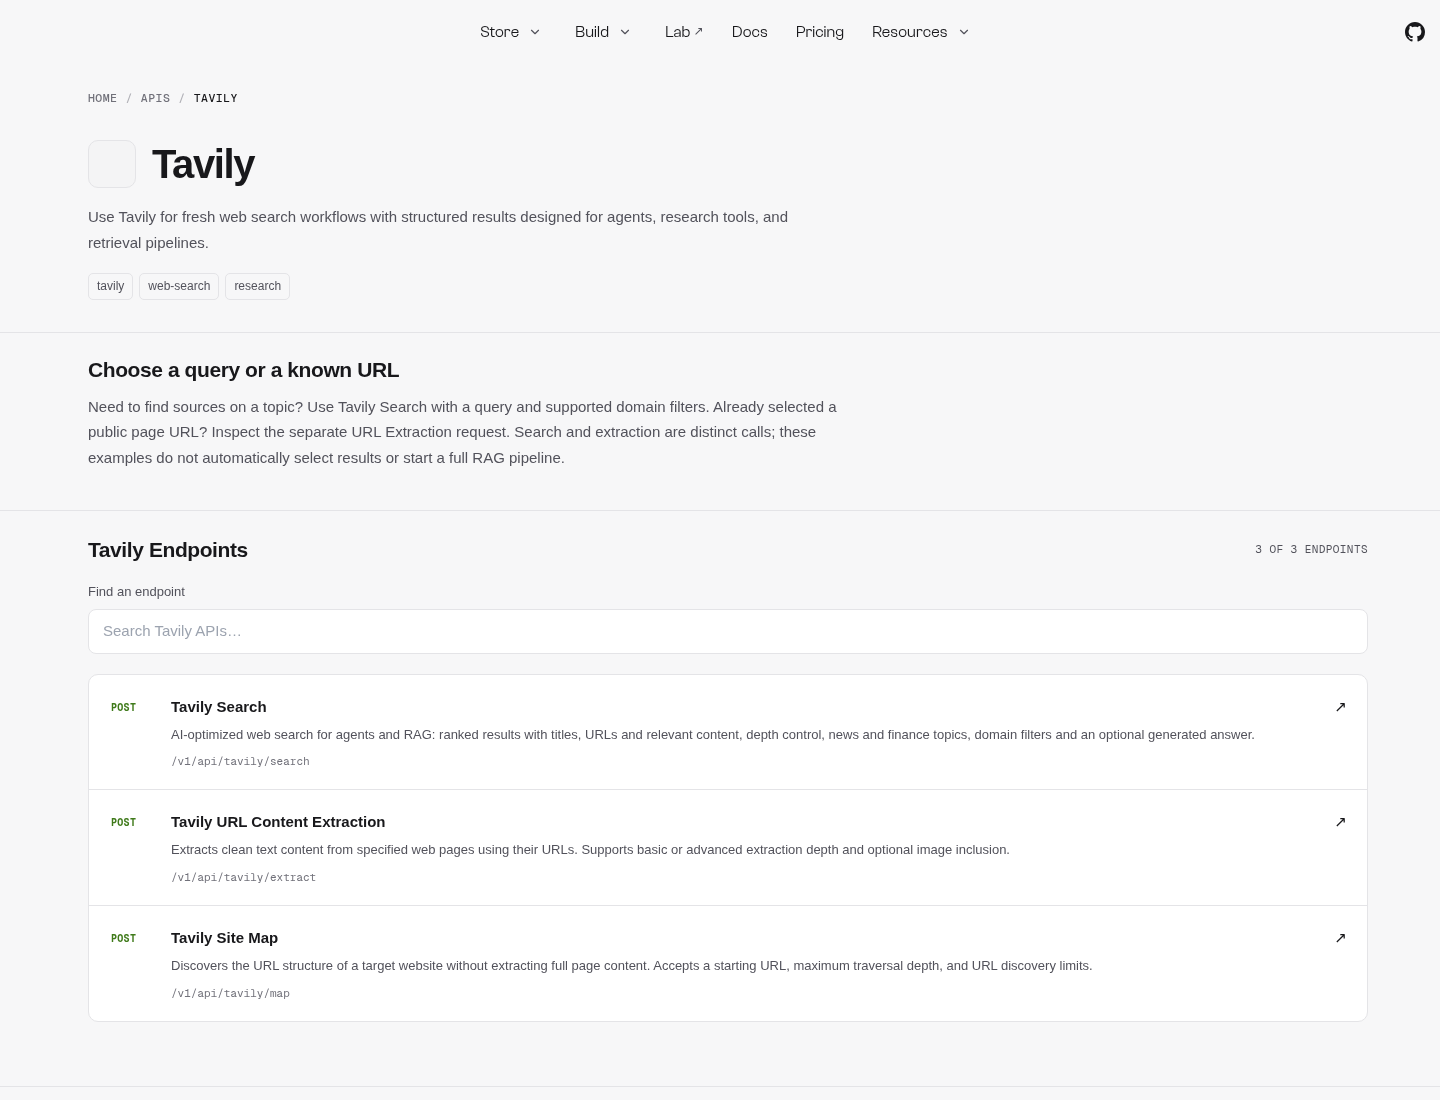 SandBase Tavily 目录页:Search / Extract / Map,作为同一余额上的 Agent 研究工具箱。
POST /v1/api/tavily/search 返回排序结果,可调深度、主题和域名,也可以要一段生成回答。POST /v1/api/tavily/extract 从你给的 URL 抽正文。目录页写明两次调用是分开的,不会替你挑结果,也不会自动开 RAG。POST /v1/api/tavily/map 只发现 URL,不抽全文。要渲染后的站、整站爬取或一批已知 URL,换工具。
Firecrawl:抓取和爬取为主,搜索是五条里的一条
Firecrawl 介绍 把自己叫成 Agent 的上下文 API:搜索、抓取,输出 Markdown 或结构化数据。SandBase 的 Firecrawl 页 列了单页抓取、整站爬取、画链接、批量抓和搜索。搜索发现候选,爬取是另一件多页任务。「已知 URL 怎么变成 Markdown」留在选型指南里,这里不重写请求。
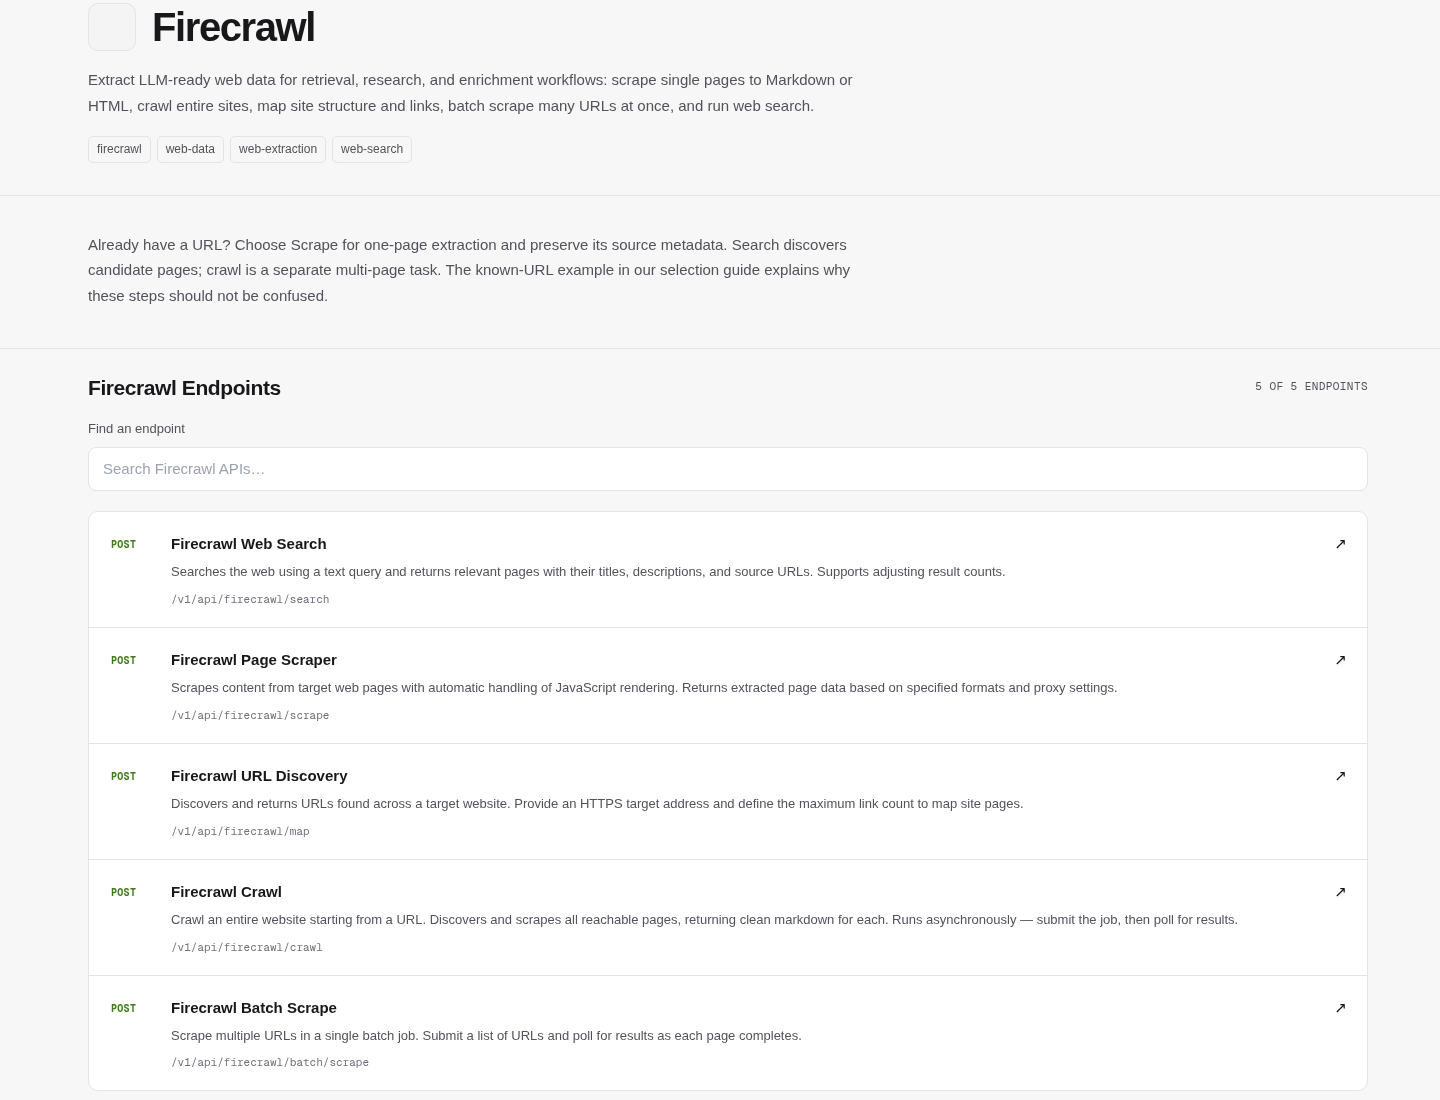 SandBase Firecrawl 目录页:Search / Scrape / Map / Crawl / Batch Scrape,覆盖已知页面与站点抓取。
Scrape 打一页,卡片描述包含 JavaScript 渲染。Map 返回 URL。Crawl 和 Batch Scrape 是异步的。路径在下面的表里。Tavily 那篇对比写:要采集或盯具体网站,选 Firecrawl。搜索端点在目录上。URL 已经在手里时,你不是冲着搜索来的。
什么时候一家就够,什么时候才串联
串联是两件活。不是幻灯片上三个 logo。
一家就够的时候
问题从模糊问句开始,Exa Search 的 highlights、内联正文,或再补一次 Contents,已经是你要留给模型的文本,而且你不爬文档站。停在 Exa。
Tavily Search 加 Extract 能覆盖那些 URL,你也不需要整站爬取或批量任务。只要 URL 清单时,用 Map。停在 Tavily。
URL 或域名已经知道。Scrape、Map、Crawl 或 Batch Scrape 就是全部工作。先跑一遍 Search 是绕路。停在 Firecrawl。
你还想少接一种返回结构。 Research Agent 实测 量过这类单厂商组合,包括 Exa search 加 contents、Tavily search 加 extract、Firecrawl search 加 scrape。数字在那篇。这里不搬表。
第二件活是真的,再串联
发现和深读不是同一步,才串联。Exa 或 Tavily 先把 URL 缩到短名单。页面要渲染后的正文、要整个站点,或搜索结果里根本没有完整正文,再交给 Firecrawl 的 scrape 或 crawl。
摘要和 highlights 不是文档本身,也该串联。停在搜索,模型会把缺的那一节补上。
问句适合 Exa,短名单落到一个文档站,这个站适合 Firecrawl,这是跨厂商的理由。页面很普通时,留在 Exa Contents 胶水更少。Contents 接不住的抓取,再挪到 Firecrawl。哪一种组合在实测里站得住,看 Research Agent 那篇,不要在这里新造一张准确率表。
同一页买两次,就不串联:搜索已经带回正文,又对同一个 URL 刮一遍,需求没有变。删掉其中一次。
四条配方,不报假延迟
下面只是调用顺序。这篇没有执行,也不给耗时。
POST /v1/api/exa/search,只留下真要读的 URL,再POST /v1/api/firecrawl/scrape。短名单其实是一个文档站,而不是几篇文章,改用POST /v1/api/firecrawl/crawl。Crawl 异步,卡片按页计价,不是一笔搜索的一口价。POST /v1/api/tavily/search,再对留下的 URL 调POST /v1/api/tavily/extract。同一家。目录页写明两次调用是分开的。POST /v1/api/exa/search先要 highlights,确定 URL 之后再POST /v1/api/exa/contents取全文。Contents 不在每日免费次数里。差价看下一节。- 想留在 Firecrawl:
POST /v1/api/firecrawl/search再POST /v1/api/firecrawl/scrape。在这份目录上,Search 不进每日免费次数,Scrape 进。同一家,第一步仍可能从第一次调用就扣费。
还要接 X 或 YouTube 的个人研究助手,看 一把 Key 的实战。更收束的研究简报教程是后面的一篇。循环、提示词和简报模板不在这里。
2026-11-08 目录上实际能调什么
首页 的标题是 “One API Key. Build and run AI agents.” 同一屏写着 Agent 和沙箱免费,以及符合条件的数据 API 每日 100 次免费调用。“2,000+ models and APIs across 100+ platforms” 是站点自己的说法。这篇没有去数目录,也没有发调用。
API 索引 把 Exa 和 Tavily 放在 search,把 Firecrawl 放在 web scraping。厂商列表给路径。端点卡片给价格。当天打开的三家列表页没有印美元数字,卡片上有。
端点地图
| 调用 | 卡片描述里的活 |
|---|---|
POST /v1/api/exa/search | 语义搜索。可选 highlights、摘要或全文。 |
POST /v1/api/exa/contents | 按 URL 列表取页面内容。 |
POST /v1/api/exa/answer | 带来源的回答。先核对出处。 |
POST /v1/api/tavily/search | 面向 Agent 的搜索。可选生成回答。 |
POST /v1/api/tavily/extract | 抽取你传入的 URL。 |
POST /v1/api/tavily/map | 发现站点 URL,不是全文。 |
POST /v1/api/firecrawl/search | 查询进,标题、描述、URL 出。 |
POST /v1/api/firecrawl/scrape | 单页。卡片描述包含 JavaScript 渲染。 |
POST /v1/api/firecrawl/map | 站点 URL。 |
POST /v1/api/firecrawl/crawl | 异步爬站。轮询拿 markdown。 |
POST /v1/api/firecrawl/batch/scrape | 异步批量 URL。 |
业务载荷按 Exa Search 卡片写的,从 outputs[0].data 读。别的端点先打开 schema,再假设字段。这里不贴任何响应体。
先看目录价和免费次数,再写循环
当天的 定价页 把模型、API 和运行时放在同一余额:按次计费,没有月费,每一笔出现在 Activities。每个方案都包括:部分模型最高 35% 折扣,卡片价就是成交价;每日 100 次免费调用,符合条件的数据 API 共享,00:00 UTC 重置;Discovery 为 $0,也就是搜目录、读 schema 和价格不扣余额;沙箱目前 $0,可能有公平使用上限,改价会提前说;失败调用 $0。方案本身:Start 为 $0,带试用额度;Build 是 Metered,文案是 “Pay per call. No subscription.”;Scale 是 Custom。
端点卡片再给单次价格。在额度内的卡片写着 “First 100 calls per day free (shared per organization)”,并说明这 100 次是符合条件的 SandBase API 共享的,用完之后按卡片价从余额扣。没有这块徽标的卡片,成功调用从第一次就开始计费。两类卡片都写失败调用不收费。
| 端点卡片 | 2026-11-08 页面上的价格 | 是否在共享的 100 次里 |
|---|---|---|
| Exa Search | 每次 $0.0105 | 在 |
| Exa Contents | 每次 $0.0045 | 不在 |
| Exa Answer | 每次 $0.0075 | 在 |
| Tavily Search | 每次 $0.012 | 在 |
| Tavily Extract | 每次 $0.012 | 在 |
| Tavily Map | 每次 $0.012 | 不在 |
| Firecrawl Search | 每次 $0.015 | 不在 |
| Firecrawl Scrape | 每次 $0.0075 | 在 |
| Firecrawl Map | 每次 $0.0075 | 在 |
| Firecrawl Crawl | 每次从 $0.0075 起 | 不在 |
| Firecrawl Batch Scrape | 每次从 $0.0075 起 | 不在 |
Crawl 和批量抓取不是一口价 $0.0075。页面上的标签是 “From $0.0075 per call”。同一天的目录载荷里,crawl 的 price_formula 是 Math.max(1.0, Math.max((output.completed ?? 0) * 1.0, len(output.data ?? []) * 1.0)) * 0.0075,批量抓取是 Math.max(1.0, len(params.urls ?? []) * 1.0) * 0.0075。Crawl 卡片还说,示例请求大约按 $0.0075 计。页数一多,就是另一个数。爬站之前先看卡片。
较早的 Research Agent 文把 exa/contents 和 firecrawl/search 标成不在每日免费次数里。这两条和当天卡片仍然一致。卡片上同样不在额度里的,还有 Tavily Map、Firecrawl Crawl、Firecrawl Batch Scrape。以当天卡片为准,不要只记住那两个例外。
一条链里两次符合条件的调用,是从同一个 100 里扣两次,不是各送 100 次。模型 token 不在这份额度里。几本账怎么放在同一余额,看 按次计费。
一把密钥,旁边还有模型和沙箱
目录不负责宣布 Exa、Tavily 或 Firecrawl 谁赢。它拿掉的是三套厂商账号:一把密钥,调用前能读 schema 和价格,和模型调用同一份余额。沙箱页 是另一行。它的定价回答写:创建、运行、停止目前不扣余额,可能有公平使用上限,改价会提前宣布,Agent 调用的模型和 API 照常计费。
只做模型路由的网关,不会替你选这一层网页工具。那条界线在 网关什么时候不够。密钥、数据 API 和沙箱收成一个账号,是 一把密钥的技术栈。这篇停在网页工具怎么选。
开放网页的抓取,接不住社交平台
抖音、小红书、微博、TikTok 和 X,不是「丢给 Firecrawl 的一个 URL」。这些页面经常要登录、要翻页,也经常超出通用抓取能拿到或被允许拿的范围。结构化平台接口、爬虫、官方 OAuth 怎么分,看 社交数据接口。开放网页用 Exa、Tavily 或 Firecrawl。来源是平台本身,用平台目录。
经典 SERP 工具什么时候仍然对
Agent 要的是搜索引擎自己的结果页:广告、本地结果盒、那家引擎的排序,或必须按 SERP 复现的查询。这时 SerpAPI 和 Google Custom Search 仍然对。拿它们做语义搜索的默认,或拿它们把文档站收成 markdown,都不合适。那张矩阵,包括这篇故意不重写的 Firecrawl「URL 到 Markdown」一节,在 五工具对比。Brave 出现在每月实测里,不在这里。
该打开 SandBase 的哪一篇
| 你要的东西 | 打开 |
|---|---|
| 五家工具,含 SerpAPI 和 Google Custom Search,外加已知 URL 的 Markdown 走读 | 搜索 API 怎么选 |
| 带日期的命中率、延迟和成本表 | 2026 年 11 月每月实测。best-ai-search-apis-agent-workflows-2026 在 2026-11-08 返回 301,落到这篇 |
| 量过的 Agent 组合:search 加 contents、search 加 scrape、search 加 extract | Research Agent 实测 |
| 还会调 X 和 YouTube 的助手 | 个人研究助手实战 |
| 模型、数据 API、沙箱一把密钥 | 一把密钥的技术栈 |
| 共享的 100 次在预算里盖住什么、盖不住什么 | 按次计费 |
| 模型网关仍然不抓网页 | 网关不够用的时候 |
| 平台社交数据,对照开放网页抓取 | 社交数据接口 |
这篇是任务、串联和目录。它不是实测榜,也不是教程。
常见问题
给 AI Agent 用,该选 Exa、Tavily,还是 Firecrawl?
按活选。问句还很模糊,要语义搜索、可选的 highlights 或全文、单独的 contents,或一段你仍要核对的引用回答,开 Exa。要的是目录里列出的研究工具箱,搜索、抽取、画站点,开 Tavily。URL 或站点已经知道,要单页抓取、爬站、画链接或批量抓,开 Firecrawl。Firecrawl Search 存在。活是采集时,它不是你选 Firecrawl 的理由。三家里没有一个是不带任务限定的最佳网页搜索 API。
什么时候把 Exa 或 Tavily 和 Firecrawl 串联?
发现和深读是两步的时候。先用 Exa 或 Tavily 搜索,再在需要更完整的页面、JavaScript 渲染后的内容、整个站点,或搜索载荷里没有的批量页面时,用 Firecrawl 抓取或爬取。普通页面够用,就留在一家里面:Exa 的 search 再 contents,Tavily 的 search 再 extract,或 Firecrawl 的 search 再 scrape。第二家只在第二件活成立时加上。
SandBase 会不会改变 Exa、Tavily、Firecrawl 怎么选?
它不选赢家。2026-11-08,一把密钥、一份余额能打开三家的卡片。调用前可以读 schema 和目录价。符合条件的数据 API 每个组织每个 UTC 日共享 100 次。上表写了不在额度里的端点,其中包括 Exa Contents 和 Firecrawl Search。模型调用另计。以后再读,重新打开卡片。要测试数字,看 每月实测 和 Research Agent 实测。要 SerpAPI 和 Google Custom Search,看 五工具指南。
选定之后做什么
从 SandBase 登录 建一把密钥。先打开 Exa、Tavily、Firecrawl 的目录页,再打开具体端点卡片。看价格,也看这张卡片有没有每日免费次数的徽标。跑一条搜索,再跑一条抓取或抽取。到 Activities 里对两行账,不要把两次调用看成一笔混合费用。第二次调用没有改变模型能引用的内容,就把它从链里拿掉。上面的价格表是 2026-11-08 从那些卡片读到的。