AI Agent 用哪个搜索 API?每月实测榜(2026 年 11 月)
AI Agent 搜索 API 每月实测:Exa、Tavily、Firecrawl、Brave、Scholar 用 30 道已核实的题各跑 3 次,比答案命中率、延迟和每千次正确答案的成本。
Kubernetes v1.37.2 是 2026 年 10 月 28 日发布的。四天后,我们问了六个搜索 API 同一个问题:它是哪天发布的?只有一个把日期交到了 Agent 手上。另一个去了 Kubernetes 官网,却拿回一份更早的补丁计划表,上面写的还是“计划 10 月 13 日发布”。Agent 照着这个结果回答,就会信心十足地答错。
这就是这篇榜单要测的东西。对 AI Agent 来说,搜索 API 好不好用,只看一件事:它返回的文字里有没有答案,来得快不快,花钱多不多。所以我们不比功能清单,而是每个月把同样的 30 道题发给每一家,检查前 5 条结果里有没有出现核实过的标准答案。本期是 2026 年 11 月:30 道题,每道跑 3 次,每家 90 次调用,全部在 2026-11-01(UTC)通过 SandBase 调用完成。
先说结论
- Exa Search 是唯一一个 90 次调用全部带回答案的 API(100%)。Tavily、Firecrawl、Brave LLM Context 和 Scholar Web Search 都是 93.3%,Brave Web Search 只有 53.3%。
- 差距几乎全部出在近 30 天的新鲜事上:6 道题里 Exa 答对 6 道,Firecrawl、Brave LLM Context 和 Scholar 各 5 道,Tavily 4 道,Brave Web 只有 1 道。
- 按每千次正确答案算,Scholar Web Search 最便宜,3.86 美元,返回的文字也最少(中位数 317 token)。按 2026-11-05 的 SandBase 标价,Exa 是 10.00 美元,Tavily 和 Firecrawl 是 10.71 美元。
- Brave LLM Context 的答案命中率有 93.3%,但前 5 条里带官方来源的只占 44.4%,很多答案来自转载站。
- Cloudsway 和通过 DataForSEO 调用的 Google 结果也测了,但本期不排名:这两家的调用碰到了 SandBase 自己的接入问题(HTTP 503 和被包了一层跳转的 URL),测出来的是我们网关的问题,不是它们的水平。
分场景排名
30 道题分成 5 个场景,每个场景 6 道。每道题只有一个可核实的答案,都配了官方来源链接和一组权威域名。正式开跑前,脚本先把每个来源页重新抓一遍,确认答案还在页面上(30 道全部通过)。
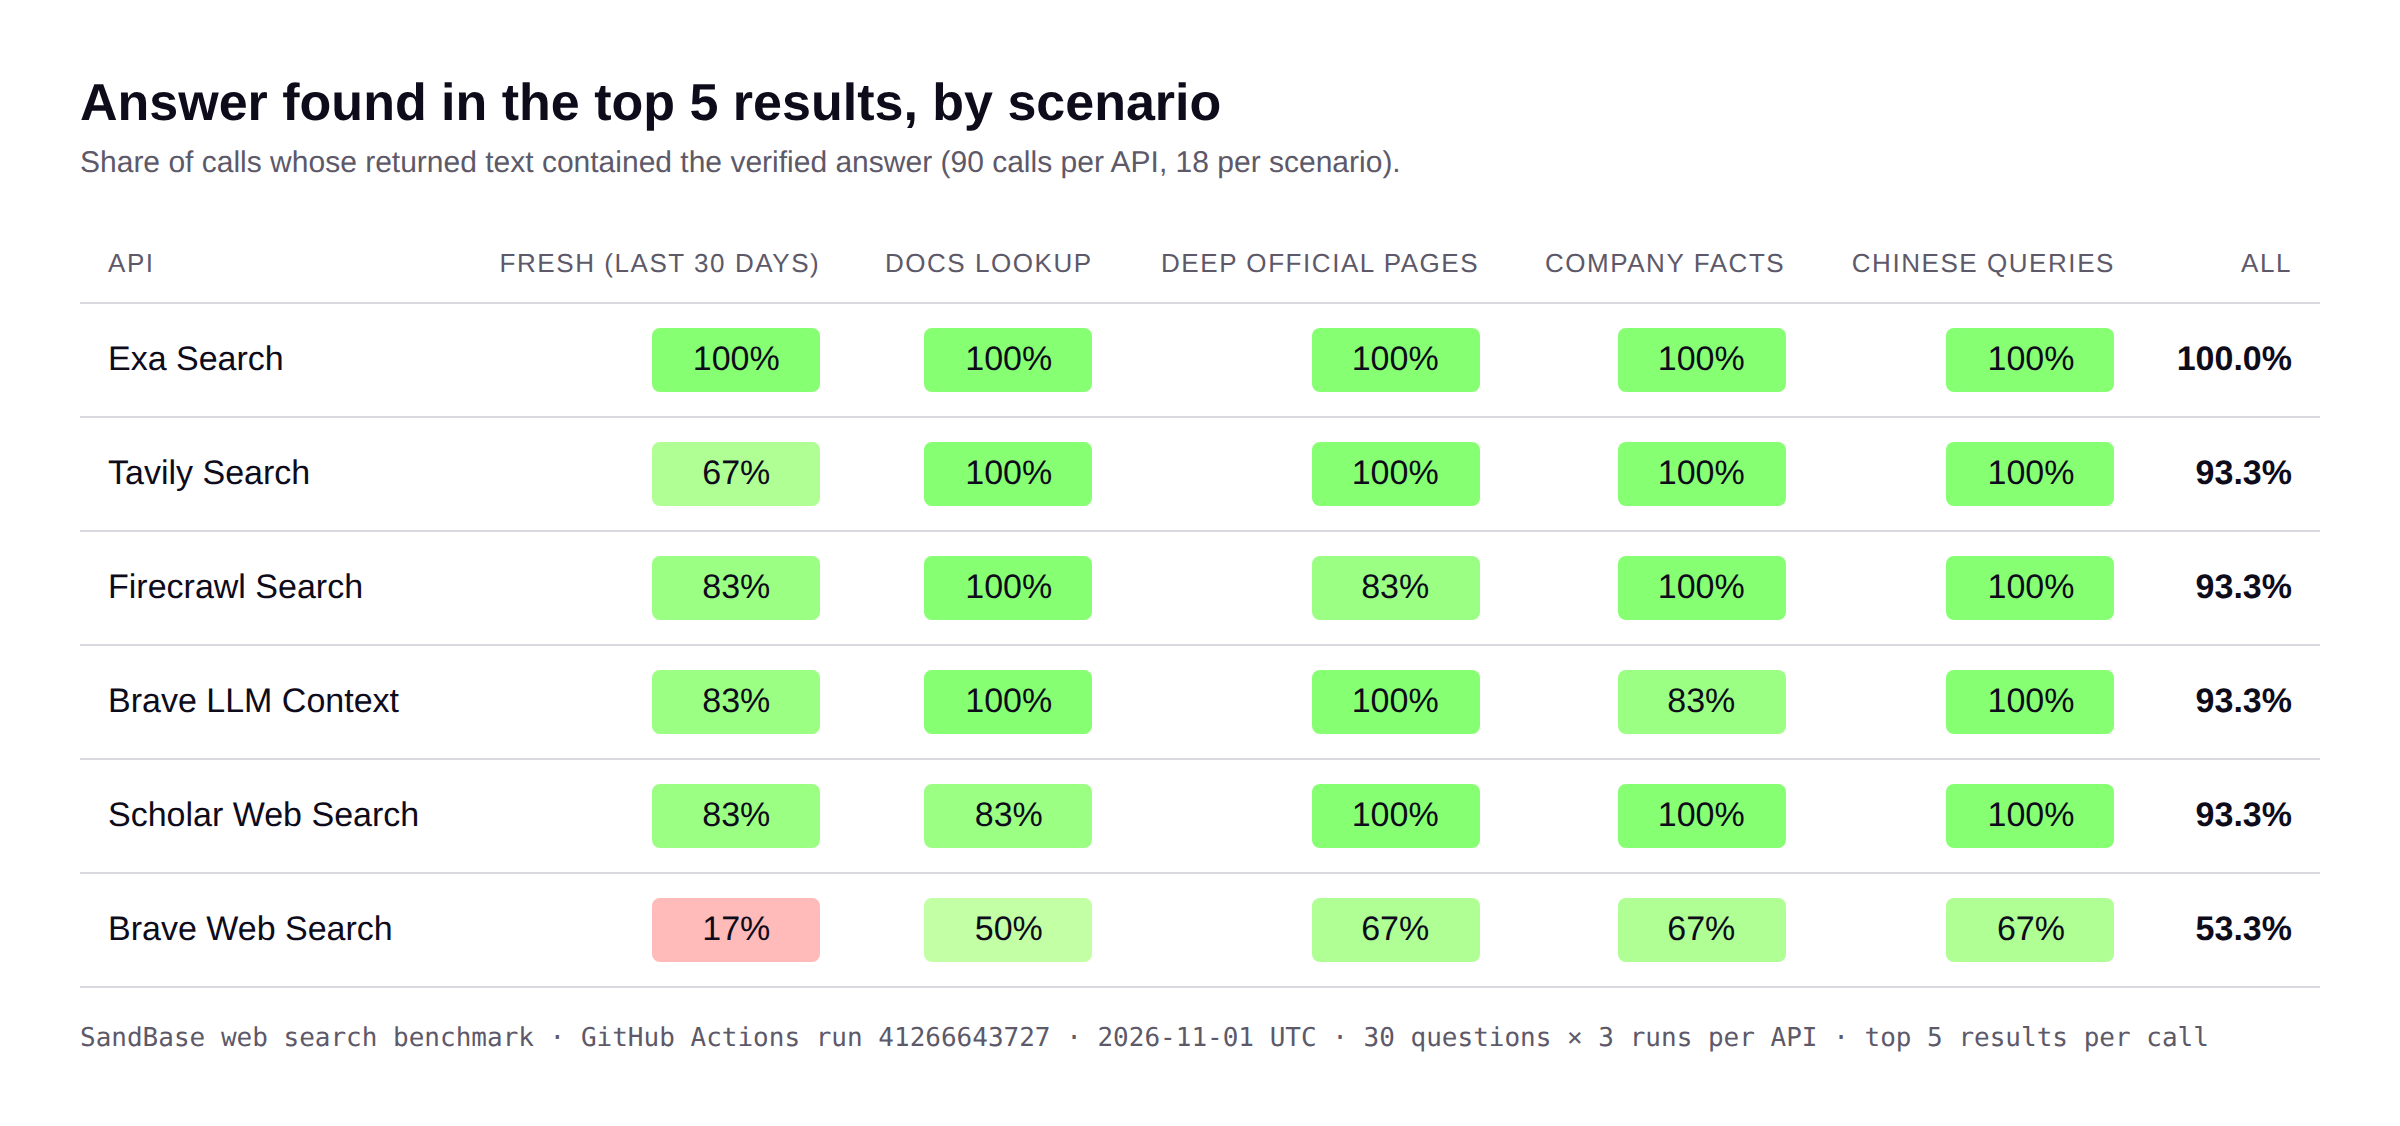
说明:各场景下前 5 条结果里出现标准答案的调用占比,每格 18 次调用。GitHub Actions 运行编号 41266643727,2026-11-01 UTC。
五个场景里有四个几乎拉不开差距:技术文档、官方深层页面、公司信息、中文查询,除了 Brave Web Search,各家都在 100% 上下。真正分出高低的是时效性。另外,结果非常稳定:30 道题里,每家对每道题要么 3 次全对,要么 3 次全错,没有忽对忽错的情况。
| API | 前 5 条含答案 | 前 5 条含官方来源 | P50 延迟 | 返回文字中位数 | 每次调用价格 | 每千次正确答案成本 |
|---|---|---|---|---|---|---|
| Exa Search | 100.0% | 96.7% | 0.48 秒 | 1,647 token | $0.01 | $10.00 |
| Tavily Search | 93.3% | 73.3% | 0.55 秒 | 1,635 token | $0.01 | $10.71 |
| Firecrawl Search | 93.3% | 96.7% | 0.54 秒 | 497 token | $0.01 | $10.71 |
| Brave LLM Context | 93.3% | 44.4% | 0.92 秒 | 2,716 token | $0.005 | $5.36 |
| Scholar Web Search | 93.3% | 93.3% | 0.55 秒 | 317 token | $0.0036 | $3.86 |
| Brave Web Search | 53.3% | 20.0% | 0.55 秒 | 1,136 token | $0.005 | $9.38 |
“每千次正确答案成本”是用每次调用的标价除以答案命中率算出来的。它没有扣掉 SandBase 在其中大部分接口上提供的每个组织每天 100 次免费调用,也没算模型读这些返回文字要花的钱。调用量大的 Agent,后面这笔钱可能比搜索费本身还多,所以我们把返回文字的长度也列了出来。
怎么选
看重时效,选 Exa Search。 近 30 天发布的版本,它全部答对了,包括四天前才出的那个 Kubernetes 补丁,它直接拿到了项目的 GitHub releases 页面。它带官方来源的比例也最高(96.7%,和 Firecrawl 并列)。代价是每次调用的价格是 Brave 两个接口的两倍。
上下文预算紧,选 Scholar Web Search 或 Firecrawl Search。 Scholar 返回的文字中位数只有 317 token,Firecrawl 是 497,而 Exa 和 Tavily 大约 1,640,Brave LLM Context 是 2,716。两家都答对了 30 题里的 28 题。Scholar 每个正确答案最便宜,但它漏了 Python 3.14 停止支持时间那道文档题和那个 Kubernetes 补丁,P95 延迟也最长,3.56 秒。
想直接拿到能喂给模型的文字,选 Brave LLM Context,但要看来源。 它返回的是整理好的段落,命中率 93.3%,可是一半以上的结果列表里没有官方域名。比如问“DeepSeek 总部在哪个城市”,它给的是 CB Insights、一家新闻网站和几个维基百科镜像站,DeepSeek 官网和维基百科本身都不在里面。拿来聊天没问题,要拿来做引用就有风险。
Tavily Search 适合做默认选项,最近发生的事情除外。 技术文档、官方深层页面、公司信息和中文查询它都是 100%,新鲜事 6 道答对 4 道。
别让 Brave Web Search 当 Agent 唯一的搜索工具。 它和 Brave LLM Context 用的是同一个 Brave 索引,命中率却是 53.3% 对 93.3%。差别在返回内容上:Brave Web 只给很短的展示摘要,答案通常在链接指向的页面里,不在返回的文字里。要么配一个抓网页的工具,要么直接换成 LLM Context 接口。
答错的题错在哪
答错的情况并不随机,每一种都对应着搜索结果误导 Agent 的一种方式。
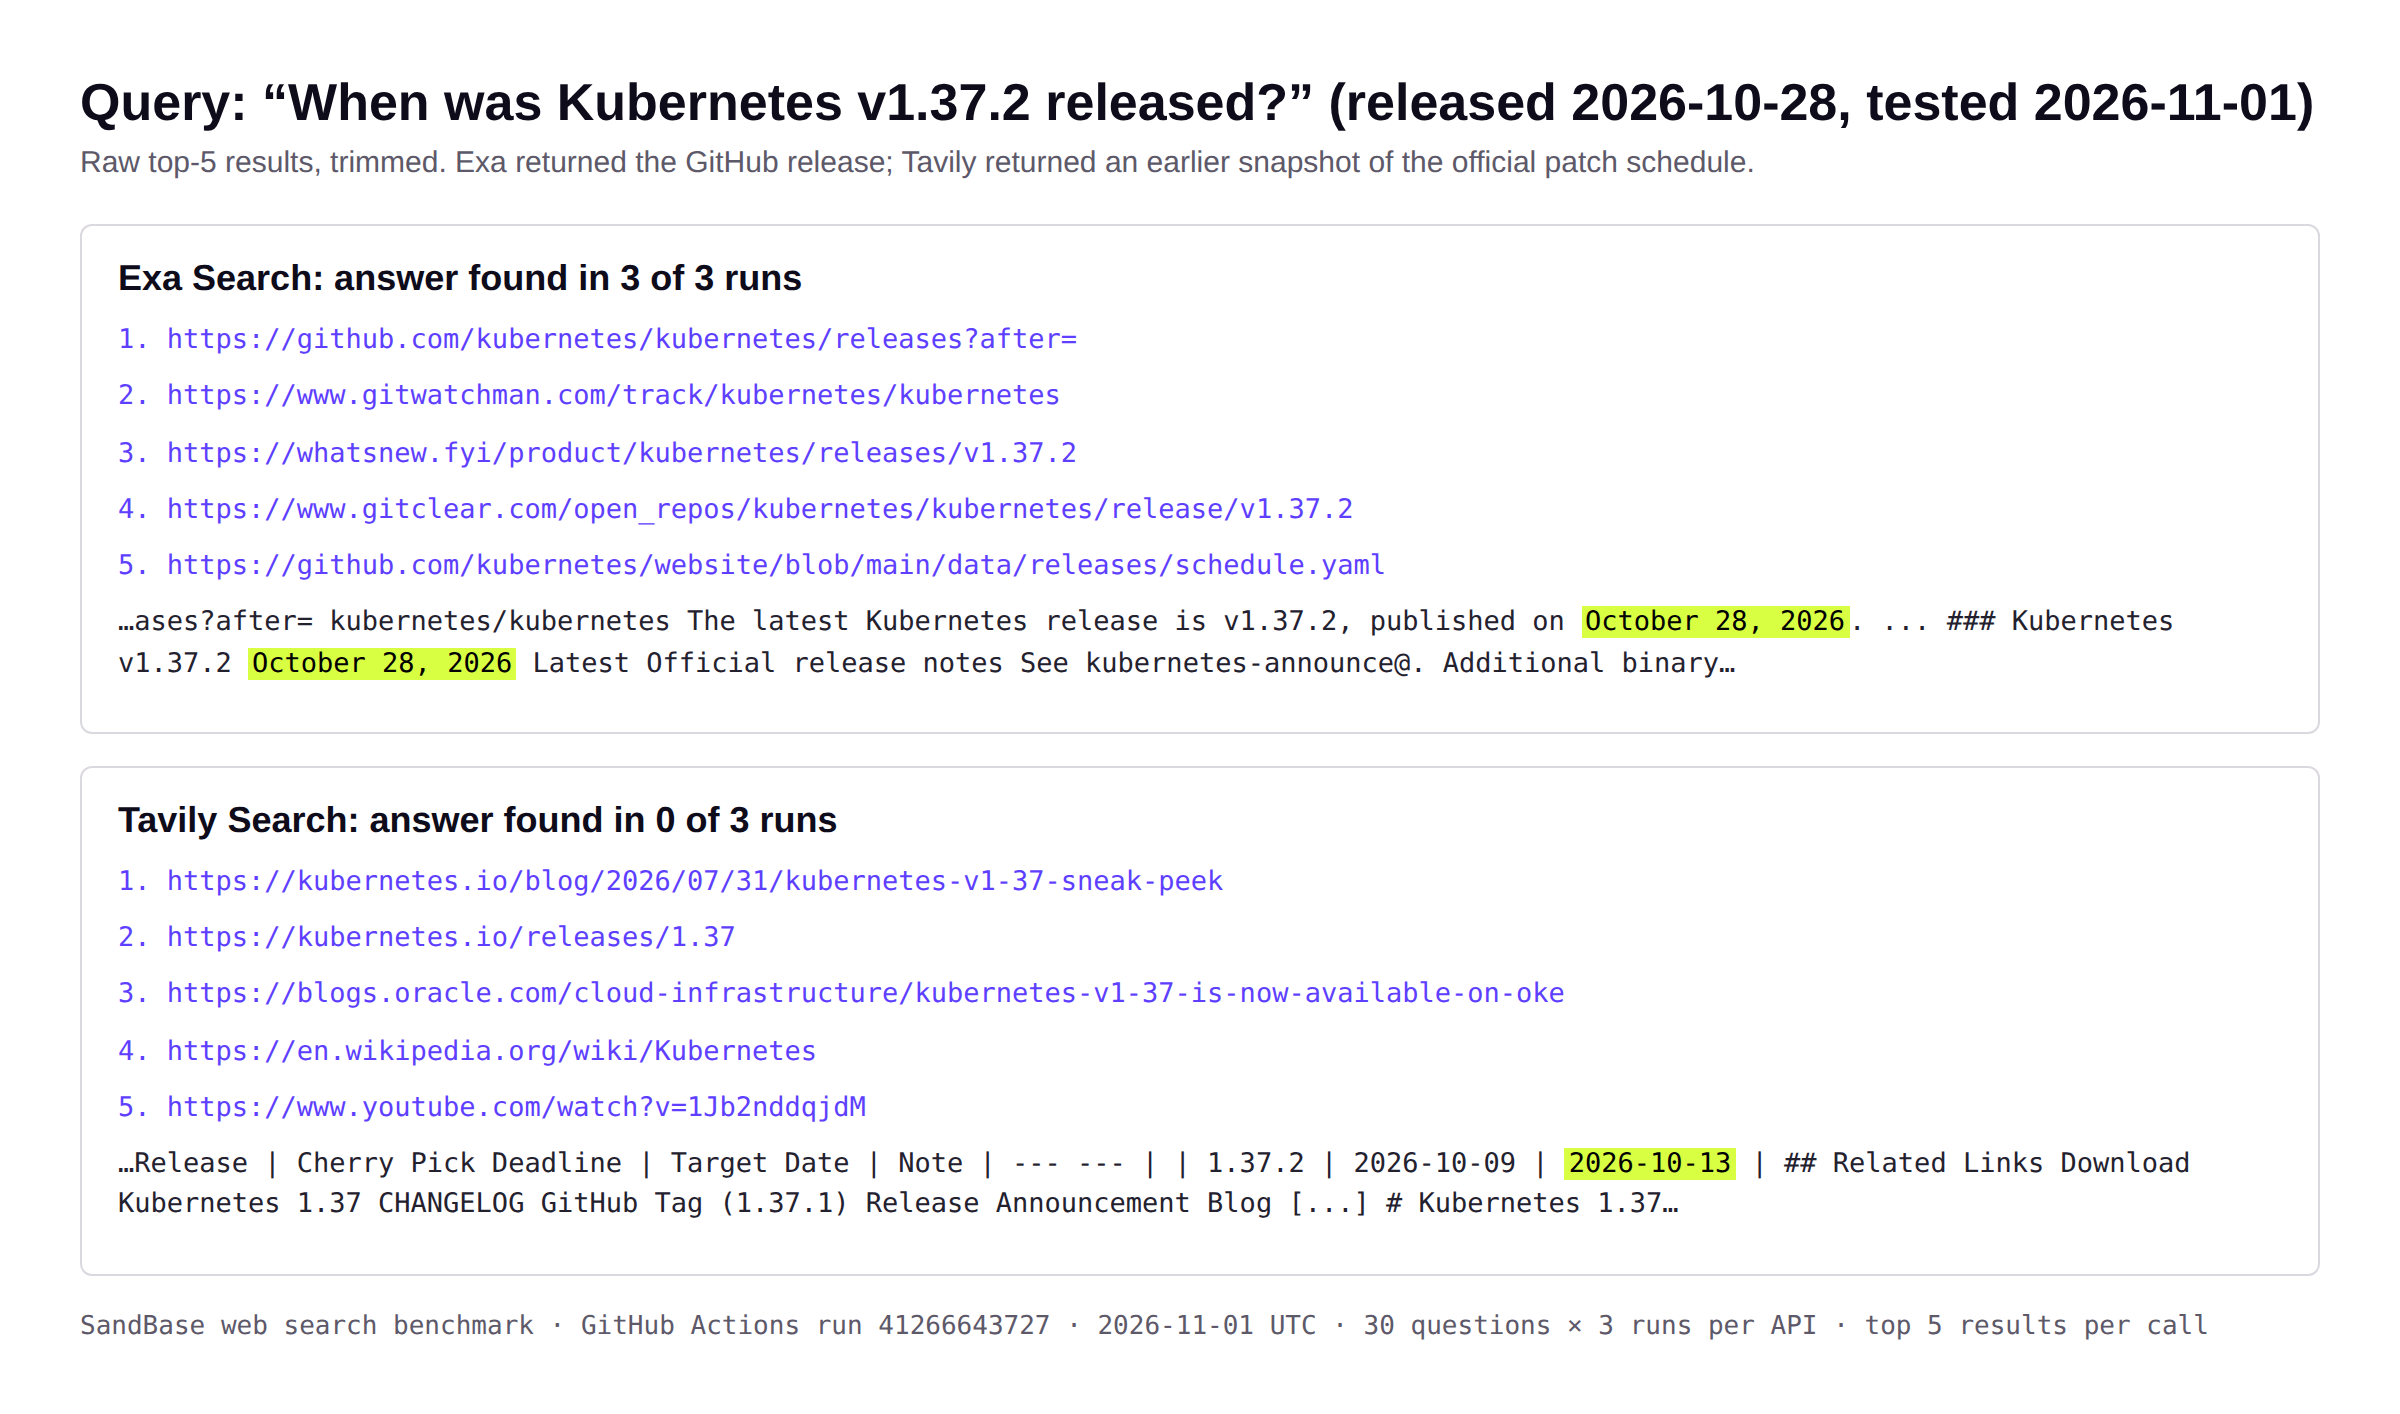
说明:“When was Kubernetes v1.37.2 released?”的原始返回(已裁剪)。Exa 拿到了标注 2026 年 10 月 28 日的 GitHub 发布记录;Tavily 返回的是 kubernetes.io 的页面,其中补丁计划表上的目标日期还是 2026-10-13。
过期的官方页面,比新鲜的非官方页面更危险。 在 Kubernetes 这道题上,Tavily 返回的全是正规域名,包括 kubernetes.io/releases/1.37。但它拿到的是发布之前的版本,补丁还标着“即将发布”。只有 Exa 找到了写着真实日期的页面。我们认为这是对做 Agent 的人最重要的一条:域名对,不等于答案是最新的。
版本号一样,软件不一样。 问 Python 3.14.10 的发布日期,Tavily 返回了 Apache Camel 3.14.10 的发布页,还有 X 上一条版本号相同的游戏更新公告。它另一条结果是 Python 的版本计划 PEP 745,上面写 3.14.10 预计 2027 年 2 月发布,这是旧计划,实际版本 2026 年 10 月 25 日就提前发了。题目本身很短、有歧义,而 Agent 发出的查询往往就是这样。
页面找对了,返回的那一段却不够。 问 Go 1.27.0 的发布日期,Firecrawl 找到了 go.dev/doc/go1.27,但返回的文字只说“八月发布”,没有具体哪天。确切日期在 go.dev 的另一个页面上。这是返回了页面里不对的那一段,不是找错了页面。
我们自己判得太严。 问 Perplexity AI 是什么时候成立的,Brave LLM Context 的回答是“成立于 2022 年”。我们的标准答案是精确到日的 2022-08-22,所以判为没答对。题目没说要精确到哪一级,下个月我们会在题目里写明,而不是测完再改判分规则。
测试方法
- 调用: 30 道题 × 3 次 × 8 个接口 = 720 次调用,4 路并发,从 GitHub Actions 的运行器发出,经过
https://api.sandbase.ai/v1/api/<厂商>/<接口>。发出去的查询就是题目原文。每家都只取 5 条结果,有正文或摘要选项的都打开:ExanumResults: 5并开启 highlights,Tavilymax_results: 5(basic 深度),Firecrawllimit: 5,Bravecount: 5(Web 开启 extra snippets),Scholarmax_num_results: 5。 - 判分: “前 5 条含答案”就是拿标准答案(包括常见的几种日期写法)去返回的全部文字里做字符串匹配,不用 LLM 打分。我们随机抽了 18 个匹配结果人工检查,18 个都是对的事实、对的对象。“官方来源”指至少有一条结果的链接落在这道题的权威域名上,比如
kubernetes.io或stats.gov.cn。 - 题目: 每个场景 6 道。新鲜事是近 30 天的发布(Firefox 159、Node.js 26 进入 LTS、Python 3.14.10、Kubernetes v1.37.2、Go 1.27.3、DeepSeek-V4.1-Flash-1017);技术文档是版本支持期限和 API 限制;官方深层页面是版本代号、数量、日期;还有公司信息,以及关于国家统计局数据和 DeepSeek 中文文档的中文查询。新鲜事这 6 道每月更换,其余 24 道固定不变,这样每个月的变化才有可比性。
- 价格: 取 2026-11-05 各 SandBase API 页面上标的每次调用价格。
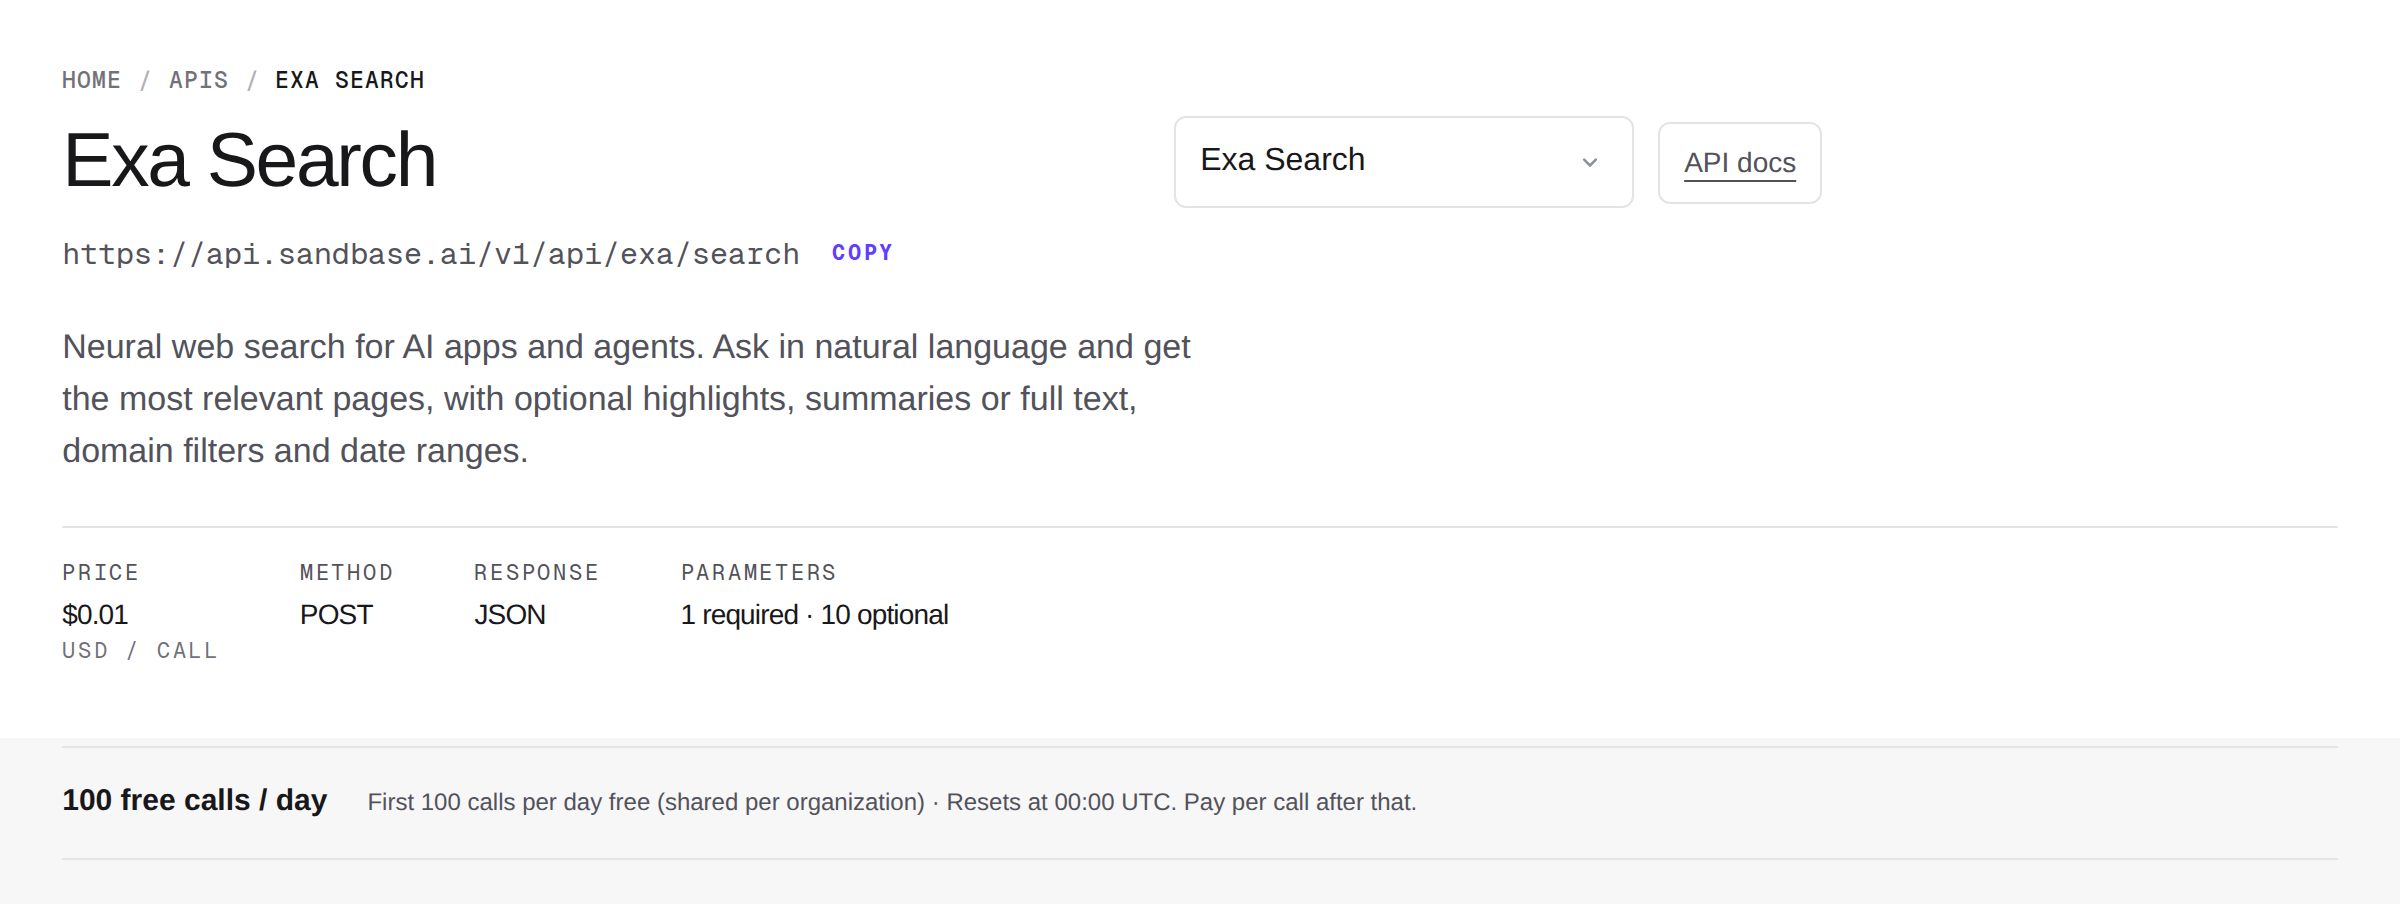
说明:2026-11-05 的 SandBase Exa Search 页面:每次调用 0.01 美元,每个组织每天前 100 次免费。Tavily、Brave 和 Scholar 的页面也有同样的每日免费额度;Firecrawl Search 页面标价同为 0.01 美元,但没有免费额度。
速度和成本
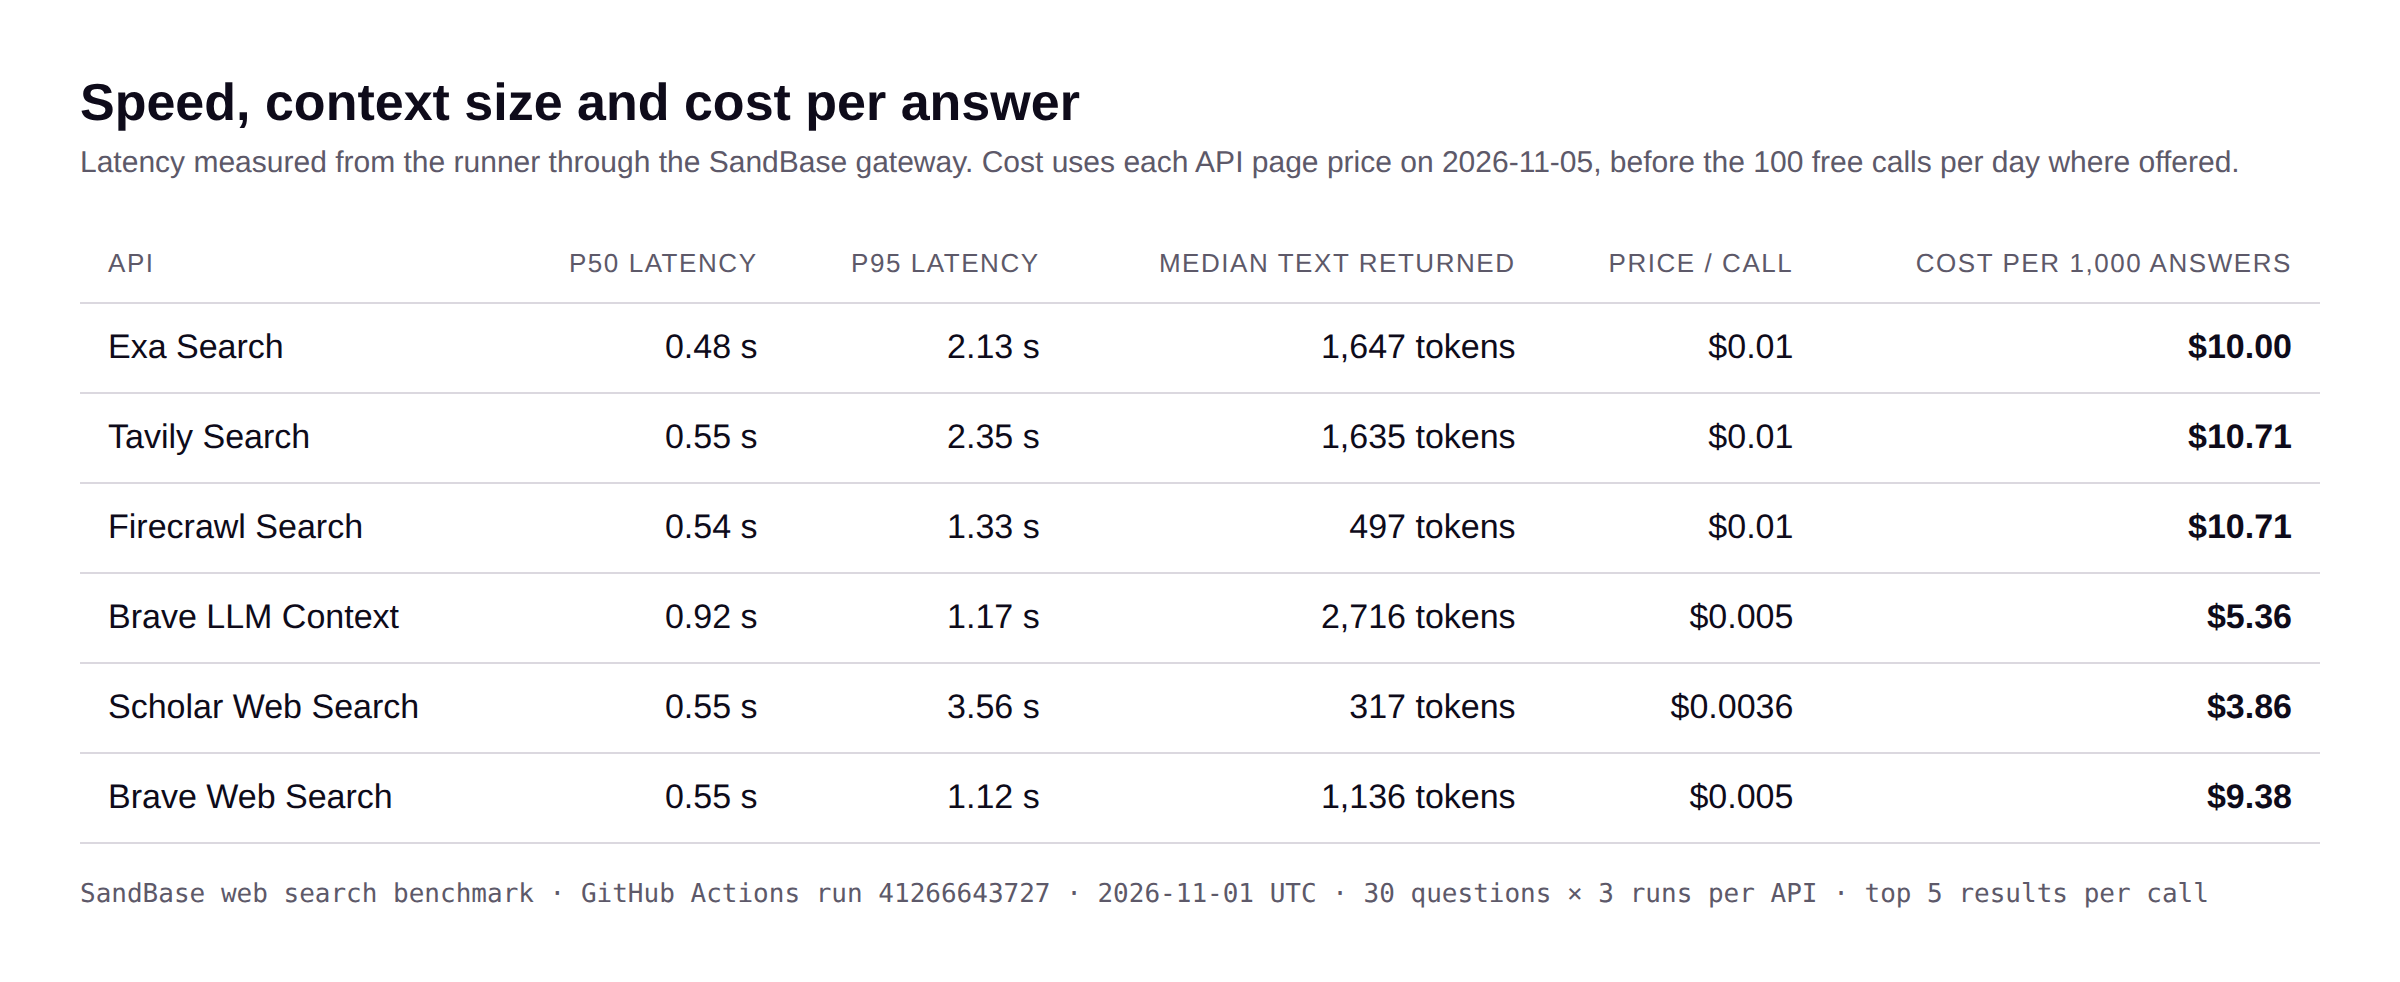
说明:延迟是从运行器经 SandBase 网关测得的端到端时间;返回文字按字节数除以 4 估算 token;成本按标价计算每千次正确答案的费用。
中位延迟差不多:六家里有五家在 0.48 到 0.55 秒之间,Brave LLM Context 要拼更长的段落,是 0.92 秒。尾部延迟差得多一些:Scholar 的 P95 是 3.56 秒,Exa 和 Tavily 都超过 2 秒,Brave 的两个接口和 Firecrawl 都在 1.4 秒以内。如果你的 Agent 是一次接一次地串行搜索,真正感受到的是 P95。
在 Agent 里怎么调用
这六个接口在 SandBase 上的请求格式一样,换一家只要改模型路径和参数。下面是一个最小调用,拿不到数据时直接报错:
import os, requests

def search(query: str) -> dict:
    r = requests.post(
        "https://api.sandbase.ai/v1/api/exa/search",
        headers={"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"},
        json={"query": query, "numResults": 5, "contents": {"highlights": True}},
        timeout=60,
    )
    r.raise_for_status()
    outputs = r.json().get("outputs") or []
    if not outputs or "data" not in outputs[0]:
        raise RuntimeError(f"no outputs[0].data in response: {r.text[:200]}")
    return outputs[0]["data"]  # Exa 的搜索结果:标题、链接和摘要片段
可以直接在 SandBase 的 Exa Search API 调试页试。想看这些工具放进完整 Agent 循环、由模型阅读并引用网页时的表现,可以看我们的 研究型 Agent 搜索 API 实测;想逐项对比功能,可以看 Exa、Tavily、Firecrawl 与 SerpAPI 对比。
下个月会变什么
12 月那一期会换掉 6 道新鲜事题目;等 Cloudsway 和 DataForSEO 的接入问题确认修复后,补测这两家;日期类题目会写明要精确到哪一级。某一家的结果有变化,我们会在页面顶部的“与上月相比”里写清楚变了什么、为什么变。
常见问题
2026 年 AI Agent 最好用的搜索 API 是哪个?
在 2026 年 11 月这一期里,Exa Search 是唯一 30 道题全部带回答案的 API,也是唯一把近 30 天的 6 道新鲜事全部答对的。Tavily、Firecrawl、Brave LLM Context 和 Scholar Web Search 都是 30 道答对 28 道。
哪个搜索 API 最便宜?
Scholar Web Search,每次调用 0.0036 美元,这次测试折合每千次正确答案 3.86 美元。它返回的内容也最短,中位数 317 token,模型读结果的花费也最低。
Exa 比 Tavily 好吗?
在这套题上,新鲜事 Exa 更好(6 道对 4 道),前 5 条带官方来源的比例也更高(96.7% 对 73.3%)。技术文档、官方深层页面、公司信息和中文查询两家都是 100%,打平。在 SandBase 上两家每次调用的价格相同。
Brave Web Search 为什么比 Brave LLM Context 低这么多?
两者查的是同一个 Brave 索引。Brave Web 只返回很短的展示摘要,答案往往在链接指向的页面里,不在返回的文字里;Brave LLM Context 返回的是给模型读的长段落。
这个榜单多久更新一次?
每月月初更新一次,24 道固定题加 6 道新换的新鲜事题。每次更新都会保留上个月的数据,方便对比。
局限
这是检索测试,不是答案质量测试:只看返回的文字里有没有答案,不评价结果排序好不好,也不评价模型能不能用对。题目都是有唯一答案的事实题,开放式的研究问题表现会不一样,那部分放在我们的 Agent 循环实测里。所有调用都经过 SandBase 网关,在同一天、从同一台运行器发出,所以延迟里包含了我们的网关和网络路径;Cloudsway 和 DataForSEO 的结果因为上面说的原因暂不公布。字符串匹配会漏掉写法特殊的正确答案,比如 Perplexity 成立年份那道题。30 道题里差一道就是 3.3 个百分点,所以 93.3% 的那四家应该看作并列。