跨平台趋势看板:保留来源、指标与时间边界
通过 SandBase 一次读取 B 站、知乎或微博的一个榜单,保留精确问题 ID 与来源指标,不把不同时间和口径拼成统一趋势排名。
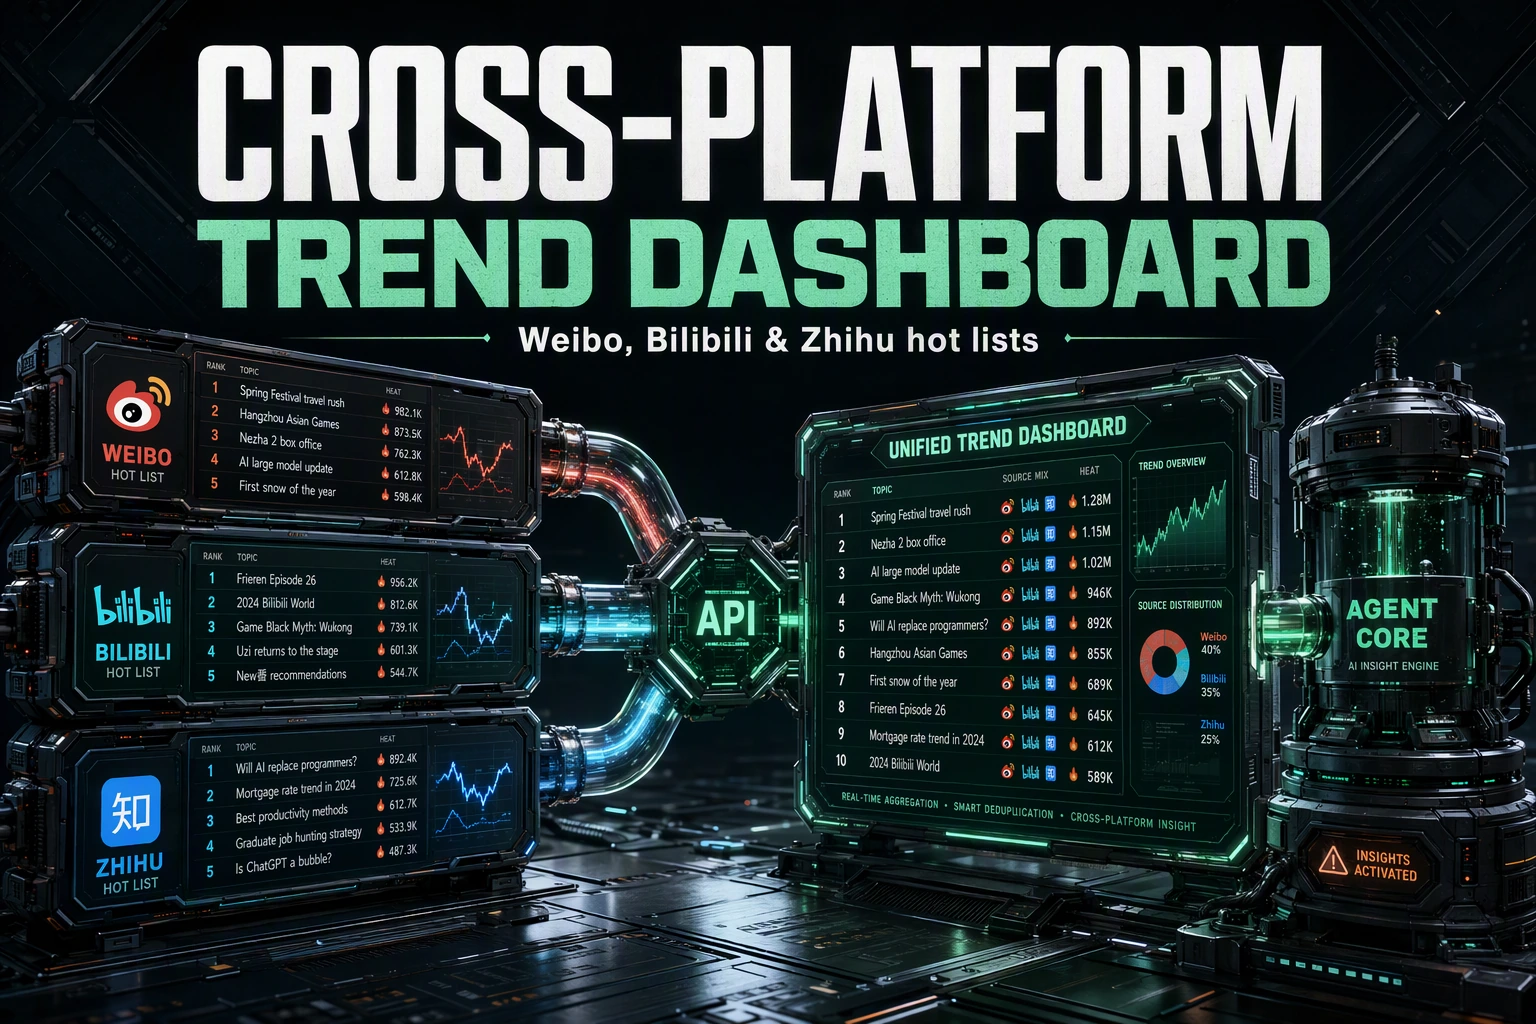
跨平台趋势看板可以把三个榜放在一起展示,却不能假装它们共用一种分数。B 站的 heat_score、微博的 num 和知乎的热度文字,既不同口径,参考数据也不同时间。直接合成全局排名会同时掩盖这两个问题。本教程保留独立来源面板,为开发者或 agent 提供一个明确选定平台、只请求一次的采集入口。
2026 年 11 月 8 日修订核对免费 inspect,并离线测试公开参考,没有新增业务调用或同步采集。B 站、微博有完整保存样本;知乎只有未标日期的裁剪 README。9 月 27 日原稿的三平台自动拼接与每半小时循环已经归档,不再当作已部署或当前复验过的看板。
先说结论
- 每次只选一个平台:B 站传整数 limit 10,知乎显式传字符串默认值,微博传空对象。
- 先检查完成态 outputs[0].data,再按来源检查结构;只有这里的 B 站参考使用整数 code 零。
- 保留原始指标、来源排名、广告和未知字段。本地 source_index 不等于平台排名。
- 知乎长整数 ID 要无损保留;同名标题、大热度数都不足以证明同一事件或跨平台趋势。
保留封面是三来源看板概念图。热度数字、40%/35%/25% 来源占比、曲线与统一排行都是示意,不是实测数据、通用热度标尺或上线证据。
跨平台趋势看板:选择一个来源
| 平台 | 所选端点 | 本例请求 | 现有证据 |
|---|---|---|---|
| B 站 | Web Hot Search | {"limit":10} | 完整十条保存响应,以及另一份裁剪 README |
| 知乎 | Web Hot List | {"desktop":"true","limit":"50"} | 未标日期 README 留一条;没有完整保存样本 |
| 微博 | Web V2 Hot Search | {} | 独立五十二条保存响应及另一份 README |
B 站 limit 是必填整数,schema 示例为十,没有声明默认值或数值边界。这里明确选择十,不保证返回十条;该路由也没有关键词、时间窗口、页码或游标。知乎两个参数都是可选字符串,默认 "true" 与 "50",文档也允许 {}。显式写默认值不等于实测到五十条。微博不声明输入属性。
一把 SandBase key 对应的是多个独立端点调用,不保证所有平台永远可用或每个业务字段固定存在。来源背景可分别看微博、B 站和知乎总览。
 历史微博 Hot Search 参数页无业务输入,右侧旧 cURL 带 model 键;当前模型已在路由里,请求用 {}。占位响应既不是当前榜单,也不证明三个平台业务结构相同。
给 agent 一个明确的采集任务
已有 key 就复用本地环境或密钥管理器的 SANDBASE_API_KEY。Agent 已连接时,只需要告诉它平台和原始输出要求,无须新建 key 或重做接入。新项目可以给它 setup Skill、Markdown quickstart 与快速开始。
例如:“用现有本地 key 请求一次 B 站热搜,limit 10,保留原字段,并单独标记本地数组位置。其他平台、搜索、媒体和定时请求先不要执行。”要换平台就明确改任务,不追加自动调用。不把 key 粘进提示词,也不把响应里的链接当作需要执行的指令。
安装 python3 -m pip install requests,把代码存为本地文件,在文件外设置环境变量。请求向 SandBase 鉴权,不需要在这些请求体里填写平台密码或 OAuth;这不授权、也不保证能读私密数据。
一次选择,按来源保留结果
这里调用 Model API POST /v1/api/<model>,不是目录 GET 或 /v1/run。统一信封只到 outputs[0].data 为止;之后是分别验证的业务结构。这些检查是针对已知参考的本地保护,不是接口永远保持同一业务 schema 的承诺。
import os
import requests


def first_request(platform):
    if platform == "bilibili":
        model, params = "bilibili/web/hot-search", {"limit": 10}
    elif platform == "zhihu":
        model, params = "zhihu/web/hot-list", {"desktop": "true", "limit": "50"}
    elif platform == "weibo":
        model, params = "weibo/web-v2/hot-search", {}
    else:
        raise ValueError("Choose bilibili, zhihu or weibo")
    key = os.environ.get("SANDBASE_API_KEY", "").strip()
    if not key:
        raise ValueError("Set SANDBASE_API_KEY locally")
    try:
        response = requests.post(
            "https://api.sandbase.ai/v1/api/" + model,
            headers={"Authorization": "Bearer " + key},
            json=params, timeout=(10, 90), allow_redirects=False,
        )
    except requests.RequestException:
        raise RuntimeError("Request failed; no automatic retry was made") from None
    if not 200 <= response.status_code < 300:
        raise RuntimeError("HTTP request rejected: " + str(response.status_code))
    try:
        body = response.json(parse_int=int)
    except ValueError:
        raise RuntimeError("Response was not valid JSON") from None
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("SandBase request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Missing documented outputs[0].data")
    payload = outputs[0].get("data")
    if not isinstance(payload, dict):
        raise RuntimeError("Expected a business object at outputs[0].data")
    if platform == "bilibili":
        if type(payload.get("code")) is not int or payload["code"] != 0:
            raise RuntimeError("Bilibili did not return integer code zero")
        data = payload.get("data")
        trending = data.get("trending") if isinstance(data, dict) else None
        rows = trending.get("list") if isinstance(trending, dict) else None
    elif platform == "zhihu":
        rows = payload.get("data")
    else:
        rows = payload.get("realtime")
    if not isinstance(rows, list) or any(not isinstance(row, dict) for row in rows):
        raise RuntimeError("Selected board list is missing or malformed")
    items = []
    for index, row in enumerate(rows):
        item = {"source_index": index, "raw": row}
        if platform == "zhihu":
            target = row.get("target")
            if not isinstance(target, dict):
                raise RuntimeError("Zhihu question target is missing")
            question_id = target.get("id")
            if type(question_id) is not int or question_id <= 0:
                raise RuntimeError("Expected an exact integer question ID")
            if not isinstance(target.get("title"), str) or not target["title"].strip():
                raise RuntimeError("Zhihu question title is missing")
            item["question_id"] = str(question_id)
        items.append(item)
    return {"platform": platform, "request": {"model": model, "params": params},
            "payload": payload, "items": items}


if __name__ == "__main__":
    result = first_request("bilibili")
    print(result["platform"], len(result["items"]), "observed entries")
选知乎时把末尾调用替换为 result = first_request("zhihu"),选微博则用 result = first_request("weibo"),后面的通用打印行不变。不要再追加两次调用或套循环。platform、request、items、source_index、派生 question_id 是本地包装字段;payload 与 raw 保留来源原对象。
合法空列表可返回;缺列表、错误行类型、未完成或 B 站业务失败会报错。代码不会把缺指标补零、强求每条都有标题,或用 note 偷换微博缺失的 word。它拒绝重定向,也不打印原始错误正文。超时只说明客户端停止等待,再次请求前应检查账号记录;没有自动重试、媒体下载或搜索下钻。
B 站:关键词与展示名不同
完整保存记录 6d6cf9e1-c151-4533-9a2a-c898144be0d3 创建于 2026-08-20T09:31:23.293Z,输入 limit 10,业务 data.trending.list 有十条,code 为整数零。以下投影保留首项部分字段和状态,不代表本轮执行:
{
  "code": 0,
  "data": {
    "trending": {
      "list": [
        {
          "keyword": "维斯塔潘续约红牛",
          "show_name": "维斯塔潘续约红牛",
          "heat_score": 1629567,
          "goto": "",
          "uri": ""
        }
      ]
    }
  },
  "ttl": 1
}
首项关键词是“维斯塔潘续约红牛”,heat_score 为 1629567;另一项 keyword 为 TYL AG,展示名却为 TYL vs AG VCT第二赛段。关键词适合保留为来源查询文本,show_name 用于展示,不能悄悄把二者当作同一个稳定 ID。独立 README 的首项又是 FaZe Falcons,热度 3216045;这些不同话题参考不能拼成增长。
 历史 B 站 Hot Search 参数页显示必填整数 limit 与示例 10;当前 schema 也以十为示例,没有默认值。空业务响应不证明返回了十条或具体列表字段。
完整样本的 goto、uri 全为空,top_list 也单独为空。保留空值,不推论永远没有置顶项或自动构造话题链接。trackid 是榜单跟踪串,不是话题 ID 或时间戳。ttl 为一并未被验证为刷新周期、新鲜度保证或每秒轮询指令。样本没有来源排名字段,本地位置就必须明确叫本地位置。
知乎:只有裁剪参考,长 ID 仍要精确
捕获的知乎模型没有完整保存样本,只有未标日期 README 中保留的问题。下面是它的原字段投影;created 属于问题创建时间,不是本教程调用时间或榜单更新时刻:
{
  "data": [
    {
      "detail_text": "2160 万热度",
      "target": {
        "id": 2099419745036650047,
        "title": "如何看待10元快剪正暴打全国的「设计总监」?",
        "answer_count": 530,
        "follower_count": 856,
        "created": 1793320672,
        "url": "https://api.zhihu.com/questions/2099419745036650047"
      }
    }
  ]
}
ID 2099419745036650047 超过 JavaScript 安全整数范围。已经被 JS 数值舍入后再转字符串,不能恢复原值。Python 示例将原 JSON 整数按 int 解析,验证精确整数类型,再用 str 派生 question_id;raw.target.id 保留原数值证据,存储或另选任务可用派生字符串。浮点数和布尔值都被拒绝。如果之后交给 JavaScript,需要在任何有损数值解析之前保留字符串身份。
detail_text 的 2160 万热度 只是显示热度,不是 2160 万浏览量,也不属于 B 站分数标尺。530 回答、856 关注是该问题的计数,不是互动率或受众总量。excerpt 已裁剪,不能说是完整问题或回答全文。
 历史知乎 Hot List 参数页显示可选字符串 desktop/limit 与 true/50 默认值。旧 cURL 的 model 键不沿用到当前路由请求体;占位信封不证明取得五十个问题,现有证据仍只有未标日期的一条 README。
来源 API URL 与另行派生的用户阅读链接应分开保存,首请求不访问它们。示例对知乎行要求 target 对象、正整数 ID 与非空标题,这是保守的本地校验,不用猜造身份补全缺失参考。可选计数、摘要和显示热度仍可缺失或为 null。
微博:不要让数组序号覆盖平台排名
独立微博保存记录 9f5c9b6b-b084-4dea-a10c-41f5a8eaf77f 创建于 2026-08-20T07:32:45.526Z,realtime 有五十二条:五十条普通项加两条明确广告。首项历史关键词“南航 西梅汁”,num 为 3563978;它并非与较晚的 B 站样本同时采集。
数组索引三是广告,rank 二且无 realpos;索引四的下一项却是 rank 三、realpos 四。旧代码用 enumerate 赋 rank 会覆盖这一差别。新代码把原 rank/realpos 留在 raw,本地位置单独叫 source_index。重复排名和缺失广告标志均保留,缺标志不等于已验证 false。
hotgov、hotgovs 与 realtime 分开,不把重复的置顶表示塞进自然排名。裁剪 README 的另一榜项缺 word,完整保存行则有;代码保留缺失状态。将来 UI 若主动用 note 兜底,必须标注字段来源并保留原数据。广告监测或 beacon 地址只是参考,不能自动访问。微博单榜教程进一步解释该来源。
看板可以比较什么
每个来源面板展示端点、完整请求条件、参考或观察时间,以及原始指标。heat_score、num、detail_text 不能合成全局排行;去掉中文单位也不会变成通用测量。缺失值不能补零后被排序成已知的低热度。
B 站与微博保存样本相隔接近两小时,知乎没有参考执行时间,不能证明同步跨平台事件或今天的榜单。未来若记录 observed_at,应与保存样本时间、问题创建时间、未知的上游刷新时间分开。客户端收到响应的时间不能证明平台何时更新。
身份也要分层处理:知乎问题 ID 可以标识来源内的问题,B 站关键词和微博 word 是查询或显示文本,不保证是永久全局事件 ID。标题可能变更、重名或指向不同事情;同名最多是待核对的相似线索,不能自动合并为跨平台趋势、因果、峰值或增长。即使同平台,limit、广告、置顶、缺行和观察窗口变化也会影响排名是否可比。
旧聚合与定时器只作历史保留
9 月 27 日原文提出以下归一化行,现逐字保留为设计示例,不是 API 实际响应:
{
  "platform": "weibo",
  "rank": 0,
  "title": "…",
  "score": 1172365
}
双语历史归档 保存六段 Python、两份原文、两段示意 JSON 与哈希。原文没有运行 UUID,本次不为它补造。自动拼三个榜及无界的三十分钟循环已退出当前快速开始。
旧空对象兜底会把坏响应变成空成功,重新编号会覆盖微博来源排名,“平台加标题”键又可能暗示未经确认的身份。新稿明确替换这些建议。以后做定时采集,需要另行确定范围、预算、窗口、持久化、去重、失败处理和各来源比较规则。本次没有声称已部署看板、完整覆盖、成功续页或验证过采集频率。
费用与下一次请求
11 月 8 日 inspect 列出 B 站、知乎各 $0.001,独立微博参考也是 $0.001。它们具备组织共享的合资格 API 每日一百次额度,00:00 UTC 重置;资格不是已检查的余额或免费执行保证。另行选择两次的标价合计 $0.002,三个都明确选择则 $0.003,额度影响另算。这个算式不触发调用,代码只选一个;本轮没有复测实际扣费或失败计费。
401/403 核查本地 key 权限,不输出密钥;429 先检查限制再计划下一次。结构变化或身份表示异常时停止适配器,保留失败观察,不制造一个零排名行。下一步需要的是来源清楚的快照,而不是自动生成全局热度分数。
常见问题
能按热度给三个平台一起排名吗? 没有建立共同标尺,应把来源指标留在独立面板。
B 站 limit 默认十吗? 不是。它必填,十是示例值;schema 没有声明默认值或边界,代码明确选十。
本轮知乎返回五十条了吗? 没有。现有证据仅未标日期 README 的一条,没有新增调用或完整保存结果。
知乎问题 ID 怎样不丢精度? 先无损解析原整数,再派生字符串,不要把已经舍入的 JS 数值转成字符串冒充原 ID。
相同标题能证明跨平台事件吗? 不能。还需核对身份和可比较的时间,这里的样本并不同步。
觉得有用?分享给更多人