Claude Opus 5 价格(2026):API 成本、1M 上下文与限制
Claude Opus 5 价格与评测:2026 年 1M 上下文、输入/输出每百万 Token 5/25 美元、API 限制、自适应思考与 Opus 对比 Sonnet。
先纠正一个会直接影响选型的数字:Claude Opus 5 不是旧版文章里写的每百万 Token 输入 15 美元、输出 75 美元。Anthropic 在 2026 年 7 月 24 日发布它时,公布的基础价格是 输入 5 美元、输出 25 美元。它支持 1M Token 上下文、同步 Messages API 最多 128K Token 输出,并提供自适应思考与可配置的 effort。
因此,Opus 5 仍然是溢价模型,但不能再用“比 Sonnet 贵 5 倍、几乎不该用”来概括。Anthropic 将它定位在复杂 Agent 编码与企业工作;当任务不需要这个能力上限时,速度更快、价格更低的 Sonnet 5 通常更合适。
先说结论
- 高价值、长链路、需要判断与复核的编码或专业任务,可以优先评估 Opus 5。
- Sonnet 5 的当前标价是输入 2 美元、输出 10 美元;Opus 5 的单价是它的 2.5 倍,而不是 5 倍。
- 1M 是容量上限,不等于应该把未经筛选的整个仓库或文档库一次塞进 Prompt。
- 生产选型要显式设置
effort,并在真实任务上同时测完成率、Token、延迟和总成本。- Claude 原生 API 的模型 ID 是
claude-opus-5;SandBase 文档中的调用名是anthropic/claude-opus-5。
Claude Opus 5 规格速查
| 项目 | 当前值 |
|---|---|
| 发布时间 | 2026 年 7 月 24 日 |
| Claude API ID | claude-opus-5 |
| 输入价格 | 每百万 Token 5 美元 |
| 输出价格 | 每百万 Token 25 美元 |
| 上下文窗口 | 1M Token |
| 同步请求最大输出 | 128K Token |
| 输入 / 输出模态 | 文本、图像输入;文本输出 |
| 思考控制 | 自适应思考与可配置 effort |
| Anthropic 表中的相对延迟 | Moderate |
| Fast mode | Anthropic 称速度约为默认模式的 2.5 倍,价格为基础价的 2 倍 |
价格、可用区域和平台功能都可能变化。上表于 2026 年 8 月 23 日对照 Anthropic 的 Opus 5 发布公告与模型总览核验。
 Anthropic 官方发布页,截图于 2026 年 8 月 23 日;页面标注的发布日期是 2026 年 7 月 24 日。
从 Opus 4.8 到 Opus 5,真正有用的变化
Anthropic 对 Opus 5 的描述是:在与 Opus 4.8 相同的基础 Token 价格下提升性能,重点覆盖软件工程、Agent 工作流、知识工作、科学任务和更强的自我验证。对工程团队来说,关键不是抽象的“更聪明”,而是多了几组可测试、可调节的控制:
- 自适应思考:模型可以根据任务调整推理行为;
- effort 设置:应用可以在能力、Token 消耗和时间之间做显式取舍;
- 1M 上下文:容纳更大的工作集;
- 128K 最大输出:明显高于旧文章错误写入的 4K–8K;
- Fast mode:延迟值得额外付费时,可以选择更快的推理模式。
这些是需要在自己的系统中验证的能力,不是效果保证。厂商基准和客户案例能说明发布时的测试结果,却不能证明它一定适合你的代码库、工具链、权限模型或 Agent harness。
Opus 5 与 Sonnet 5 怎么选
Anthropic 当前模型表中,两者都是 1M 上下文、同步请求最多 128K 输出。主要差异在能力定位、价格和速度,而不是上下文窗口。
| 维度 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|
| 定位 | 复杂 Agent 编码与企业工作 | 速度与智能的平衡 |
| 输入 / 输出价格 | $5 / $25 每 MTok | $2 / $10 每 MTok |
| 相对延迟 | Moderate | Fast |
| 上下文 / 最大输出 | 1M / 128K | 1M / 128K |
| 更适合先测的任务 | 困难且高价值、需要持续判断的任务 | 高频编码、工具调用和一般生产任务 |
按标价计算,Opus 5 的输入和输出单价都是 Sonnet 5 的 2.5 倍。这仍然是一笔需要解释的溢价,但路由依据应该是任务价值和实测完成质量,而不是模糊的“困难 Prompt”。
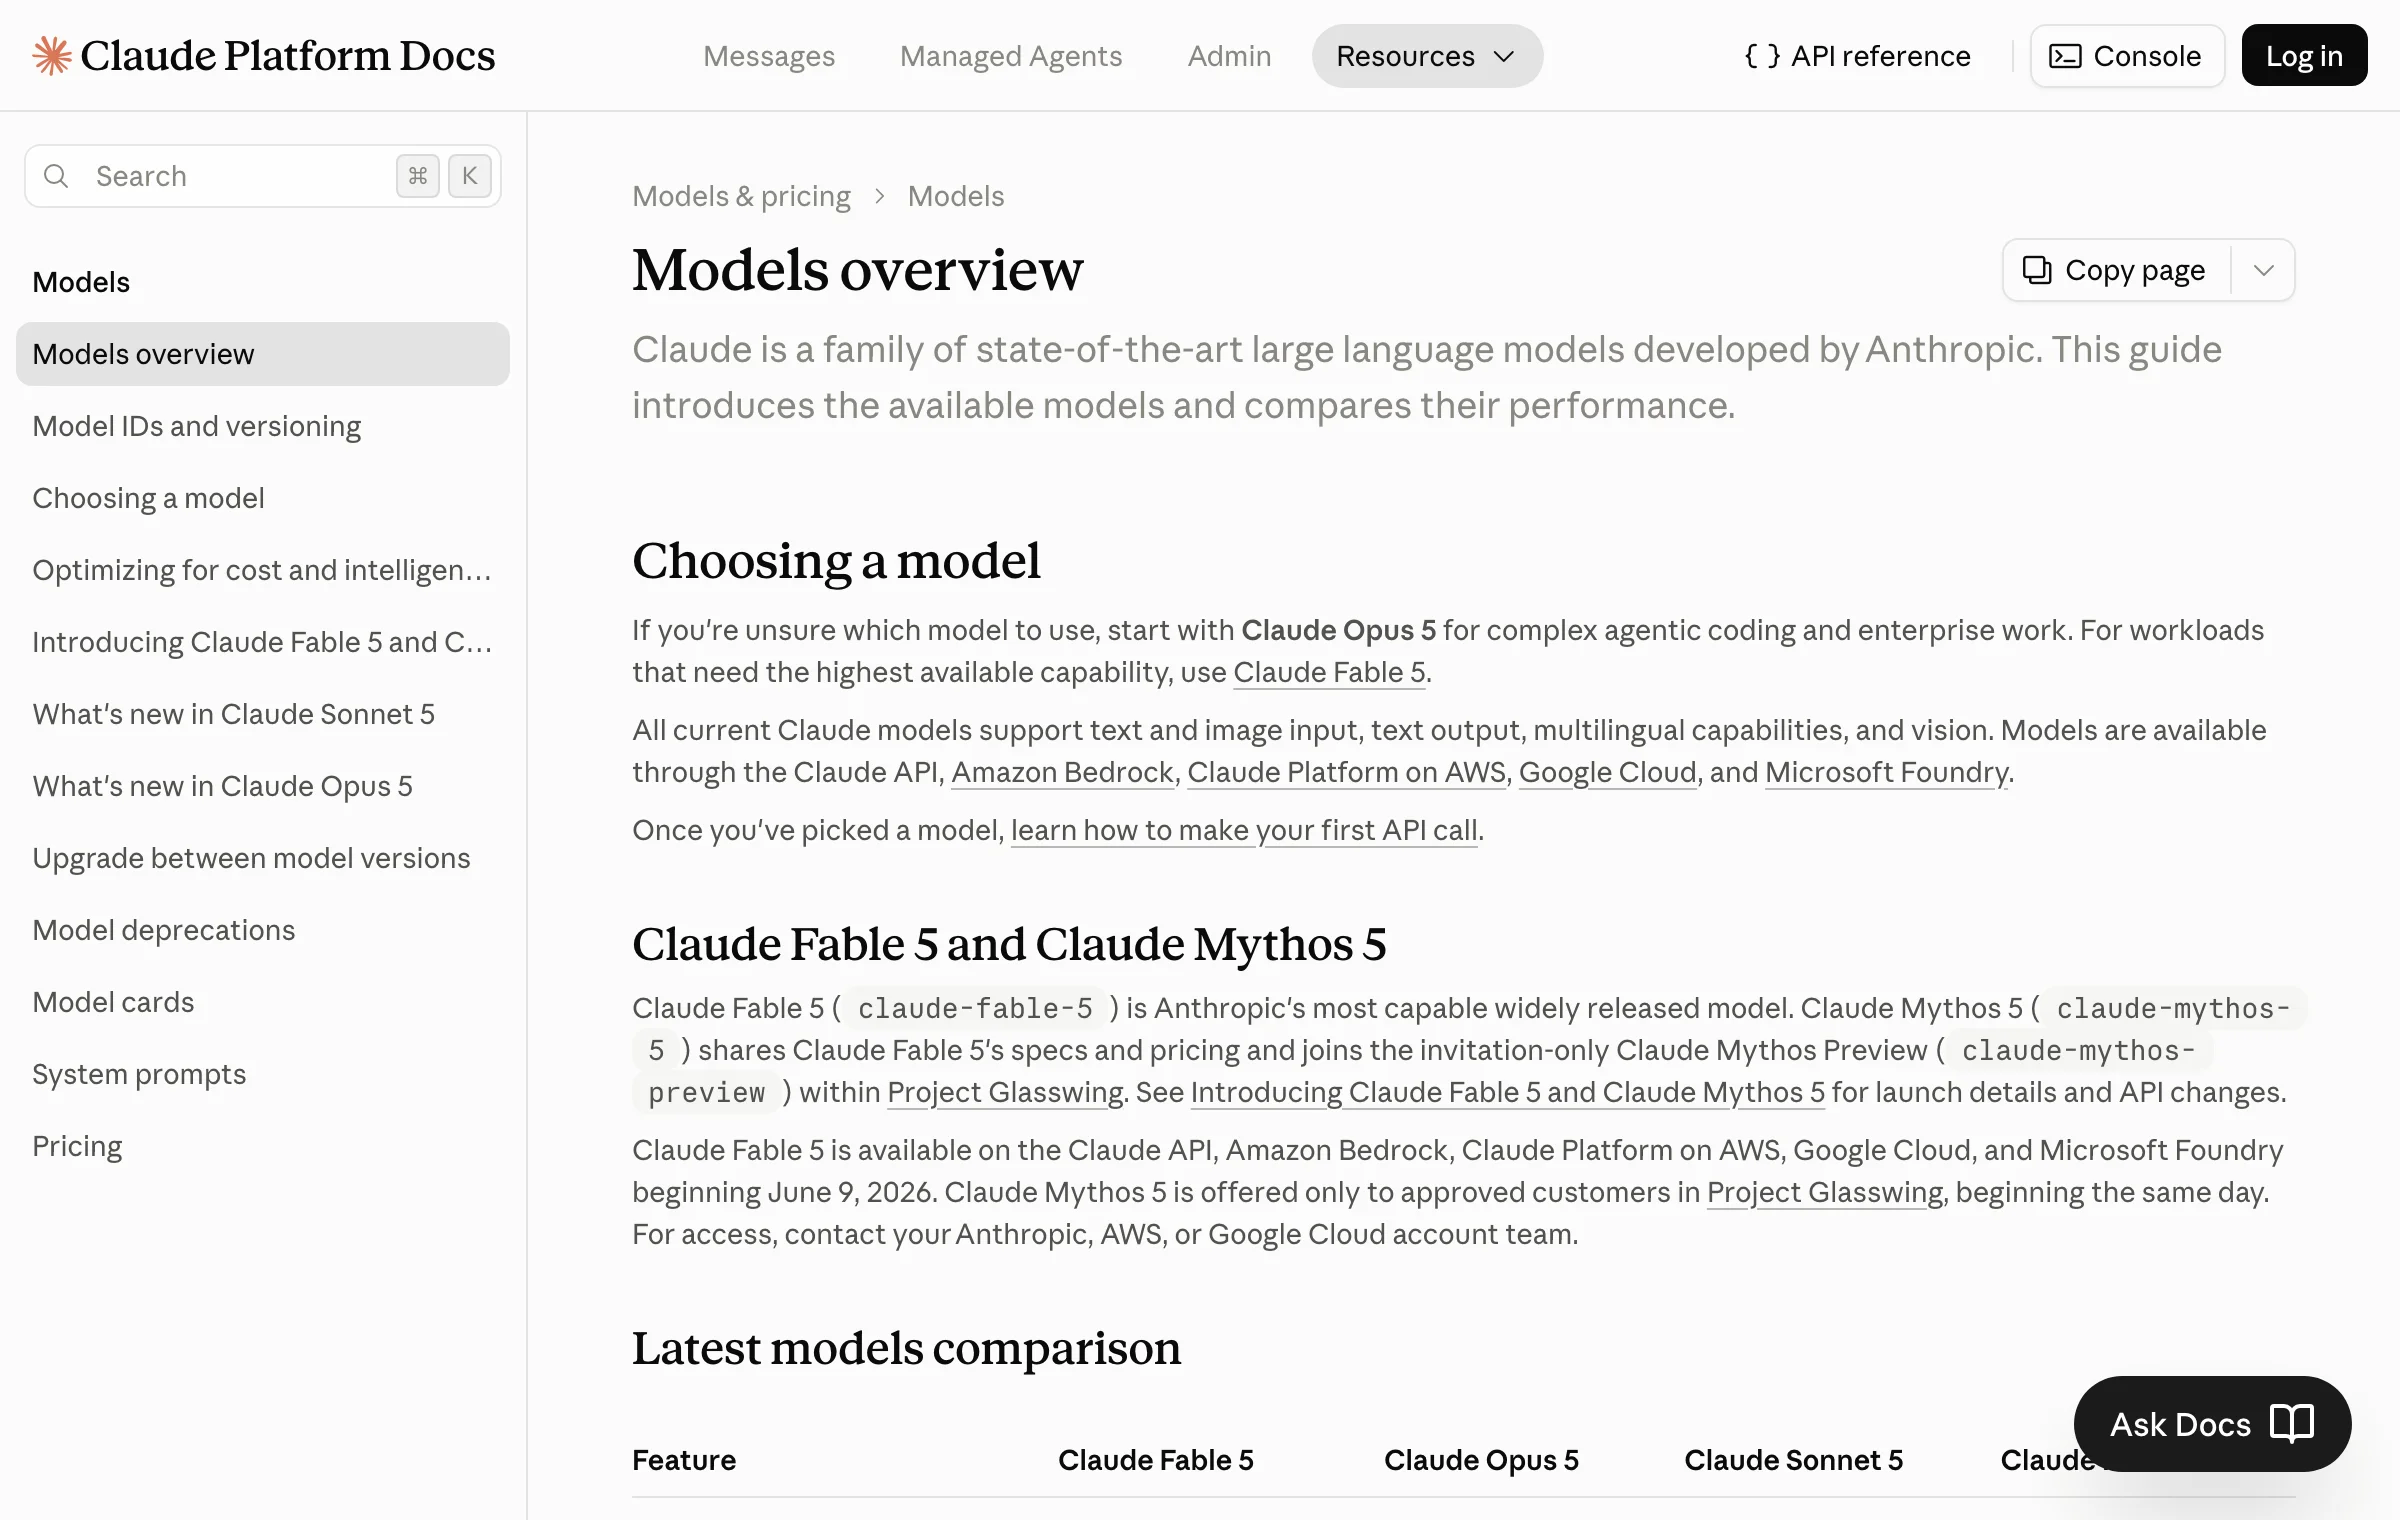 Claude Platform 模型总览,截图于 2026 年 8 月 23 日。模型 ID、价格、上下文、输出限制和相对延迟应以实时页面为准。
哪些任务值得先测 Opus 5
“永远先调用便宜模型”不一定真的省钱。一次失败的迁移、漏掉的风险或返工的专业交付,成本可能远高于 Token 差价。下面三个条件同时成立时,可以把 Opus 5 放进首轮评估:
- 任务价值足以覆盖更高的模型成本。 例如复杂代码迁移、根因分析,或必须由专家验收的多步骤产物。
- 模型需要维持较长的工作链路。 不只是回答问题,而是规划、调用工具、检查结果、修订并验证。
- 评测能证明它有优势。 在相同 harness、工具、Prompt 和验收测试下,Opus 5 相对 Sonnet 5 或其他候选模型确实带来有意义的提升。
这不等于“把全代码库一次喂进去,模型就能理解全部依赖”。上下文容量无法保证召回、相关性判断和跨文件推理一定正确。仓库地图、检索、分阶段验证与测试仍然重要。
哪些任务更适合 Sonnet 5 或其他模型
当任务高频、对延迟敏感、容易机械验收,或者便宜模型已经达到合格线时,应优先选择低成本路线。例如:
- 分类与路由;
- 按 schema 抽取;
- 测试充分的局部代码修改;
- 短摘要;
- 高频工具调用;
- 交互速度优先的用户界面。
也不要机械地把“规划”全交给 Opus、“执行”全交给 Sonnet。简单任务的规划可能很容易,而执行阶段反而包含关键判断。真正应观察的是每一类任务的失败模式。
1M 上下文解决什么,又没解决什么
1M 窗口减少了大型仓库、文档集、运行日志和会话状态被迫切片的问题,但没有消除四个生产约束:
- 无关输入仍然消耗费用和模型注意力;
- Prompt 越长,失败原因可能越难定位;
- 数据进入 Prompt 前仍要执行访问控制;
- 输出仍需对照原始证据和验收标准检查。
处理长上下文时,应记录实际传入了哪些文件或段落,保留引用与证据位置,并在不同 Prompt 长度下测试检索质量。目标是“最小但完整的工作集”,不是“尽量把窗口填满”。
按当前标价计算成本
下面只展示算术,不代表任务质量或项目总成本。
| 请求规模 | 输入成本 | 输出成本 | 合计 |
|---|---|---|---|
| 100K 输入 + 5K 输出 | $0.50 | $0.125 | $0.625 |
| 500K 输入 + 10K 输出 | $2.50 | $0.25 | $2.75 |
| 1M 输入 + 20K 输出 | $5.00 | $0.50 | $5.50 |
Anthropic 表示,符合条件的重复输入通过 Prompt caching 最多可节省 90%,Batch 处理符合条件时可节省 50%。但写入/读取费率、缓存期限与 Batch 延迟都会影响结果,生产预算应以当前定价文档为准。
通过 SandBase 调用 Claude Opus 5
SandBase 当前模型页将 Claude Opus 5 记录在 POST /v1/messages,模型 ID 为 anthropic/claude-opus-5。应以实时模型页的 schema 为准,不要假设 OpenAI Chat Completions 的请求结构一定暴露所有 Anthropic 原生能力。
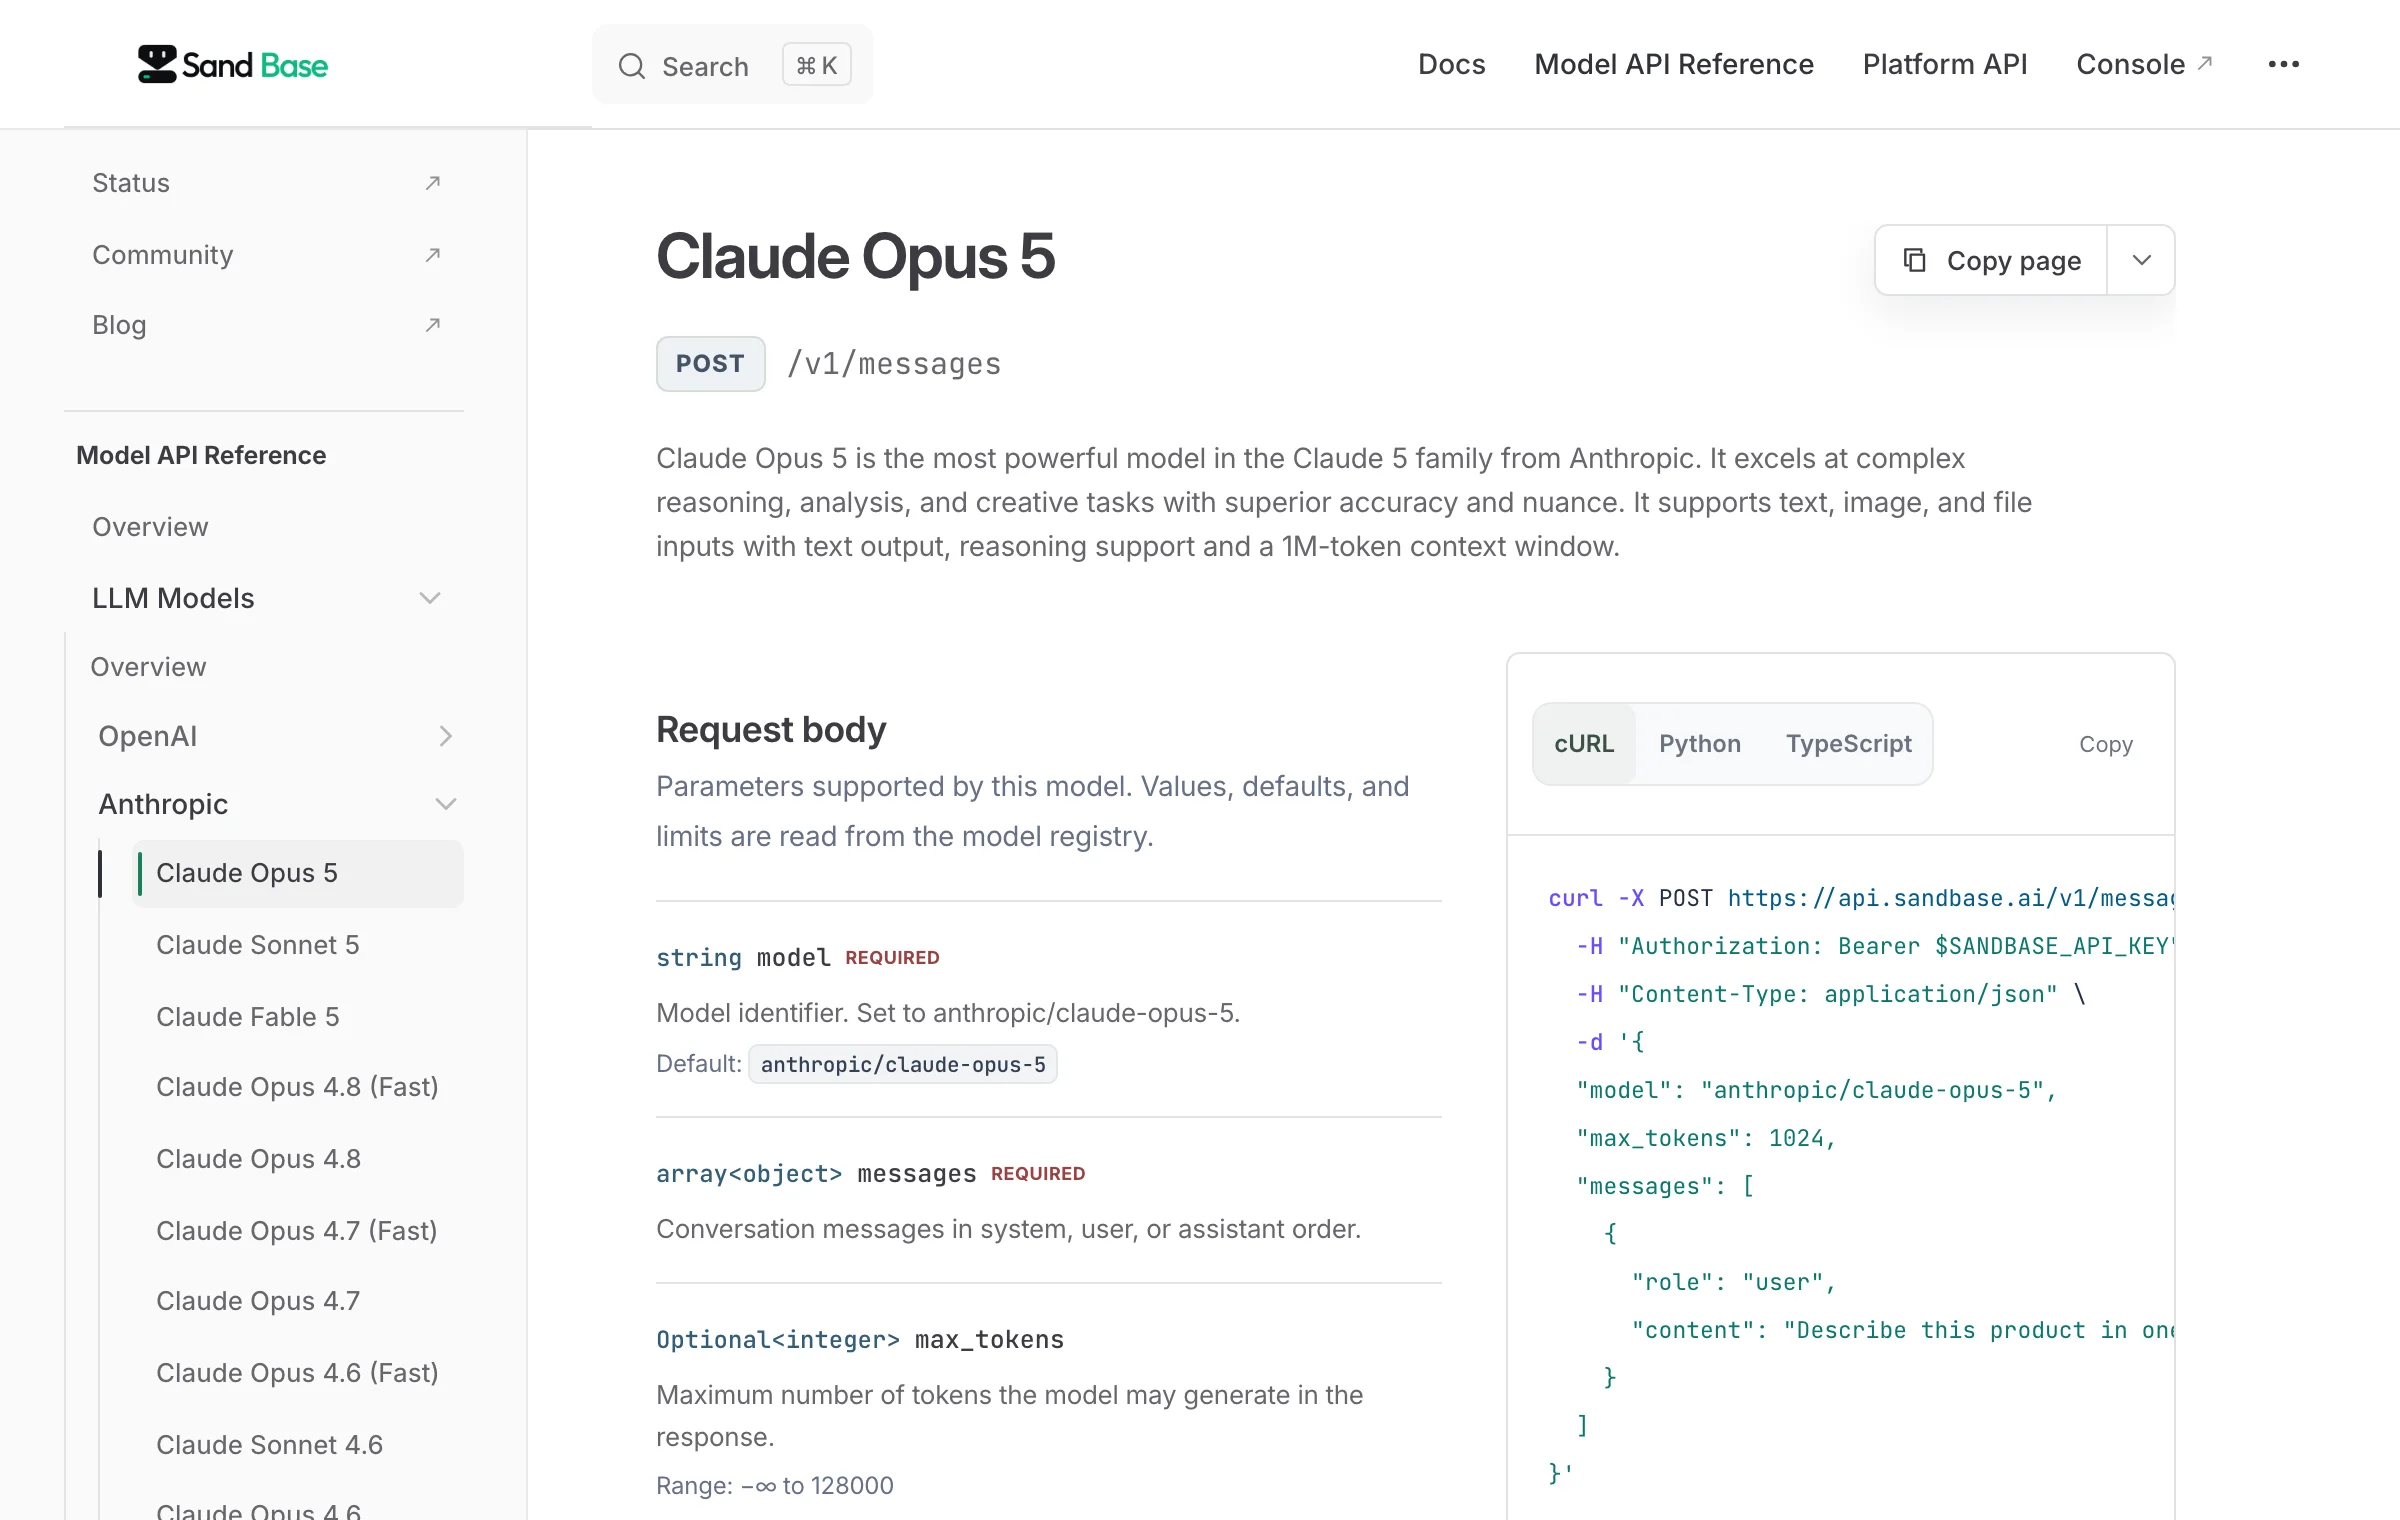 SandBase 模型参考页,截图于 2026 年 8 月 23 日,展示当前端点、模型 ID、请求字段与 128K 输出限制。
curl -X POST https://api.sandbase.ai/v1/messages \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "anthropic/claude-opus-5",
    "max_tokens": 2048,
    "messages": [
      {"role": "user", "content": "审查这份迁移计划,指出风险最高的假设。"}
    ]
  }'
调用前请查看 SandBase Claude Opus 5 API 参考核对当前字段与可用性。SandBase 提供集成入口,模型本身仍由 Anthropic 提供。
一套可执行的生产评测方法
在切换默认路由前:
- 选择 30–100 个真实任务,并由专家定义验收标准。
- 固定 harness、工具、上下文、重试和停止条件。
- 至少同时测试 Sonnet 5 与 Opus 5,并显式设置 effort。
- 记录任务完成率、人工修订量、工具失败、Token、延迟与总成本。
- 区分模型失败和检索、工具、权限或 harness 失败。
- 只把实测收益高于成本与延迟溢价的任务类别路由给 Opus 5。
- 模型、Prompt、工具或 harness 变化后重新评测。
这种方法能形成可解释的路由策略。通用百分比阈值,或凭空规定“最难的 20%”,都不能替代真实数据。
FAQ
Claude Opus 5 多少钱?
本文发布时,Anthropic 标价为每百万输入 Token 5 美元、每百万输出 Token 25 美元。Fast mode 为基础价的两倍,US-only inference 为 1.1 倍;购买前请检查实时定价页。
Claude Opus 5 是 1M 上下文吗?
是。Anthropic 当前模型表列出 1M 上下文和 128K 同步最大输出。Batch API 在指定 beta header 下可能有不同的输出限制。
Opus 5 还是 Anthropic 最强模型吗?
不是。Anthropic 当前模型总览将 Claude Fable 5 描述为其能力最强的广泛发布模型。Opus 5 的定位是以更低价格处理复杂 Agent 编码和企业工作。
Agent 应该默认使用 Opus 5 吗?
不应该一概而论。Sonnet 5 更快,输入和输出价格都是 Opus 5 的 40%;简单、高频或延迟敏感的任务可能无法从溢价中获益。默认模型应由具体工作负载评测决定。