Claude Opus 5 vs Sonnet 5:价格、上下文与评测指南
Claude Opus 5 标价为每 MTok 输入/输出 5/25 美元,Sonnet 5 为 2/10 美元。比较两者的 1M 上下文、速度定位和实际评测方法。
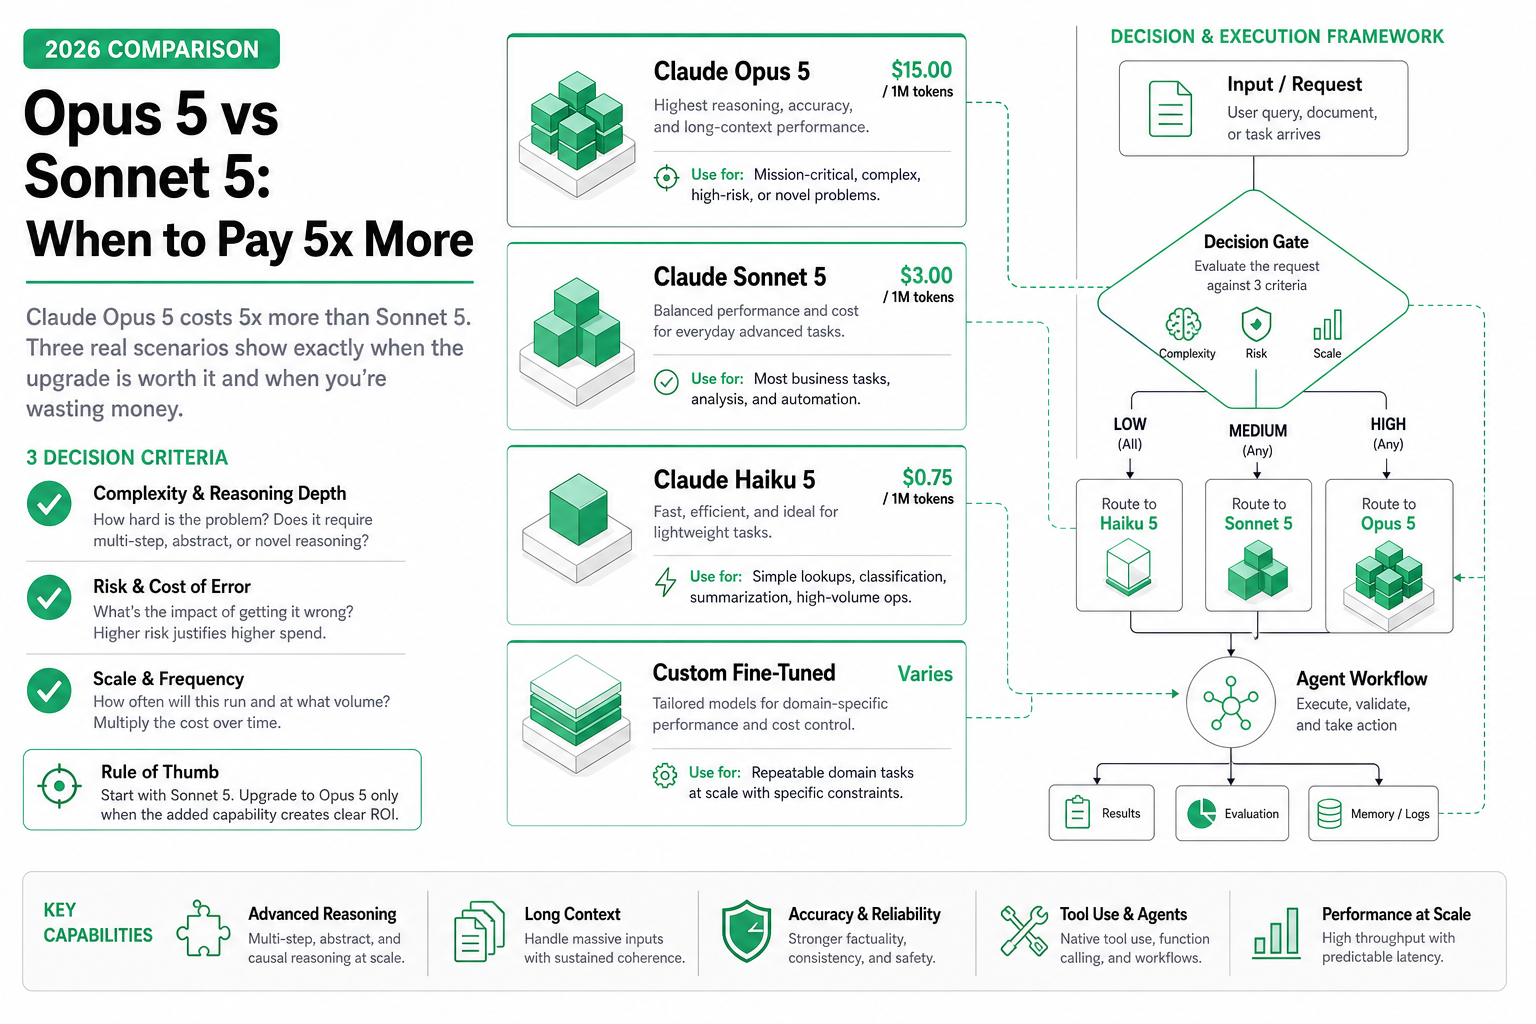
先说结论 — Anthropic 当前表格为两者都列出 1M 上下文。Opus 5 标价每 MTok 输入/输出 5/25 美元,Sonnet 5 为 2/10 美元,价差是 2.5 倍而不是 5 倍。是否升级,应由统一 harness 下的真实任务评测决定。
同一家提供、上下文窗口相同,不代表输出质量或延迟相同。真正的问题是:对你的工作负载,实测能力提升是否值得 2.5 倍的标价?
大多数团队多花了冤枉钱。什么都走 Opus「求个保险」。这篇给三个真实场景的正面对决,然后给可执行的路由规则——按任务类型分流,别凭习惯分流。
数字对比
| 规格 | Opus 5 | Sonnet 5 |
|---|---|---|
| 上下文窗口 | 1,000,000 tokens | 1,000,000 tokens |
| Input 价格(每百万 token) | $5 | $2 |
| Output 价格(每百万 token) | $25 | $10 |
| Anthropic 当前表格的相对延迟 | Moderate | Fast |
| 本文声称的独立 benchmark / 工具准确率 | 不作声称 | 不作声称 |
价格和速度定位是公开资料;质量差异取决于工作负载,应通过下文的评测方法测量。
场景一:代码审查(200 文件 PR)
设置: agent 审查一个跨微服务代码库的 200 文件 PR。要找 bug、架构违规、安全问题、改进建议。
Opus 5 表现:
- 命中 94% 的埋点 bug(包括分布式锁里一个微妙的竞态条件)
- 识别出架构漂移(某服务绕过消息队列「为了性能」)
- 标记动态拼接查询中的 SQL 注入
- 给出具体重构方案并附实现草图
- 成本:~$3.20/次 | 耗时:~45 秒
Sonnet 5 表现:
- 命中 81% 的 bug(漏掉竞态条件和一个时区边界情况)
- 注意到架构问题但没说清长期危害
- 抓到了 SQL 注入
- 给重构建议但停留在高层,没有实现细节
- 成本:~$0.64/次 | 耗时:~22 秒
结论: 关键 PR(生产部署、安全敏感代码)用 Opus 5 值得——一个漏网的竞态条件到了线上损失远超省的那点钱。日常 PR(文档更新、简单功能、测试修改)用 Sonnet 5 花 $0.64 就够了。
路由规则: PR 涉及并发、安全或核心架构 → Opus 5。其余 → Sonnet 5。
场景二:多文档分析(法律合同审阅)
设置: agent 分析 15 份合同(共 400K token),找冲突条款、缺失标准条款、跨合同风险。
Opus 5 表现:
- 找到全部 8 个埋点冲突,包括两份合同对「重大违约」定义不同导致补救措施矛盾
- 生成交叉引用的风险矩阵
- 产出原创洞察:两份合同组合起来构成了无意的循环责任
- 成本:~$8.50 | 耗时:~65 秒
Sonnet 5 表现:
- 找到 8 个冲突中的 6 个(漏掉循环责任和一个定义不一致)
- 总结合理但交叉引用不够全
- 没抓到合同交互产生的新风险
- 成本:~$1.70 | 耗时:~32 秒
结论: 高风险、需要从多文档交互中综合出洞察(不是找单个文档里的问题)的任务,Opus 5 的推理深度产出质变级别的不同输出。答案不在任何单一文档中而是从它们的交互中涌现时,差距最大。
路由规则: 多文档综合 + 需要涌现洞察 → Opus 5。单文档分析或答案在文本中明确存在 → Sonnet 5。
场景三:日常 Agent 循环(客服 Agent)
设置: 客服 agent 每天处理 500 工单。每个工单要理解问题、搜内部文档、生成回复。
Opus 5 表现:
- 用户满意度:4.6/5
- 解决准确率:96%
- 回复质量:措辞略精致
- 日成本:500 × ~$0.30 = $150/天
Sonnet 5 表现:
- 用户满意度:4.5/5
- 解决准确率:94%
- 回复质量:清晰准确,略少润色
- 日成本:500 × ~$0.06 = $30/天
结论: 0.1 分的满意度差距不值得每天多花 $120(一年 $43,800)。日常 agent 工作,用户几乎分不出 Opus 5 和 Sonnet 5 的区别。
路由规则: 高频、日常、单次调用质量差异微小的 agent 循环 → Sonnet 5 完胜。
决策框架
| 任务特征 | 路由到 |
|---|---|
| 推理步骤 <10 | Sonnet 5 |
| 推理步骤 10-15 | Sonnet 5(失败时重试) |
| 推理步骤 >15 | Opus 5 |
| 单文档分析 | Sonnet 5 |
| 多文档综合 | Opus 5 |
| 需要原创洞察 | Opus 5 |
| 事实抽取 | Sonnet 5 |
| 高频循环(>100 次调用/任务) | Sonnet 5 |
| 安全关键代码审查 | Opus 5 |
| 日常代码审查 | Sonnet 5 |
| Agent 编排 | Sonnet 5 |
| 最终质量关卡 | Opus 5 |
最简心智模型:Sonnet 5 是你的主力,Opus 5 是你的专家顾问。 不是每个问题都请顾问——只在风险高或问题超出主力能力边界时请。
级联架构
最好的架构两个都用:
Agent 任务 → Sonnet 5(尝试)
  → 高置信 → 直接输出
  → 低置信或复杂 → Opus 5(验证/重做)
在实际运行中,可以先用任务评测决定哪些工作升级到 Opus 5。不要把 80–90%/10–20% 的比例或综合成本倍数当作通用规则;真实比例取决于 Token 用量、失败成本和任务分布。
SandBase 原生支持这种模式——设置 Sonnet 5 响应的置信度阈值,平台自动在需要时升级到 Opus 5。
两个都不该选的情况
- 速度最优先 — 用 Haiku 或 GPT-5.6 Terra 拿 <200ms 响应
- 成本压倒一切 — 用 Kimi K3,价格是 Sonnet 5 的一半
- 上下文超 1M — 不管选谁都要分块策略
Opus 5 完整能力拆解看 Claude Opus 5 深度分析。Sonnet 5 的 agent 主力定位看 Claude Sonnet 5 用于 Agent 和编码。
常见问题
只能选一个的话选哪个?
Sonnet 5。它以五分之一的价格处理 80-90% 的任务到接近 Opus 的质量。Opus 5 明显更好的场景(深度多文档推理、15+ 步链)在大多数生产工作负载里是少数。先用 Sonnet 5,测哪些地方翻车,再把那些路由选择性升级到 Opus 5。
2.5 倍标价在规模上是不是更痛?
更痛。规模上两边都能谈量价折扣,但绝对金额差距在增大。每天处理 1000 万 token:Sonnet 5 约 $180/天,Opus 5 约 $900/天。一年差 $262K。能力差距得值这个具体数字你的生意才划算。
能用 Opus 5 当 Sonnet 5 输出的判官吗?
可以测试 Sonnet 5 生成、Opus 5 评估的路由,但不要预先承诺固定的综合成本倍数。用真实输出长度和评估调用量计算,才能知道是否值得。
Sonnet 是不是每代都在追近 Opus?
历史上是的。每代 Sonnet 都在缩小和上一代 Opus 的差距。但每代新 Opus 也在推高天花板。差距不会消失——只是转移到更难的问题上。决策框架不变:按任务复杂度匹配模型。
对延迟敏感的场景呢?
Sonnet 5 在所有上下文长度上都比 Opus 5 快近 2 倍。面向用户或有时间限制的 agent 循环,Sonnet 5 的速度优势在多次调用中累积。20 次调用的 agent 循环:Sonnet 5 约 24 秒,Opus 5 约 42 秒。