Threads 创作者研究 API 教程
用一次请求读取已知 Threads 账号资料或搜索候选;核对响应结构、保留未知指标,先确认身份再决定后续查询。
已经知道 Threads 账号,和只知道品牌名称,不该走同一条接入路径。前者直接查资料,后者先搜索候选,再确认哪个才是目标。这篇 Threads 创作者研究 API 教程先解决这两个首次请求,不把模糊匹配自动当成已确认的身份。
2026-11-08 本次修订核对了免费端点 inspect 和当前公开参考响应,没有执行付费 Threads 业务请求。原文 2026-09-27 UTC 的资料实测保留在后半篇,run ID 与 JSON 数值不改。Threads API 总览介绍更广的能力范围;这里的当前代码只读一次资料,或返回一次候选搜索。
先说结论
- 已知账号用
threads/web/user-info,参数是username,业务载荷里检查user对象。- 找候选用
threads/web/search-profiles,参数是query,候选位于xdt_api__v1__users__search_connection.edges[].node。- 两者都只读取
outputs[0].data。关键结构缺失应报错,不能当成空资料或零粉丝。- 不自动选首条匹配、不遍历账号、不排名、不抓帖子,也不自动重试或翻页。
Threads 创作者研究 API:先区分输入
| 已有信息 | 所选请求 | 需要判断什么 |
|---|---|---|
| 已确认的账号 handle | 用户资料 | 返回的这个账号资料 |
| 品牌名、显示名或查询词 | 资料搜索 | 候选账号集合,还不是最终选择 |
资料 schema 只有一个必填字符串 username,搜索只有一个必填字符串 query。两者都没有声明 page、cursor、end_cursor 或 limit。不要把帖子接口的分页参数移植过来,也不要写成可以自动搜到下一页。
例如主页链接 https://www.threads.net/@nasa 对应的输入是 nasa,不是完整 URL,也不是数字账号 ID。helper 接受裸 handle 或一个前导 @,去掉两端空白,并用字母、数字、点、下划线做简单格式检查。这只是本例的本地输入限制,不宣称穷尽了上游所有用户名规则,更不能据此确认账号存在。
搜索本来就比精确资料查询宽。当前公开参考明确提醒:目标名称旁边可能混有相似 handle。显示名相同或带认证标记,都不能单独证明就是你要找的组织。先将 username 与目标身份核对,再决定是否追加资料请求。代码保留全部候选 node,不取第一条当最终答案。
已有项目或 agent 怎么接
已经有 Key,就复用项目本地的 SANDBASE_API_KEY 或现有密钥存储。agent 已连接 SandBase,就使用现成连接并检查所选端点,不必再创建 Key。新项目可以把 setup skill 和 Markdown quickstart 交给 agent,再说明任务、handle 或查询词;密钥不贴进对话,也不写入示例源码。
可以这样描述:“使用现有 SandBase 连接,先检查 threads/web/search-profiles,再按我给的名称查询一次,把候选留给我核对。不自动选账号,不逐个查资料,不按粉丝排名,不读取帖子。”如果已经知道账号,把任务改为一次 user-info。先明确停止点,就不会让小查询悄悄扩成一整套调研。
Python 环境先运行 python3 -m pip install requests,把代码存为 first_request.py,本地配置 Key 后运行 python3 first_request.py。主程序默认读取一次示例账号 nasa。改成搜索时,将最后两行替换为 result = first_request("search", "OpenAI") 和 print("Candidate count:", len(result[SEARCH_CONNECTION]["edges"]))。这是两种备选任务,不是把两个请求接起来执行。
单次请求,按端点检查结构
使用端点 README 的 Model API POST 路由:https://api.sandbase.ai/v1/api/threads/web/<operation>,JSON 只放 username 或 query。目录 GET 路径和上游 schema 内嵌的通用 /v1/run 条目,都不能替代这里明确记录的逐端点请求。
import os
import re
import requests

SEARCH_CONNECTION = "xdt_api__v1__users__search_connection"


def first_request(task, value):
    if not isinstance(value, str) or not value.strip():
        raise ValueError("Provide a known username or a search query")
    value = value.strip()
    if task == "profile":
        username = value[1:] if value.startswith("@") else value
        if not re.fullmatch(r"[A-Za-z0-9._]+", username):
            raise ValueError("Use a username, not a profile URL")
        path, params = "user-info", {"username": username}
    elif task == "search":
        path, params = "search-profiles", {"query": value}
    else:
        raise ValueError("Choose profile or search")
    key = os.environ.get("SANDBASE_API_KEY", "").strip()
    if not key:
        raise RuntimeError("Set SANDBASE_API_KEY locally")
    try:
        response = requests.post(
            f"https://api.sandbase.ai/v1/api/threads/web/{path}",
            headers={"Authorization": f"Bearer {key}"}, json=params,
            timeout=(10, 90), allow_redirects=False,
        )
        if not 200 <= response.status_code < 300:
            raise RuntimeError(f"SandBase HTTP {response.status_code}")
        body = response.json()
    except ValueError:
        raise RuntimeError("SandBase returned invalid JSON") from None
    except requests.RequestException:
        raise RuntimeError("SandBase network request failed; not retried") from None
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("SandBase request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Missing documented outputs[0].data")
    payload = outputs[0].get("data")
    if not isinstance(payload, dict):
        raise RuntimeError("Missing documented outputs[0].data")
    if task == "profile":
        user = payload.get("user")
        if not isinstance(user, dict) or not user:
            raise RuntimeError("Missing or empty Threads user object")
    else:
        connection = payload.get(SEARCH_CONNECTION)
        if not isinstance(connection, dict) or not isinstance(connection.get("edges"), list):
            raise RuntimeError("Missing Threads search connection/edges array")
        for edge in connection["edges"]:
            if (not isinstance(edge, dict) or not isinstance(edge.get("node"), dict)
                    or not edge["node"]):
                raise RuntimeError("Missing or empty Threads search node object")
    return payload


if __name__ == "__main__":
    result = first_request("profile", "nasa")
    print("Profile name:", result["user"].get("full_name"))
共用 SandBase 信封,不代表业务载荷相同。资料必须是非空 user 对象;搜索必须有指定 connection 对象、edges 数组,以及每条 edge 内的非空 node 对象。空 edges 数组可以成立,数组不存在则不能。拒绝空资料或空 node 是本例的完整性检查,避免把无法使用的记录打印成成功查询。
两个公开参考响应都不需要 code: 0 或 success: true 规则,所以代码没有套用其他平台的成功判断。HTTP 失败、状态未完成、非法 JSON、旧顶层 output、缺少资料或搜索结构,都会停止,不把上游错误吞成“没有候选”。可选业务字段原样保留,不自动补值。
请求设置连接和读取超时,不跟随跳转。遇到超时、网络错误或 401/402/403/429/5xx,都不会自动再发一次。错误信息不回显密钥或原始上游正文。按情况先查鉴权、账户计费上下文或限流,再决定是否另行尝试。离线 mock 只能证明这些客户端行为,不能证明上游此刻可用。
看资料与候选,不制造排名
当前公开资料参考展示的是 NASA,样本里有显示名、简介、粉丝数、认证标记和空 bio_links。这些是已公开样本中观察到的字段,不是本次修订刚测出的数字,也不保证每条资料都包含。字段可能缺失或为 null。没有 follower_count 表示未知,显式数字 0 则是返回值;把两者合并会丢失信息。
is_verified 缺失也不能自动变成 false。“没有提供”和“明确为 false”是不同状态。以后要做表格,先保留未知值与读取日期,再决定比较规则。粉丝数是资料指标,不能直接当作帖子触达、投放效果或受众质量。
公开搜索样本的 node 里有 username、full_name、id、pk、is_verified 等身份字段,但没有据此保证每个候选都有粉丝数。因此不能把搜索结果直接丢进旧版粉丝排序逻辑。候选先保持候选,决定继续查谁是后续独立任务。
资料参考中的空 bio 链接,也没有证明非空链接元素一定是什么结构。要提取链接,先看一条真实返回,再写映射。JSON 里的链接或头像 URL 不会被这个示例自动访问,它不下载头像、不跟 bio,也不宣称能读取私有账号内容。
价格与免费额度资格
2026-11-08 免费 inspect 显示,资料查询 base price 为 $0.002,资料搜索为 $0.003。两者都具备组织每天 100 次数据 API 共享免费额度资格,00:00 UTC 重置。本次没查询剩余额度,也没执行业务请求。符合资格,不等于下一次一定免费。
抵扣可能的额度之前,单次请求按所选端点价格预算。若搜索一次,再人工选中一个账号查资料,属于两个独立请求,按当前基础价合计 $0.005。这只是规划算术,不是示例自动执行的链路,也不是本次实际扣费。更大的账号列表需要另定预算,并保留每次错误,不能静默跳过。
历史资料实验:2026-09-27
原教程会遍历账号并对扁平记录排序。双语 Python 原文归档逐字保留原来的八段代码,并记录来源提交与 SHA256。旧代码跳过缺资料的账号、将缺粉丝数补为 0、将缺认证标记补为 false,再遍历 handle 列表。它只供追溯,不再作为当前执行建议。原封面的排名卡片也是概念示意,不是一份经过验证的创作者榜单。
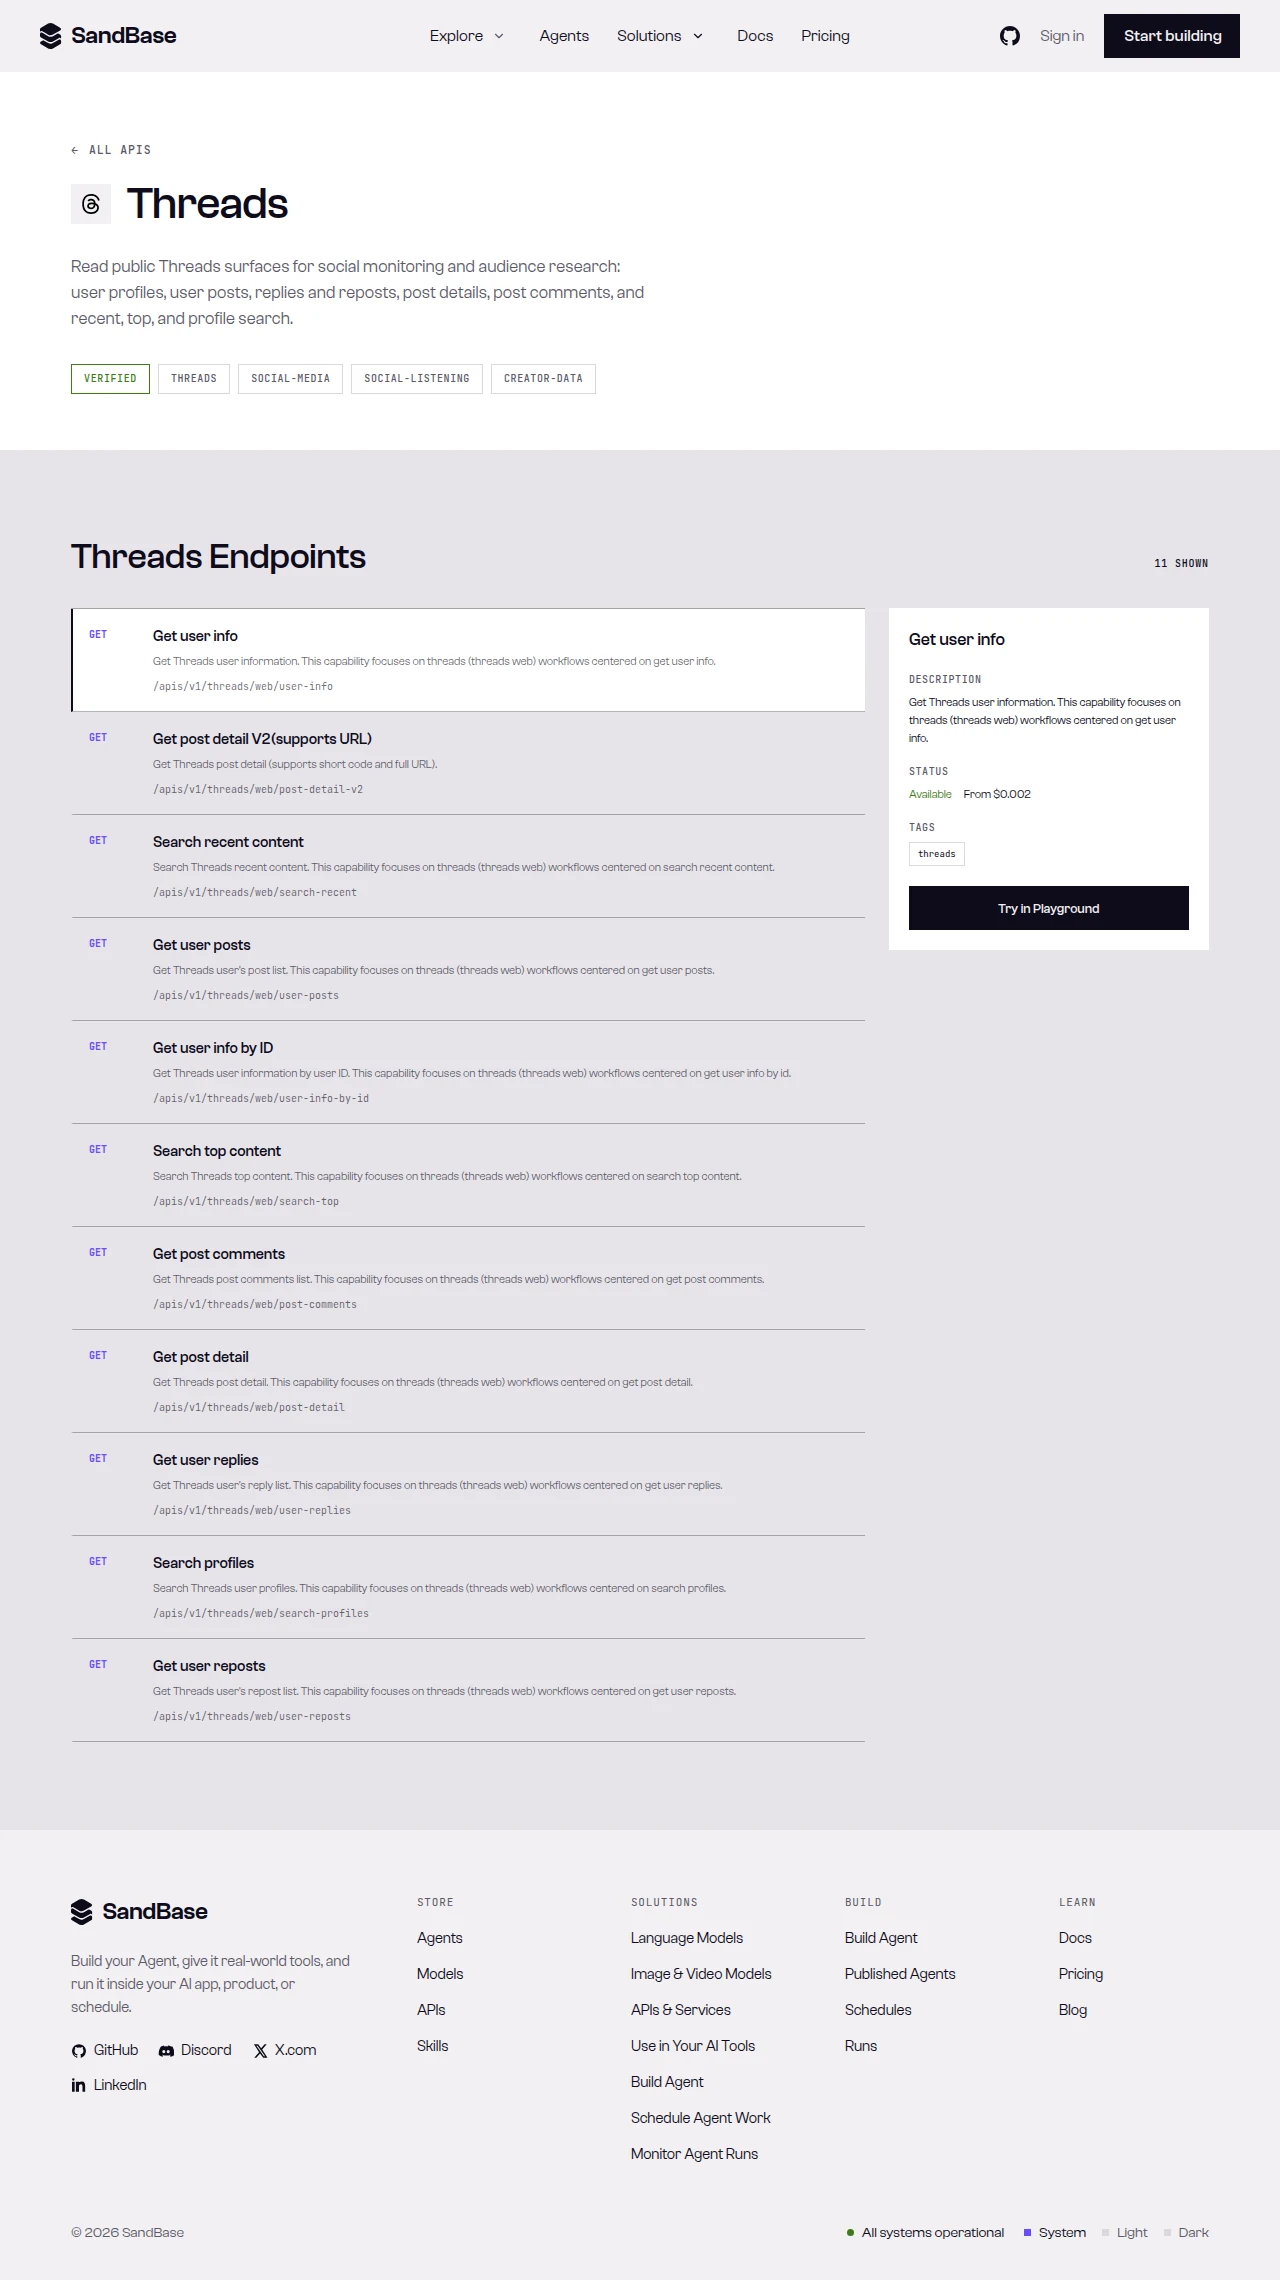 历史目录截图,2026-09-27。展示端点列表,不是一次成功的资料或搜索执行;当前输入和价格另行核对。
原文对 zuck 的资料读取 run 是 77059cb9-8616-4be1-abfe-96e82a12b54f。下面 JSON 原样保留,粉丝数与简介只表示那个历史时间点,不是当前数值:
{
"id": "77059cb9-8616-4be1-abfe-96e82a12b54f",
"status": "completed",
"model": "threads/web/user-info",
"outputs": [
{
"data": {
"user": {
"full_name": "Mark Zuckerberg",
"biography": "Mostly superintelligence and MMA takes",
"follower_count": 5744972,
"is_verified": true,
"bio_links": [],
"id": "63055343223",
"pk": "63055343223"
}
}
}
]
}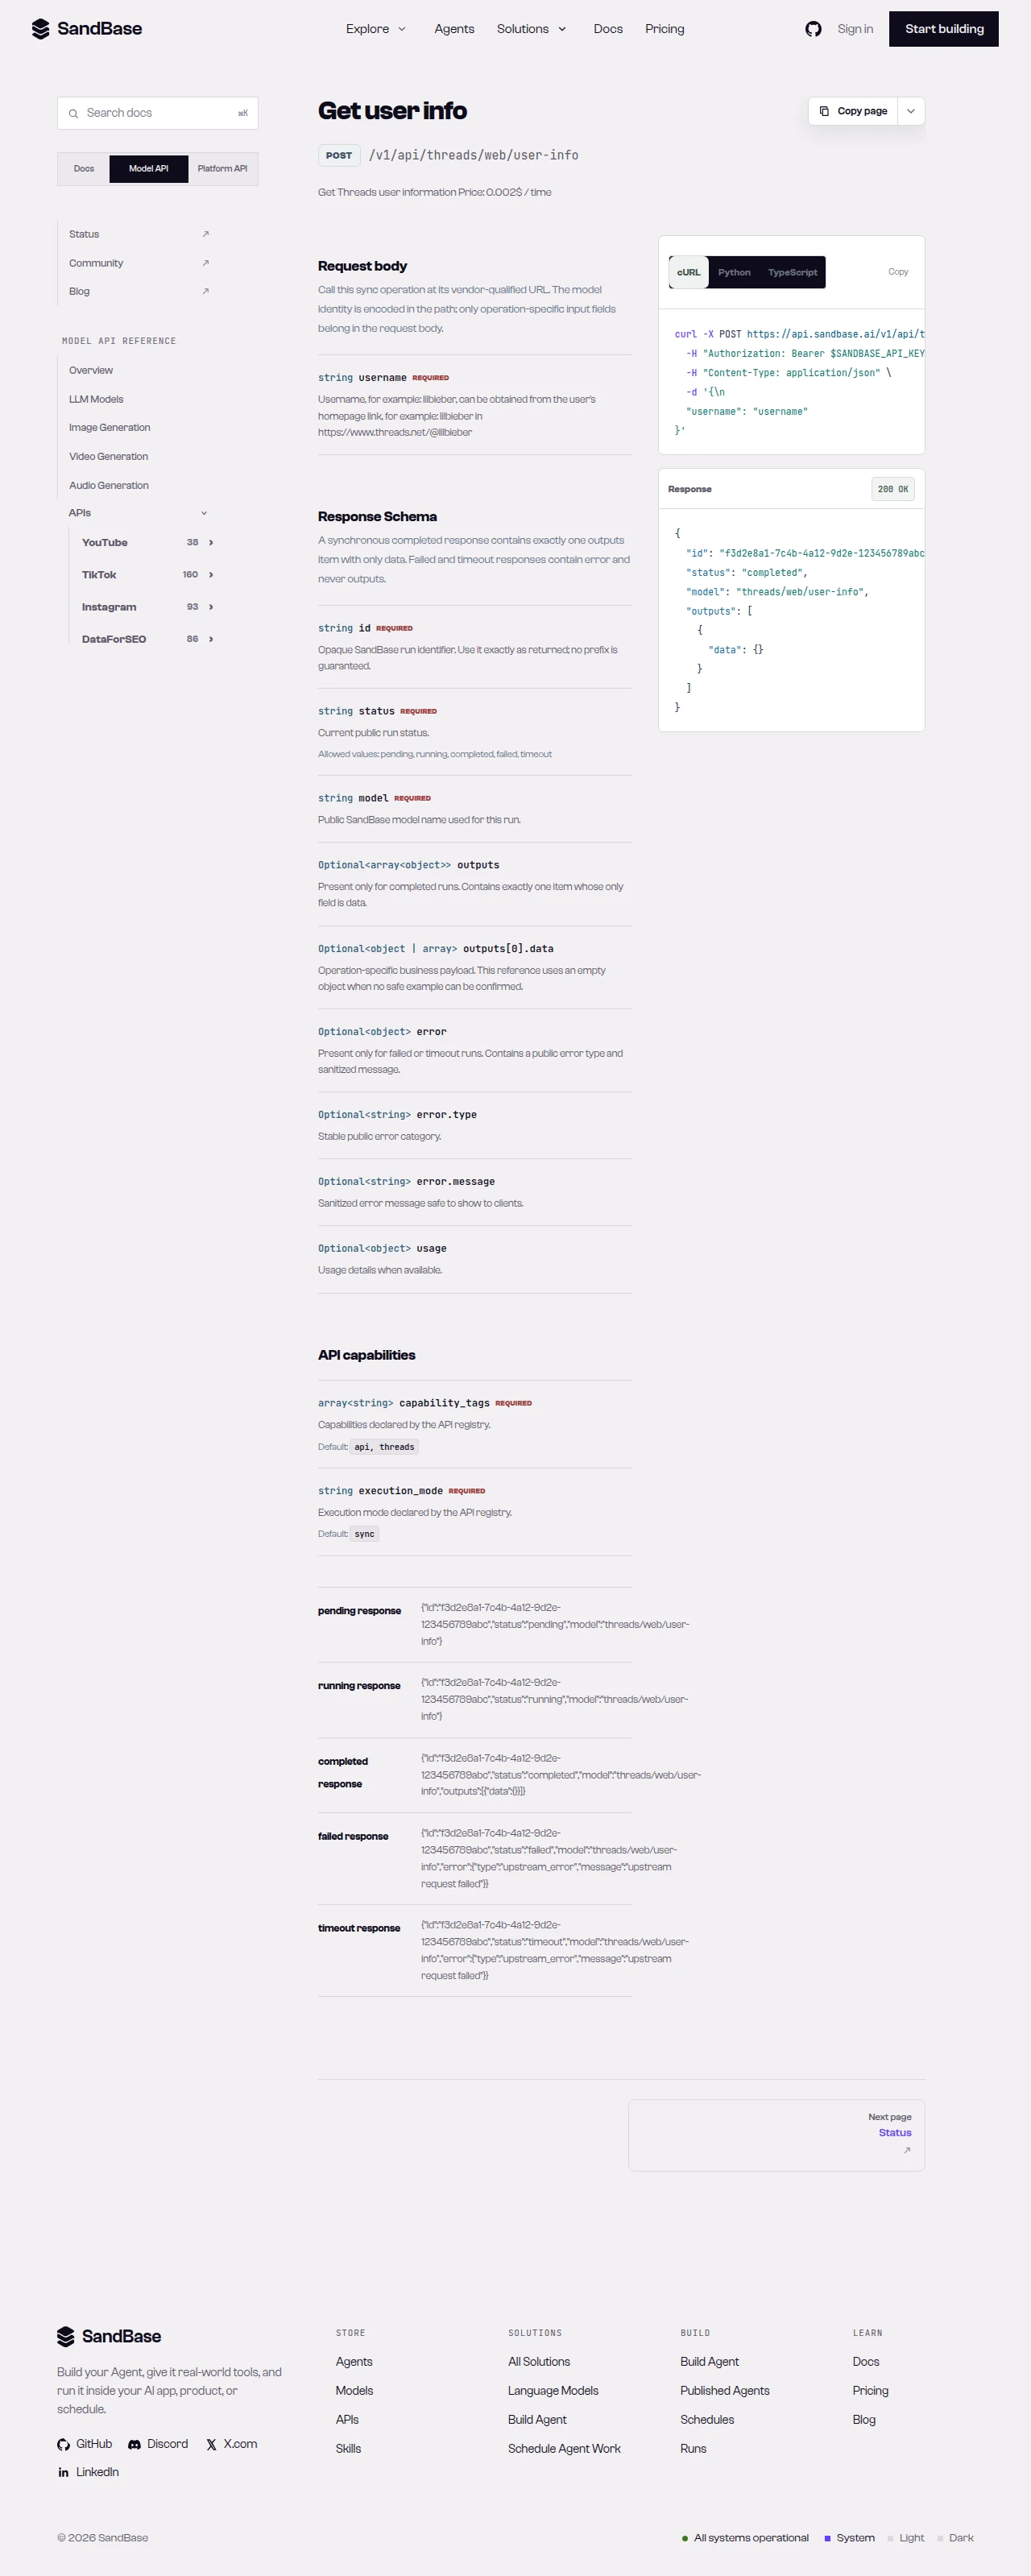 历史 user-info 参数参考截图,2026-09-27。实际历史资料样本是上方 JSON,截图不是本次业务执行证据。
旧列表写了 zuck、mosseri、natgeo,但本文保留的是一份明确资料响应,不能据此证明列表里每个账号都返回了相同字段。旧排序使用 (verified, followers) 降序,认证才是第一排序键,并非简单的“按传播度排序”。缺值补零和补 false 又进一步影响比较。新版直接移除这个排序,而不是给它换个名字继续当作已审核结论。
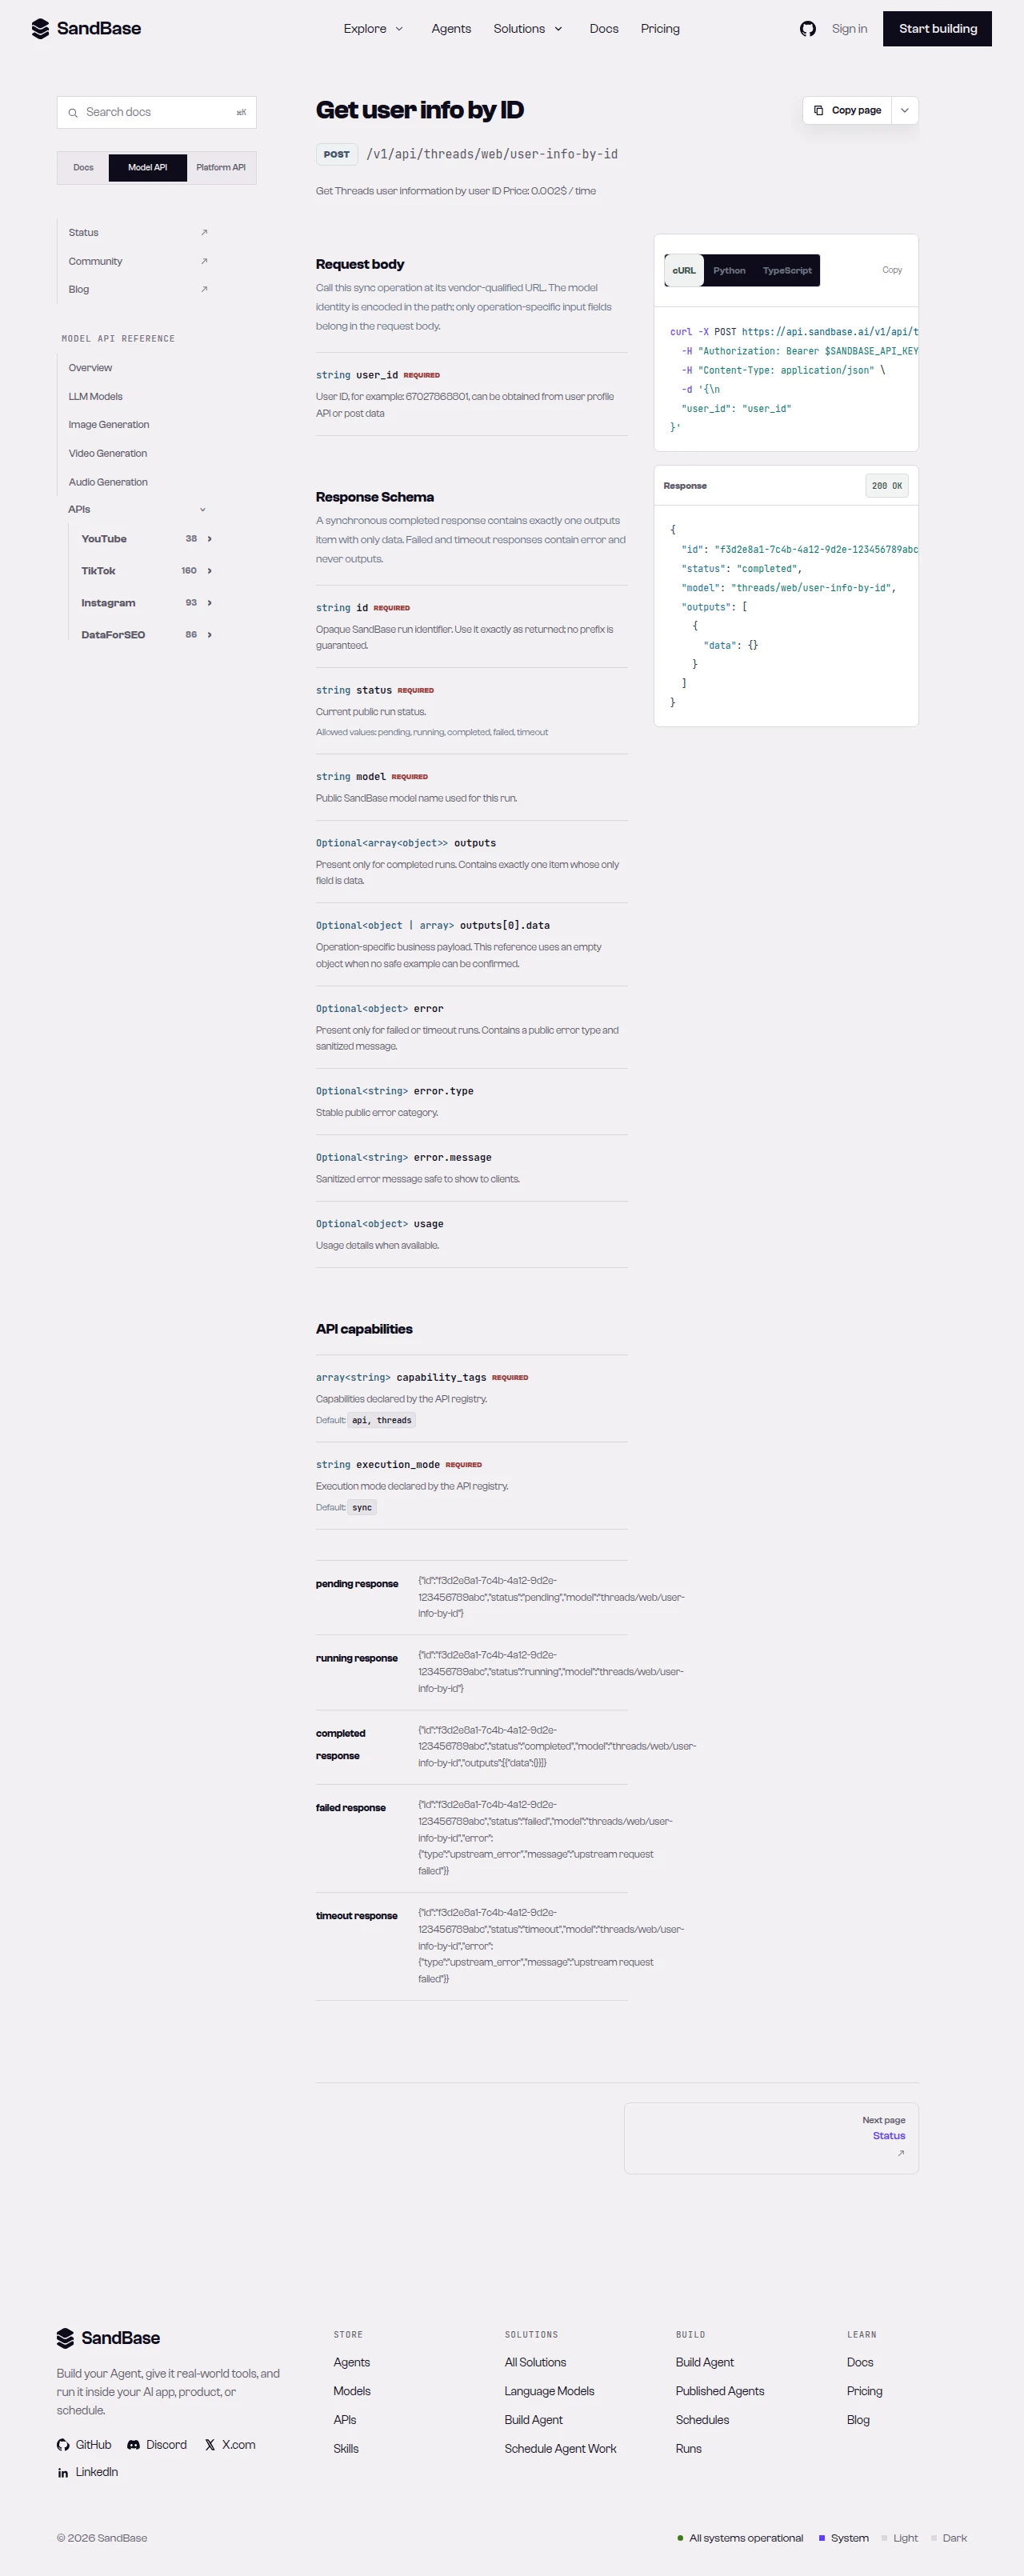 历史 user-info-by-id 参数参考,2026-09-27。它与按 username 查询不是同一端点,当前行为不在本次复验范围。
常见问题
需要 Threads 或 Meta 登录吗? 这两个当前请求 schema 使用 SandBase 鉴权,不要求 Threads 登录 cookie 或 OAuth token,也不授予私有或账号授权内容的访问权限。
为什么资料缺失要报错?
缺少、为 null 或空的 user,都不等于一个已经确认、粉丝数为零的账号。helper 会报告问题,让它与可选字段缺失的有效资料分开。
能直接取搜索第一条吗? helper 不会这样做。搜索可能含相似账号,追加任何请求前先核对用户名与目标身份。
怎么获取更多候选?
本次检查的搜索 schema 只声明 query,不能自造 page、cursor 或 limit。本文不承诺完整搜索覆盖,也没验证续页机制。
可以继续读取帖子和回复吗? 这是其他端点与任务,本次未验证它们的当前可用性、价格、标识或分页。扩展前应单独检查。
先从确实已知的输入发出一条请求,保留未知字段,再判断哪些后续研究值得继续。
觉得有用?分享给更多人