知乎公开数据 API | SandBase
用一个 REST API 读取知乎公开的问题、回答、文章、热榜和用户资料。无需知乎登录,无需 SDK,一把 SandBase key,为 agent 而建。
知乎是一个中文问答和知识社区——长篇回答、专家专栏、一个追踪全国在讨论什么的热榜,还有充满领域信号的用户资料。这直接对应到知识挖掘、趋势调研和专家发现。但想用程序拿到这些数据,通常得逆向网站、管理 cookie,还要在标记每次变动时重建爬虫。
SandBase 的知乎公开数据 API 把这层搭建成本去掉了。它通过普通 REST 端点读取知乎公开的问题、回答、文章、热榜、搜索和用户资料——一把 SandBase API key,不用知乎登录,也不用 SDK。端点参考保证的是响应信封(id、status、model,以及 outputs[0].data);下面出现的业务字段是示例结构,不是保证的 schema,请以一份真实响应为准核对。
这不是知乎的官方开放平台。 如果你需要已认证的成员操作或一份授权的数据协议,请用知乎官方渠道;当你的流程需要的是公开、只读的数据(调研、监测)时,用 SandBase。想直接试?领取 SandBase API key,再浏览知乎端点。
先说结论
- 一个 API 读取知乎公开的问题、回答、文章、热榜、搜索和资料。
- 本文的 Model API 端点用
POST /v1/api/zhihu/<path>调用——只传该端点的参数,不用 SDK,一把SANDBASE_API_KEY。- 端点以自然标识为入参:内容用
question_id/answer_id/article_id,人用user_url_token,搜索用keyword。- 它只返回公开、只读数据。不能发帖、你这边不用登录、也拿不到私密数据;鉴权用 SandBase API key。
当前范围:一个已知问题
2026-11-08 修订通过免费 inspect 和公开样本核对问题详情、问题回答,没有执行付费业务请求。更广的发现、搜索、资料介绍保留自 2026-09-27 总览,属于历史导航,不是本轮执行验证。原封面是概念插画,其中示意姓名、数字、标题、专业标签都不是实测结果或验证过的排名。
已有问题 ID,就在详情与回答信息流中选一个。问答教程提供完整校验的单次 Python 请求,并覆盖已有 Key、已连接 Agent、新项目三条接入路径。不会自动选热榜第一项,不会串三个端点或继续翻页。
两个选定端点的基础价都是 $0.001,均符合组织共享的每日 100 次合资格调用额度,在 UTC 00:00 重置。资格不是剩余额度;本次没有查余额、剩余次数或实际扣费,不能承诺一次请求必定免费成功。
你到底需要哪个知乎 API?
| 你的需求 | 选择 | 原因 |
|---|---|---|
| 发帖、以成员身份操作,或用账号授权数据 | 知乎官方渠道 | 成员和账号操作走知乎官方。 |
| 读取公开的问题、回答、文章或资料 | SandBase 知乎公开数据 API | 普通 REST、一把 SandBase key、面向只读流程的结构化 JSON。 |
| 私密或仅账号可见的数据 | 都不适用于公开流程 | 这类数据不在本篇公开数据的范围内。 |
从知乎 API 能拿到什么
整个目录建立在一个 web 面上。按用途归类:
- 热榜与发现 —— 热榜、热门推荐,以及搜索联想。
- 搜索 —— 按关键词搜文章、问题、视频、专栏和用户。
- 问答 —— 问题详情、它的回答,以及回答详情。
- 文章与专栏 —— 专栏文章详情、某专栏的文章,以及评论。
- 用户 —— 按
user_url_token读公开资料、回答、文章和想法。
动手前请查每个端点的在线 API 参考确认参数;可用性因端点而异。
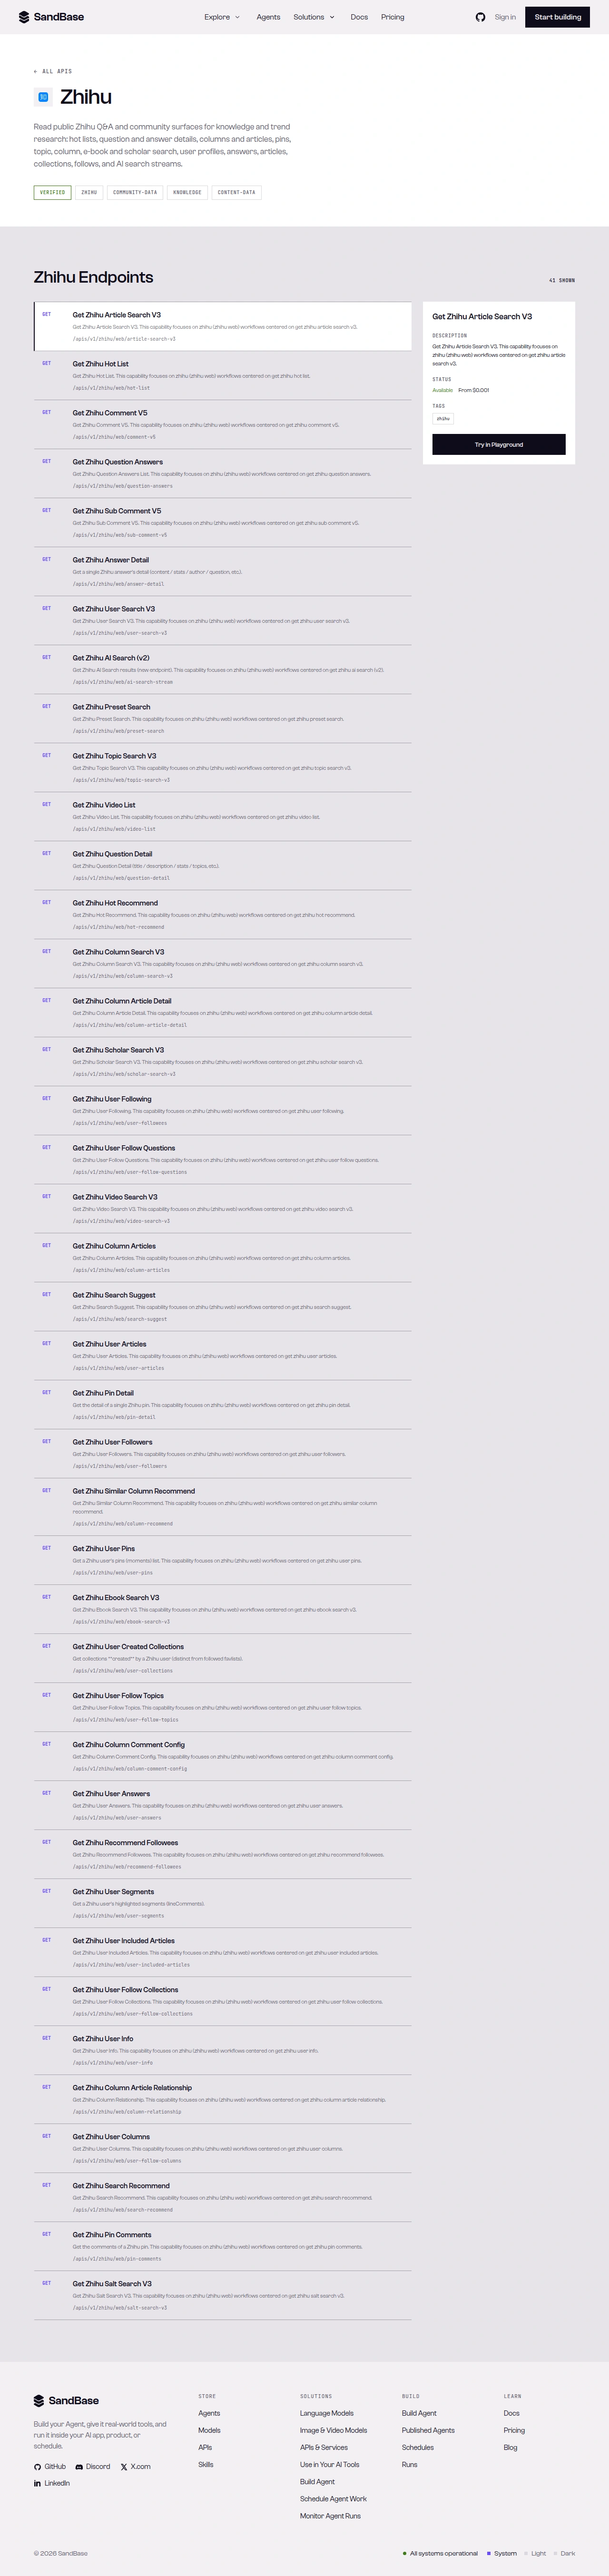 历史知乎目录。保留自旧总览,不是当前目录数量或新验证的业务请求。
知乎提供的 vs. SandBase 补上的
公开数据来自知乎,SandBase 不拥有或运营知乎。统一鉴权提供一致入口,但每个端点仍需分别核对输入、业务结构、可用性与预算。相同信封不会自动保证从热榜到专家资料的链路可靠。当前示例读取选定问题一次就停止。
快速上手:读取一个问题详情
本地配置 SANDBASE_API_KEY,传入数字问题 ID 字符串。使用 Model API POST 路径,不换成目录 GET 路由。下面的 cURL 有超时限制,只发一次请求;它只是打印响应,不校验业务成功。需要完整检查请用问答教程里的 Python。新项目可以把 SKILL.md、quickstart.md、已知 ID 和单个任务交给 Agent。
curl --fail-with-body --connect-timeout 10 --max-time 90 \
  -X POST https://api.sandbase.ai/v1/api/zhihu/web/question-detail \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"question_id":"37811449"}'
先检查 completed 状态,再要求 outputs[0].data 是对象。详情本身就是问题记录,参考有 id、title;教程的字符串 ID 匹配、标题非空属于本地完整性保护,允许 detail、excerpt 为空,并把缺失计数保留为未知。不另找嵌套 question,也不强加未记载的 provider 状态标志。
如果改选回答,传 question_id、limit: 5、offset: 0、order: "default",省略 cursor/session_id。业务 data 是卡片数组,只有 target_type: "answer" 的 target 才按回答提取,ad_info 是广告信息。不要把外壳直接当回答,也别把所有卡片数算成回答数。回答 target 结构错误应报错;合法空信息流与数组缺失需要区分。
旧热榜 Python 连同不安全的空输出回退,保存在历史归档。下面原 JSON 逐字保留,是历史热榜示意,不是新详情例子的输出,也不是本次执行过请求的证据:
{
  "id": "0437c98c-2fc0-4b23-9e40-c986f4512883",
  "status": "completed",
  "model": "zhihu/web/hot-list",
  "outputs": [
    {
      "data": {
        "data": [
          {
            "detail_text": "…",
            "target": { "title": "…", "answer_count": 560, "follower_count": 1701 }
          }
        ]
      }
    }
  ]
}
任何非 completed 状态都应停止,不回退成空数据。每次请求仍需分别检查端点业务结构。
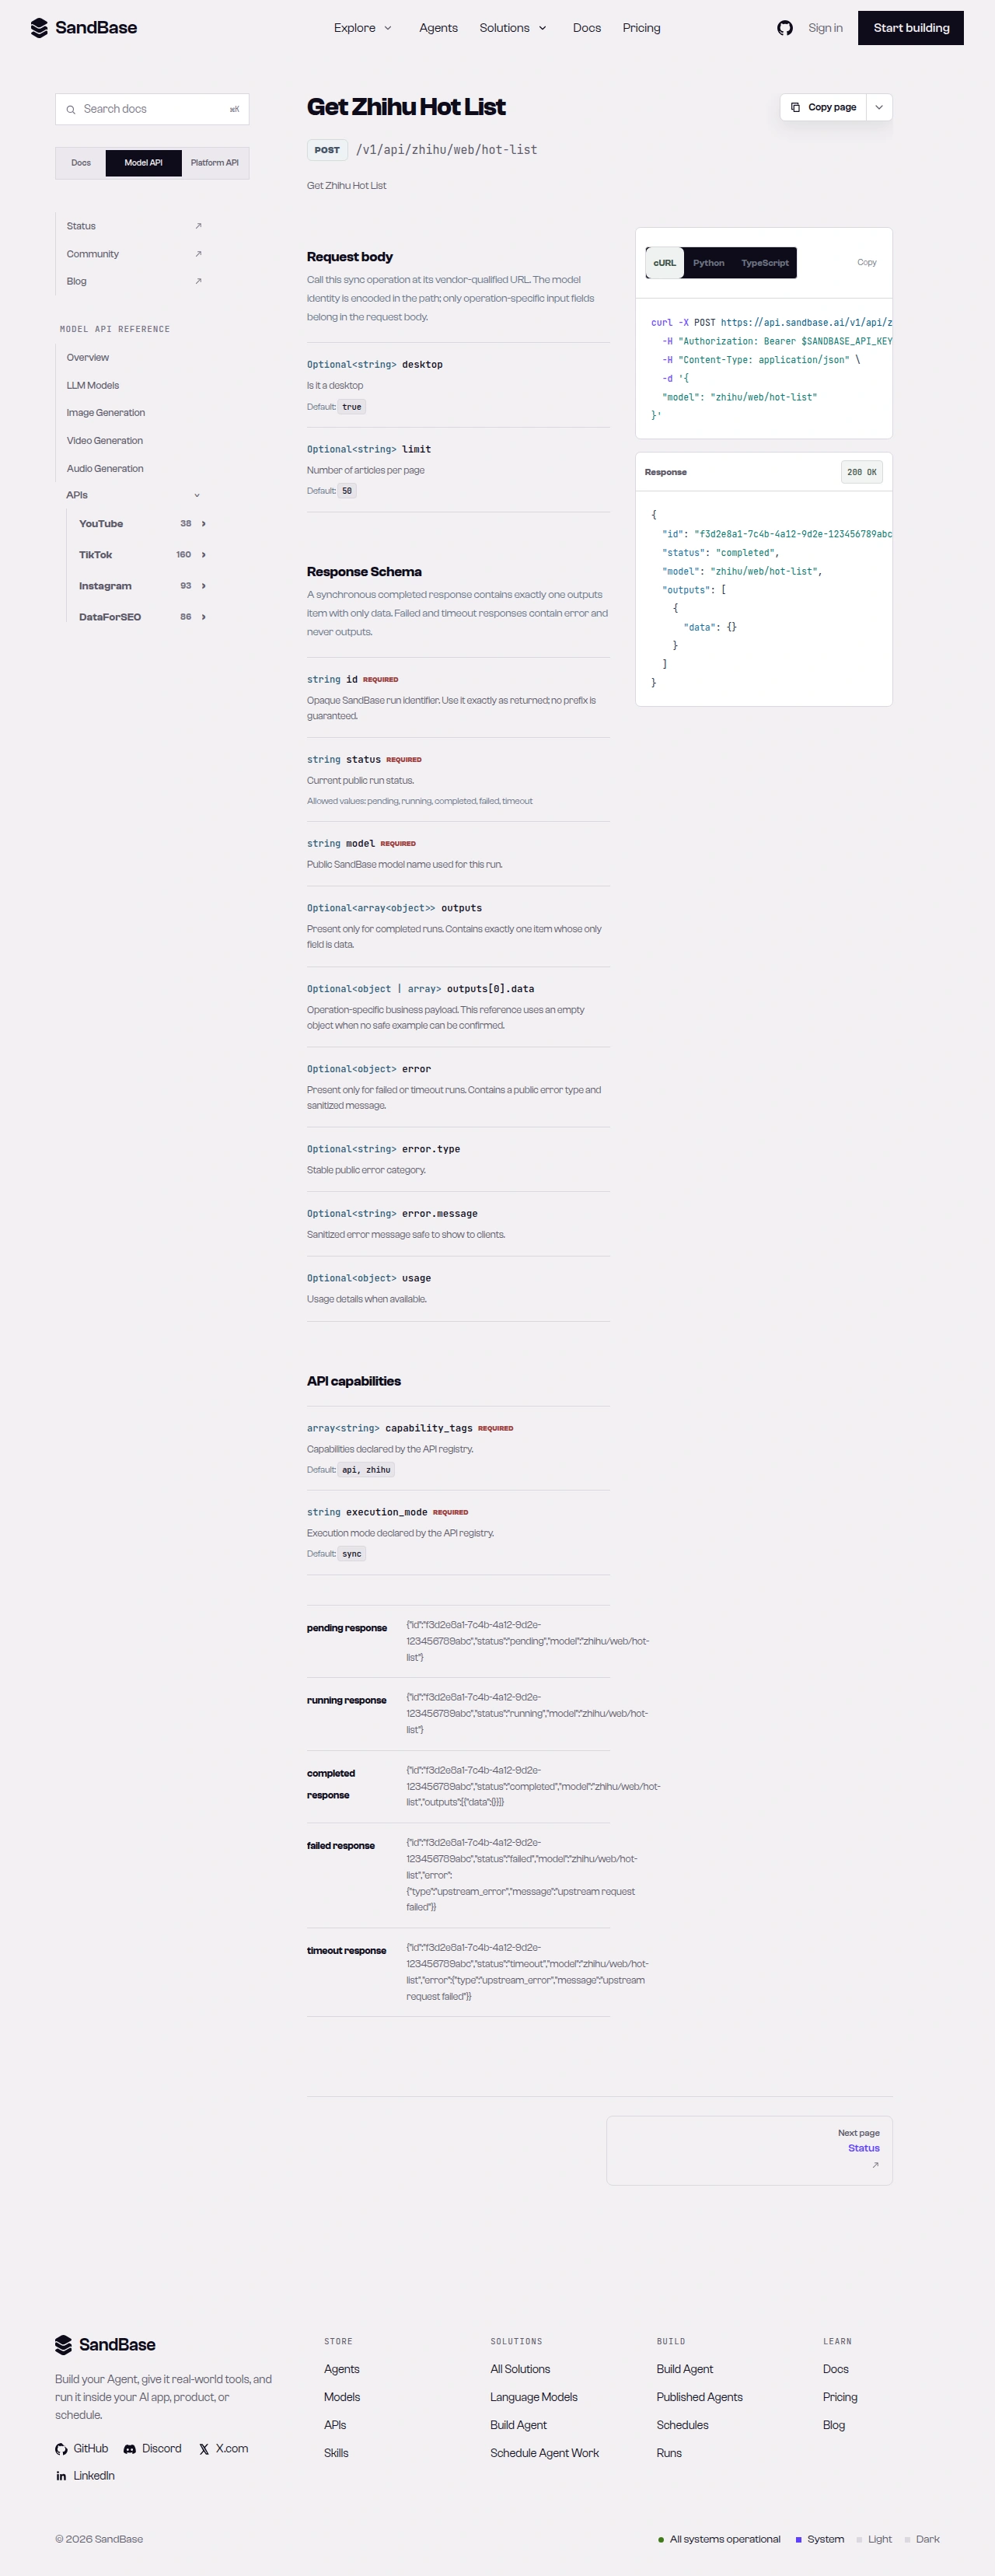 历史热榜参数参考。旧生成 cURL 包含 model 字段,不要复制进当前只传端点参数的请求;这不是新验证的业务调用。
能力地图
这是旧总览保留的历史导航,本轮只核对问题详情和问题回答契约,其他输入与业务执行未复验。
| 能力簇 | 代表端点 | 典型用途 |
|---|---|---|
| 热榜 | zhihu/web/hot-list | 热门问题监测 |
| 文章搜索 | zhihu/web/article-search-v3 | 关键词内容发现 |
| 问题详情 | zhihu/web/question-detail | 按 question_id 读问题 |
| 问题回答 | zhihu/web/question-answers | 拉取某问题下的回答 |
| 用户资料 | zhihu/web/user-info | 按 user_url_token 的公开专家信号 |
分页因端点而异。当前回答参考的 cursor、session_id 来自响应,仅增加 offset 不是完整续页方法;本轮不执行下一页。
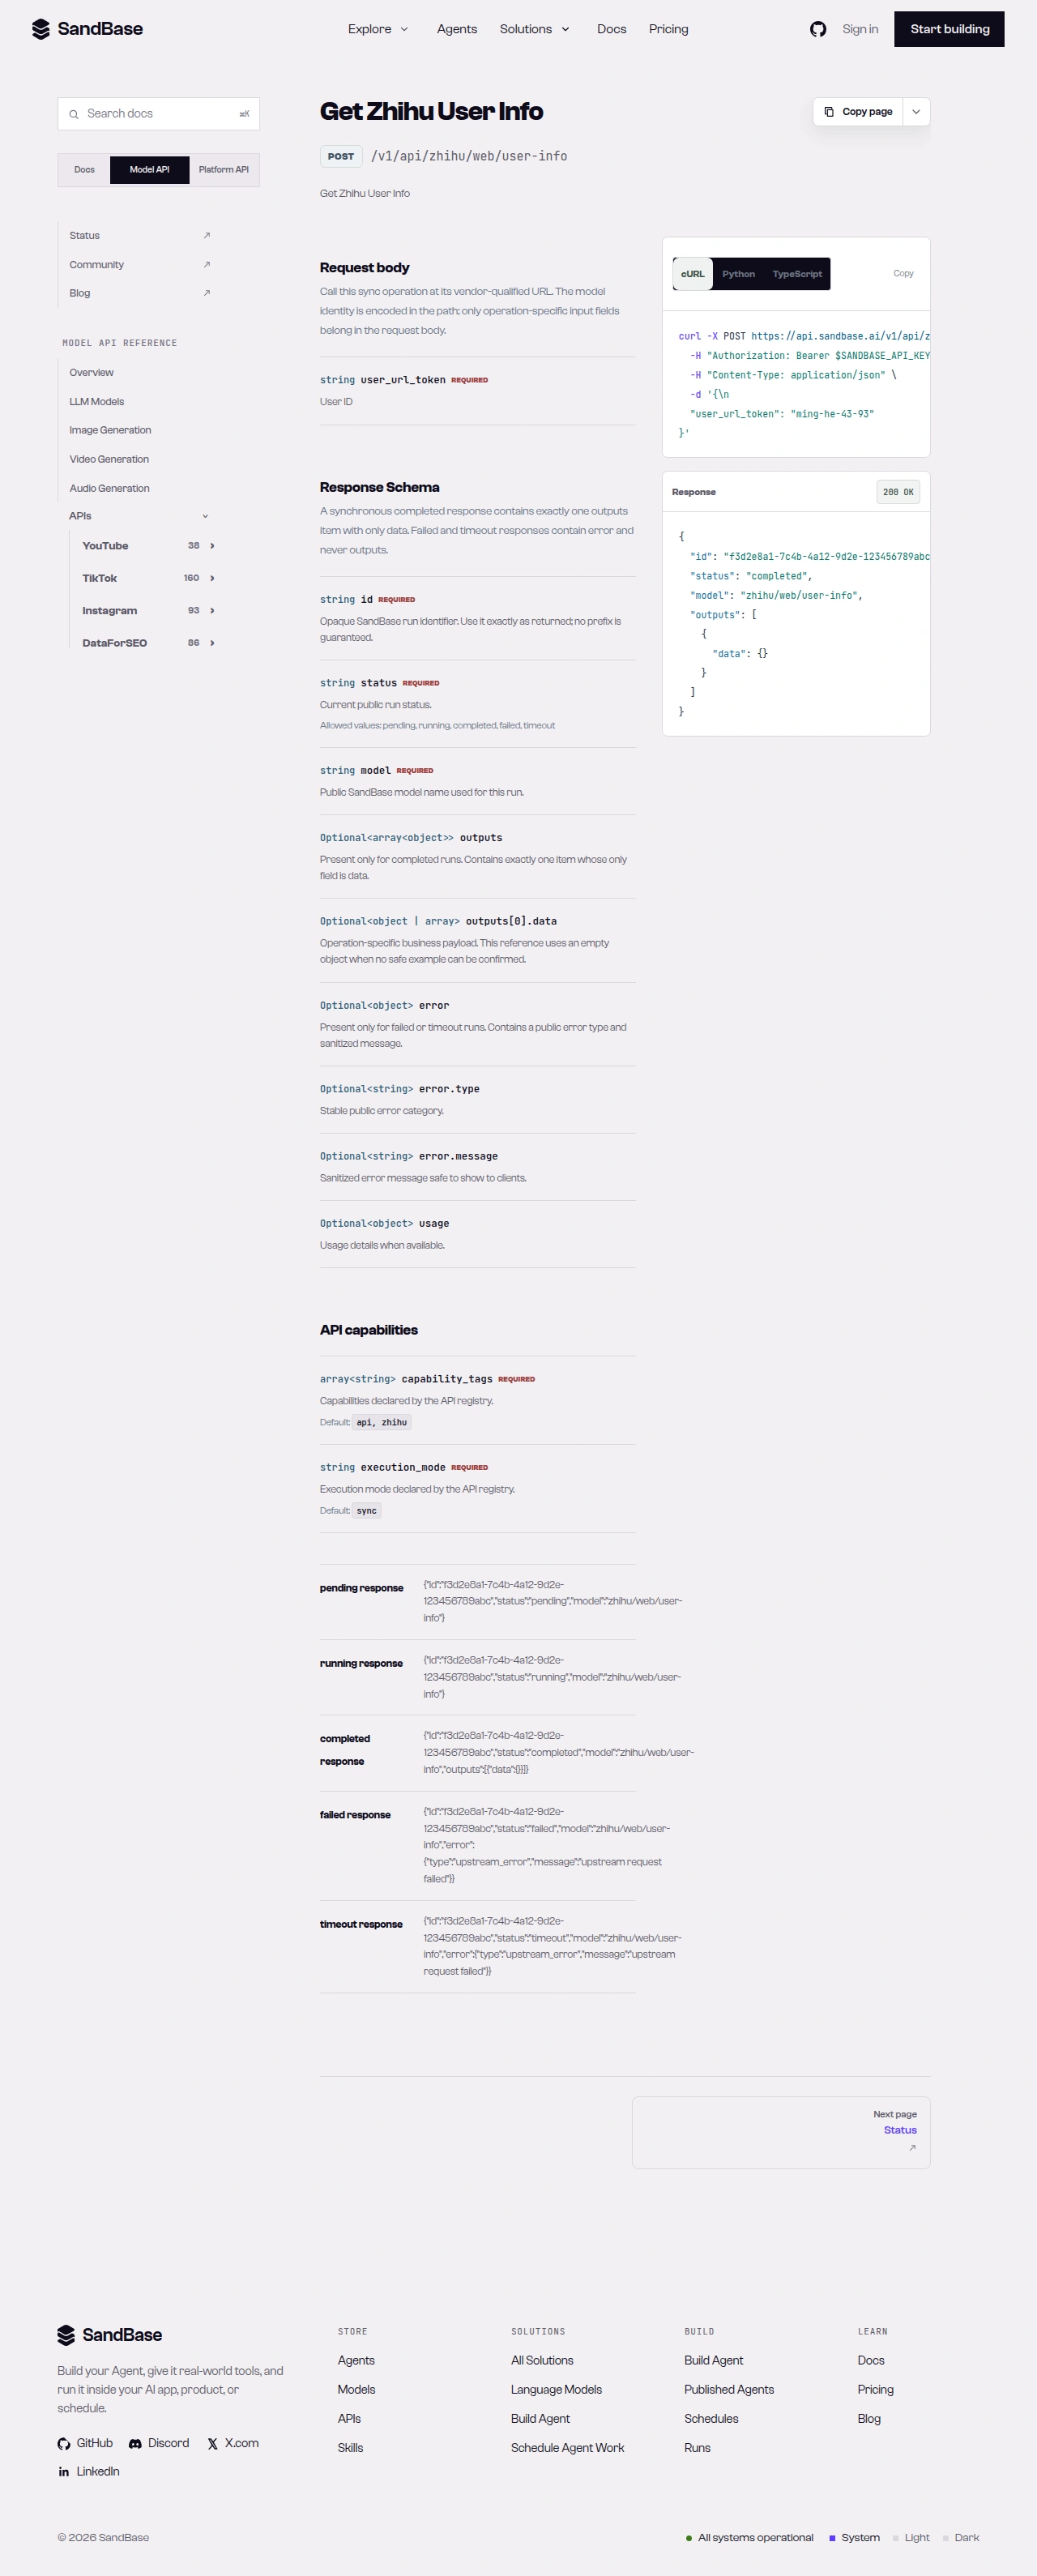 历史 user-info 参数参考。保留自旧总览,不是当前目录数量或新验证的业务请求。
增加下一次调用之前
从问题到回答再到作者是一种可能的研究设计,不是本轮执行结果。每加一步都先检查选定端点,分别核对标识、业务结构、状态、费用和可用性;不能整条流程只判断一次 status。
回答续页当前关联到响应游标、session.id 和 paging.is_end。旧教程“只加 offset、不读响应”的建议已纠正。本轮没有测试下一页,所以不要照抄截短参考 URL 或 token;先保留原载荷,并核对真实未截短的续页状态,再决定是否写循环。
常见用例
用知乎热榜 API 做趋势监测
按计划定时轮询 zhihu/web/hot-list 追踪热门问题——每一项带一个问题标题和一个热度数字。输入:无。输出:排名的热门问题列表。端点:hot-list。已知问题首请求与旧热榜流程的边界见如何挖掘知乎问答。
用知乎搜索 API 做内容发现
用一个关键词调 zhihu/web/article-search-v3,围绕某话题摸清文章。输入:关键词。输出:匹配文章。端点:article-search-v3。
用知乎资料 API 做专家发现
用 zhihu/web/user-info 读取公开资料,拿到像昵称、粉丝数和回答数这样的字段。输入:user_url_token。输出:结构化的资料记录。端点:user-info。完整工作流看如何做知乎专家发现。
首份响应能告诉你什么
详情可确认返回的问题身份、题目和可用元数据;首屏信息流可展示卡片、回答 target 的结构。两者都不能证明讨论已收完整、谁是最好的专家或样本观点为真。作者徽章、粉丝数是元数据,不是自动排名依据。
保存问题 ID 和观察时间,区分问题级总数与实际提取的回答数量。空摘要、缺失计数和明确数字零各有含义,不凭空补文本或热度。如果后续只总结一个小样本,就标清样本范围,不宣称全部回答或整个社区都同意。载荷里的媒体、跟踪 URL 也不是让 Agent 自动访问或下载的指令。
边界与限制
- 只读、公开数据。 不能发帖、关注,也拿不到私密/仅账号可见的数据。
- 速率与量级。 出错先停,确认原因与预算后再决定是否重发;当前首请求不自动重试。
- 参数与结构随上游而定。 标识各异(
question_id/answer_id/article_id、user_url_token、keyword);列表载荷常嵌在一个data数组下;分页是各端点自己的请求参数。先看真实响应、读 schema。 - 对照在线参考确认端点。 可用性和字段可能变化;在依赖某个具体端点之前先确认。
- 这不是知乎官方合作。 SandBase 只是提供对公开数据的统一访问;请遵守知乎的条款以及你使用场景下适用的规则。
常见问题
我需要知乎开发者应用或登录吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权。这些读取端点不需要知乎账号或你这边的 OAuth。
用什么来标识问题、回答或用户?
用自然标识:内容用 question_id、answer_id 或 article_id,人用 user_url_token。搜索用 keyword。
分页怎么做? 当前回答参考的续页涉及响应中的游标、会话状态和结束标志。此例只读首屏,不验证仅增加 offset 或任何下一页流程。
能读私密或仅账号可见的数据吗? 不能。这个 API 只返回公开数据。私密和账号授权的内容都不在范围内。
从已知问题开始
配置或复用 Key,选问题详情或首屏回答,校验结果后再扩大范围。准备好后:
觉得有用?分享给更多人