Inkling 2 Small 权重开放:许可证、显存门槛与 API 选择
Inkling 2 Small 已开放 Apache 2.0 权重。分清 17B 激活参数与 500GB 显存门槛、模型上下文与 Tinker 服务限制,选择部署或 API。
看到 Inkling 2 Small,最容易产生的误解是“只有 17B,普通机器也能跑”。官方资料实际写的是 594B 总参数、17B 激活参数,NVFP4 权重的部署起点为至少 500GB 聚合 GPU 显存。此次值得关注的是可下载权重与定制空间,而不是突然出现了一个笔记本级编程模型。
Thinking Machines 在 11 月 5 日发布模型,并于 11 月 12 日更新公告,确认权重开放。本文按 2026 年 11 月 13 日的资料讨论部署与 API 选择,没有本地安装或性能实测。
先说结论
- 官方 Inkling 2 Small 权重已经开放,仓库标注 Apache 2.0。
- 原厂规格为 594B 总参数、17B 激活,接受文本和图片,输出文本。
- NVFP4、MXFP8 的官方起步显存要求分别为 500GB、800GB。
- 模型的 1M 上下文不等于所有 API 都开放 1M;Tinker serverless 当前表格列的是 256K。
- 11 月 13 日 SandBase 目录检索未找到准确 Inkling 条目。
开放权重改变了什么
官方 Hugging Face 模型卡已经提供可以用于评估自建部署的权重与许可证信息。这与“将来会开放”是两个阶段,也正是本次应当更新报道的地方。
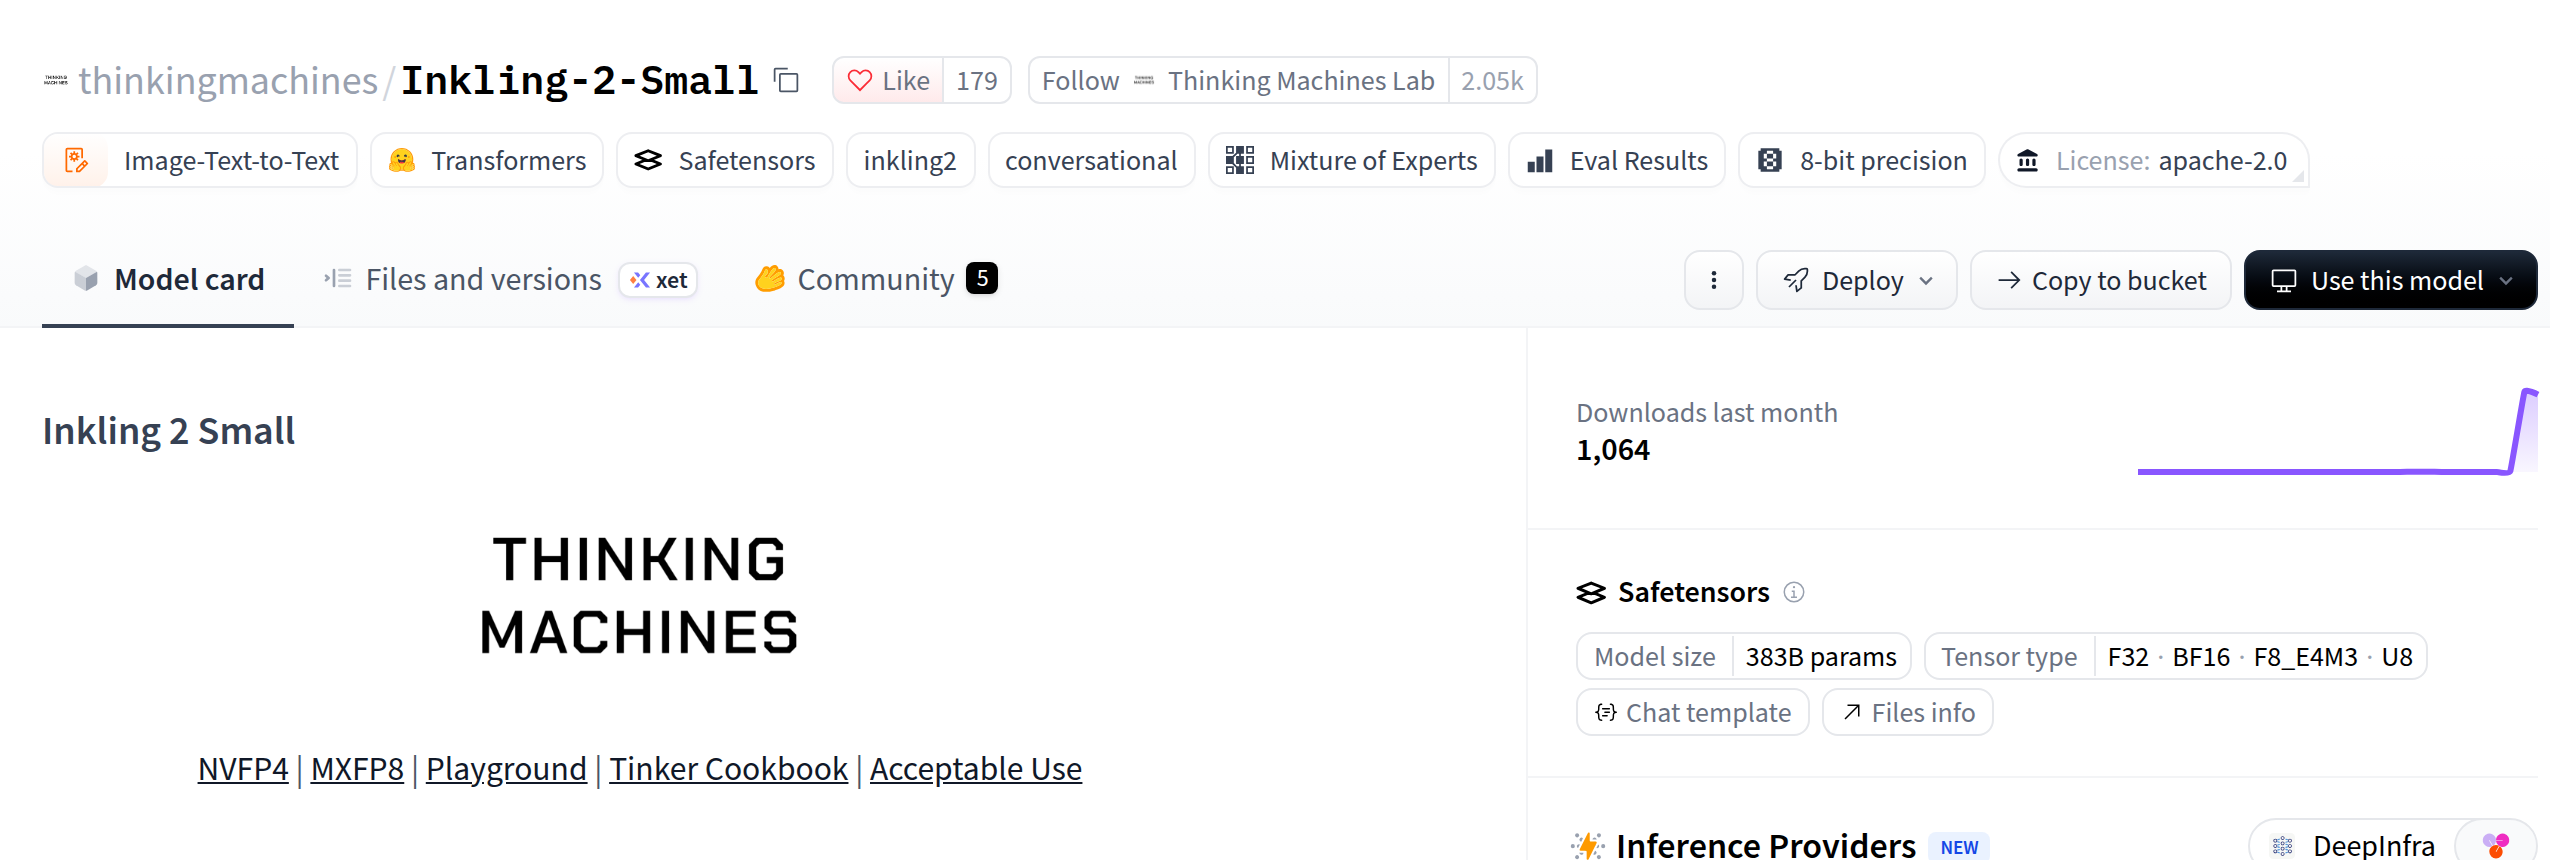 11 月 13 日截取的原厂仓库。参数、许可证和权重格式以原始模型卡为准。
权重可下载,让团队能够控制服务栈、研究运行时行为,并评估自己的后训练方案。它没有消除运维:算力采购、运行时版本、失败监控、容量限制和应用边界,仍然需要有人负责。
仓库采用 Apache 2.0,不意味着每家托管服务都免费,也不意味着其服务协议完全相同。使用权重时查看许可证;使用某家 API 时,还要查看该服务的条款和费用。不要把开源许可证当成通用的托管承诺。
激活参数不是显存预算
MoE 每个 token 只激活部分参数,不能由此推导出其余权重不需要存在于服务系统中。完整模型与运行时仍要放进集群,实际请求还会占用额外资源。
| 官方权重格式 | 聚合 GPU 显存起点 | 模型卡给出的配置示例 |
|---|---|---|
| NVFP4 | 500GB | 2 张 B300 或 4 张 H200 |
| MXFP8 | 800GB | 4 张 B300 或 8 张 H200 |
这些是原厂起步配置,不是指定并发量下的吞吐保证。输入长度、KV cache、批处理方式、运行时实现和卡间连接,都会影响还能承载多少用户请求。不能只根据“17B 激活”去采购机器。
官方列出的本地推理选项包括 vLLM、SGLang、TokenSpeed 和 Unsloth。应按权重格式、硬件和对应版本阅读链接中的具体部署方法。模型目录里通用的“一行启动命令”不是完整安装说明,更不能证明任意已有版本都支持当前权重。
部署前先定义目标:同时服务多少请求、典型输入多长、最多等待多久、资源耗尽时怎样处理。权重加载成功只是第一关;能否在预期负载下稳定处理任务,需要另外验证。
发布日期和权重日期要分开
Thinking Machines 官方公告最初介绍 Tinker 访问,并说明计划在外部测试后开放权重。11 月 12 日更新确认这一步已经完成。因此,继续引用最初的“下周开放”而忽略更新,会把当前状态写错。
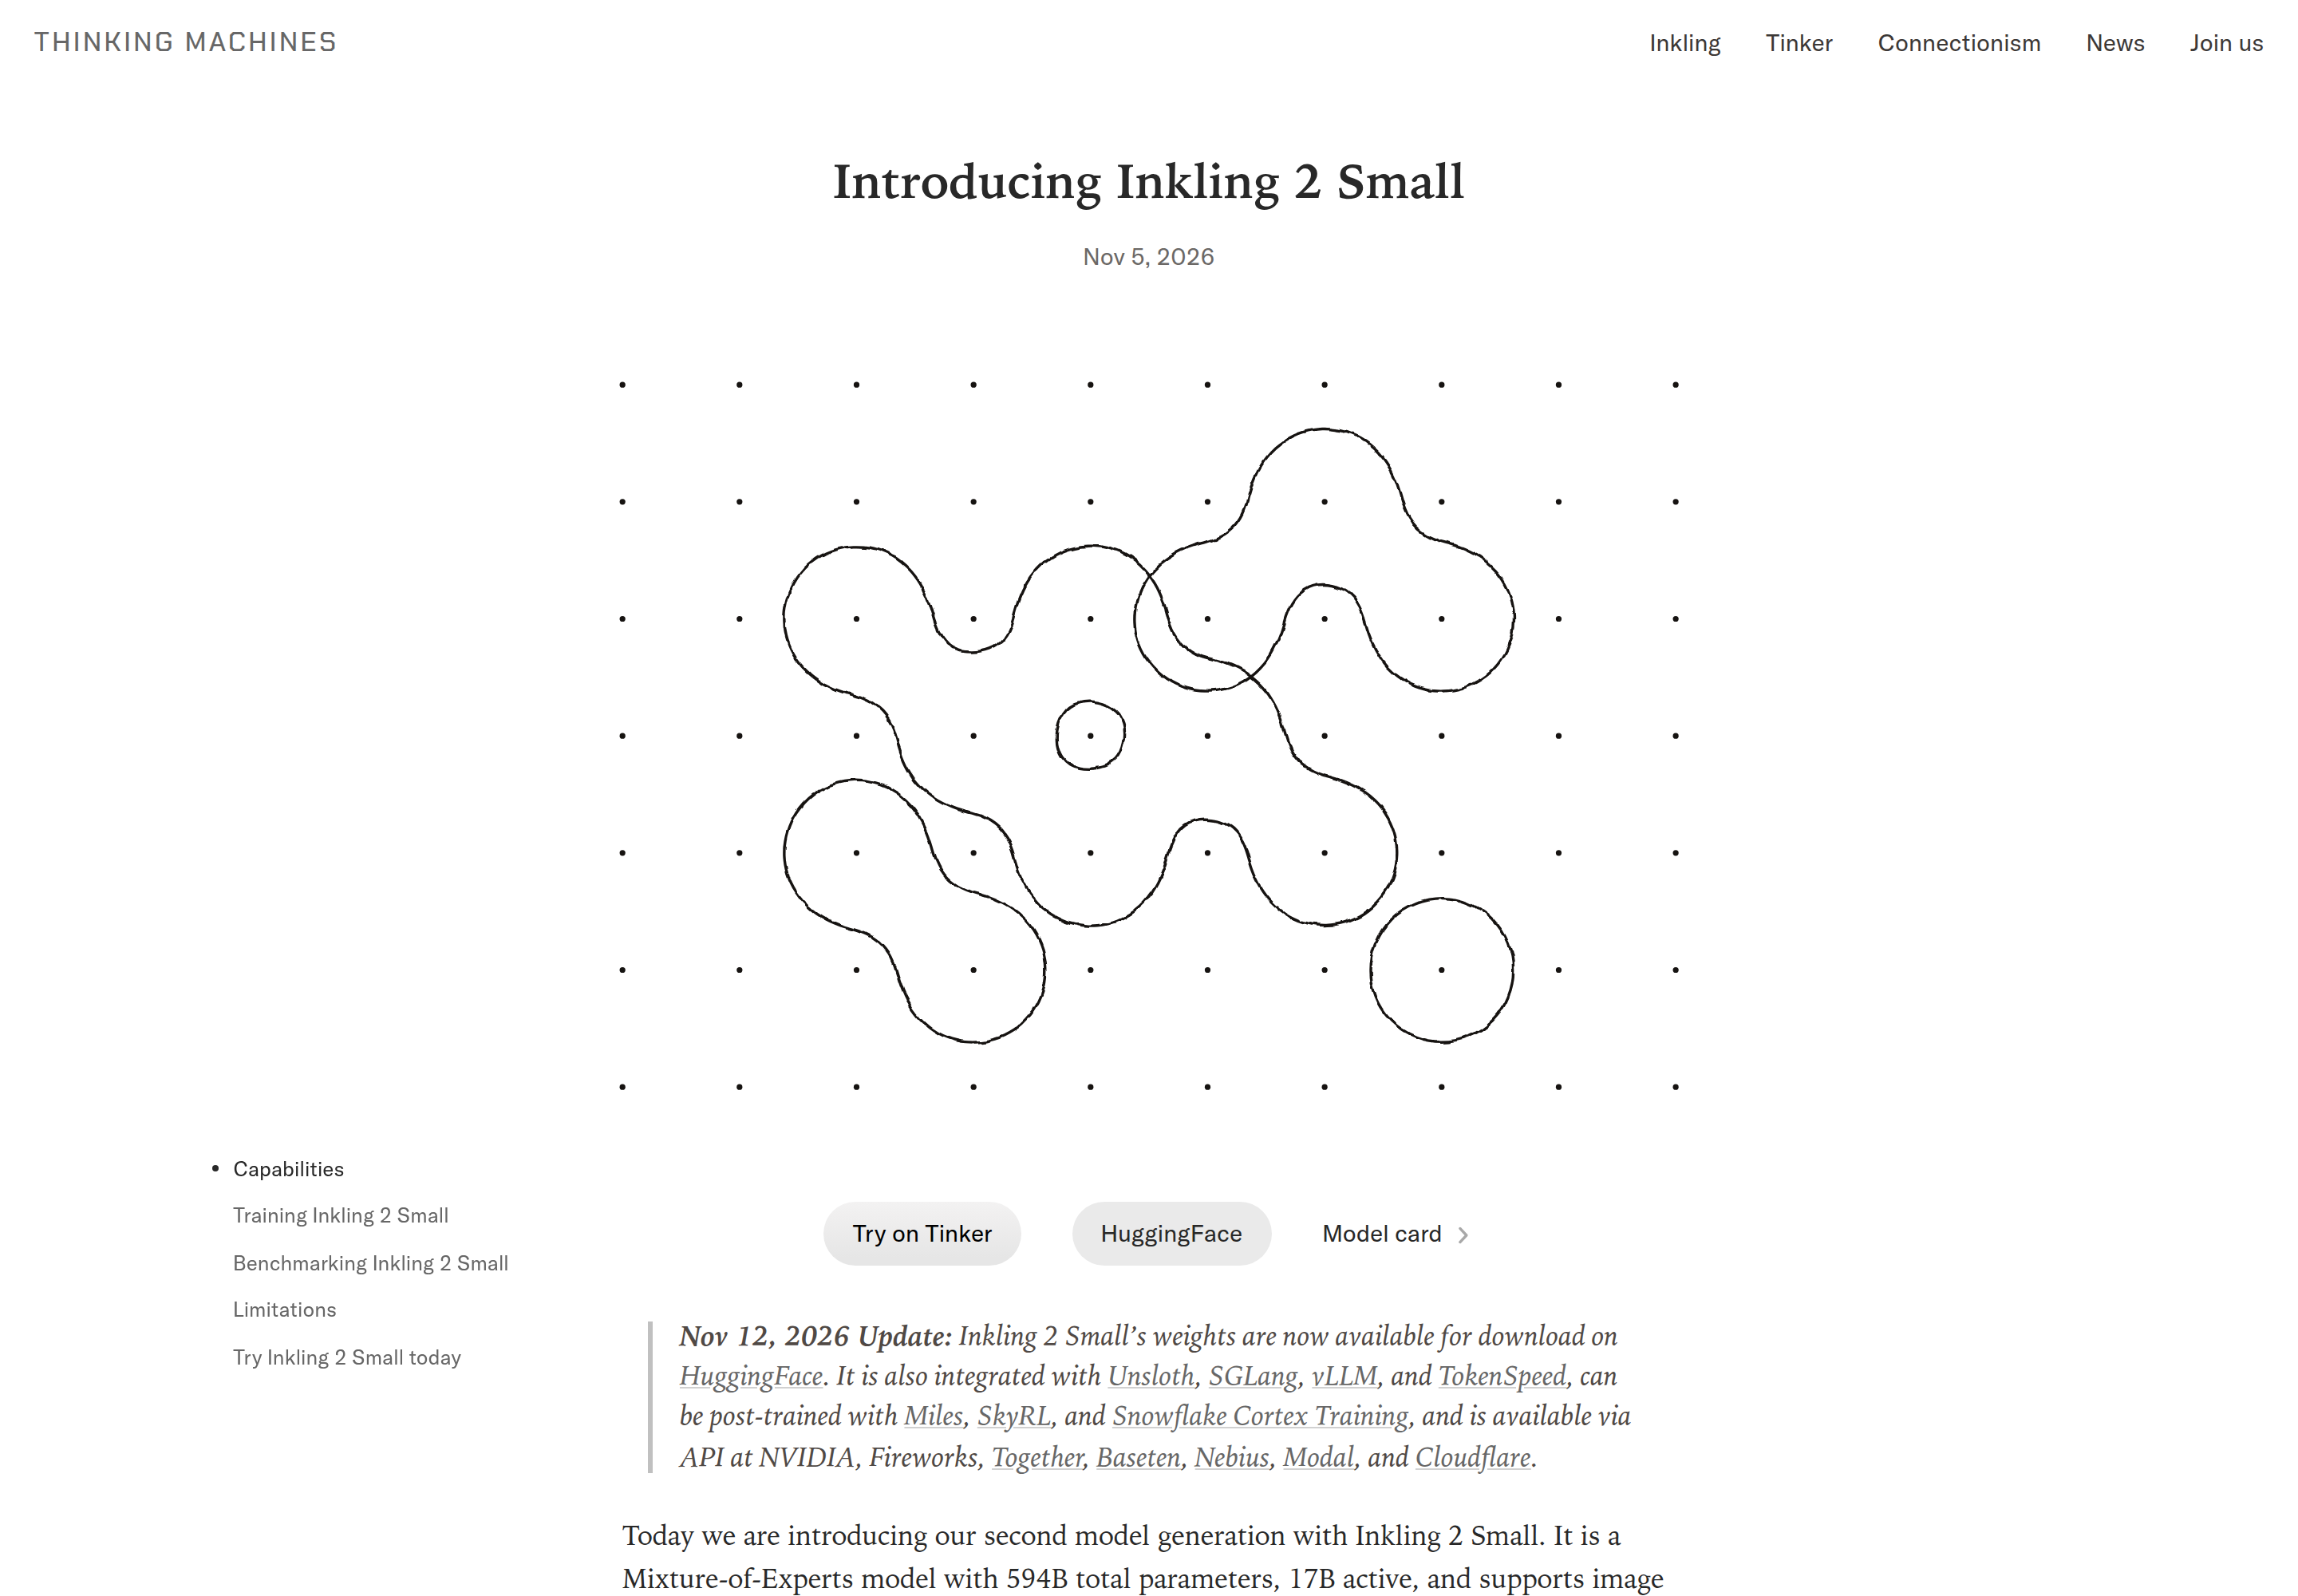 11 月 13 日截取的官方公告。首次发布和后续权重开放是不同的时间节点。
公告也列出局限:表达可能偏长,工具或技能很多时可能选得不够好,并不支持音频输入。这些比单纯的亮点列表更能帮助设计评估。如果应用有很大的工具菜单,就应专门检查工具选择,不能用一个编程分数替代这项验证。
视觉编程则应同时检查代码和最终渲染结果:模型是否正确使用截图证据,修正时是否动了无关部分,达到要求后是否停止。这里列的是建议测试项目,不是本文已经观察到的 Inkling 表现。
模型窗口与服务窗口不是一回事
基础模型卡写的是最高 1M 上下文;但 Tinker 定价页在 11 月 13 日核查时,Inkling 2 Small 的 serverless 行列出 256K 上下文,并注明该推理服务仍有 beta 访问条件。不能把模型上限直接复制成 Tinker 服务规格。
| 路径 | 要核对的内容 |
|---|---|
| 自建权重 | 显存、运行时、上下文配置、并发 |
| Tinker serverless | 当前窗口、访问条件、推理费率 |
| 其他托管商 | 自有 model ID、限制、缓存价和条款 |
| SandBase | 准确目录条目与调用文档 |
例如,Cloudflare 的 Inkling 文档描述了自己的托管路径,ID 为 @cf/thinkingmachines/inkling-2-small,要求付费访问。这不是 Tinker 请求,也不是 SandBase 请求。
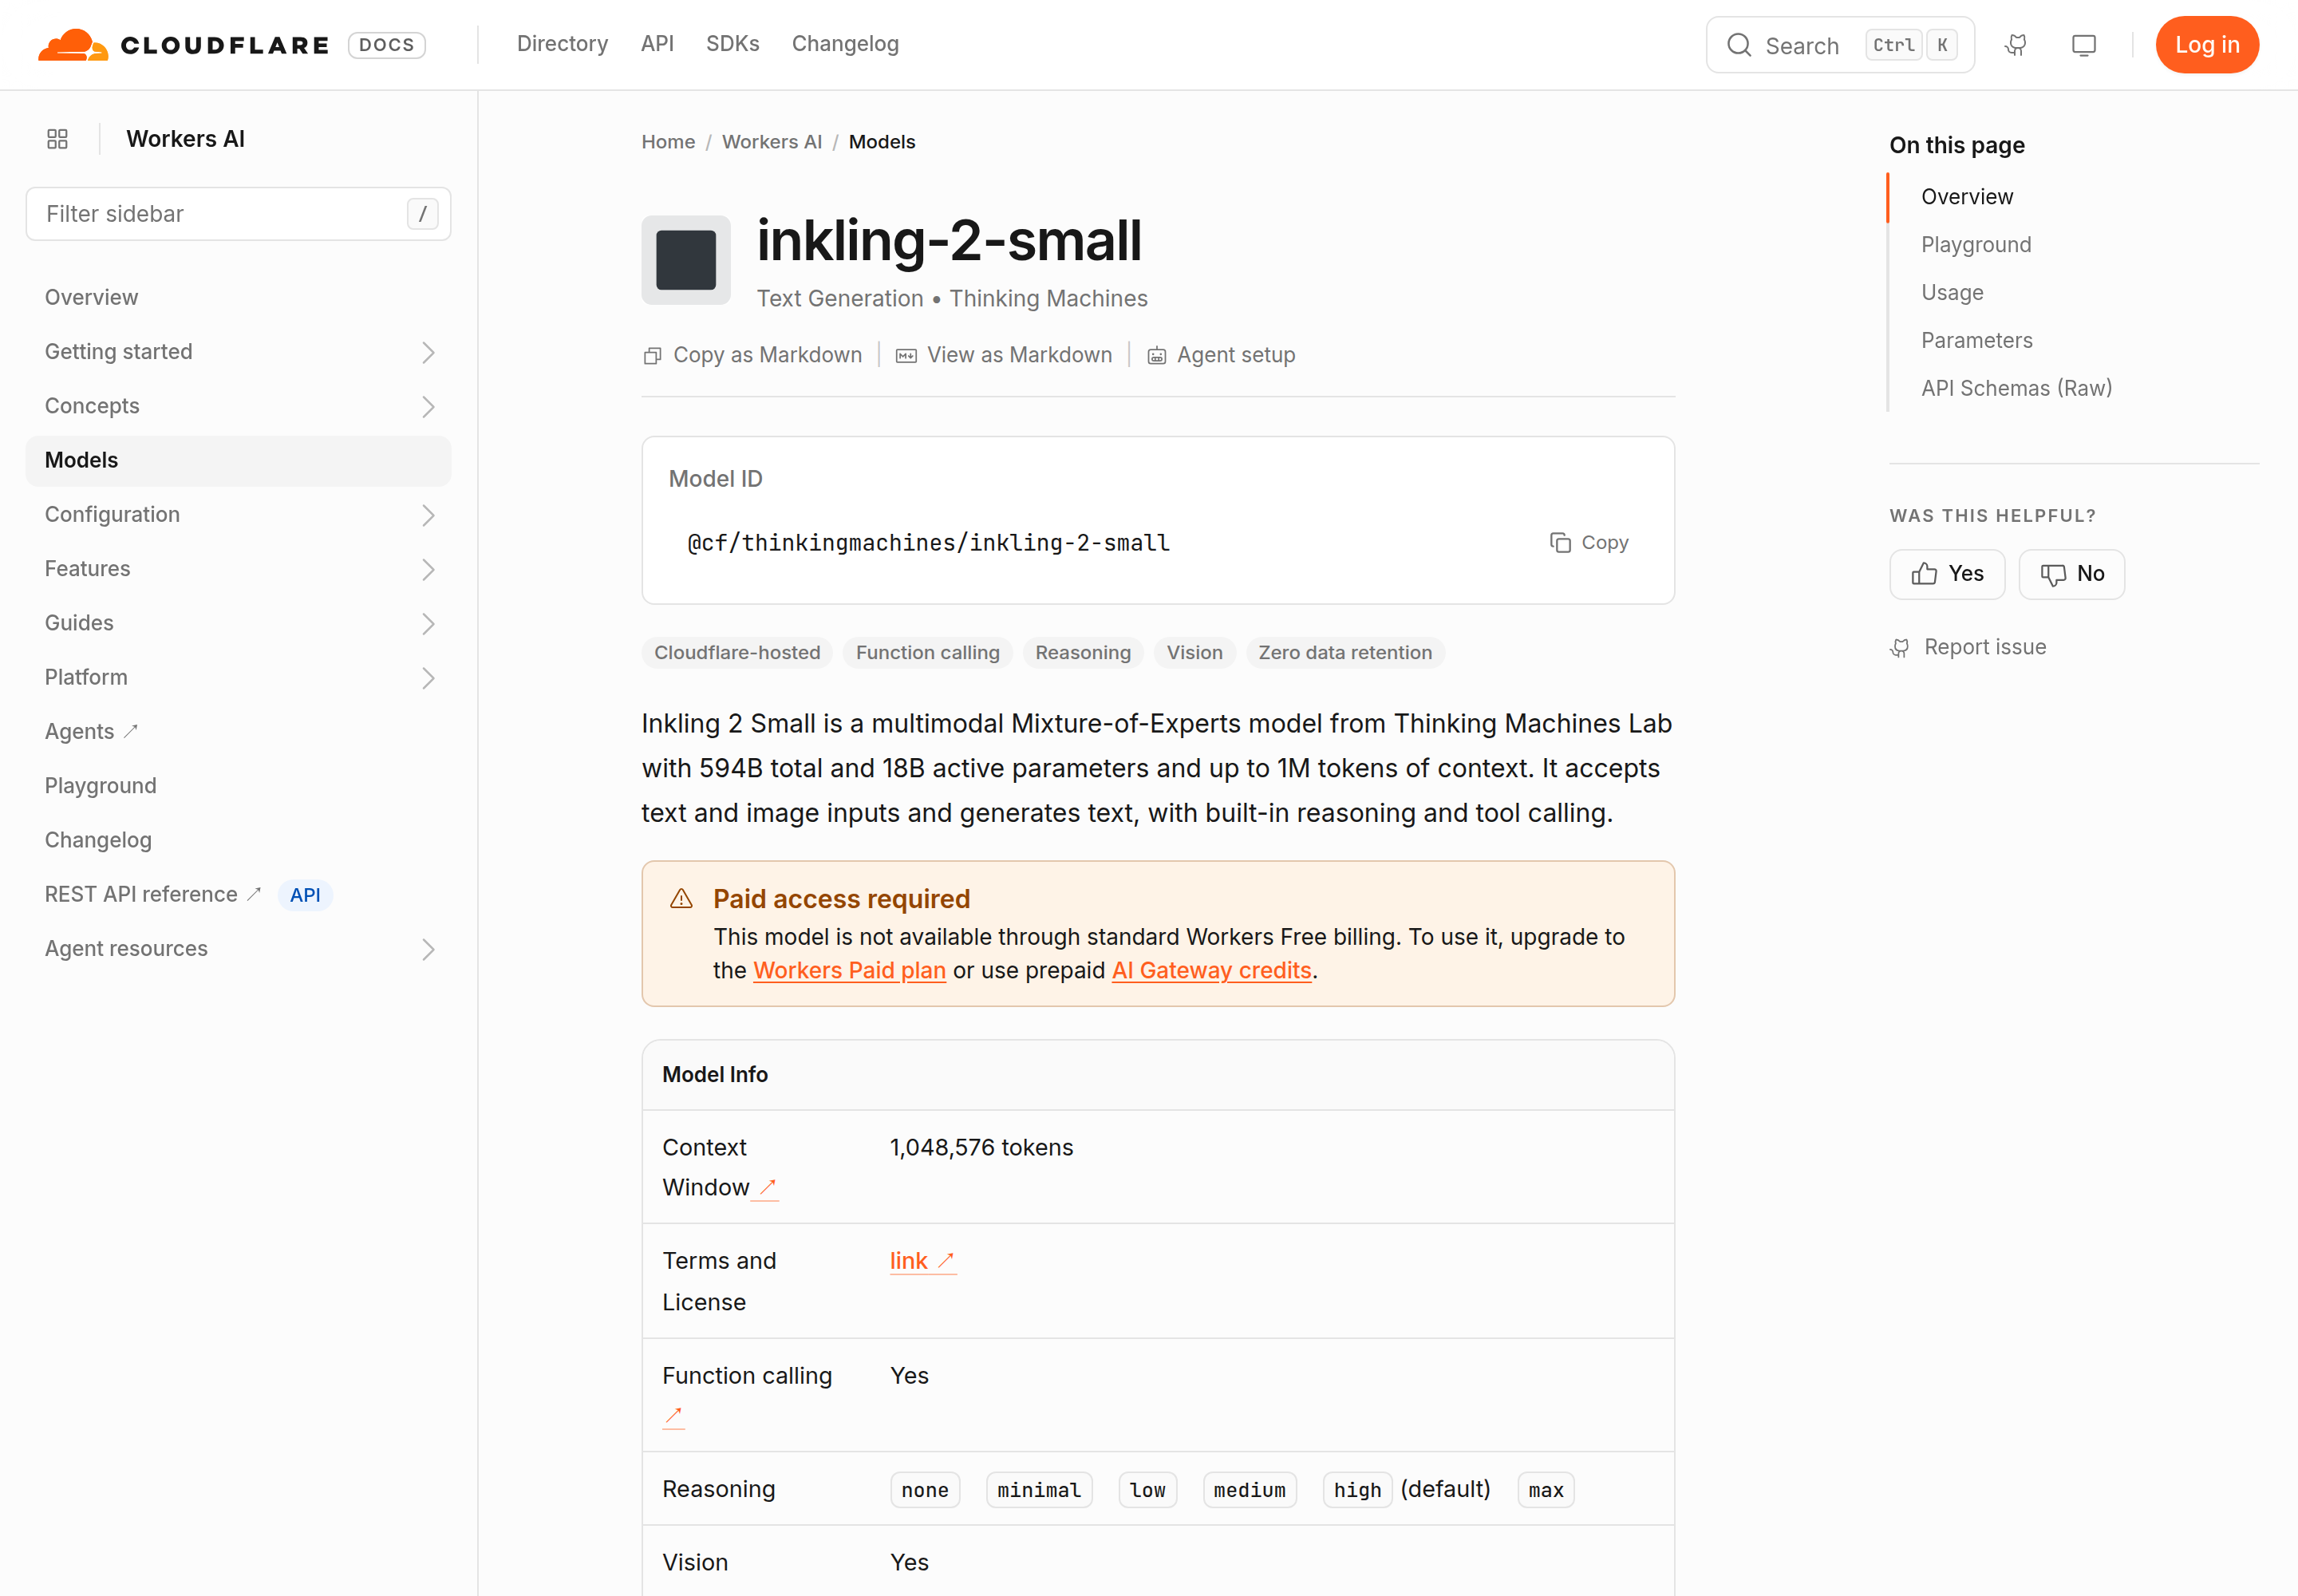 11 月 13 日的 Cloudflare 页面,仅说明它自己的服务。第三方元数据存在差异时,本文采用原厂的 17B 激活参数。
这一区分很重要:不能拿 A 平台最低价格、B 平台最大窗口和 C 平台示例代码,拼成一个实际上不存在的服务方案。
API 评估成本怎么估
Tinker serverless 表格列出的每百万 token 价格为:输入 0.30 美元、缓存输入 0.03 美元、输出 1 美元。假设一次没有缓存命中的请求消耗 10,000 输入与 2,000 输出 token:
10,000 ÷ 1,000,000 × 0.30 + 2,000 ÷ 1,000,000 × 1.00 = 0.005 美元
这是推理费算例,不是修复一个问题的实测成本,也不包括训练、重试、工具和本地基础设施。训练计费与推理计费分开,权重可以下载并不意味着后训练没有费用。
如果比较自建和托管,先算利用率。一个整月预留、每天只忙几小时的集群,与持续处理稳定队列的集群,每个合格任务的成本会明显不同。把维护人员投入、故障恢复和空闲资源加入后,再判断哪条路更合适。
团队应该选哪条路
如果首先想知道模型能否完成业务任务,优先通过文档清楚的托管服务评估。这样可以把任务质量与硬件配置问题分开。注意托管窗口是否覆盖输入,不要因为某家限制较小,就推断基础模型没有更大的能力边界。
如果自有控制、定制需求或稳定利用率足以支撑运维,再考虑部署权重。固定 checkpoint revision、运行时方案和资源限制,保留小型回归任务集。一次同时换权重和服务实现,出了问题很难定位原因。
如果现实约束就是一台工作站,或者没有明确的定制收益,继续使用现有模型也是合理决定。可以查看 SandBase 上的 GLM-5.3-Flash作为另一条已列出的候选路线,但它不是 Inkling 的别名。另一个近期选型问题可参考 Qwen4 预览接入指南,其生命周期约束完全不同。
把训练和服务实验拆开
如果要利用定制能力,先保留未经修改的基线,并把验收样例与训练集分开。训练后用相同运行时和配置比较,记录 checkpoint 与渲染器版本;不要同时改提示词、权重和部署方式,再把所有改善归给后训练。
训练、采样和最终推理分别记账。目标可以先收窄到自己的文档抽取格式,同时检查资料不足时是否仍会明确放弃回答。这里是实验建议,不是本文已经完成的微调结果。
常见问题
权重现在真的能下载了吗?
可以。官方仓库已经提供权重,发布公告也记录了 11 月 12 日的开放更新。
只有 17B 激活,能否用普通笔记本运行?
官方部署要求不支持这个推论。NVFP4 的建议起点是至少 500GB 聚合 GPU 显存。
所有 API 都支持百万上下文吗?
不是。基础模型容量与供应商提供的服务窗口不同,Tinker 当前 serverless 表格列为 256K。
能听音频吗?
官方说明不支持音频输入。模型卡给出的输入是文本与图片,输出为文本。
建议先通过明确的托管路径验证任务价值,再决定拥有整套服务基础设施是否值得。
觉得有用?分享给更多人