开发者工具
代码 Agent 跑久了为什么会忘记目标
代码 Agent 忘记目标、重复失败修复怎么办?用任务状态记录、回归测试和重启提示找回原始要求,区分缓存与记忆,避免把测试变绿当成任务完成。
阅读关于 AI 智能体、模型路由以及构建生产级 AI 系统的洞察。
代码 Agent 忘记目标、重复失败修复怎么办?用任务状态记录、回归测试和重启提示找回原始要求,区分缓存与记忆,避免把测试变绿当成任务完成。
阅读
拆解 Fable 5.1 与 Mythos 5.1 的三项科研案例:金星地形重建、蛋白质候选实验验证、GPU Kernel 加速,分别核对输入、结果、样本与适用限制。
阅读
Claude 将费马大定理的已有证明写成了 Lean 可检查的代码。这项研究验证了什么?如何用一道小定理测试模型,并识别偷换命题与未完成证明?
阅读
旧模型帮助训练 GPT-6 Astra,是否等于递归自我改进?区分已披露事实与研究者判断,用训练数据过滤的示例说明还需要哪些实验记录,才能证明下一代模型确实变好。
阅读
MazeBench 14% 的纪录,与 Fusion 360 建模、频谱识别、分子演示和 48 关游戏放在一起看:GPT-6 Astra 已能做什么,哪些结论还不能下。
阅读
GPT-6 Astra 的 Plus 额度为什么消耗这么快?结合官方使用限制、创作者案例与三次游戏生成账单,分析订阅额度、Fast 模式和 API 实际费用。
阅读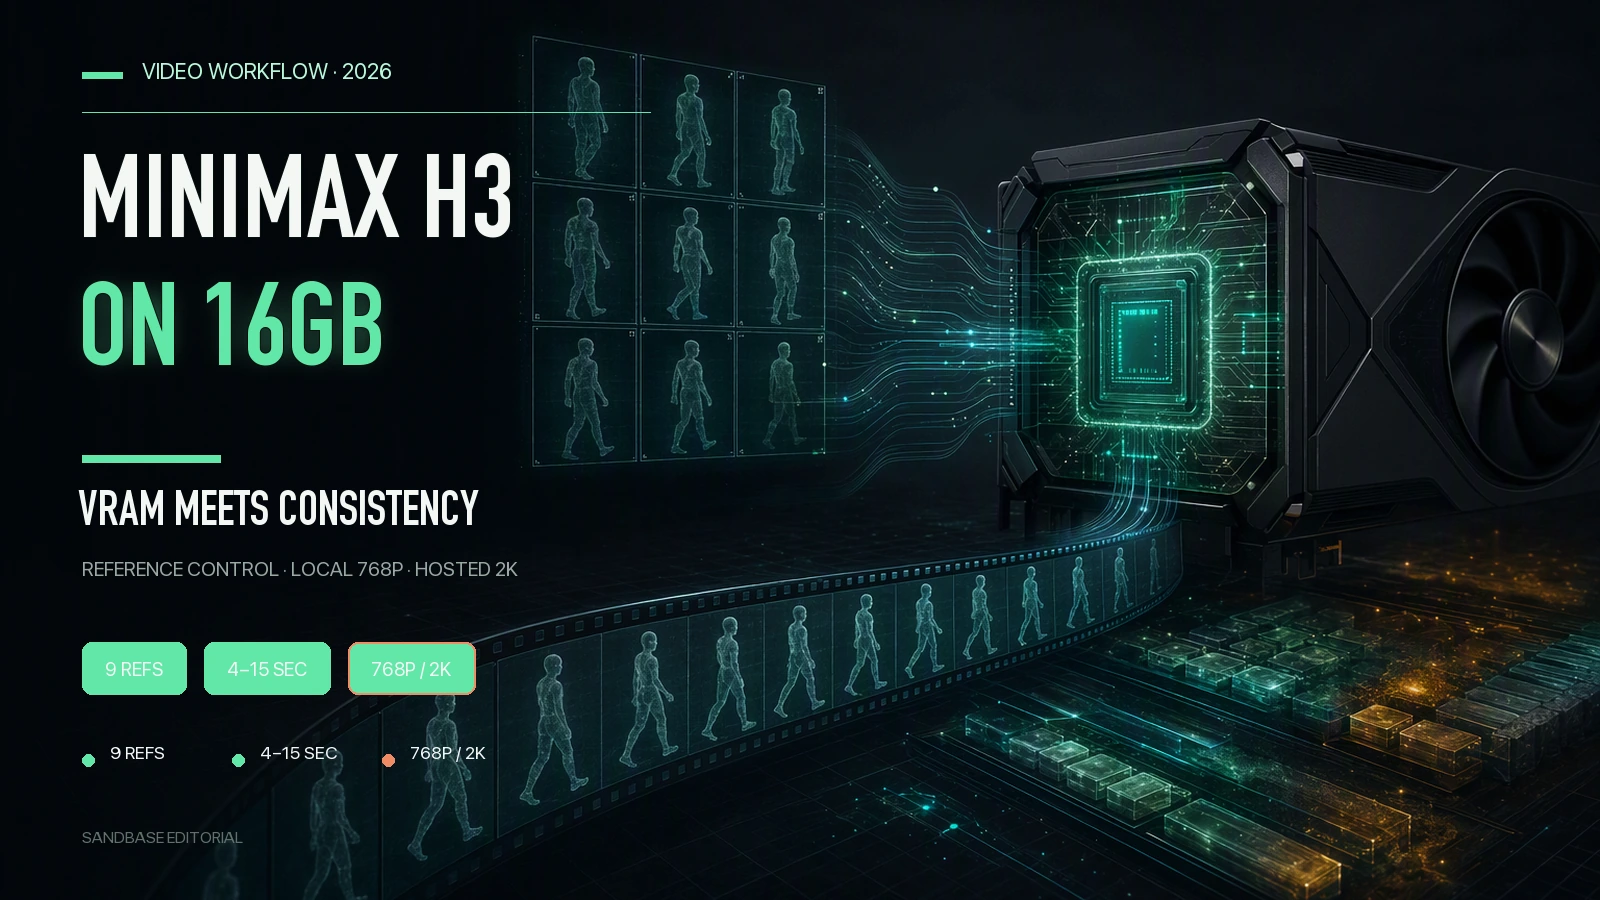
MiniMax H3 能否在 16GB 显存上运行?核对权重与 offload 要求、4–15 秒时长限制,以及本地 768p 和托管 2K 的区别。
阅读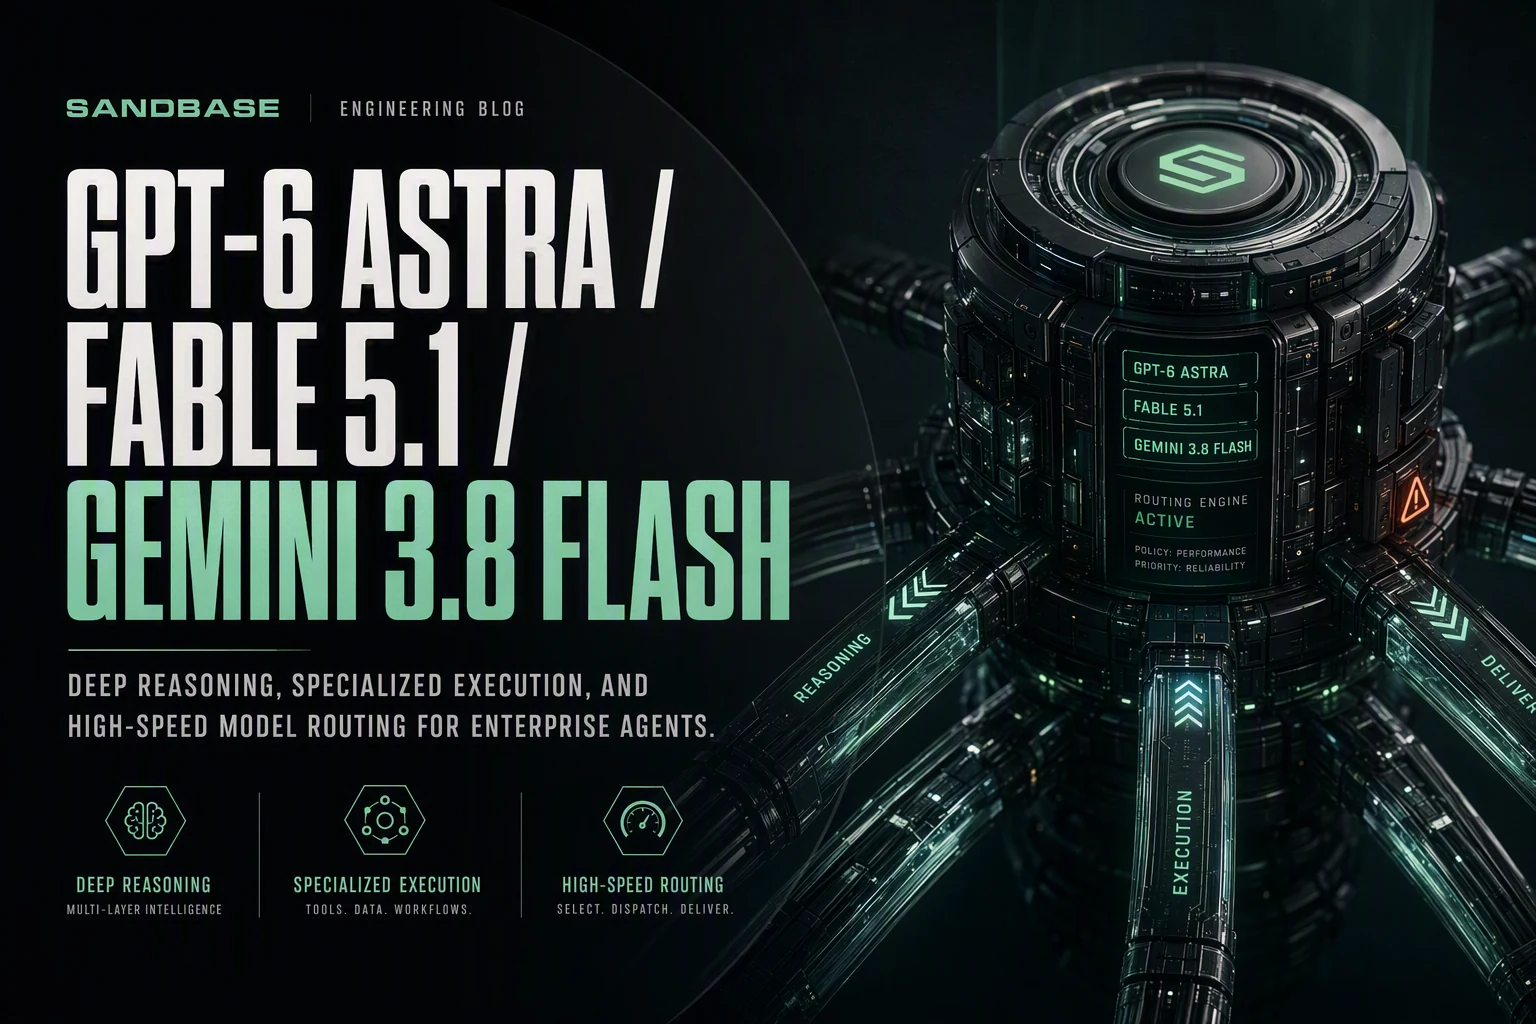
按任务、预算与失败方式比较 GPT-6 Astra、Claude Fable 5.1 和 Gemini 3.8 Flash,给出代码 Agent 的重试、升级和人工审批示例,不把不同跑分当统一排名。
阅读
Codex Persistent Mode 的公开代码说明了什么?区分 8 月报道、后续任务与休眠机制,核对权限、记忆和费用边界;代码存在不等于产品已经普遍开放。
阅读