用一个 API 监测 Reddit 社区:一套实用工作流 | SandBase
搭一套 Reddit 社区监测工作流:评估社区规模、发现话题讨论、给背后的作者建档——一把 SandBase key,不用 OAuth 应用。
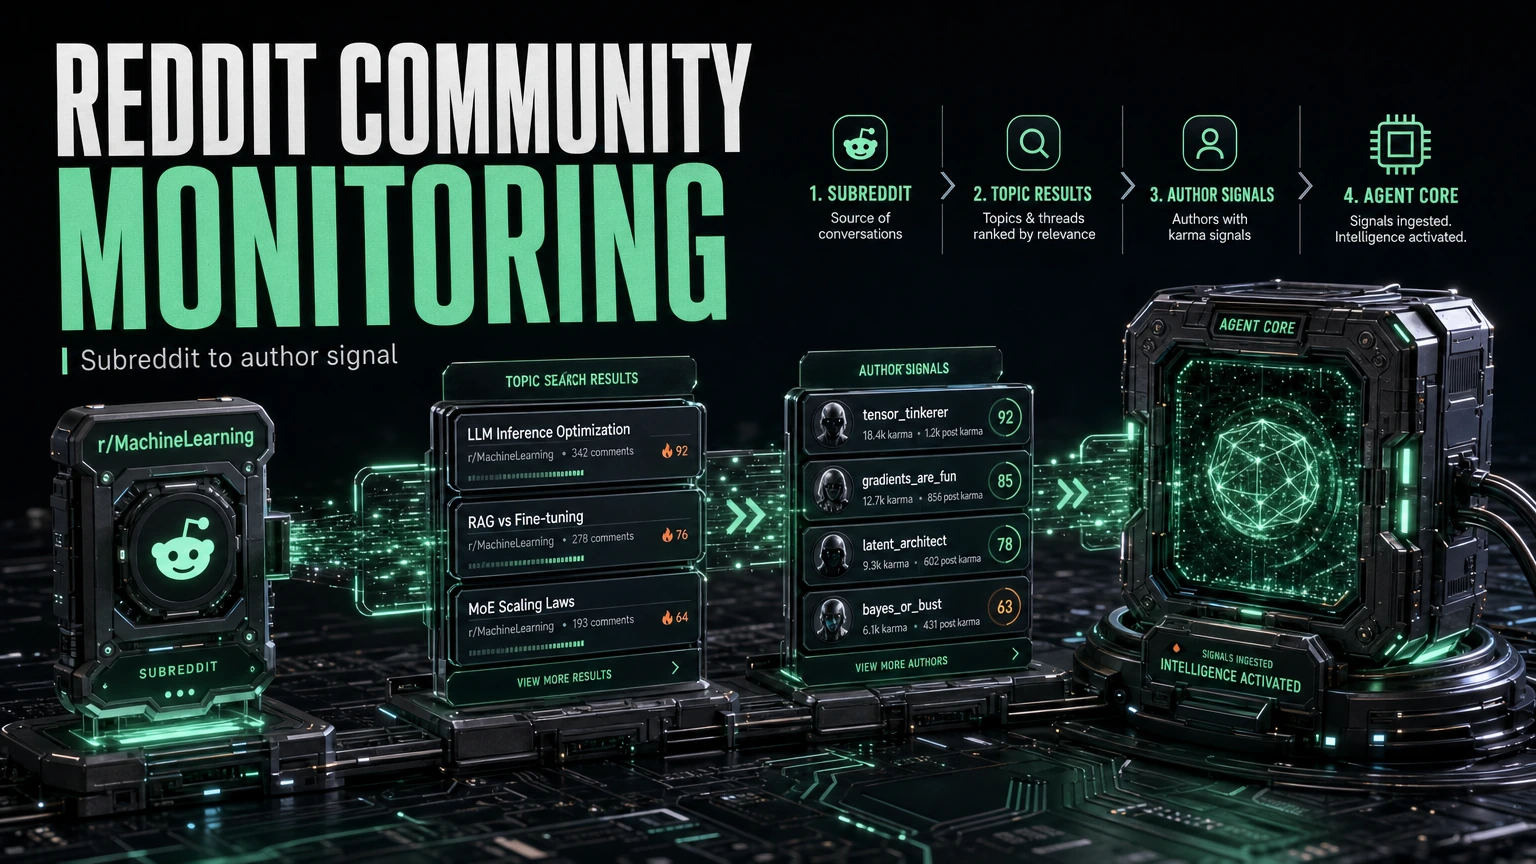
在 Reddit 上做社区监测,归根到底是三个问题:这个社区有多大、大家在就我关心的话题说什么、以及是谁在说?这篇教程用 SandBase Reddit API 说明这三个问题各自所需的请求组件——你自己不用 Reddit OAuth 应用,也不用 PRAW,但仍然需要一把 SandBase API key。端点参考只保证响应信封(id、status、model、outputs[0].data);下面出现的业务字段是示例结构、并非保证的 schema,所以字段名和数值都当作示例看,以真实响应为准核对。
如果你想先看完整的端点全景,从 Reddit 公开数据 API hub 开始。这一篇提供请求组件和明确标注的字段映射示意。
先说结论
- 三步:
subreddit-info(基线)→dynamic-search(发现)→user-profile(作者信号)。- 每次都是
POST /v1/api/reddit/<path>,一把SANDBASE_API_KEY;响应共用{ id, status, model, outputs }信封。- 在这些示例结构里,Reddit 的载荷嵌在命名键下(
subredditInfoByName、redditorInfoByName)——读准确的路径,并以真实响应为准核对。- 只有信封(
id、status、model、outputs[0].data)是保证的;业务字段是示例——以真实响应为准核对。- 只是公开、只读数据;你自己不用 Reddit OAuth 应用,也不能发帖或投票,但仍需要一把 SandBase API key。
工作流全貌
| 步骤 | 端点 | 输入 | 你拿到 |
|---|---|---|---|
| 1. 评估社区 | reddit/app/subreddit-info | subreddit_name | 订阅数、类型、描述 |
| 2. 发现讨论 | reddit/app/dynamic-search | query | 某话题的搜索结果 |
| 3. 给作者建档 | reddit/app/user-profile | username | karma 明细、账号标记 |
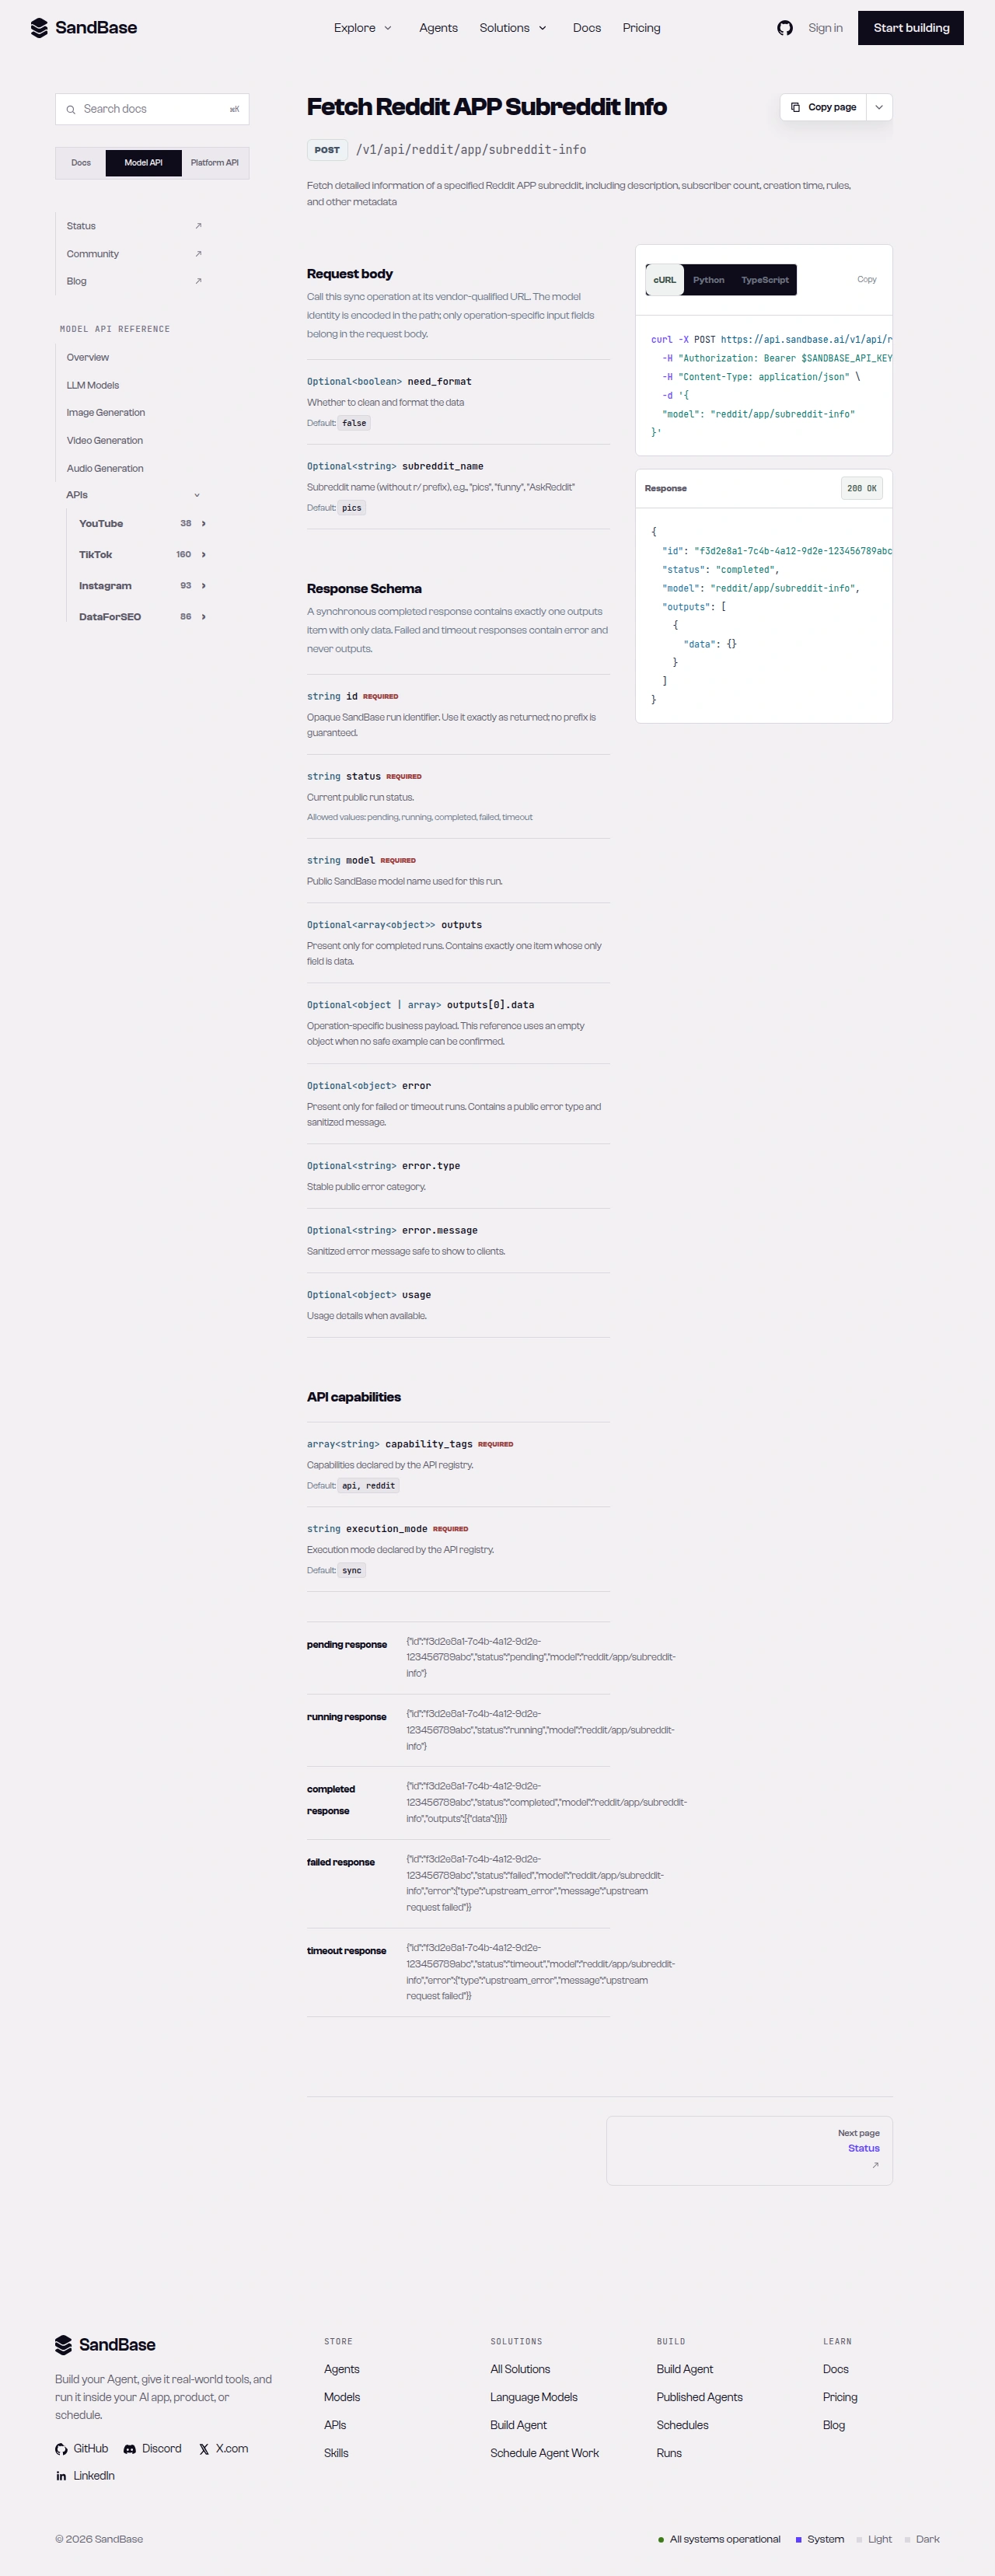 原 app 参考页历史截图;当前参数可能变化,请以链接中的在线参考为准。端点的 API 参考是每个参数名和响应路径的权威来源。
第 1 步 —— 评估社区
监测一个社区之前,先建立基线:它有多大、多活跃?按名称解析社区:
以下是请求示例,不是新实测回执。先加载辅助函数定义,再单独执行需要的请求。
import os
import requests

BASE = "https://api.sandbase.ai/v1/api/reddit"
API_KEY = os.environ.get("SANDBASE_API_KEY")
if not API_KEY:
    raise RuntimeError("Set SANDBASE_API_KEY before making a request")

HEADERS = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json",
}


def call(path: str, params: dict) -> dict:
    resp = requests.post(
        f"{BASE}/{path}", headers=HEADERS, json=params, timeout=90
    )
    resp.raise_for_status()
    try:
        body = resp.json()
    except ValueError as exc:
        raise RuntimeError("SandBase response was not valid JSON") from exc

    if not isinstance(body, dict):
        raise RuntimeError("SandBase response was not a JSON object")
    status = body.get("status")
    if status != "completed":
        safe_status = status if isinstance(status, str) and status in {
            "failed", "timeout", "running", "queued"
        } else "unknown"
        error = body.get("error")
        error_kind = "none" if error is None else (
            "object" if isinstance(error, dict) else "non-object"
        )
        raise RuntimeError(
            f"SandBase request did not complete: {safe_status}; error={error_kind}"
        )

    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs:
        raise RuntimeError("SandBase response is missing outputs[0]")
    first = outputs[0]
    if not isinstance(first, dict) or "data" not in first:
        raise RuntimeError("SandBase response is missing outputs[0].data")
    payload = first["data"]
    if not isinstance(payload, dict):
        raise RuntimeError("SandBase outputs[0].data was not a JSON object")
    return payload
下面保留原 app 字段映射示意,使用 Python 风格伪代码;实现前请先检查真实载荷。
info = call("app/subreddit-info", {"subreddit_name": "programming"}).get("subredditInfoByName", {})
print(info.get("name"), info.get("subscribersCount"), info.get("type"))
# 示例输出:programming 6922588 PUBLIC
注意这个示例结构里的嵌套:载荷在 subredditInfoByName 下,带 name、subscribersCount、type 这样的字段。只有信封是保证的,所以这里保留的是字段映射伪代码,实际使用前仍需检查类型。上面的数值是示例——一次社区读取可以浮现订阅数、一个 type 和一个社区 id,但请以真实响应为准核对具体字段名和数值,因为业务字段不是保证的 schema。把这个基线存下来,后续运行就能追踪订阅数随时间的增长。
第 2 步 —— 发现话题讨论
有了基线,就搜索关于你话题的讨论。dynamic-search 接一个 query(你的搜索关键词),按参考它还有相互独立的可选参数:用于支持的结果类型排序的 sort、用于帖子或媒体时间筛选的 time_range,以及从上一次响应带过来、用来取下一页的 after 游标:
results = call("app/dynamic-search", {"query": "machine learning"})
# results 是一个结构化的搜索布局——读 schema,
# 并看一份真实响应,对准你实际要用的字段路径再迭代;
# 要翻页,就传上一次响应里的 `after` 游标
dynamic-search 的响应是一个结构化布局,不是扁平列表,当前参考列出了嵌套布局,具体字段仍需核对实际响应。带上 query 和你需要的可选 sort 跑一次真实请求,看响应,对准你实际用到的字段路径——不要假设一次调用就同时返回帖子和社区。
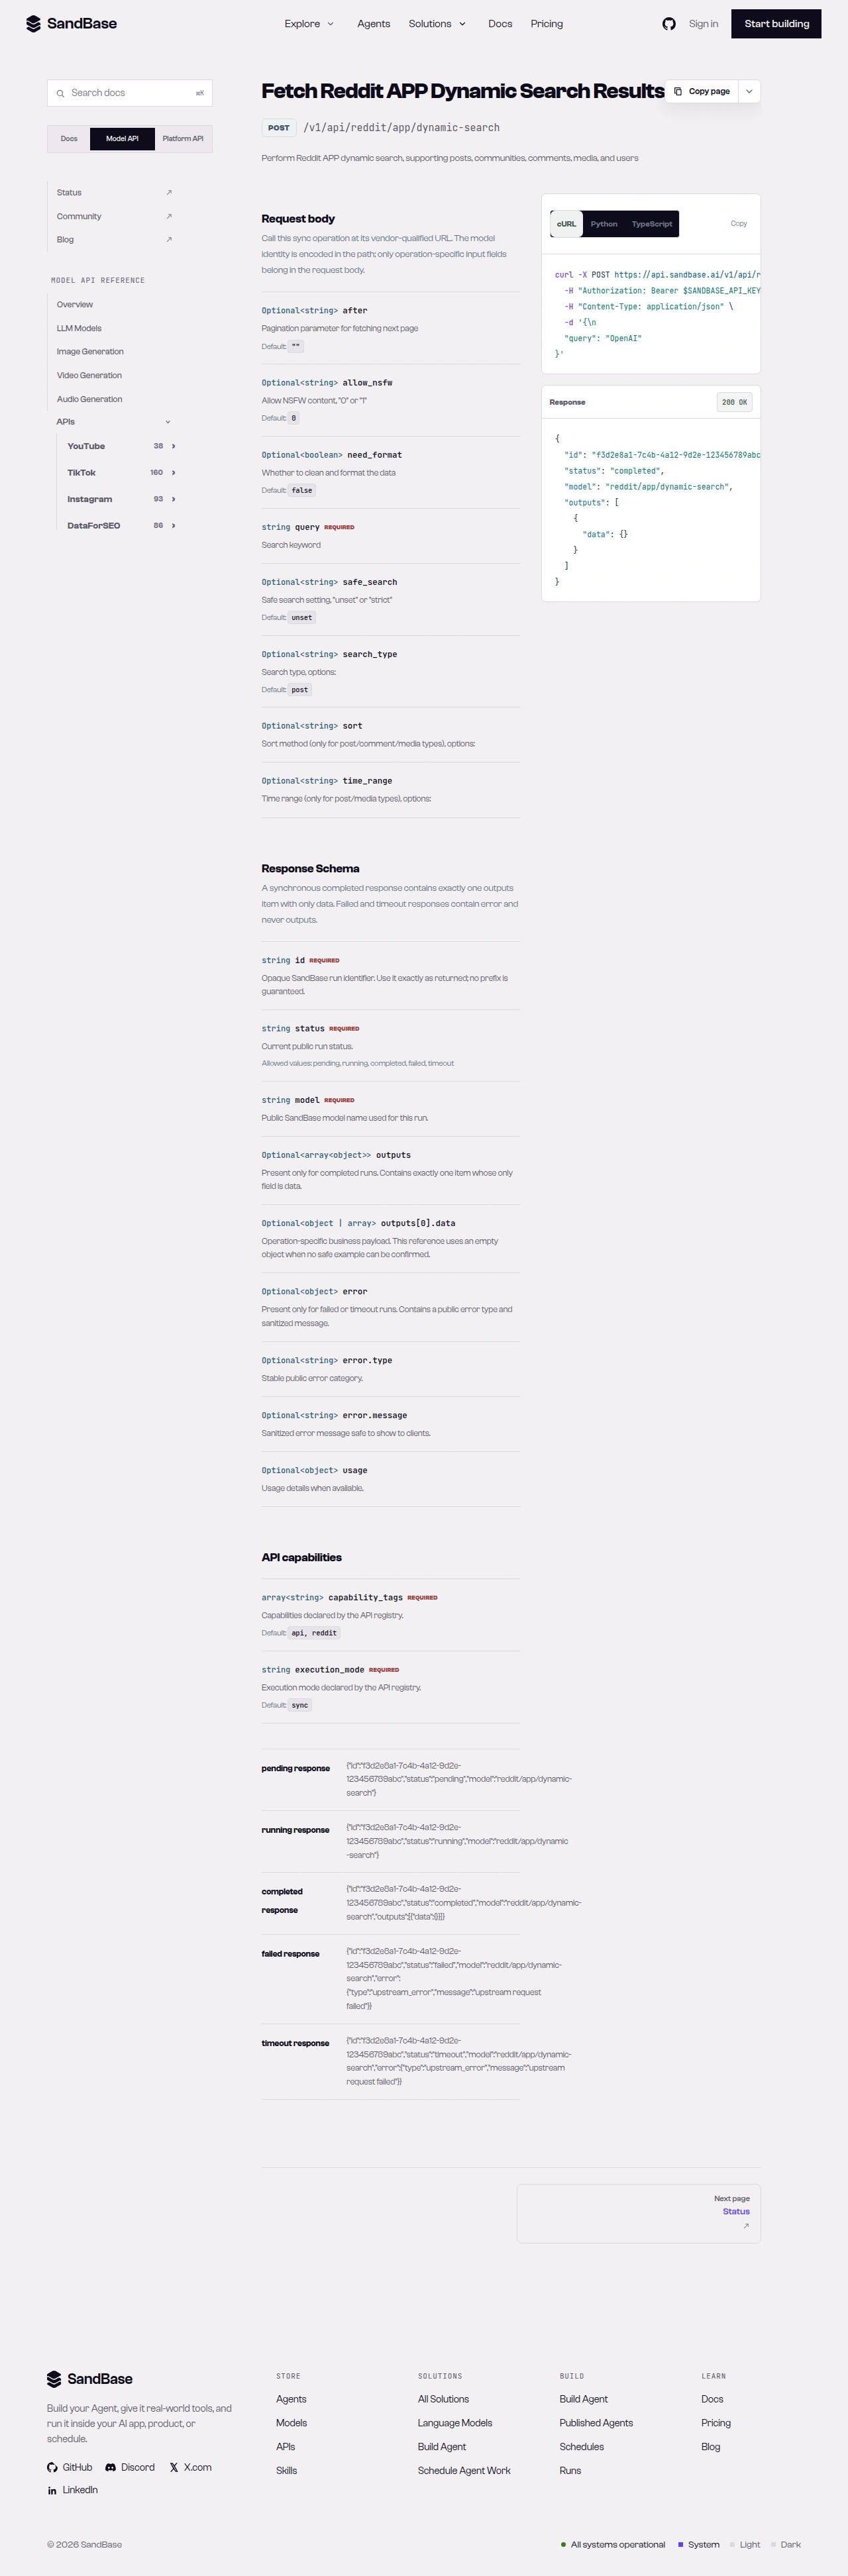 原 app 参考页历史截图;当前参数可能变化,请以链接中的在线参考为准。dynamic-search 在 search 键下返回一个结构化布局——迭代前先读 schema。
第 3 步 —— 给作者建档
浮现出讨论之后,给背后的账号建档,以此给它们的信号加权。user-profile 接一个 username:
user = call("app/user-profile", {"username": "spez"}).get("redditorInfoByName", {})
karma = user.get("karma", {})
print(user.get("name"), karma.get("total"), "total karma")
# 示例输出:spez 940980 total karma
print("employee:", user.get("isEmployee"))
# 示例输出:employee: True
同样注意这个示例结构里嵌在 redditorInfoByName 下。一次用户读取可以浮现一个 karma 对象,带 fromPosts、fromComments 和 total 这样的字段,还有像 isEmployee 这样的账号标记。只有信封是保证的,所以这里是映射示意,不是已测试的解析器。把 karma 和账号年龄当作可选的排序或过滤信号——它们是上下文,不是对可信度或专业性的确证。下面是一个示例响应结构:业务字段不是保证的 schema,请把字段名和数值都当作示例,以一份真实响应为准核对具体字段(载荷会变、数值也会随时间变)。
{
"id": "a98dfb8b-afa5-4471-9f91-33cadaca5d99",
"status": "completed",
"model": "reddit/app/user-profile",
"outputs": [
{
"data": {
"redditorInfoByName": {
"name": "spez",
"id": "t2_1w72",
"isEmployee": true,
"karma": { "fromPosts": 184487, "fromComments": 756493, "total": 940980 }
}
}
}
]
}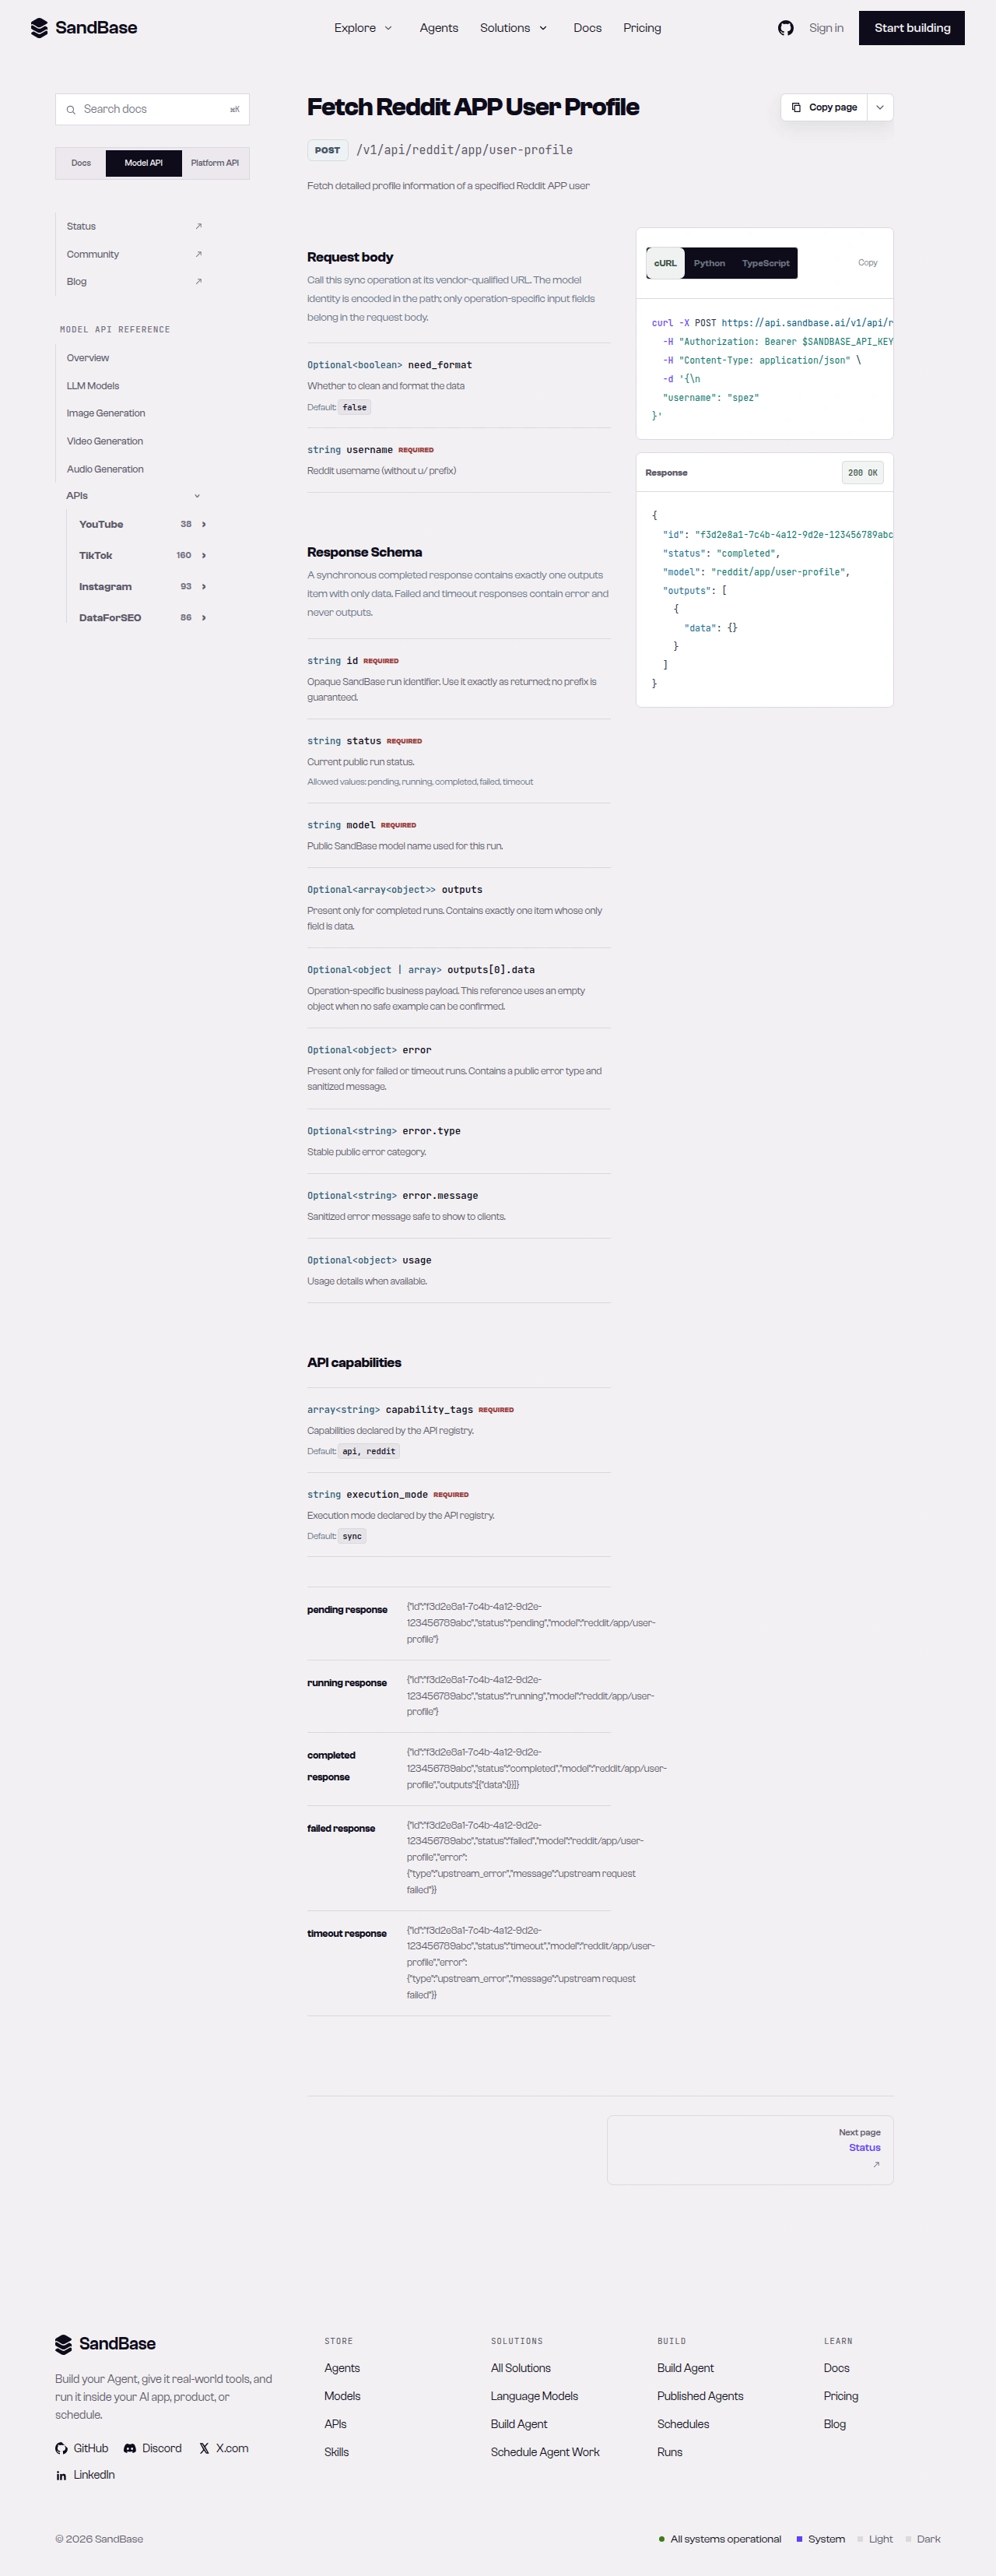 原 app 参考页历史截图;当前参数可能变化,请以链接中的在线参考为准。user-profile 在 redditorInfoByName 下返回 karma 和账号标记。
把它串起来
下面用 Python 风格的伪代码说明原有的三个组件,不是可以直接运行的完整监测程序。先检查响应,再决定怎样映射业务字段或选择作者;本文没有实现作者提取、数据存储或定时运行。
# 1. 请求社区基线。
baseline_payload = call("app/subreddit-info", {"subreddit_name": "programming"})
# 检查载荷,找到社区对象后再存储字段。
# 订阅数缺失时保留为未知,不要补成零。

# 2. 用原有 app 端点请求话题搜索。
hits = call("app/dynamic-search", {"query": "machine learning"})
# 检查布局,再手动选择一个已核对的公开作者用户名。

# 3. 按需请求该作者的公开资料。
# 将已核对的 username 传给 app/user-profile,再检查返回载荷。
# karma 有值才记录。isEmployee 缺失或为 null 时保留未知;
# 只有明确返回 false 才是 false。这里没有提供作者提取函数。
辅助函数统一检查响应信封。重试、限流退避、业务字段映射和持久化仍需另行实现并验证。
先搜索一个 subreddit,再查看选定帖子的评论
如果已经知道要研究哪个社区,可以先用 Reddit Subreddit Search API,在该社区内按关键词搜索帖子。这里传入不带 r/ 的 programming,关键词用 agent,排序设为 new,时间范围设为 month。这只是请求示例,不是已经跑通的结果,也不是完整监测程序。
复用前面的辅助函数,单独发起第一页搜索请求:
search_payload = call("subreddit-search", {
    "subreddit": "programming",
    "query": "agent",
    "sort": "new",
    "timeframe": "month",
})
print("Search payload keys:", sorted(search_payload))
辅助函数读取的是 outputs[0].data。接下来要单独检查这个业务载荷:文档示例有 found,帖子列表位于其内部的 data.posts,不是平台响应的顶层字段。这段代码只打印键名,不解析搜索结果。帖子正文也可能缺失或被截短。
手动选择一个帖子,在 Reddit 打开它,核对完整 URL 对应的是公开帖子。将这个完整链接设置为环境变量 REDDIT_POST_URL,再单独调用 Reddit Post Comments API 获取评论第一页:
POST_URL = os.environ["REDDIT_POST_URL"]
comments_payload = call("post-comments", {"url": POST_URL})
print("Comments payload keys:", sorted(comments_payload))
评论文档示例在业务载荷中使用 found 和 data.comments。评论是带 parentId 关联的平面数组;拿到一页不等于拿到了完整讨论。这里没有自动选择搜索结果,也没有重建评论树。
两个默认请求都不带游标或 requireFields。以后确实需要搜索分页,并接受可能更高的报价时,才在第一页搜索请求里加入 "requireFields": ["nextCursor"]。指定字段可能改变来源和价格;不支持的字段组合可能被拒绝,来源本身没有的字段仍可能缺失,后续页面会沿用第一页的来源。不要承诺固定价格或一定有游标。先检查真实响应,确认存在完整有效的 data.nextCursor,再将它作为 cursor 传入;搜索条件保持不变,评论分页则保持同一个 url。不要拿文档里截短的展示 token 续页。
处理粗糙的边角
- 注意嵌套。 在这些示例结构里,Reddit 的载荷在命名键下(
subredditInfoByName、redditorInfoByName)。只有信封是保证的,所以读准确的路径要防御式,别假设是顶层字段。 - 迭代前先看
reddit/app/dynamic-search。 它的布局是结构化的,不是扁平列表,字段是否可用仍需核实——从真实响应里对准字段路径,用after游标翻页,需要特定顺序时再设sort。 - 先检查 HTTP、JSON 和响应信封。 辅助函数会在 HTTP 错误、无效 JSON、非 completed 状态,以及
outputs[0].data缺失或格式不符时抛错。error可能为 null 或其他类型,不能假定它一定是对象。业务字段仍需检查;这里没有实现自动重试或退避。 - 尊重速率限制。 遇到 HTTP 429 用退避,并控制轮询节奏。
- 只是公开数据。 你自己不用 Reddit OAuth 应用,不能投票、发帖,也访问不了私密社区——但每次调用都用一把 SandBase API key 鉴权。
为什么在 API 层做监测
核对实际要用的字段,并补齐存储、去重和错误处理之后,公开 API 读取可以成为监测系统的输入。本文提供请求组件和原有 app 工作流的示意,没有实现定时监测,也没有证明订阅趋势、完整讨论覆盖或情感分析结果。
不同端点可以共用辅助函数检查平台信封,但输入参数和业务载荷仍各有不同。先发起一个请求,检查响应,再手动选择下一个公开资源。加入按 URL 获取评论的请求,并不等于已经实现完整的“搜索到评论”流水线。
常见问题
需要 Reddit 的 OAuth 应用或账号吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权。这些读取端点不用 Reddit OAuth 应用、不用 PRAW,你这边也不用账号。
结果和评论怎么翻页?
原有 reddit/app/dynamic-search 和 reddit/app/post-comments 使用 after;app 评论另有排序参数 sort_type。归一化的 reddit/subreddit-search 与按 URL 读取的 reddit/post-comments 使用 cursor。先检查所选端点和真实响应,不要跨变体照搬分页参数。
能读私密或仅限账号的数据吗? 不能。这套工作流只是公开、只读数据——社区统计、搜索结果和公开的资料字段。不能投票、发帖,也访问不了私密社区。
下一步
现在你有了可单独检查的请求组件,以及一份可以改造的工作流示意,还不是完整运行的社区监测系统。先核对响应,再补齐解析、存储和可靠性处理,之后才能把它当作可重复运行的系统。
如需另外接入应用,可了解 Personal Agent API。这些 HTTP 示例不会创建或运行托管 Agent。
觉得有用?分享给更多人