Pinterest 视觉研究 API 教程 | SandBase
搭一套 Pinterest 视觉研究工作流:列出品牌的 board、读一个 board 的 pin、再用搜索扩大范围——一个 SandBase 密钥,无需 Pinterest 登录。
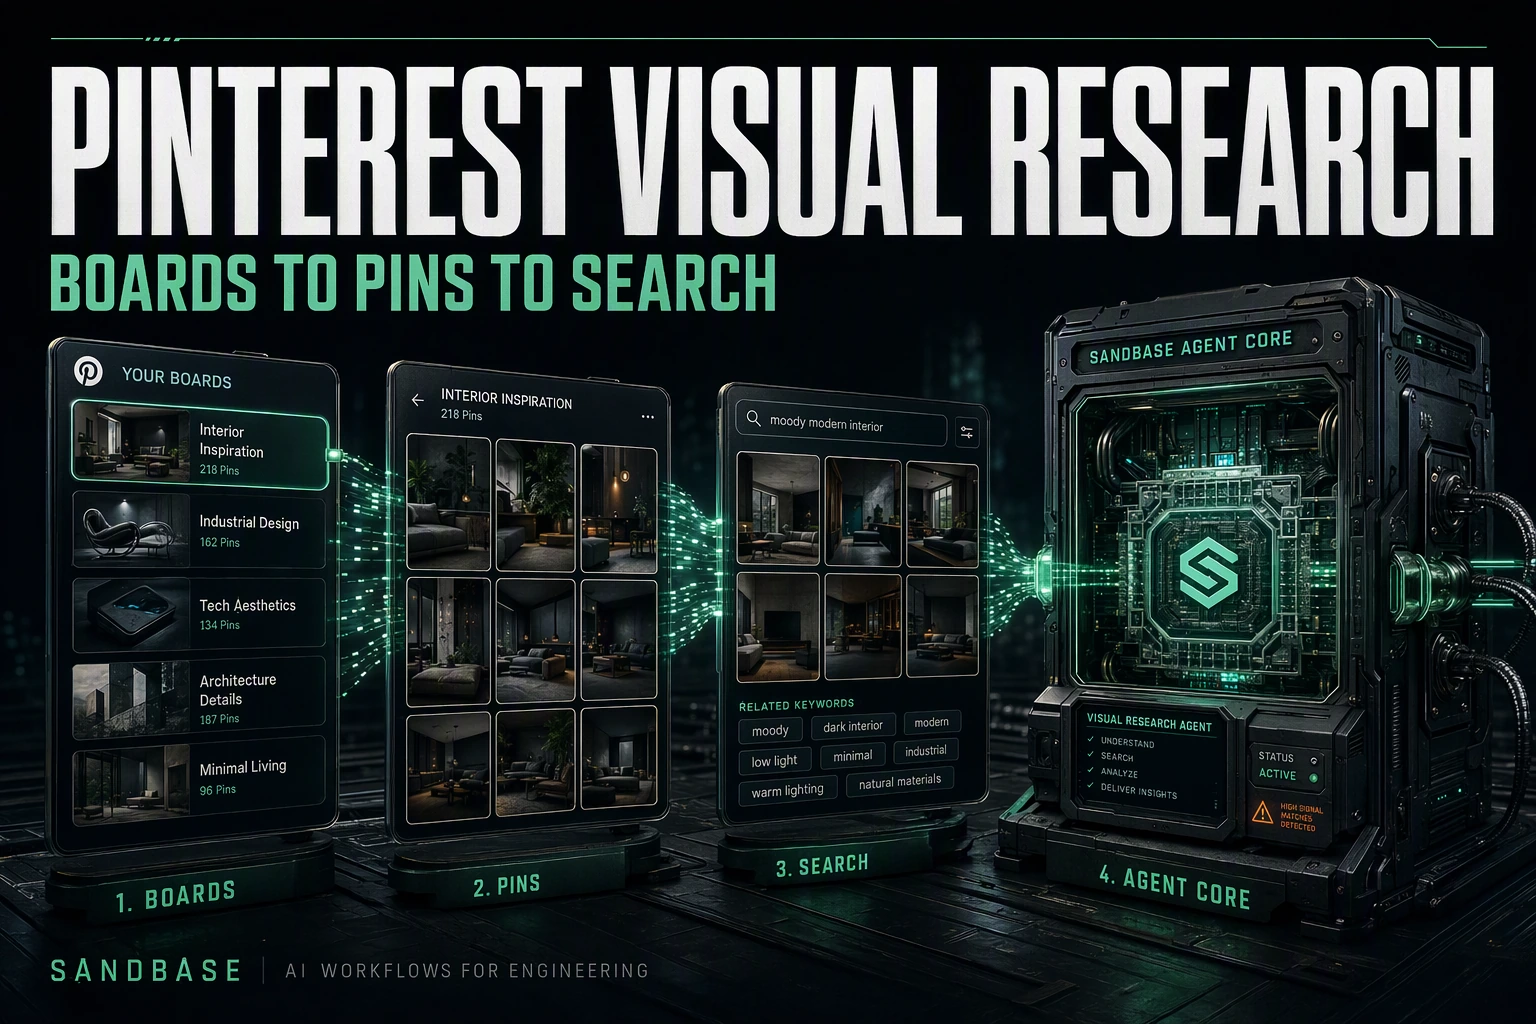
如果你在 Pinterest 上做视觉趋势研究——一个品牌如何策展、一个 board 收集了什么、某个主题下正在浮现什么——你想要一个可复用的循环:列出一个 handle 的 board、打开重要的那些、再用关键词搜索把网撒大。这篇 Pinterest 视觉研究 API 教程用三个 SandBase 端点把这个循环串起来,让 Agent 能端到端跑完。它建立在 Pinterest 公开数据 API 汇总页之上;建议先读那篇了解全局。
这里的一切都是公开、只读数据。不需要登录 Pinterest、不需要 SDK——但仍需要一个 SandBase API 密钥来鉴权。端点 API 参考是参数和响应信封的权威来源;下面的载荷字段名来自我实际跑的调用(测试于 2026-09-27,UTC),仅供观测——并非文档保证——请以真实响应为准核对,因为负载会随时间变化。
先说结论
- 三个端点构成循环:
user-boards→board→search。- 每次调用都是
POST /v1/api/pinterest/<path>,只传该端点的参数,一个SANDBASE_API_KEY。- 信封可能不同:参考记录的是
outputs[0].data,但在我的调用里负载常出现在一个顶层output对象下,含一个success标记、一个结果列表和一个cursor——两种结构都读。- 以自然输入链式串联:一个
handle列出 board,每个 board 的url打开它的 pin,一个query扩大集合。
工作流一览
- 用
pinterest/user-boards为一个 handle 列出 board。 - 用第 1 步里的一个 board
url调用pinterest/board打开一个 board。 - 用一个
query调用pinterest/search用搜索扩大范围,抓到该品牌之外的 pin。
每个端点返回相同信封——一个 id、一个 status、model。参考记录负载在 outputs[0].data 下;在我的调用里它常出现在一个顶层 output 对象下,承载 success、一个结果列表和一个 cursor。failed 或 timeout 的运行带 error。两种结构都读(优先 output,回退 outputs[0].data),把 status 检查写一次。
本教程使用每个端点专属的 Model API 参考及其 POST https://api.sandbase.ai/v1/api/pinterest/... 路径。Pinterest 目录卡片暴露的是另一个 GET /apis/v1/pinterest/... 面——不要用目录路径替代。下面每一步都链接它的确切参考。
SandBase vs. Pinterest 官方平台
| 你的需求 | 用 |
|---|---|
| 公开、只读的视觉研究 | SandBase Pinterest 公开数据 API |
| 发帖、保存 pin,或以会员身份操作 | Pinterest 官方平台 |
| 私有或仅账号可见的数据 | 两种公开方案都不适用 |
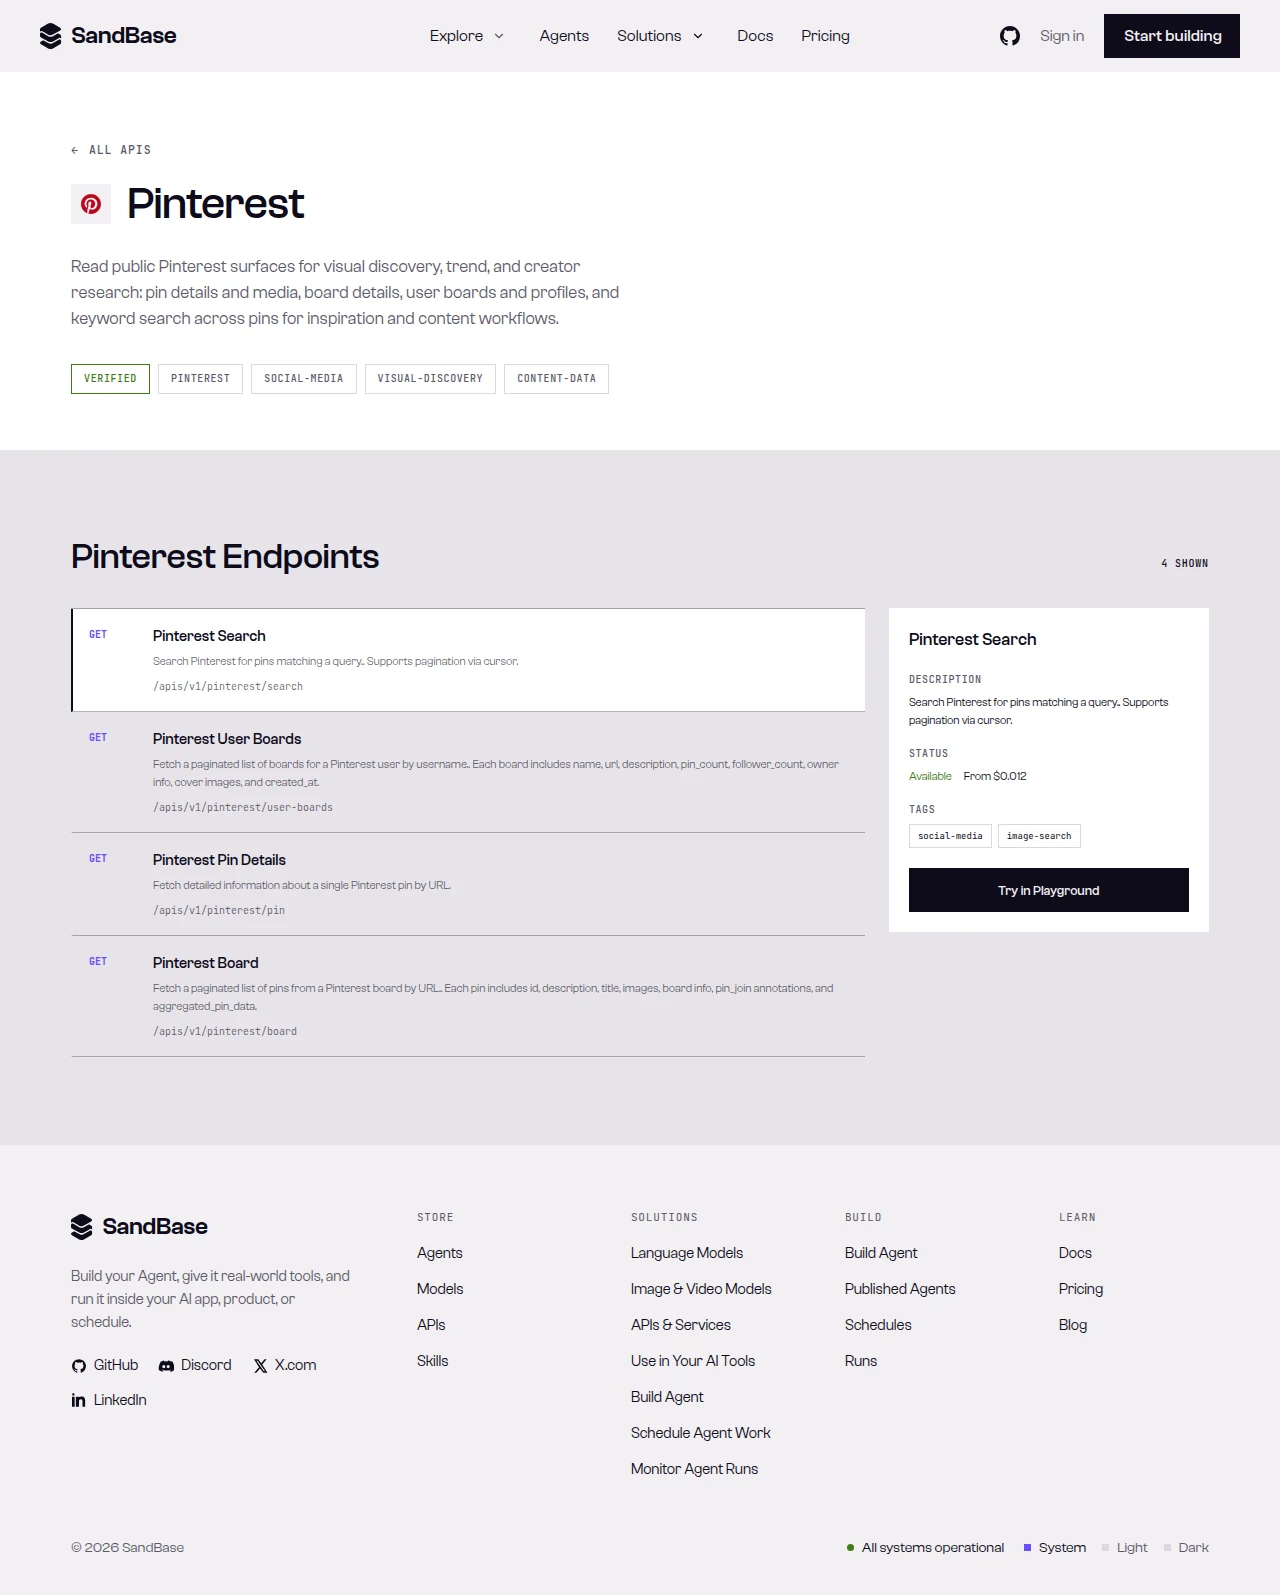 SandBase 上的 Pinterest 端点——user-boards、board 和 search 驱动这个循环。
第 0 步:一个辅助函数管所有调用
import os
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call(path: str, payload: dict) -> dict:
    resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=70)
    resp.raise_for_status()
    body = resp.json()
    if body.get("status") != "completed":
        error = body.get("error", {})
        raise RuntimeError(error.get("message", f"{path} 未完成"))
    # 信封可能不同:优先读顶层 output,否则 outputs[0].data。
    output = body.get("output")
    if output is None and body.get("outputs"):
        output = body["outputs"][0].get("data", {})
    return output or {}
下面每一步都用 .get() 防御式读取有名字的字段。
第 1 步:列出一个 handle 的 board
out = call("pinterest/user-boards", {"handle": "nike"})
boards = out.get("boards", []) if out.get("success") else []
print(len(boards), "个 board")
在我抓到的响应里(user-boards run id 962cce4c-cfc8-4fb1-8ed4-943109e4dd97,测试于 2026-09-27,UTC),output 带一个 success 标记、一个 boards 列表和一个 cursor。每个 board 带一个 name、一个 url、一个 pin_count 和一个 description。字段名会随时间变化——把它们当作观测到的,并对照真实响应核对。
first = next((b for b in boards if isinstance(b, dict) and b.get("url")), None)
board_url = first.get("url") if first else None
第 2 步:打开一个 board 的 pin
out = call("pinterest/board", {"url": board_url})
pins = out.get("pins", []) if out.get("success") else []
cursor = out.get("cursor")
print(len(pins), "个 pin,还有更多:", bool(cursor))
在我这次运行里(board run id 74fa4c3d-6e7d-4c0b-9d7a-61787d564a65),负载带一个 success 标记、一个 pins 列表和一个 cursor。翻页时,用返回的 cursor 重发 board——确切参数名请对照 board API 参考核对。
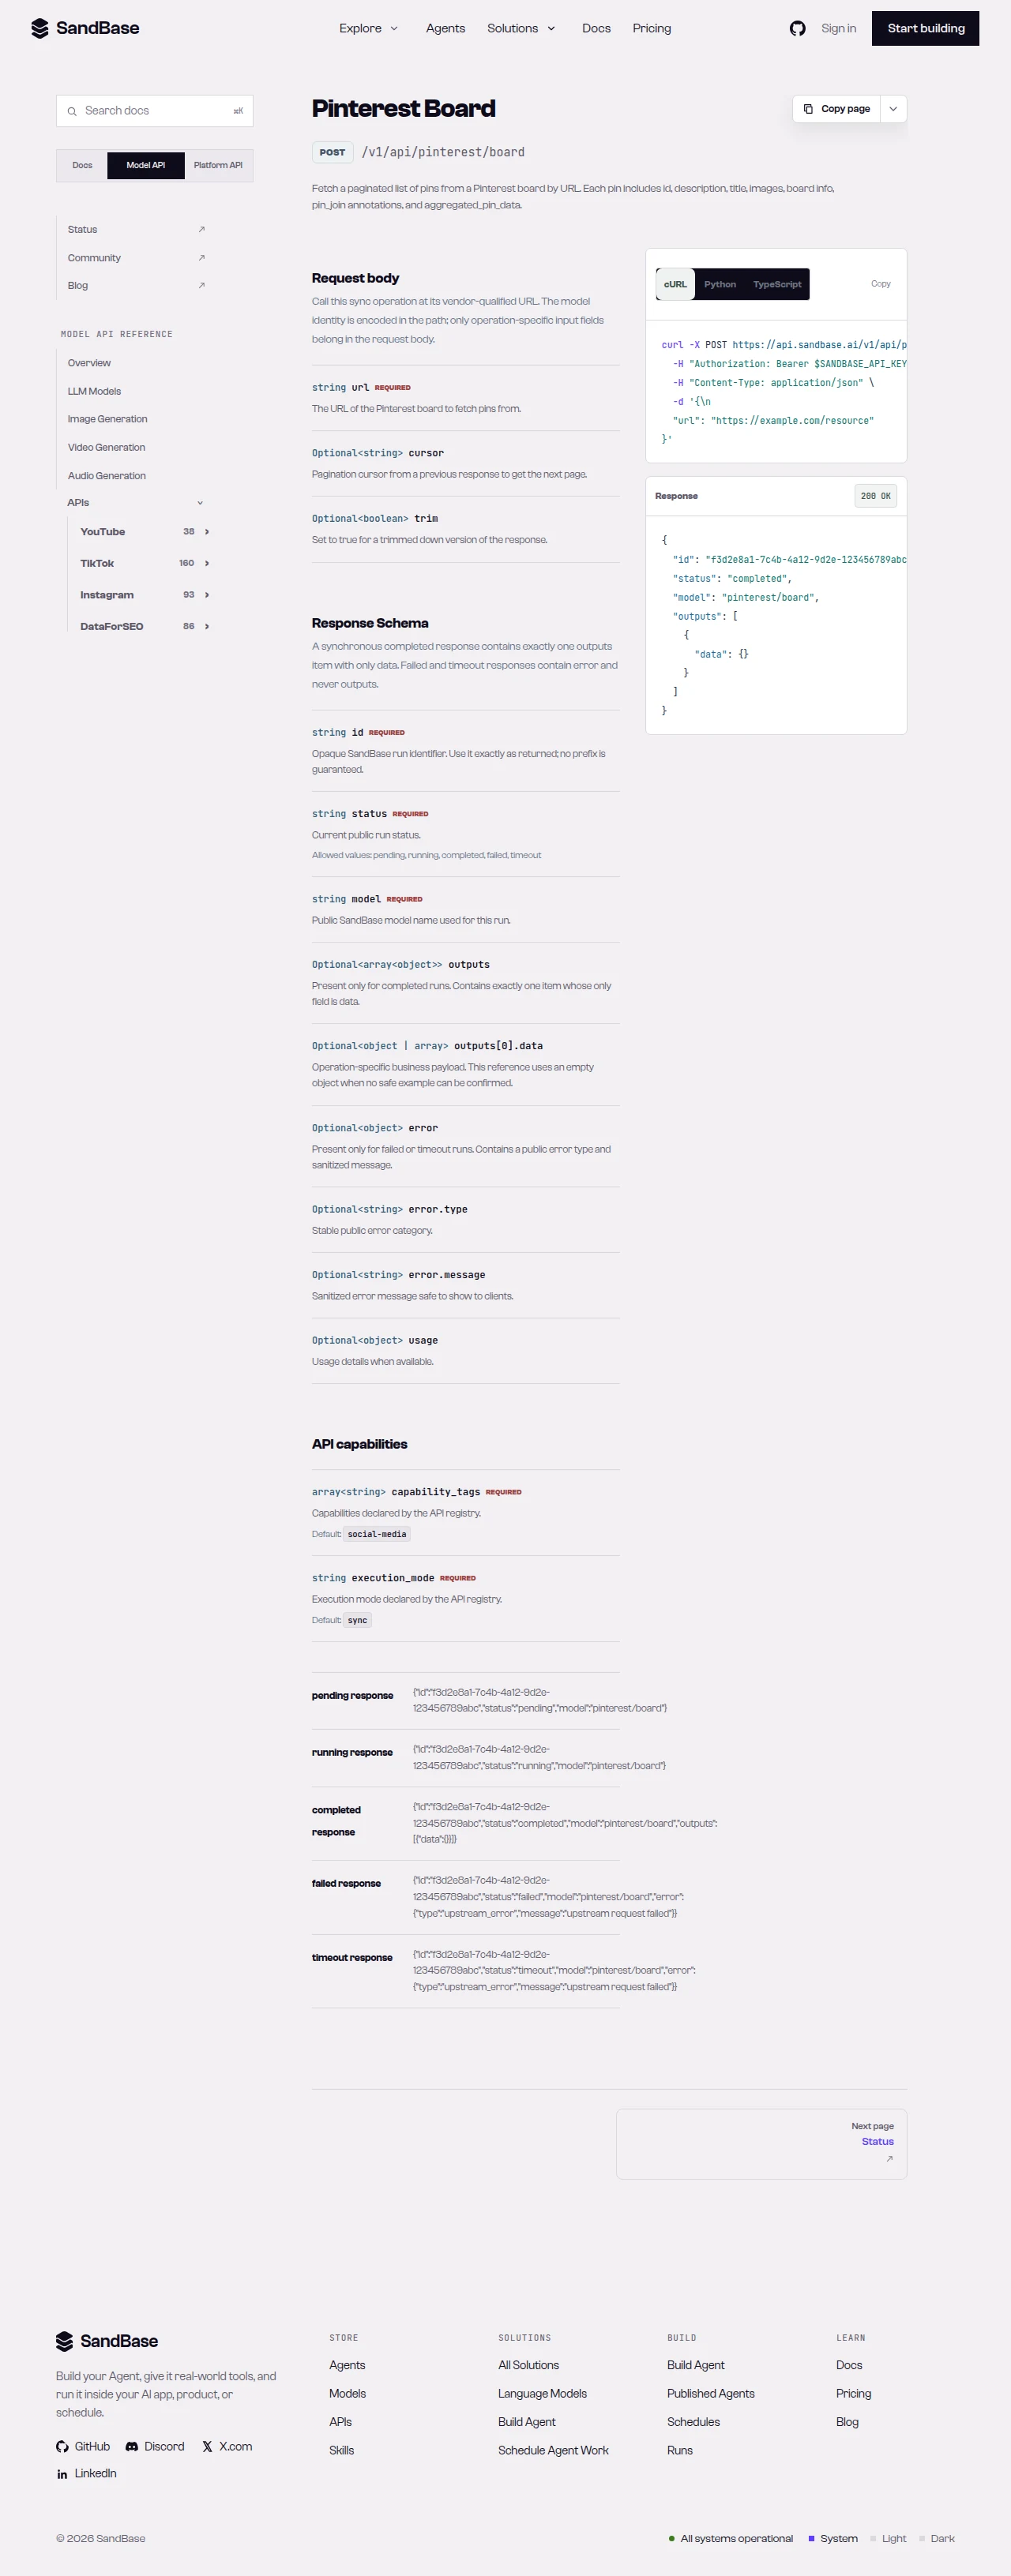 board 参考——
url 参数和响应路径的事实来源。
第 3 步:用搜索扩大范围
out = call("pinterest/search", {"query": "minimalist kitchen"})
pins = out.get("pins", []) if out.get("success") else []
print(len(pins), "个搜索 pin")
search 端点接受一个 query,返回 pins 加一个 cursor(我这次运行的搜索 run id 7298c08a-09be-471b-978a-b155a323d9e3)。这把你的集合从一个品牌的 board 扩大到某个主题下正在浮现的一切。确切参数见 search API 参考。
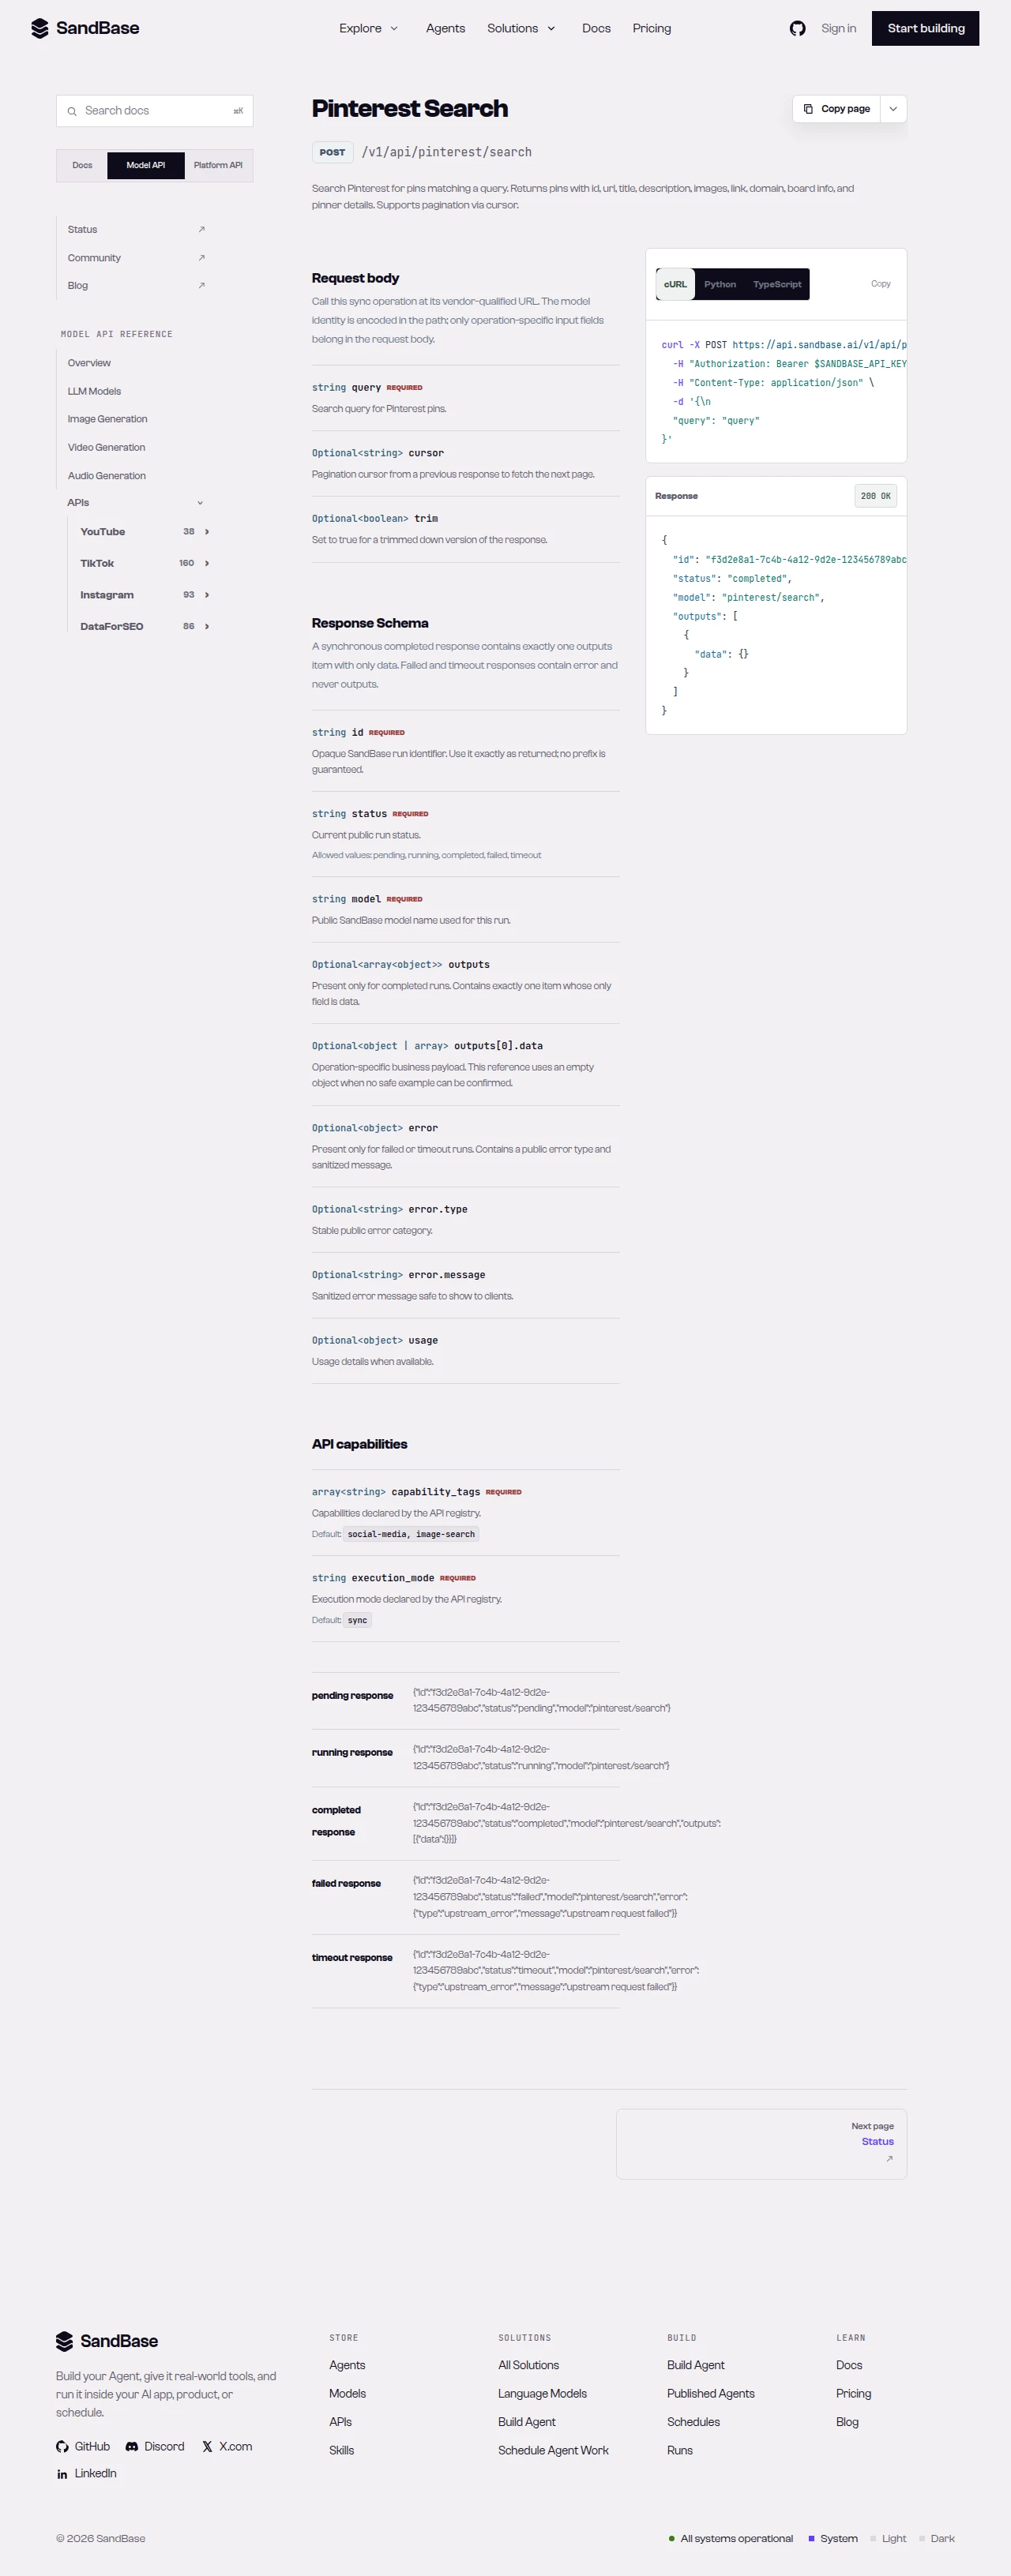 search 参考——传一个
query;用返回的 cursor 翻页。
串起来
def research(handle: str, query: str):
    boards_out = call("pinterest/user-boards", {"handle": handle})
    boards = boards_out.get("boards", []) if boards_out.get("success") else []

    collected = []
    for b in boards:
        if not isinstance(b, dict) or not b.get("url"):
            continue
        board_out = call("pinterest/board", {"url": b["url"]})
        collected.append({
            "board": b.get("name"),
            "pins": board_out.get("pins", []) if board_out.get("success") else [],
        })

    search_out = call("pinterest/search", {"query": query})
    return {
        "boards": collected,
        "search": search_out.get("pins", []) if search_out.get("success") else [],
}因为三个端点共享同一个信封,循环保持扁平:call(...) 里一次 status 检查、一次 output.success 兜底、处处同一套 .get() 模式。标识从一步流向下一步——一个 handle 产出 board,每个 board 的 url 产出 pin。
实操要点
- 信封可能不同。 参考记录的是
outputs[0].data;在我的调用里负载常出现在一个顶层output对象下、带一个success标记。两种结构都读(优先output,回退outputs[0].data)并按status分支。 - board 需要一个有效的
url。 从一次user-boards结果里取,而不是自己拼。 - 用
cursor翻页。board和search都返回一个cursor;重发它取下一页。参数名对照参考核对。 - 业务字段仅供观测。 参考保证的是信封;把
boards、pins、pin_count之类当作观测到的、以真实响应核对。 - 仅公开、只读数据。 不发帖、不保存、不涉及私有或仅账号可见数据。用 SandBase API 密钥鉴权。
- 做个好客户端。 遇到 HTTP 429 等瞬时错误按退避重试;用游标翻页而不是猛打。
常见问题
我需要 Pinterest 登录或 SDK 吗?
不需要。你用自己的 SANDBASE_API_KEY 向 SandBase 鉴权。这些读取端点不需要你这边有 Pinterest 账号或 OAuth。
为什么这个面返回 output 而不是 outputs?
参考记录负载在 outputs[0].data 下;在我的调用里它常出现在一个顶层 output 对象下,含一个 success 标记、一个结果列表和一个 cursor。两种结构都读(优先 output,回退 outputs[0].data),再检查 success、防御式读列表。
我怎么拿到 board url?
从 user-boards。output.boards 里每个 board 带一个 url,直接传给 pinterest/board。
怎么翻更多 pin?
board 和 search 都在 output 里返回一个 cursor。用游标重发同一个调用取下一页。确切参数名对照参考核对。
小结
三个端点、一个 output 信封、标识在步骤间流动——这就是整个视觉研究循环。完整端点目录和响应细节见 Pinterest 公开数据 API 汇总页。准备好后: