MiniMax M3.1 Flash 对比 GLM、DeepSeek、Gemini、Claude:城市脚本实测
让 MiniMax M3.1 Flash、GLM-5.3-Flash、DeepSeek V4.1 Flash、Gemini 3.8 Flash 和 Claude Sonnet 5.5 写同一段城市影片脚本,72 个请求位的真实调用,对比 JSON 可用率、城墙轮廓、坐标与成本。
默认档位下,MiniMax M3.1 Flash 在 9 次请求里有 7 次把 16,000 个 completion token 全花在思考上,一行 JSON 都没返回。任务并不复杂,只是城市影片脚本里的一个时代。把 reasoning_effort 设成 "low",同一个模型 9 次全部返回可用的 JSON,中位耗时 25.6 秒,9 次加起来只花了 $0.0154。
如果你打算在 AI City Remix(SandBase 的城市故事视频挑战赛)里用 M3.1 Flash 当导演模型,先要知道这一点,但不止这一点。2026 年 10 月 23 日,我们把同一个写时代的任务交给 GLM-5.3-Flash、DeepSeek V4.1 Flash、Gemini 3.8 Flash 和 Claude Sonnet 5.5,每个回答都用 Skill 自带的校验器和 Wikidata 坐标打分。如果你要让模型写结构化 JSON,内容又带地理坐标、事实很多,这篇是写给你的。比赛规定必须用 M3.1 Flash 导演,所以对参赛者来说,真正有用的问题是:它写完之后,你该查什么。
MiniMax M3.1 Flash 和其他模型对比:先说结论
- M3.1 Flash 开 low,Gemini 3.8 Flash 和 Claude Sonnet 5.5 用默认档,都是 9 次全部可用;GLM-5.3-Flash(low)9 次里 7 次可用;DeepSeek V4.1 Flash 即使开 low,也只有 5 次可用。
- 失败的主因是默认档位。DeepSeek、GLM 和 M3.1 Flash 在默认档位下,各有 4–7 次撞上 16,000 token 上限,返回内容为空。
- 知名地标的坐标谁都没问题:对照 Wikidata,中位误差在 12–34 米之间(只统计可用回答多于一个的配置)。
- 拉开差距的是城墙轮廓。Gemini 和 Claude 画的多边形,一共框住了 30 个指定地标中的 29 个;M3.1 Flash 只框住 15 个里的 5 个,巴黎城墙面积只有史料记载 253 公顷的 0.11–0.62 倍。
- 按 SandBase 标价,在可用时代不少于 5 个的配置里,每产出一个可用时代的成本,从约 $0.0009(GLM low)、$0.0017(M3.1 Flash low),到 $0.025(Gemini)和 $0.055(Claude)不等。
为什么拿城市脚本来测
city-through-time 这个 Skill 能把一份 story.json 变成带旁白的地图影片。模型只负责写文本:年份、标签、旁白、颜色、每段城墙的 OpenStreetMap 引用、一个兜底多边形,再加最多两个带坐标的地标。Skill 的说明要求 Agent 通过 SandBase 调用 M3.1 Flash,一次只写一个时代,effort 用 low。
这个任务比看上去难。一个回答要同时满足三件事:是符合特定 schema 的合法 JSON,历史上说得对,地理上还要在两个尺度上靠谱。小尺度是一座大教堂的一个点,大尺度是一段中世纪城墙的 20 个点组成的环。三件事里任何一件都可能单独翻车。Skill 文档里也提醒过:城墙张冠李戴、兜底轮廓偏出好几公里,都很常见。
我们挑了三段史料记载清楚的城墙:
| 城市 | 要求写的时代 | 指定地标 | 参考事实 |
|---|---|---|---|
| 巴黎 | 腓力二世·奥古斯都城墙 | 巴黎圣母院、卢浮宫要塞 | 1190–1213 年修建;围合 253 公顷(Wikipedia) |
| 罗马 | 奥勒良城墙 | 斗兽场、万神殿 | 公元 271–275 年奥勒良在位时修建;13.7 km²(Wikipedia) |
| 伊斯坦布尔 | 狄奥多西城墙 | 圣索菲亚大教堂、竞技场 | 狄奥多西二世时期;第一阶段由安特米乌斯主持,413 年完工(Wikipedia) |
所有请求的 system prompt 都一样,是 Skill 完整的 references/story.md。user prompt 也一样:只写一个时代对象,带 OSM 引用、12–30 个点的兜底多边形,以及上面指定的那两个地标。max_tokens 统一设为 16,000,全部通过 SandBase 兼容 OpenAI 的 Chat Completions 接口流式调用。最早跑过一轮非流式请求,几次长调用被断了连接,那一轮整体作废,所有配置都改成流式重跑。
参测模型和价格
五个模型都能在 SandBase 的 LLM 价格对比页上查到。下面是 10 月 23 日核对的 SandBase 标价,单位是每百万 token。
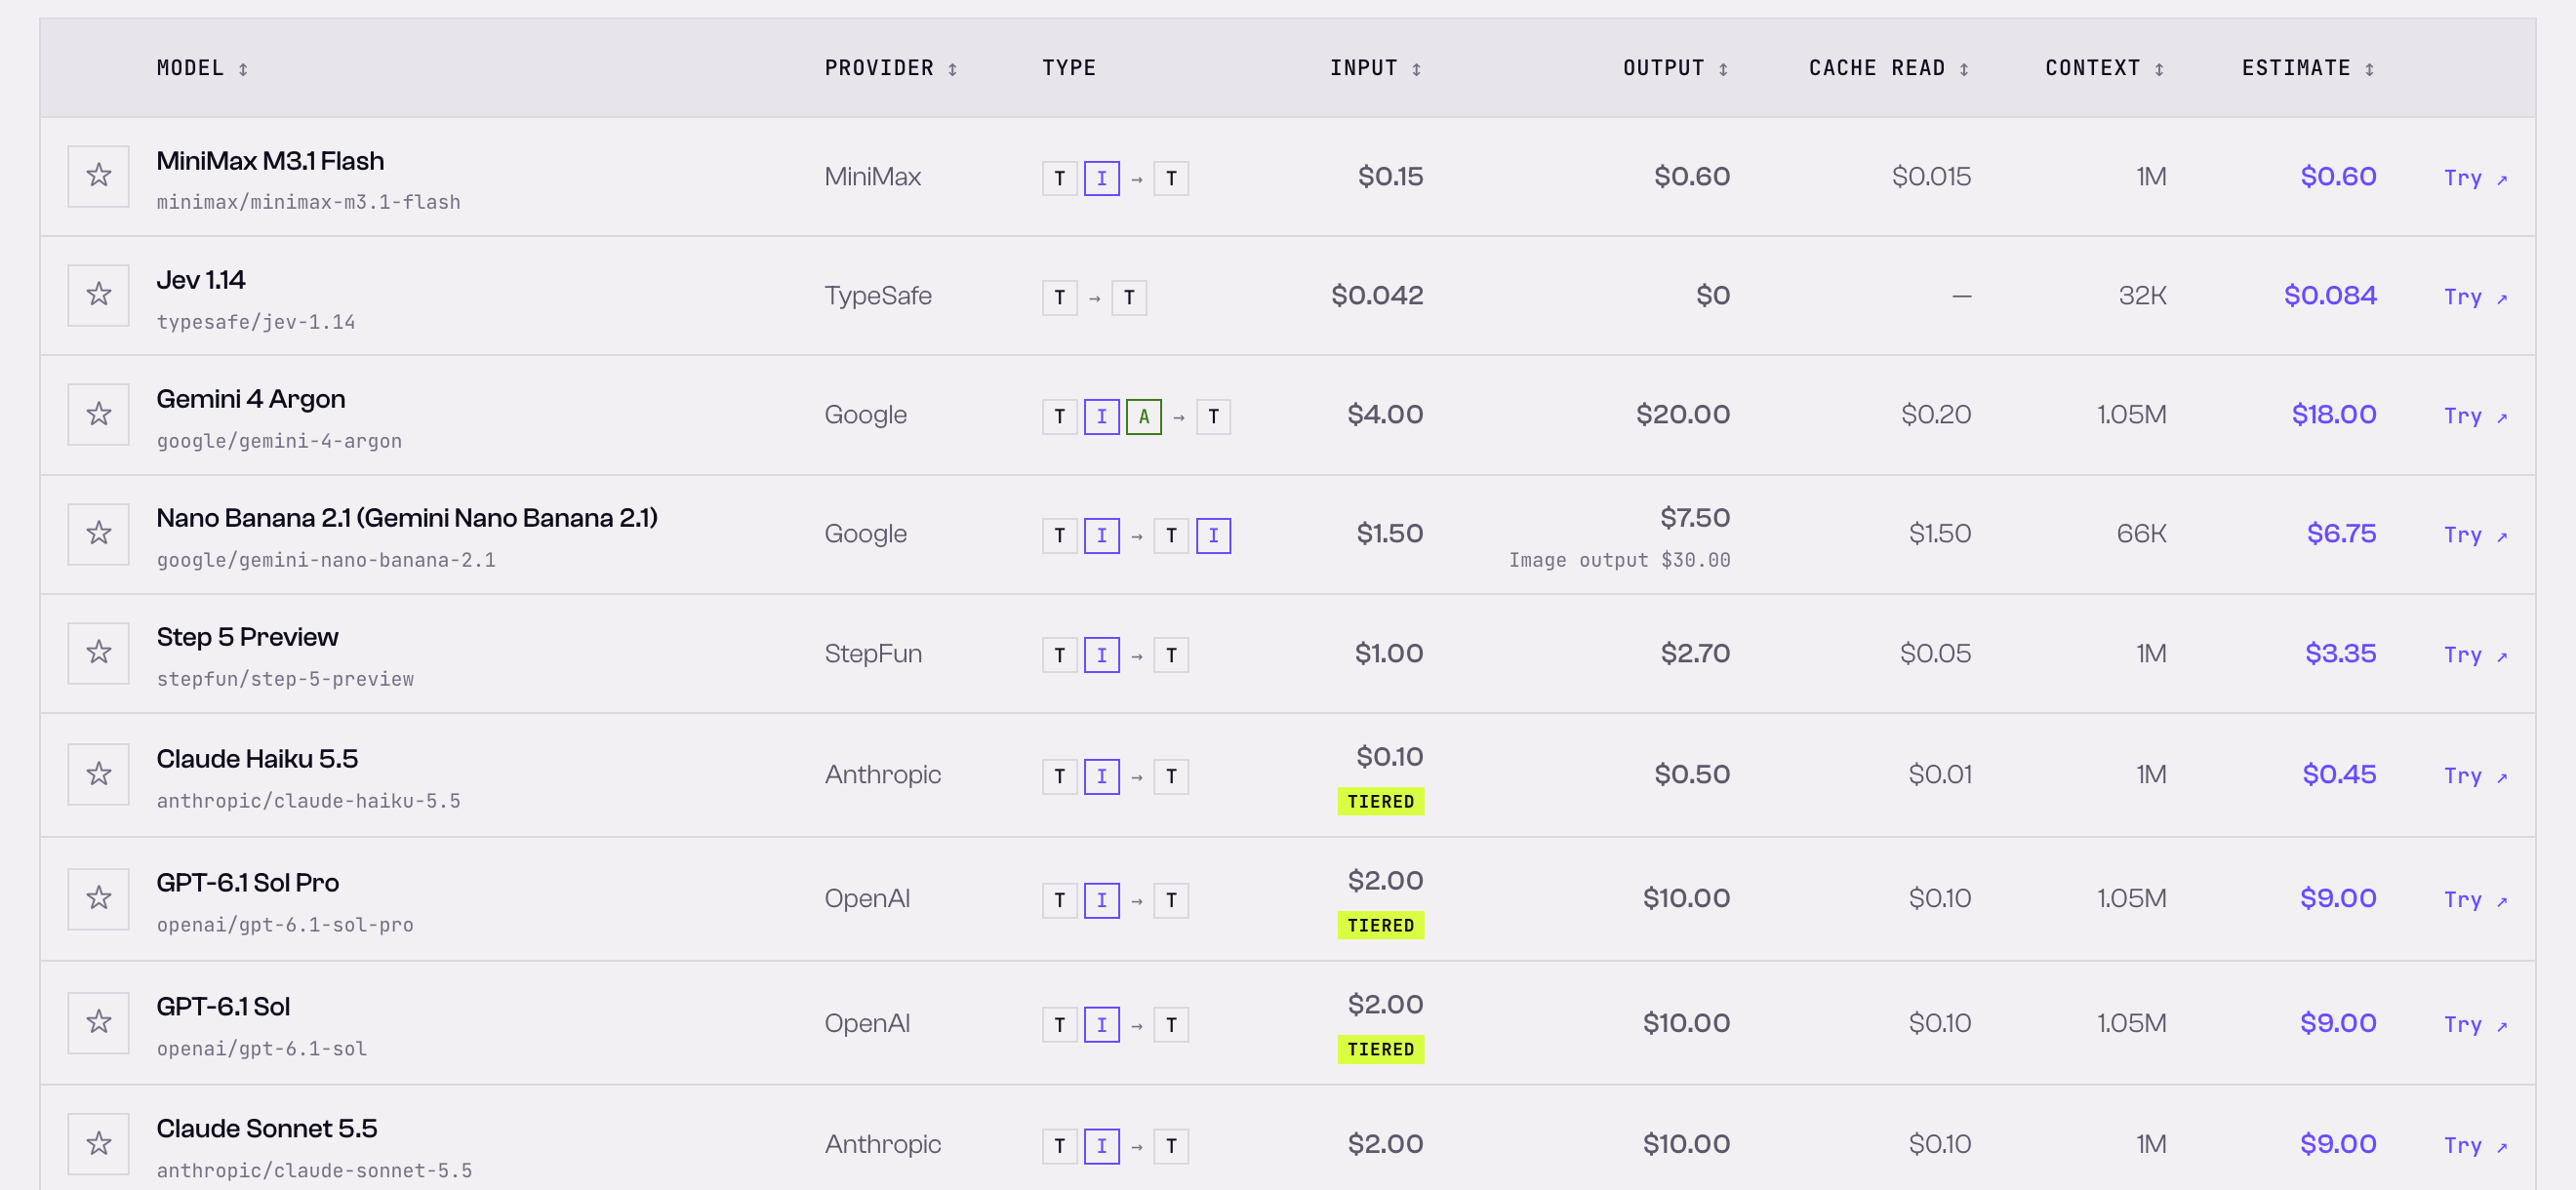 SandBase LLM 价格对比页,2026-10-23 截图(默认排序)。这一屏能看到 M3.1 Flash 和 Claude Sonnet 5.5,另外三个模型在同一页面下方。
| 模型(SandBase ID) | 输入 / 1M | 输出 / 1M | 跑了哪些配置 |
|---|---|---|---|
MiniMax M3.1 Flash(minimax/minimax-m3.1-flash) | $0.15 | $0.60 | low、默认 |
GLM-5.3-Flash(z-ai/glm-5.3-flash) | $0.15 | $0.50 | low、默认 |
DeepSeek V4.1 Flash(deepseek/deepseek-v4.1-flash) | $0.30 | $1.20 | low、默认 |
Gemini 3.8 Flash(google/gemini-3.8-flash) | $1.50 | $7.50 | 默认 |
Claude Sonnet 5.5(anthropic/claude-sonnet-5.5) | $2.00 | $10.00 | 默认 |
一开始,DeepSeek 和 GLM 只跑了默认档位。结果两者和 M3.1 Flash 一样把 token 耗光了,于是我们给它们各补了一轮 low。M3.1 Flash 用上了 Skill 推荐的档位,另外两个却只能用默认值,这样比对它们不公平。Gemini 和 Claude 没传 effort 字段,两者离上限都还很远。
结果:JSON 可用率、轮廓和成本
每个配置跑 9 次(3 座城市 × 3 次)。「可用」的意思是 Skill 自带的 validateStory() 接受了这个对象,resolve.mjs 能直接用。它只是格式门槛,不代表质量好坏。
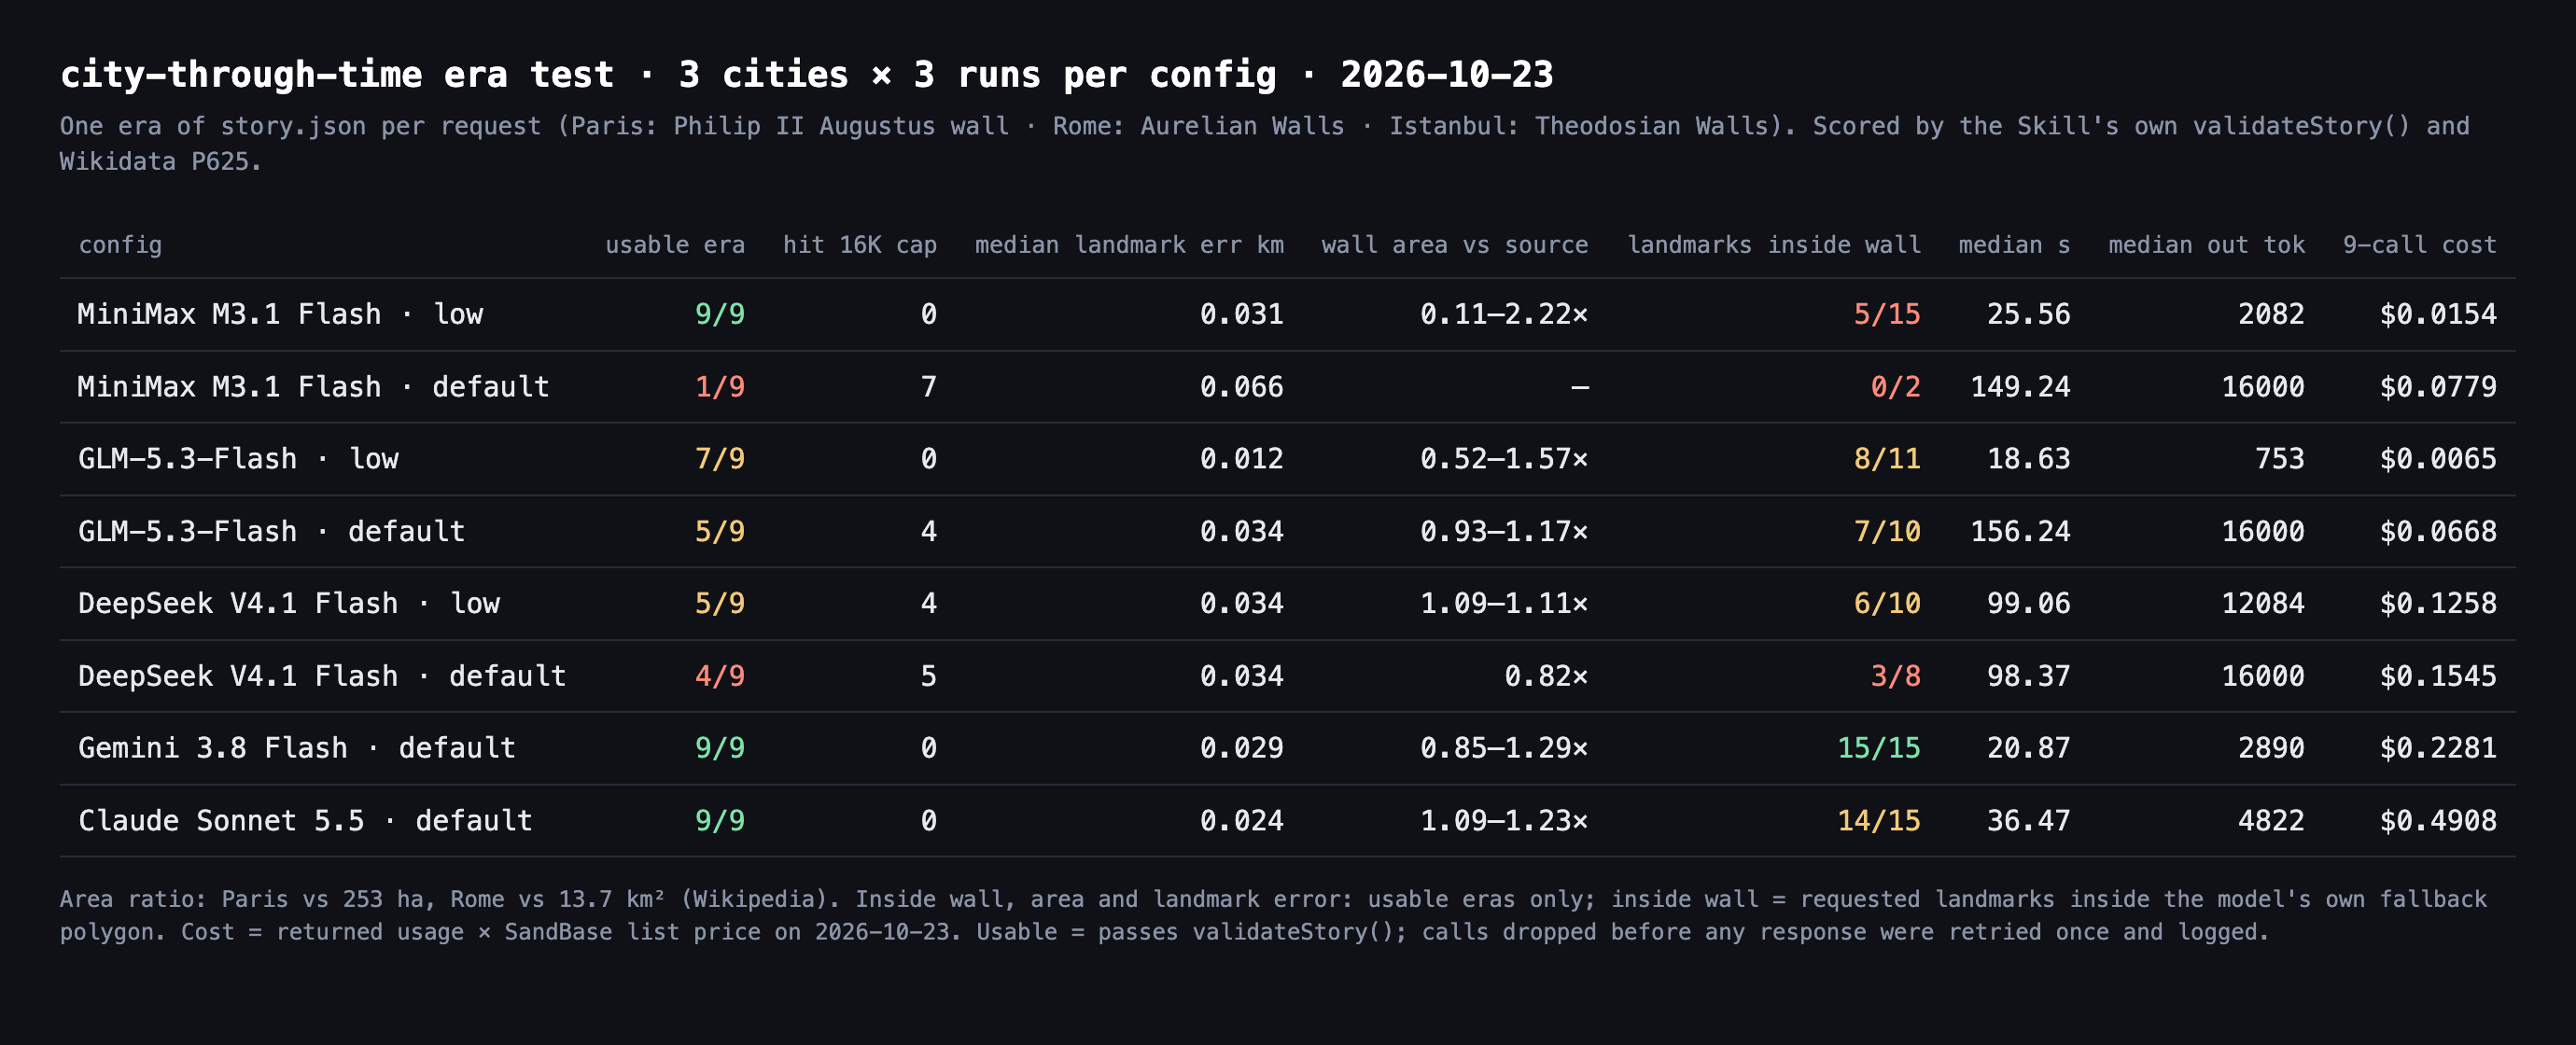 由
summary.json 渲染的结果总表,2026-10-23:八个配置共 72 个请求位;有两次在收到任何响应之前连接就断了,各重试一次,均有记录。
| 配置 | 可用 | 撞 16K 上限 | 地标在城墙内 | 城墙面积 / 史料 | 中位耗时 | 9 次成本 |
|---|---|---|---|---|---|---|
| M3.1 Flash · low | 9/9 | 0 | 5/15 | 0.11–2.22× | 25.6 秒 | $0.0154 |
| M3.1 Flash · 默认 | 1/9 | 7 | 0/2 | – | 149.2 秒 | $0.0779 |
| GLM-5.3-Flash · low | 7/9 | 0 | 8/11 | 0.52–1.57× | 18.6 秒 | $0.0065 |
| GLM-5.3-Flash · 默认 | 5/9 | 4 | 7/10 | 0.93–1.17× | 156.2 秒 | $0.0668 |
| DeepSeek V4.1 Flash · low | 5/9 | 4 | 6/10 | 1.09–1.11× | 99.1 秒 | $0.1258 |
| DeepSeek V4.1 Flash · 默认 | 4/9 | 5 | 3/8 | 0.82× | 98.4 秒 | $0.1545 |
| Gemini 3.8 Flash · 默认 | 9/9 | 0 | 15/15 | 0.85–1.29× | 20.9 秒 | $0.2281 |
| Claude Sonnet 5.5 · 默认 | 9/9 | 0 | 14/15 | 1.09–1.23× | 36.5 秒 | $0.4908 |
「地标在城墙内」统计的是:指定地标有没有落在模型自己画的兜底多边形里。巴黎只算圣母院,罗马和伊斯坦布尔两个地标都算。和地标误差、面积一样,这一项只统计可用回答,所以可用回答越少,分母越小。「城墙面积」只统计巴黎和罗马,伊斯坦布尔城墙内的面积我们没找到统一的史料数字。
发现一:起决定作用的是 effort,不是模型
表里影响最大的变量根本不是哪个模型,而是 effort 档位。
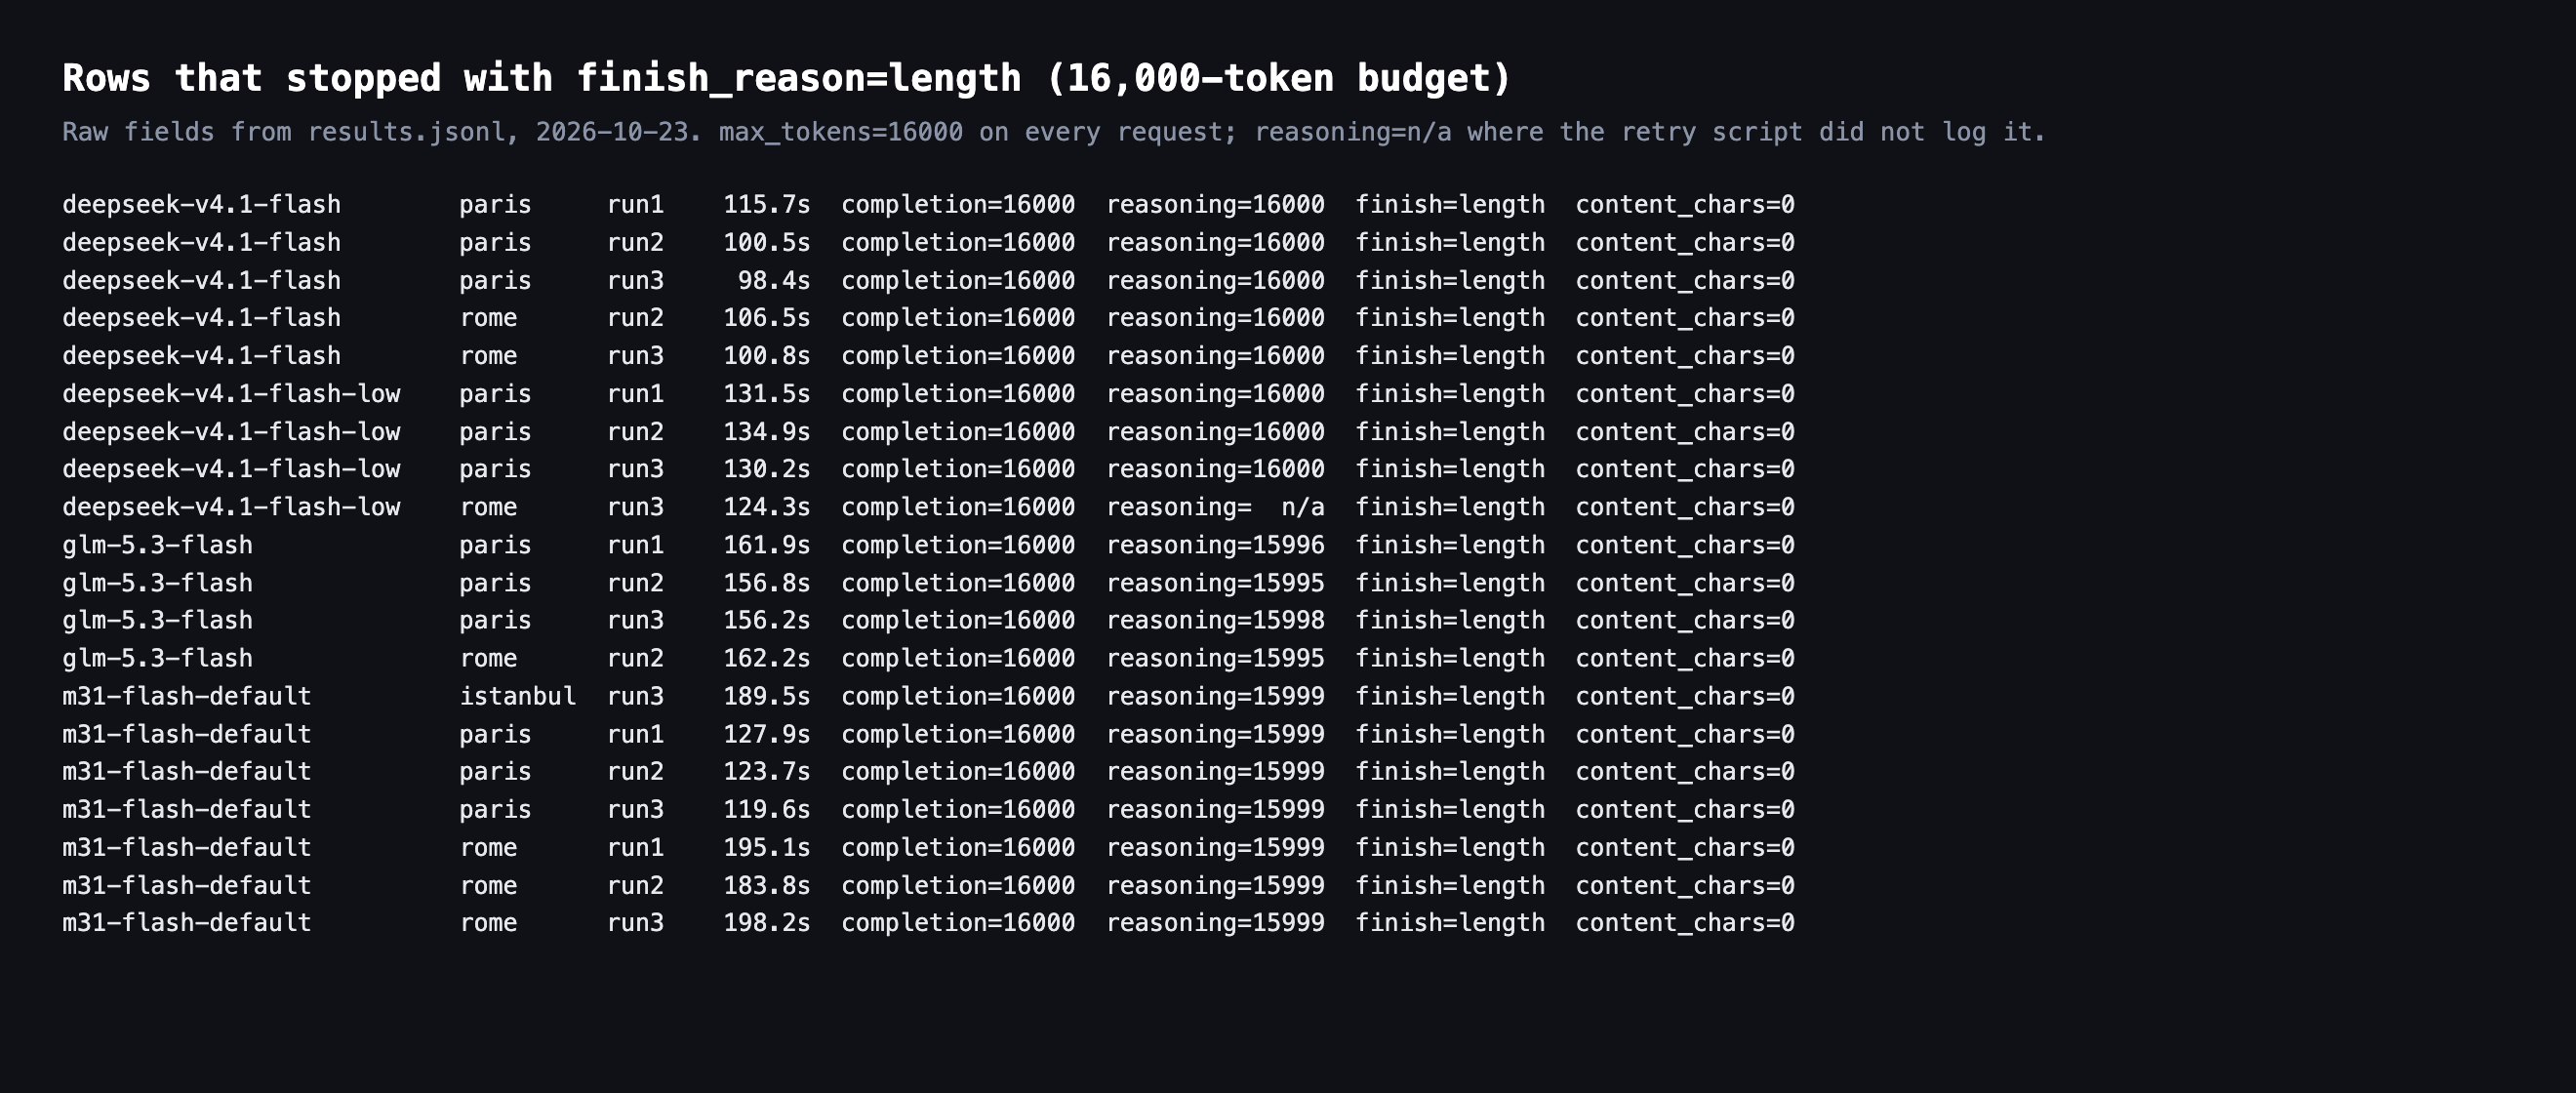
results.jsonl 里所有以 finish_reason: length 结束的行:16,000 个 token 几乎全花在思考上,一个字的正文都没返回。有一行重试记录没记下 reasoning,显示为 n/a。
原始数据里有三点很突出:
- 默认档位的 M3.1 Flash 根本没写到答案。 7 次请求停在 15,999 个 reasoning token,正文 0 字符,每次耗时 120–198 秒。还有 1 次流在 60 秒后关闭,没有正文,也没有 usage。MiniMax 文档写明,不传 effort 时默认是
max;在这个任务上,max 的意思就是整个额度都拿去想了。 - 换成 low,M3.1 Flash 和 GLM 都不再撞上限。 M3.1 Flash(low)的 completion token 中位数是 2,082,GLM(low)是 753,两者一次都没撞上限。
- DeepSeek V4.1 Flash 开了 low 照样撞线。 low 档下的三次巴黎请求全部在约 130 秒后停在 16,000 个 reasoning token,罗马也有一次如此。调低 effort 对伊斯坦布尔有效(3 次全部可用),对巴黎没用。
这还有一个实际操作上的影响。Skill 提醒过,同步请求超过两分钟左右,SandBase CLI 就会把它断开。我们日志里 20 次撞上限,有 14 次超过了两分钟。如果走 CLI,这些请求看起来会是超时,而不是空回答。遇到超时,先查 effort,再怪模型。
GLM 的默认档位有个怪现象。两次伊斯坦布尔请求返回的 completion token 超过了 16,000(17,073 和 21,033),却照样带着正文正常结束。这里只记录观察到的现象,上限为什么没生效,我们没查明白。
发现二:点好画,轮廓难画
知名地标的坐标不是问题。除了只有一个可用回答的 M3.1 Flash 默认档,各配置对照 Wikidata 的中位误差都在 12–34 米。所有可用的巴黎回答里,圣母院离 Wikidata 坐标都不到 8 米。最大的一次误差,是 M3.1 Flash 在一次伊斯坦布尔请求里把圣索菲亚大教堂放偏了 1.14 公里。
各模型真正拉开差距的是兜底多边形,而这恰恰是观众在屏幕上看得见的部分:OSM 里查不到模型给的城墙名时,影片就会点亮模型自己画的多边形,还会把面积打在屏幕上。
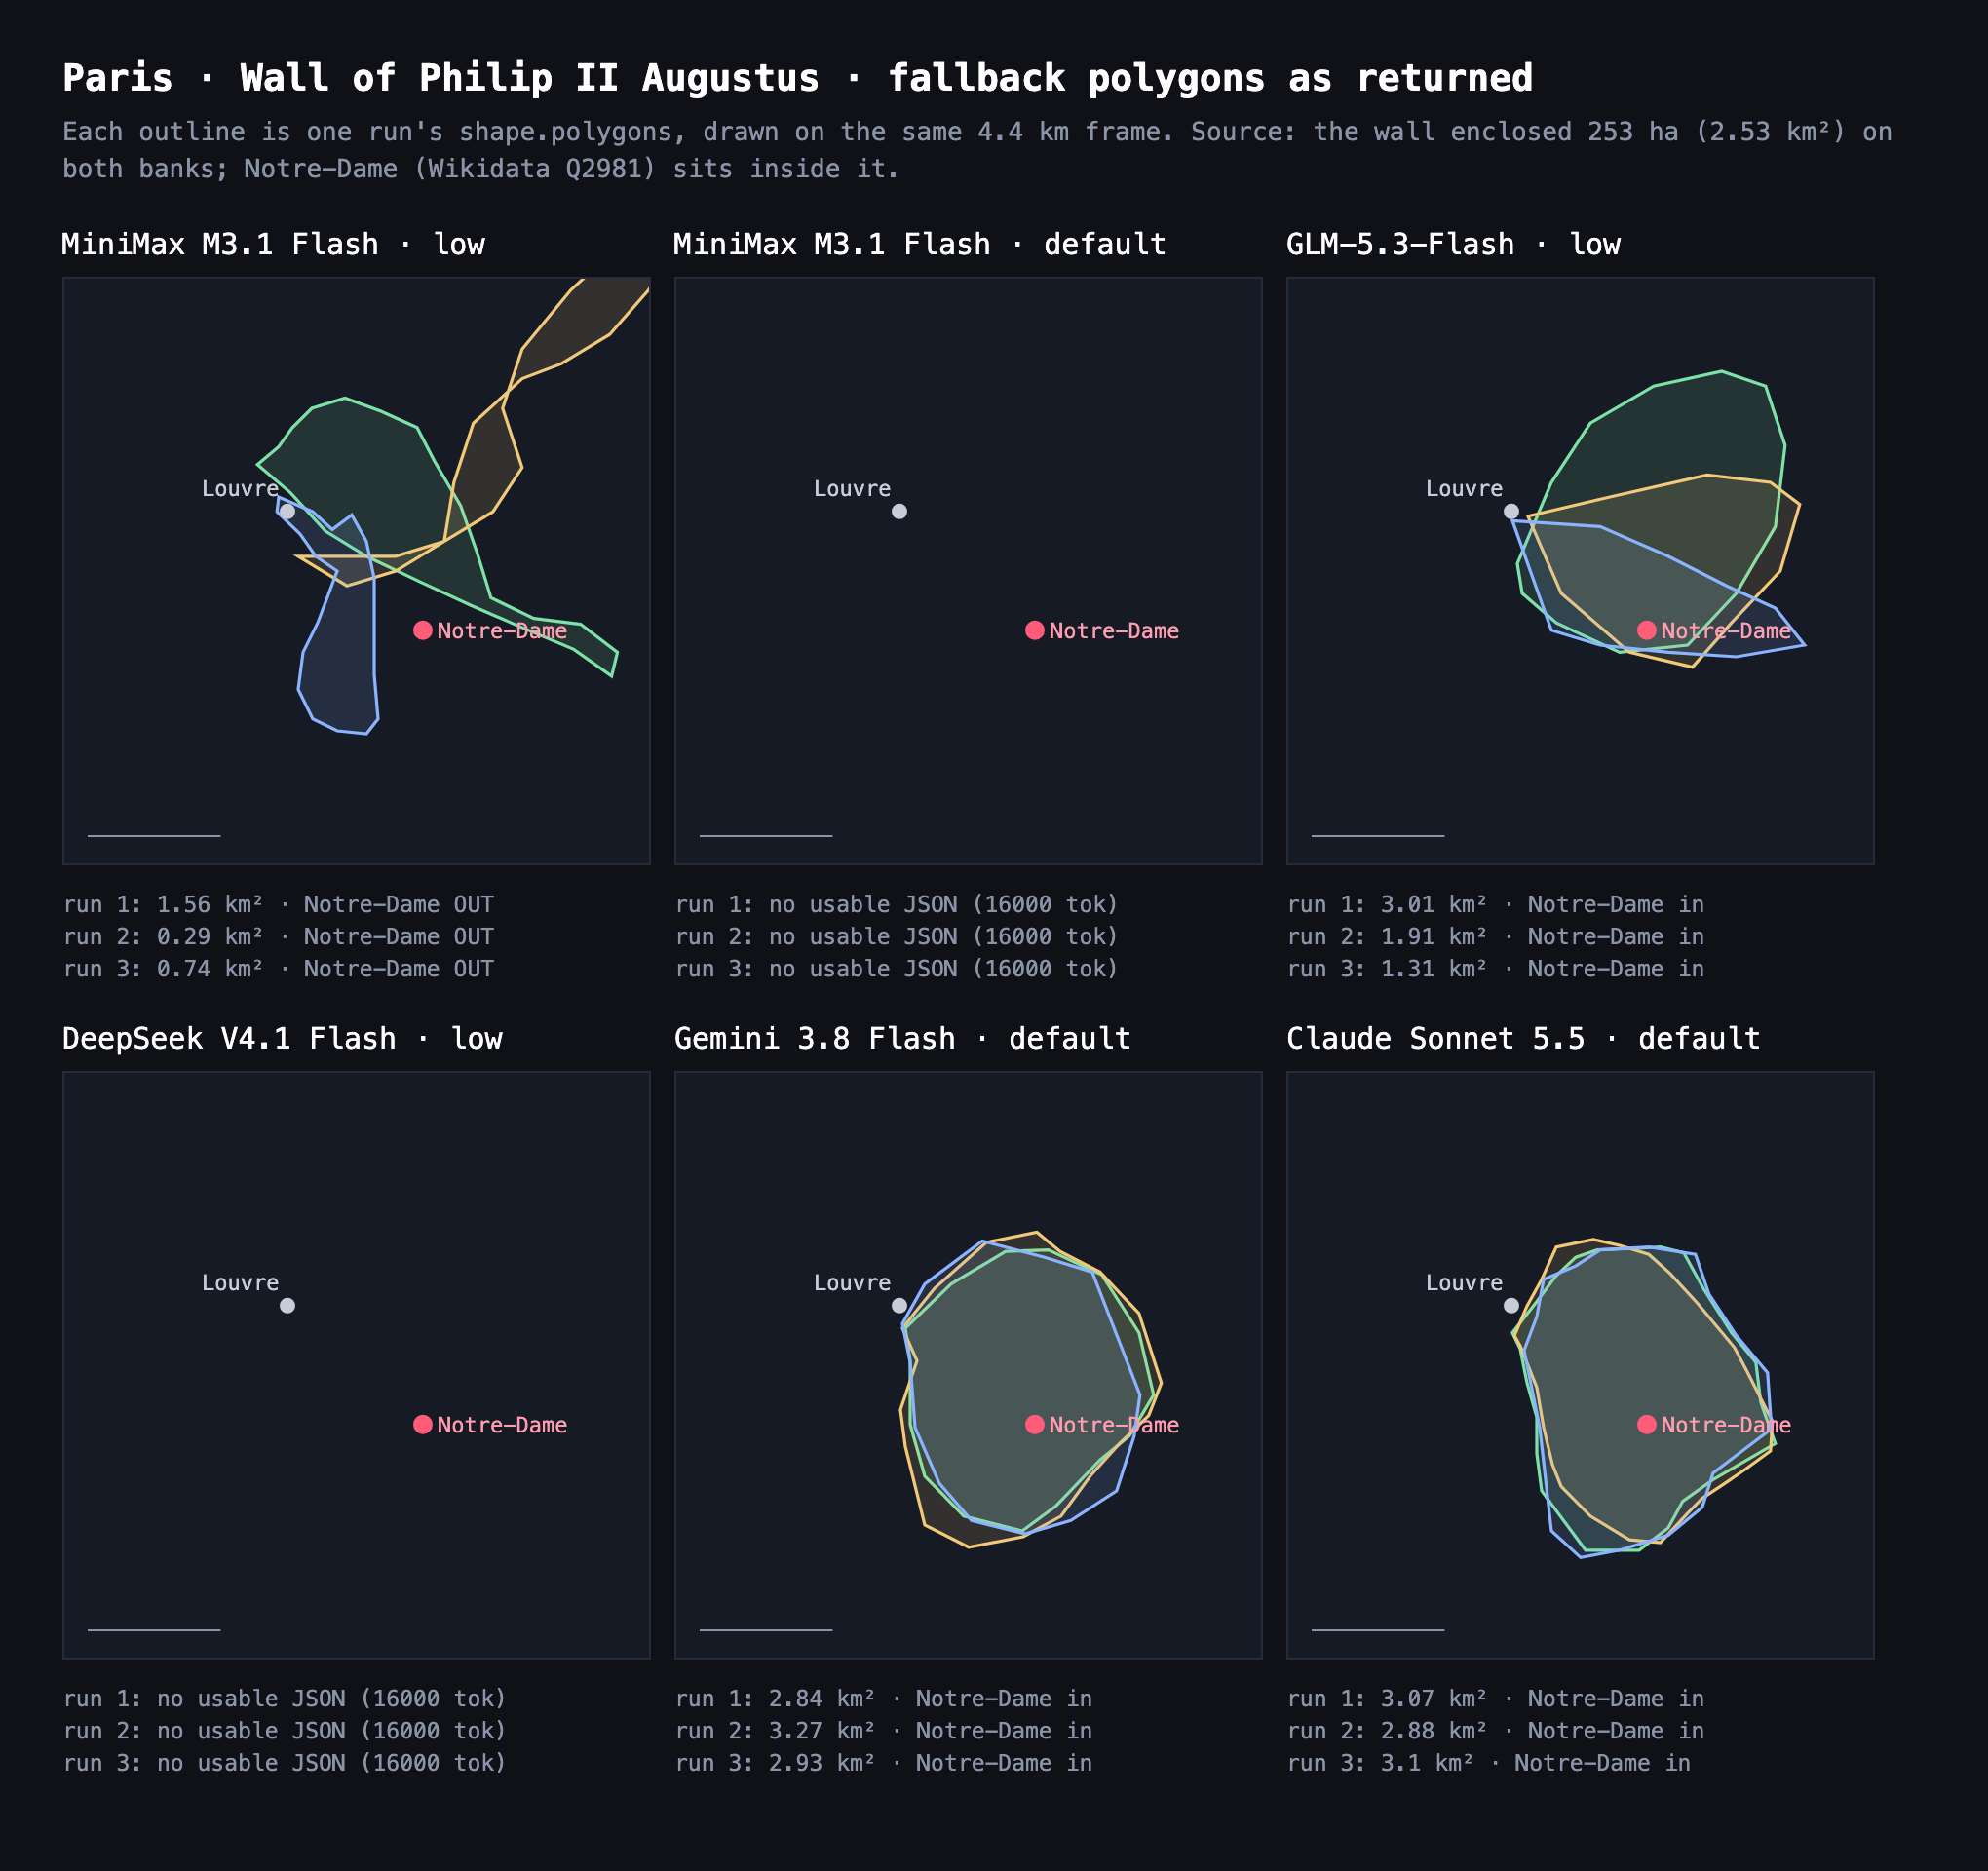 每个配置返回的所有巴黎多边形,画在同一个 4.4 公里见方的画框里。Gemini 3.8 Flash 和 Claude Sonnet 5.5 画出的环稳定在 2.8–3.3 km²,都围住了圣母院;M3.1 Flash(low)三次画了三个不同的形状,没有一个框住它。
从面板里能看出规律:
- M3.1 Flash(low) 每次都返回合法 JSON,但巴黎的环只有 0.29–1.56 km²,史料记载是 2.53 km²。三次都没框住圣母院,可圣母院在西岱岛上,本来就在真实城墙以内。罗马有一次面积是真实值的 2.22 倍。伊斯坦布尔三次都没框住圣索菲亚。
- GLM-5.3-Flash(low) 每次都框住了圣母院,但形状每次都不一样(1.31–3.01 km²)。
- Gemini 3.8 Flash 和 Claude Sonnet 5.5 每次都很稳定,大小也接近史料:分别是史料面积的 0.85–1.29 倍和 1.09–1.23 倍。两者在巴黎都略微偏大,沿着现代街道描城墙,偏大是意料之中的。
年份和人名各家基本都对。所有可用回答都说对了修建者。唯一一次年份出错,是 M3.1 Flash 有一次把狄奥多西城墙写成「c. AD 440」,而城墙在 413 年就完工了。它另外两次写的是「408–439」,这样的年份区间,没有出处的话我们不会放上屏幕。
这条发现的范围:三段城墙,每段跑三次,同一天。换一段模型不熟的城墙,或者换一座 OSM 覆盖稀疏的城市,排名可能会变。
发现三:每个可用时代的成本
失败的请求往往烧掉最多的 token,所以看单次调用的价格会被误导。用每个配置的总花费除以可用时代数,数字更公平:
| 配置 | 每个可用时代的成本 | 备注 |
|---|---|---|
| GLM-5.3-Flash · low | ≈ $0.0009 | 最便宜;9 次里有 2 次没过校验(stat 超过 60 字符,旁白超过 300 字符) |
| MiniMax M3.1 Flash · low | ≈ $0.0017 | 次次都是合法的纯 JSON;轮廓靠不住 |
| DeepSeek V4.1 Flash · low | ≈ $0.025 | 开 low 也想得很久 |
| Gemini 3.8 Flash · 默认 | ≈ $0.025 | 本次测试轮廓最好,成本是 M3.1 Flash low 的 15 倍 |
| Claude Sonnet 5.5 · 默认 | ≈ $0.055 | 质量和 Gemini 接近,成本约为 Gemini 的 2 倍,也更慢 |
| DeepSeek V4.1 Flash · 默认 | ≈ $0.039 | 9 次有 4 次可用 |
| MiniMax M3.1 Flash · 默认 | ≈ $0.078 | 9 次只有 1 次可用 |
换算一下:一个完整的 8 时代城市故事要发 9 次请求。按 M3.1 Flash low 的价格,大约 $0.015;我们那份维也纳故事,旁白加插图估价约 $0.69。就算用 Claude 写,脚本也就 $0.50 左右,还是比媒体便宜。所以只做一部片子的话,脚本成本不是决定因素,轮廓质量和失败率才是。
怎么选,参赛者该怎么做
| 你的需求 | 选择 | 理由 |
|---|---|---|
| 参加 AI City Remix | MiniMax M3.1 Flash,reasoning_effort: "low" | 规则要求它当导演;开 low 时 9/9 可用 |
| 大批量、最便宜的合法 JSON | GLM-5.3-Flash low 或 M3.1 Flash low | 每个时代都不到 $0.002;用 GLM 要加一步 schema 修复 |
| 不用重画就能上屏的轮廓 | Gemini 3.8 Flash 或 Claude Sonnet 5.5 | 巴黎和罗马各自 6 次,轮廓都稳定、大小合适 |
| 模型容易想太久 | 哪个都行,但必须显式设置 effort | 五个模型里有三个,默认档把额度烧光了 |
如果你要参加 AI City Remix,导演继续用 M3.1 Flash,但别再信它画的兜底多边形,只把它当占位符。让 OSM 引用来干活:用城墙在 OSM 里的真实名称,或者写一个正则,匹配沿旧城墙走向修的那几条大道。然后在 resolve.mjs 的输出里确认,轮廓来自 OSM,而不是兜底。地标方面,M3.1 Flash 给知名地点的坐标没问题,但每个地标换成 Wikidata 的值只要一次请求,风险就没了。把这一步自动化,也正好对上 30% 的 AI 工作流评分。
这次测试有两件事说明不了。第一,它没比较旁白和讲故事的水平,而评委在这一项上给了 25%。第二,它和长链路 Agent 任务、写代码都无关,厂商跑分里这几个模型在那些任务上的排序并不一样。相关内容见我们的 M3.1 Flash 价格与跑分指南 和 M3.1 Flash 对比 DeepSeek V4.1 Flash。
常见问题
哪个模型写 city-through-time 脚本最准?
在 2026 年 10 月 23 日的 72 个请求位里,Gemini 3.8 Flash 和 Claude Sonnet 5.5 的城墙轮廓最准,9 次全部可用。MiniMax M3.1 Flash 开 low 同样 9 次可用,成本只有它们的 1/15 到 1/32,但兜底轮廓经常大小不对、形状不对。
MiniMax M3.1 Flash 为什么会返回空答案?
默认档位,也就是 MiniMax 文档里的 max,9 次请求里有 7 次把 16,000 个 completion token 全用在了思考上,还没开始写正文就以 finish_reason: length 结束了。把 reasoning_effort 设为 "low" 之后,9 次全部正常。
AI City Remix 能用 Gemini 或 Claude 吗?
不能拿它们当导演。规则要求作品通过 SandBase 用 MiniMax M3.1 Flash 导演,上传时要勾选声明。FAQ 允许围绕它搭任意工具链(Skill 本身就会调用语音和图像模型),但让另一个 LLM 来写脚本,就等于换掉了导演。想要更准的几何数据,就从 OpenStreetMap 和 Wikidata 里取轮廓和坐标。
脚本和影片的成本比起来怎么样?
8 个时代的故事,用 M3.1 Flash(low)写,我们测出每个可用时代约 $0.0017,一份脚本约 $0.015。我们那份维也纳故事,Skill 对旁白加插图的估价是 $0.69。
这能算这几个模型的通用评测吗?
不能。这只是一个结构化的地理类任务,三座城市,每个配置跑三次,同一天完成,程序自动打分。它反映的是模型在这类写 JSON 任务上的表现,不代表模型的整体水平。
对参赛者来说,模型已经定了,这次测试说的是怎么把它用好。M3.1 Flash 开 low,在这个任务上又稳又几乎不花钱。它最弱的是轮廓和坐标,所以这两样从数据里取,不要靠它的记忆。比赛之外,如果地理信息要一次渲染就能上屏,Gemini 3.8 Flash 是这次测试里性价比最高的选择。