KeywordScout 指南:把选题变成有数据依据的内容优先级
拆解 SandBase KeywordScout 如何组合模型头脑风暴、Google Ads 数据与 DataForSEO 难度,避免凭空捏造搜索需求。
做内容规划最危险的捷径,是让语言模型同时编关键词和搜索量。词看起来像真的,数字也很精确,但两者都可能没有真实需求支撑。
SandBase KeywordScout 把工作拆开:模型先发散查询与主题簇,Google Ads 提供相关词、月搜索量、CPC 与广告竞争度,DataForSEO Labs 再补充 SEO 难度,最后由模型去重并给出优先级。它适合编辑、增长团队和独立开发者做“少而准”的选题表,而不是堆 100 个没人负责的标题。
先说结论
- 单次最多整理 100 个关键词,并提供 12 个月趋势。
- 页面提供 4 类搜索意图与 11 个市场/语言预设。
- 搜索量和 CPC 来自 Google Ads,经 DataForSEO 返回。
- SEO 难度与广告竞争度是两套指标,不能混用。
- 没有实测数据时,页面会标成 AI 估算,而不是伪装成事实。
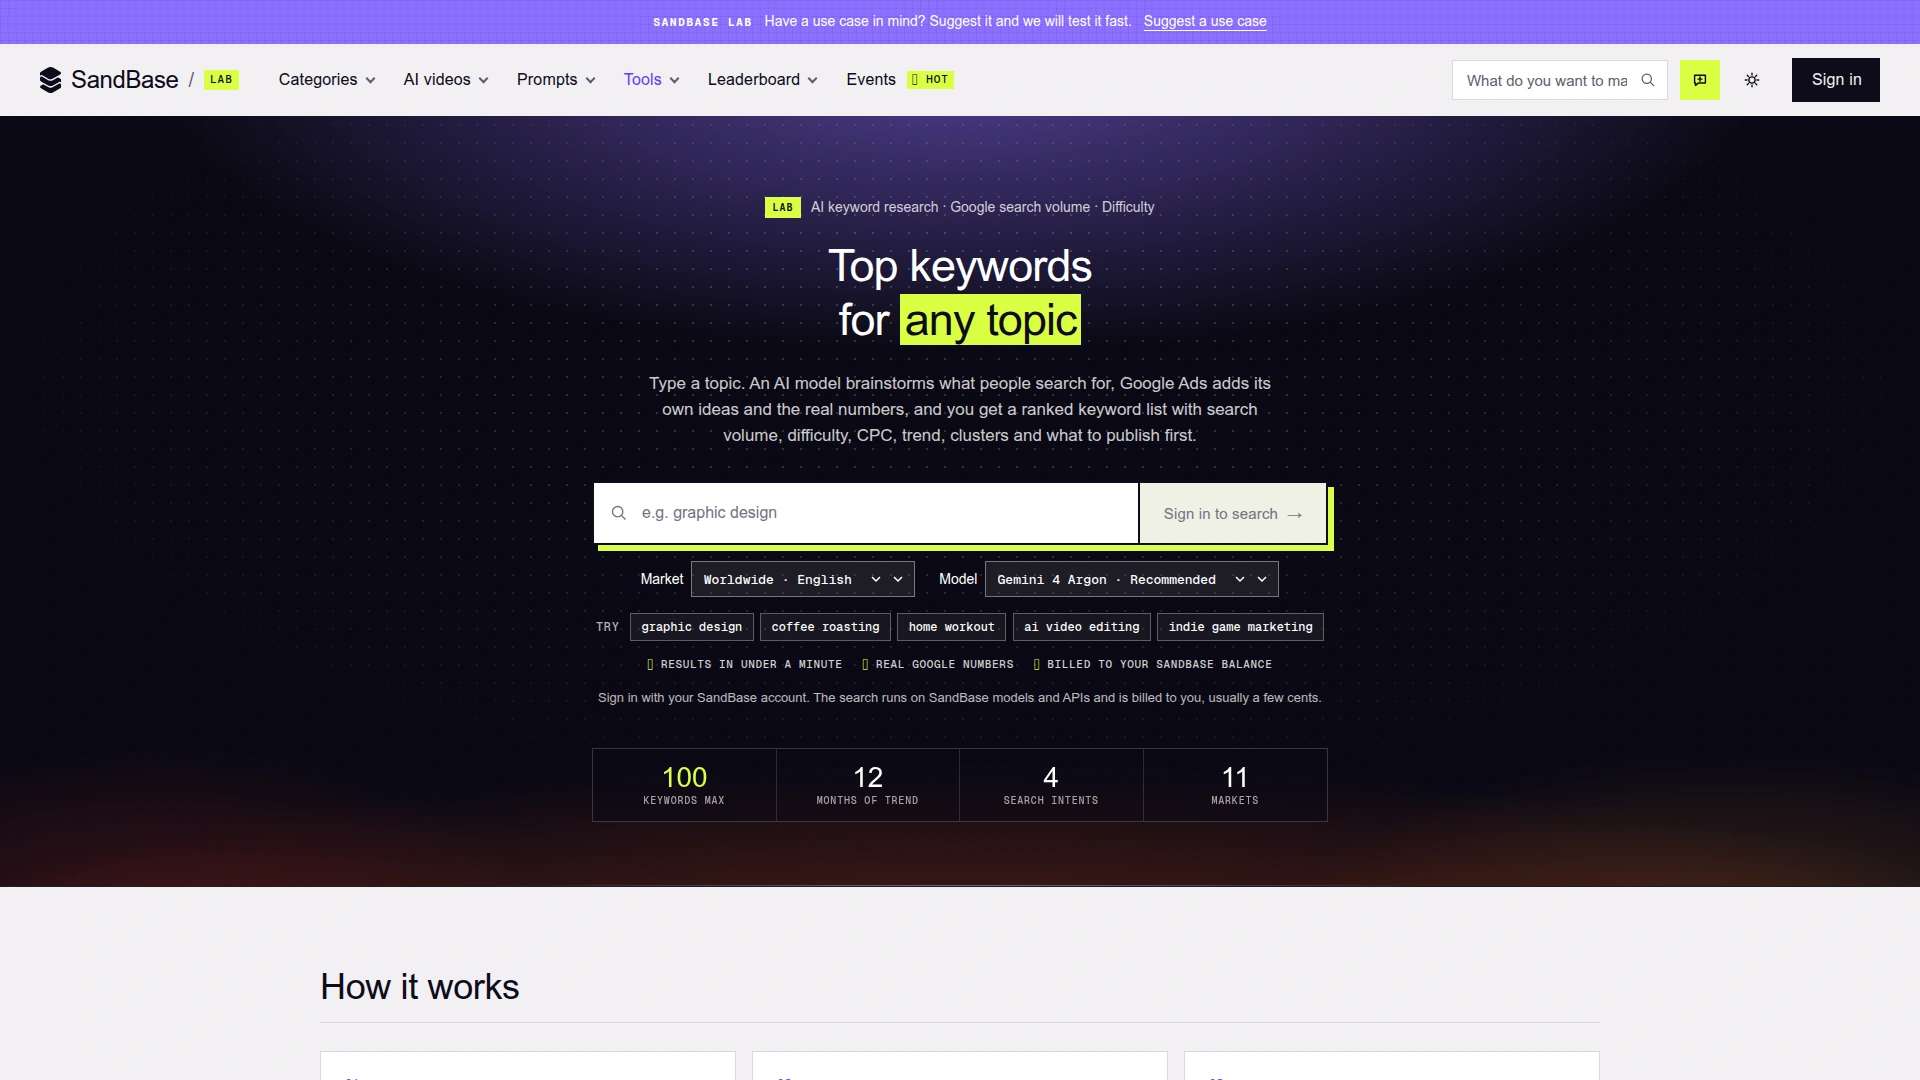 2026-11-02 核验的公开页面。运行前可选择主题、市场和模型,并明确写明费用计入 SandBase 余额。
为什么要拆成三步
头脑风暴负责找语言,测量负责判断是否存在可观察需求,编辑判断负责决定是否值得做成页面。三步混在一起,最容易出现“高搜索量但不是目标用户”“低难度但没有转化路径”的假机会。
| 阶段 | 来源 | 作用 |
|---|---|---|
| 发散 | SandBase 模型 + Google Ads 词建议 | 生成查询、主题簇与意图 |
| 测量 | Google Ads / DataForSEO | 搜索量、CPC、广告竞争度与趋势 |
| 测量 | DataForSEO Labs | 批量 SEO 难度 |
| 取舍 | 所选模型 | 去噪、去重、标题与切入角度 |
页面当日可选 Gemini 4 Argon、GPT-6.1 Sol、Claude Sonnet 5.5 与 GPT-6 Luna。这只是执行选择,不是能力排行榜。 measured columns 已经承担大部分筛选时,便宜、快速的模型可能就够用。
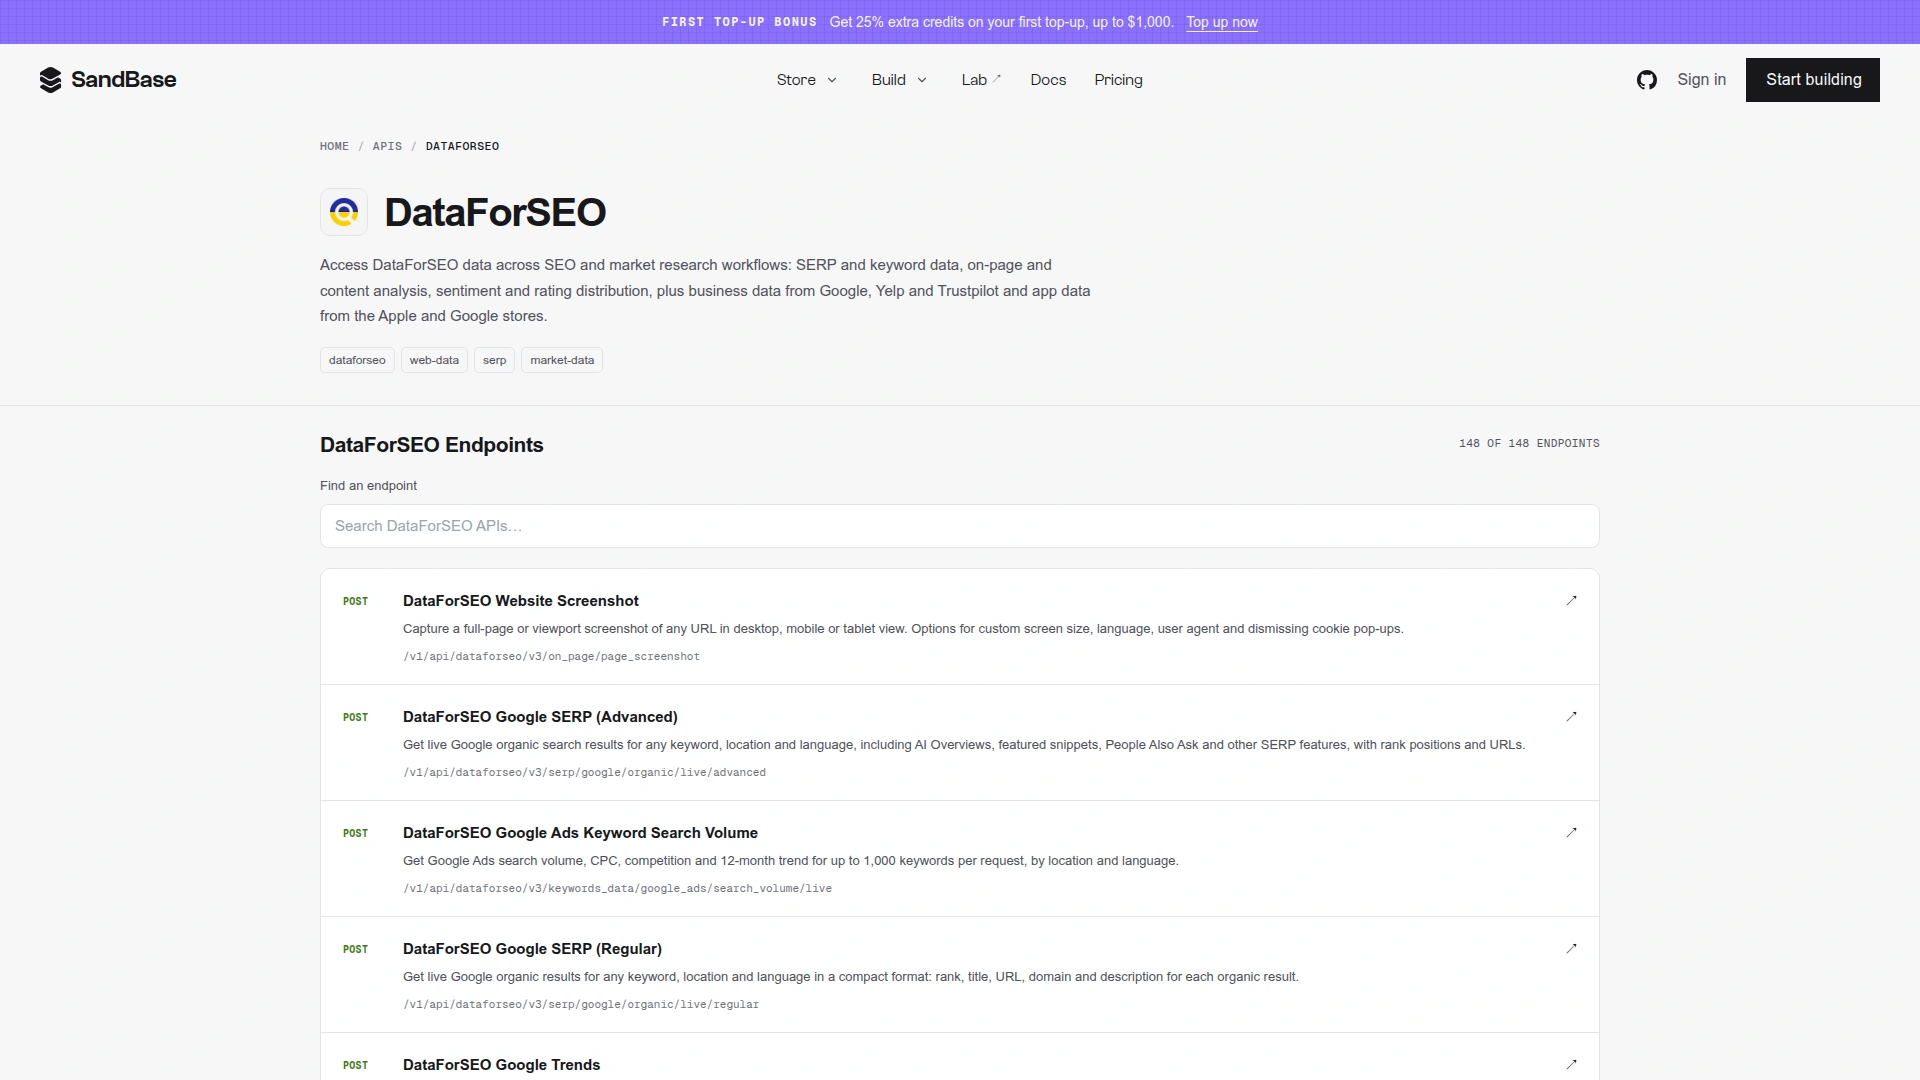 DataForSEO 目录是可复用的 API 层。KeywordScout 只调用其中 3 个端点,并不等于使用目录里的全部能力。
三个 API 依赖
| 端点 | 用途 |
|---|---|
keywords_for_keywords/live | 相关词与测量字段 |
search_volume/live | 搜索量、CPC、广告竞争度、月度趋势 |
bulk_keyword_difficulty/live | 批量自然搜索难度 |
这些能力可通过 POST /v1/api/<model> 接入工作流,业务数据位于已完成响应的 outputs[0].data。如果这个路径缺失,代码应直接报错。更深层字段仍然保留 DataForSEO 的 provider shape,上生产前要用带日期的真实响应验证。
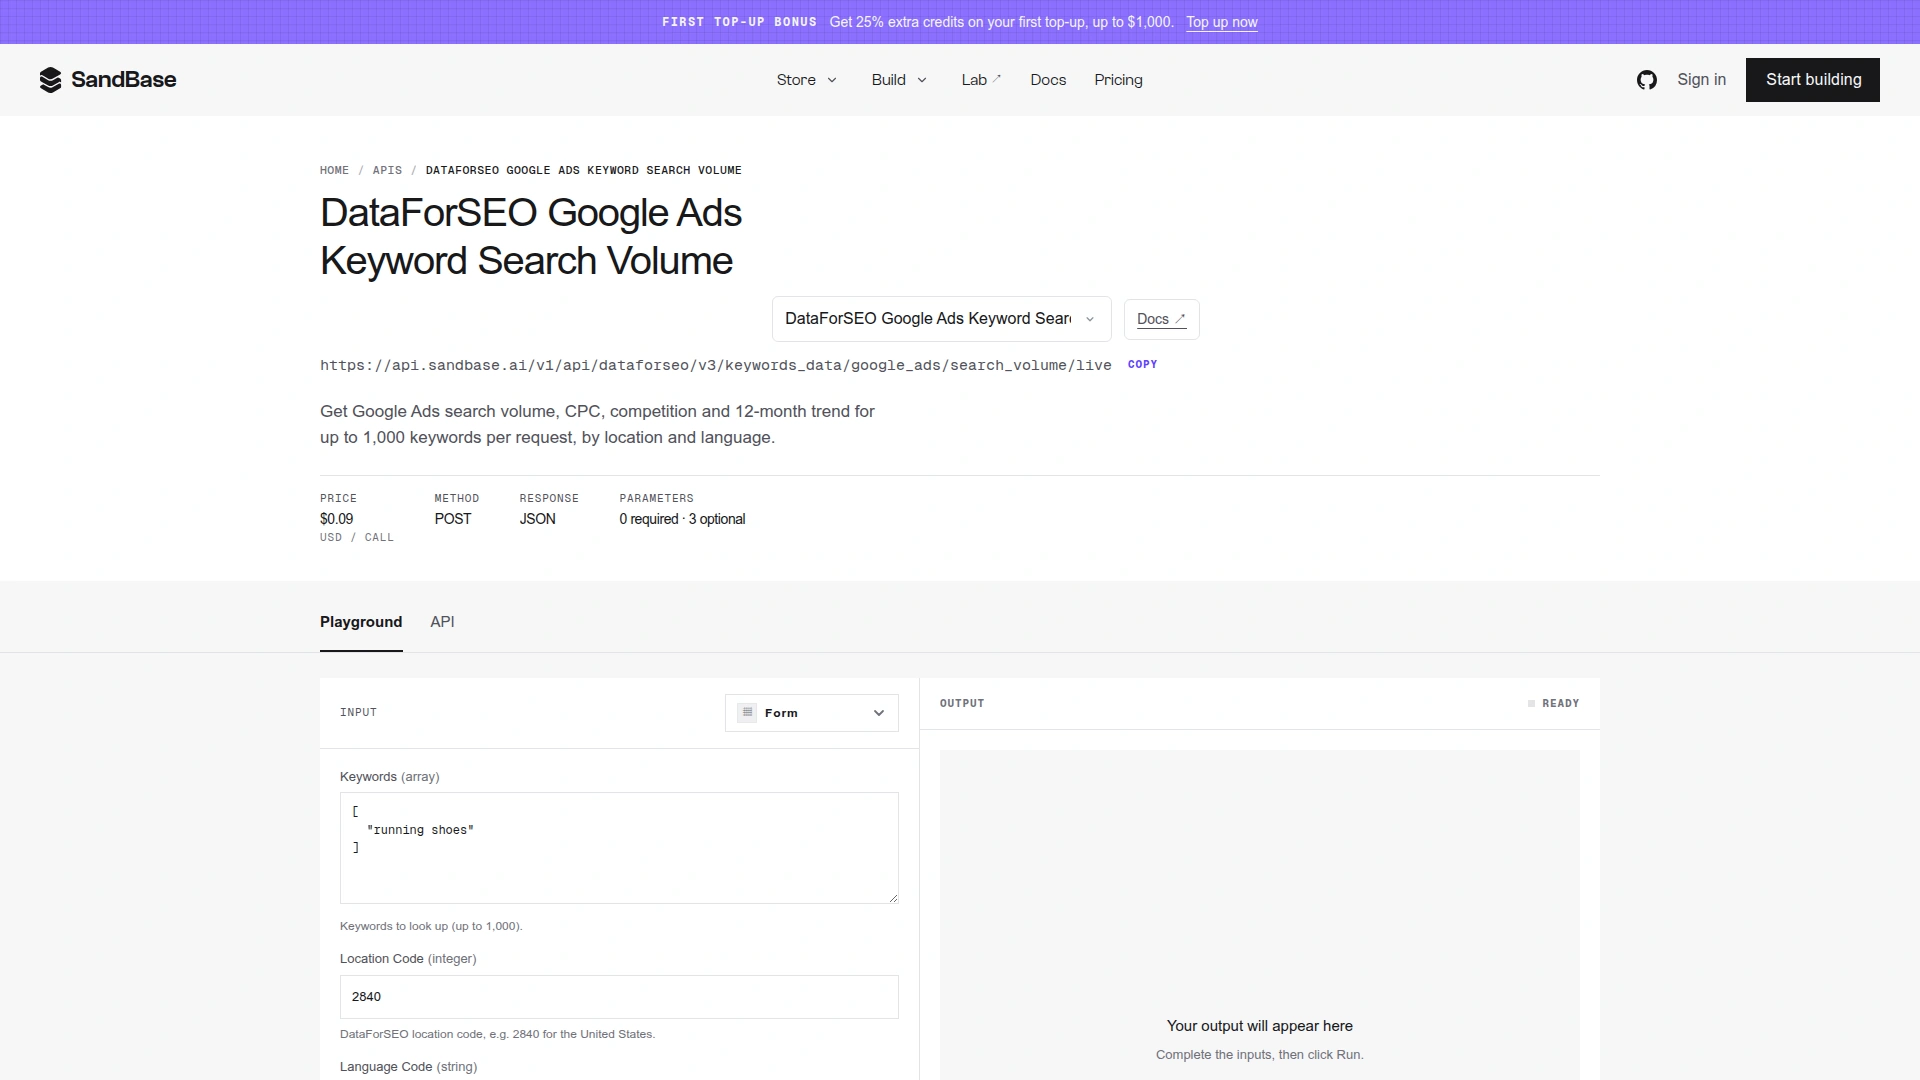 直接端点页记录生产路由与请求结构。需要定时运行、保存历史或批量处理时,应从 Lab 迁移到 API。
怎么选出真机会
先删掉不服务目标读者或产品的词。再看意图:信息型词与购买对比词即使搜索量相同,也不是同一篇文章。接着看趋势,12 个月平均值可能被某个热点月份拉高。然后把难度与网站现有权重、覆盖文章对照。最后确认页面能把读者带到明确的下一步,而不是写完就结束。
一份可审计的选题表至少保留市场、语言、抓取日期和数据源。不要把“12,100 次搜索”写成普查数字;Google Ads 数值是取整后的估算。CPC 反映广告竞价,不保证商业价值。难度分也是模型化指标,不承诺能否排名。
下一步可以参考 DataForSEO 关键词调研 Agent与网页搜索 API 指南,先查重,再批准 brief。
生产清单
- 比较前固定市场与语言。
- 原样保存测量字段和抓取日期。
- 明确区分实测值与 AI 估算。
- 按读者任务去重,不只按字符串去重。
- 已有 canonical 页面能回答的词直接跳过。
- 每个独立意图只写一个 brief,并确定产品落点。
- 发布前重查真实 SERP;表格是证据,不是全部市场。
常见问题
搜索量是精确值吗?
不是。页面说明它来自 Google Ads 的 12 个月平均月搜索量,并保留 Google 的取整方式。
广告竞争度和 SEO 难度一样吗?
不一样。前者看广告主竞争,后者估算自然搜索竞争。
KeywordScout 能保证流量吗?
不能。它帮助排研究优先级,排名与流量仍取决于页面、网站、竞品和时间。
最后判断
KeywordScout 的价值,是不让一个模型假装同时知道语言和需求。发散、测量、编辑取舍彼此分开,数字也保留来源。用它少写几篇没有读者的文章,通常比多生成 100 个标题更划算。