怎么做可检索的 GLB 资产库?12 条来源实测
用 SQLite 管理生成的 GLB,实测 12 条来源的哈希去重、派生关系和体积筛选,展示真实模型缩略图。
同一份图生 3D 文件可能在模型对比、费用实验和交付目录里各出现一次。资产库要保留这些来源记录,文件本身只需要存一份。我们把 12 条真实来源记录导入 SQLite,得到 8 份不同的 GLB,其中四组是逐字节相同的重复文件。两份本地优化过的版本保留独立身份,同时关联到原件。下面用实际数据库、筛选结果和渲染缩略图走完这套流程。
先说结论
- 如果 12 条来源记录各存一份 GLB,累计 74,819,416 字节。每份不同文件只存一次,合计 58,438,100 字节。本批理论上可少存 16,381,316 字节,约 21.9%,还需另计数据库、缩略图和存储服务的开销。
- 文件用完整 SHA-256 去重,来源标签单独存。缩贴图的长椅和优化后的机器人都有自己的哈希,并保留到原件的关系。
- 筛选长椅且不超过 4,000,000 字节,得到三份不同的 GLB。三份都能渲染,在所示角度里只有一份保留可辨认的完整靠背和椅腿。
- 同一清单重跑时,输出 JSON 完全一致。父文件引用缺失时,导入事务回滚,原有快照保留。
1. 分开记录文件、来源和派生关系
模型名和主体可以用于筛选,但很难当文件主键。TRELLIS 的原始长椅有 3,981,800 字节和 11,222 个三角面。同一个模型后来又跑了一次,长椅有 4,491,860 字节和 13,765 面。若用路线和主体当唯一键,两个可以对比的结果就会被覆盖。与此同时,原始长椅在对比实验和预算实验里各存了一份,文件名不同,字节一致。
可以用三张表。资产表记录完整 SHA-256、文件字节、三角面和内嵌图片数。来源表记录路径、可读名称、主体和生成路线。派生关系表把派生件的哈希连到原件哈希,两个端点都必须存在于资产表。若有生成任务 ID 或输入图哈希,可以加在来源表里,追溯哪次请求或导入得到这份文件。本文用一份本地清单和完整文件哈希演示。 Python hashlib 文档 · SQLite 外键文档
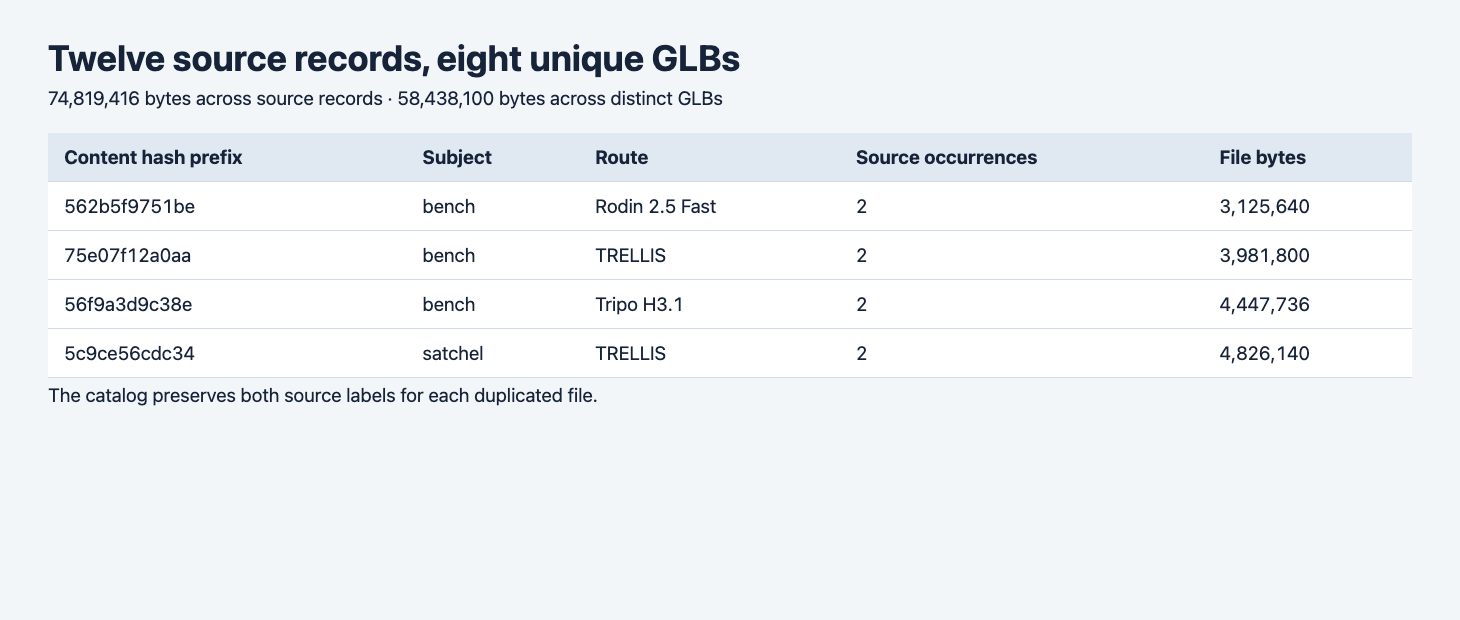
浏览器表格从实跑输出生成。截图仅显示哈希前缀,数据库保存并比较完整哈希。
2. 写一份含原件和派生件的清单
使用 Python 3.11 或更新版本,准备一个专用的 SQLite 数据库文件,无需安装第三方 Python 包。将下面的 JSON 保存为 sources.json。文件路径相对清单所在目录。准备两份逐字节相同的原件,以及一份确实发生变化的派生件。本文的 12 条证据记录来自 TRELLIS 实测、预算路线实测、移动端 GLB 优化实测 及其关联对比。
[
  {
    "label": "Bench original",
    "subject": "bench",
    "route": "Tripo H3.1",
    "file": "bench-original.glb"
  },
  {
    "label": "Bench archived copy",
    "subject": "bench",
    "route": "Tripo H3.1",
    "file": "archive/bench-original.glb"
  },
  {
    "label": "Bench texture derivative",
    "subject": "bench",
    "route": "Tripo H3.1",
    "file": "bench-resize-only.glb",
    "parent": "bench-original.glb"
  }
]
从生成回执取得模型路线和输入引用。从下载的 GLB 读取字节、三角面和内嵌图片数。脚本读取 GLB 的 JSON 块,统计文件存储的三角形图元。入库前还可跑一遍 GLB 自动验收。数据库里的面数是客观字段,是否批准交付需要单独记录。这样即使规则后来变化,也可以保留当时从文件中测得的数据。
3. 创建并查询资产库
把下面的程序保存为 catalog.py。程序先核对 GLB v2 文件头并读取指标,计算完整哈希,再在同一事务里替换专用数据库的快照表。文件不存在时会在替换之前终止。父子关系找不到父文件时会回滚。这个例子每个数据库对应一份清单,重新导入会移除已经从清单删除的记录。要同时维护多份清单,可以给每份指定自己的数据库路径。
import argparse
from hashlib import sha256
import json
from pathlib import Path
import sqlite3
import struct

SCHEMA = """
PRAGMA foreign_keys = ON;
CREATE TABLE IF NOT EXISTS asset (
    hash TEXT PRIMARY KEY, bytes INTEGER NOT NULL,
    triangles INTEGER NOT NULL, images INTEGER NOT NULL
);
CREATE TABLE IF NOT EXISTS occurrence (
    source TEXT PRIMARY KEY, hash TEXT NOT NULL REFERENCES asset(hash),
    label TEXT NOT NULL, subject TEXT NOT NULL, route TEXT NOT NULL
);
CREATE TABLE IF NOT EXISTS variant (
    child TEXT NOT NULL REFERENCES asset(hash),
    parent TEXT NOT NULL REFERENCES asset(hash),
    PRIMARY KEY (child, parent), CHECK (child <> parent)
);
"""

def inspect(path):
    data = path.read_bytes()
    if len(data) < 20:
        raise ValueError(f"Short GLB: {path}")
    magic, version, size, json_size, kind = struct.unpack_from("<4sIIII", data)
    if (magic, version, size, kind) != (b"glTF", 2, len(data), 0x4E4F534A) or json_size > len(data) - 20:
        raise ValueError(f"Invalid GLB header: {path}")
    doc = json.loads(data[20:20 + json_size])
    primitives = [p for mesh in doc["meshes"] for p in mesh["primitives"]]
    if not primitives or any(p.get("mode", 4) != 4 for p in primitives):
        raise ValueError(f"Expected triangle primitives: {path}")
    triangles = sum(doc["accessors"][p.get("indices", p["attributes"]["POSITION"])]["count"] // 3
                    for p in primitives)
    embedded_images = sum("bufferView" in image for image in doc.get("images", []))
    return sha256(data).hexdigest(), len(data), triangles, embedded_images

def import_manifest(db, manifest):
    rows = json.loads(manifest.read_text())
    assets = {row["file"]: inspect(manifest.parent / row["file"]) for row in rows}
    with db:
        db.execute("DELETE FROM variant")
        db.execute("DELETE FROM occurrence")
        db.execute("DELETE FROM asset")
        for row in rows:
            asset = assets[row["file"]]
            db.execute("INSERT INTO asset VALUES (?, ?, ?, ?) ON CONFLICT(hash) DO NOTHING", asset)
            db.execute("INSERT INTO occurrence VALUES (?, ?, ?, ?, ?)",
                       (row["file"], asset[0], row["label"], row["subject"], row["route"]))
        for row in rows:
            if "parent" in row:
                child, parent = assets[row["file"]][0], assets[row["parent"]][0]
                db.execute("INSERT INTO variant VALUES (?, ?) ON CONFLICT(child,parent) DO NOTHING",
                           (child, parent))

def main():
    cli = argparse.ArgumentParser()
    cli.add_argument("manifest", type=Path)
    cli.add_argument("--database", default="catalog.sqlite")
    cli.add_argument("--subject")
    cli.add_argument("--max-bytes", type=int, default=1_000_000_000)
    args = cli.parse_args()
    with sqlite3.connect(args.database) as db:
        db.row_factory = sqlite3.Row
        db.executescript(SCHEMA)
        import_manifest(db, args.manifest)
        totals = db.execute("""
            SELECT (SELECT COUNT(*) FROM occurrence) AS records, COUNT(*) AS unique_files,
            (SELECT SUM(a.bytes) FROM occurrence o JOIN asset a ON a.hash = o.hash) AS repeated_bytes,
            SUM(bytes) AS unique_bytes, (SELECT COUNT(*) FROM variant) AS variant_edges FROM asset
        """).fetchone()
        matches = db.execute("""
            WITH matched AS (
                SELECT o.*, ROW_NUMBER() OVER (PARTITION BY hash ORDER BY source) AS choice
                FROM occurrence o WHERE (? IS NULL OR o.subject = ?)
            )
            SELECT a.*, o.subject, o.route,
            (SELECT COUNT(*) FROM occurrence other WHERE other.hash = a.hash) AS records
            FROM asset a JOIN matched o ON o.hash = a.hash AND o.choice = 1
            WHERE a.bytes <= ? ORDER BY a.bytes, a.hash
        """, (args.subject, args.subject, args.max_bytes)).fetchall()
        print(json.dumps({"totals": dict(totals), "matches": [dict(r) for r in matches],
                          "occurrences": [dict(r) for r in db.execute("SELECT * FROM occurrence ORDER BY source")],
                          "variants": [dict(r) for r in db.execute("SELECT * FROM variant ORDER BY child")]}, indent=2))

if __name__ == "__main__":
    main()
先不带筛选条件运行,查看完整快照。若按前文三条清单准备文件,预期会得到三条来源、两份不同的 GLB,以及一条派生关系。归档原件要是逐字节复制,派生件的字节要有实际变化。
python3 catalog.py sources.json --database catalog.sqlite > catalog.json
python3 catalog.py sources.json --database catalog.sqlite > reimport.json
cmp catalog.json reimport.json
同一份清单重跑时,示例输出保持一致。按体积排序时使用完整哈希打破并列。来源文件一旦改变,下一次导入会重新计算哈希,并按当时的清单重建来源记录和关系。如果业务要保留跨版本历史,可将旧清单及其文件另行归档,再用当前快照服务查询。
4. 面数一样,仍要保留原件和派生件
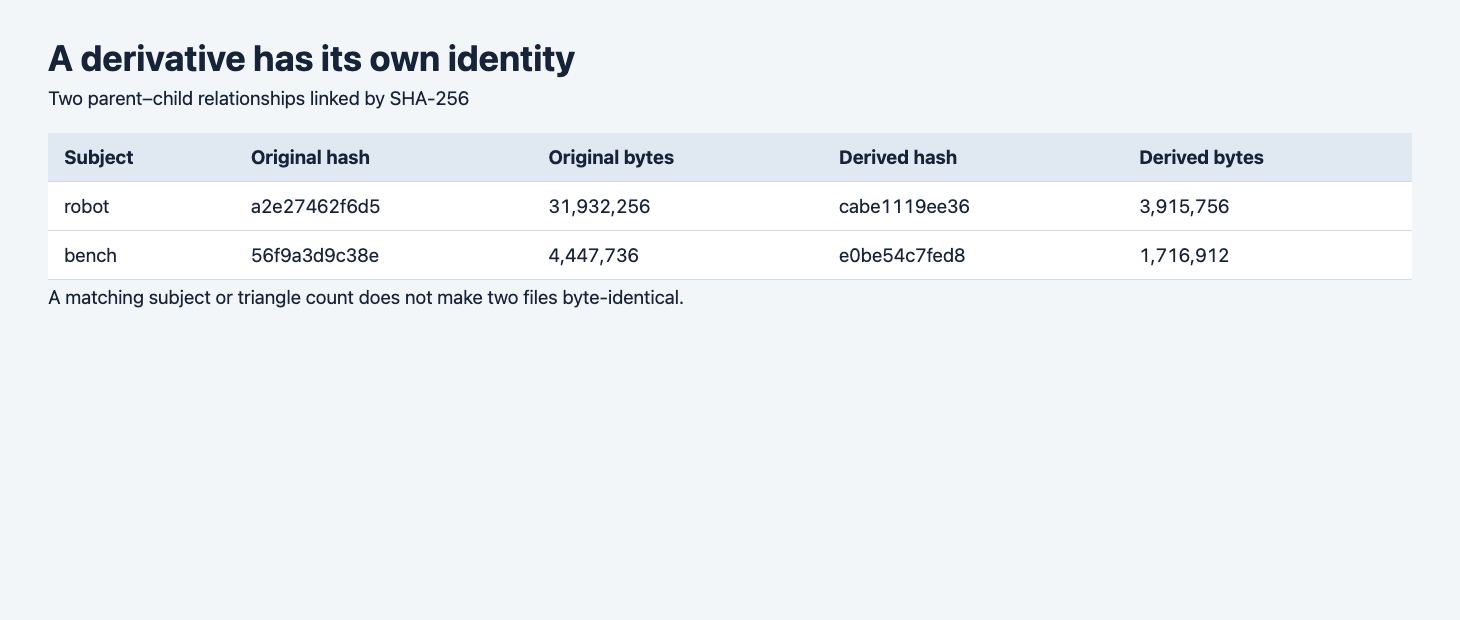
机器人应用减面和缩贴图,长椅只缩贴图。两条关系均来自实跑清单。
Hunyuan 机器人的原件是 31,932,256 字节和 499,914 面,交付版是 3,915,756 字节和 49,990 面。Tripo 的长椅从 4,447,736 字节降到 1,716,912 字节,前后均有 18,834 面。只看名字或三角面数,很容易把两份长椅当成一个版本。它们的贴图数据不同,哈希也不同。保留两个文件键后,用户能选轻量预览版,制作人员还能追溯到原始输出。
5. 用筛选结果和缩略图一起选
python3 catalog.py sources.json --database catalog.sqlite \
  --subject bench --max-bytes 4000000 > bench-filter.json
此命令按主体标签精确筛选,包含等于字节上限的文件。完整实验返回三份不同的 GLB,按体积排序。下图由本地浏览器读取实际查询结果,再加载对应的文件。对照统一灯光下的归一化渲染,可以看到各文件保留的部件。文中的 Python 负责输出查询 JSON。实际项目可把查询得到的文件交给自己的查看器。
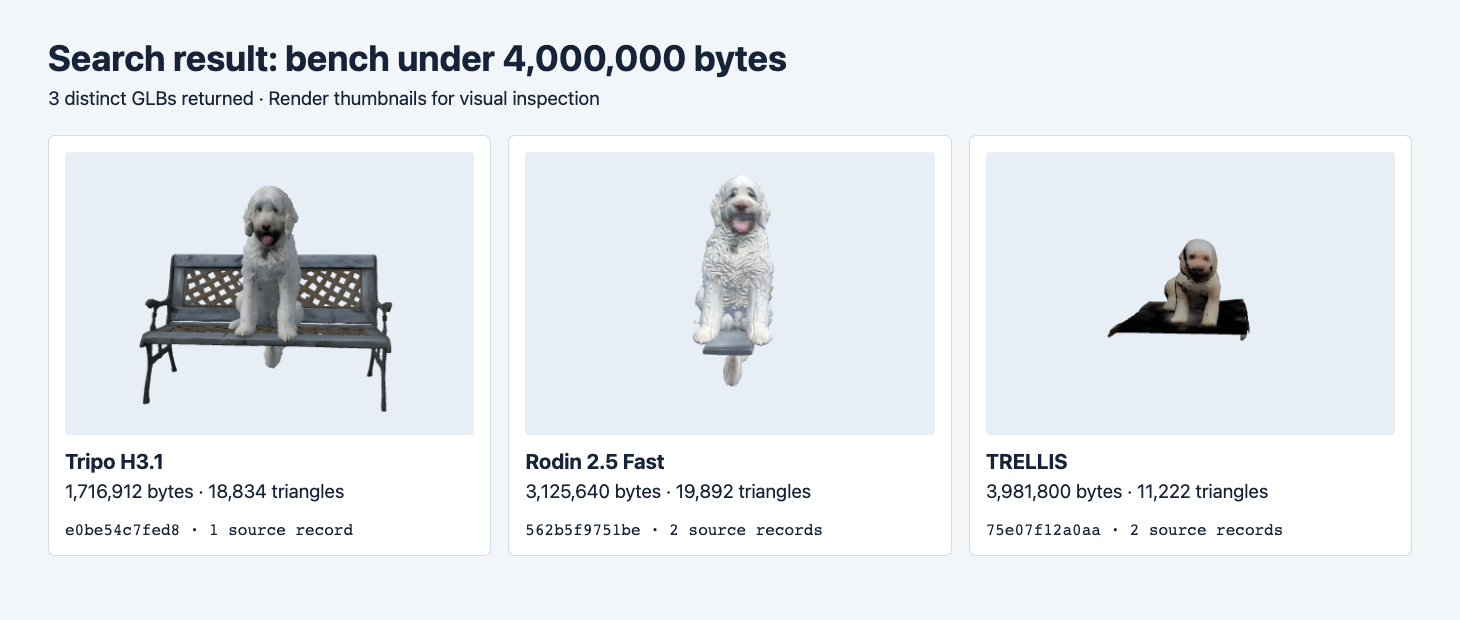
左到右是缩贴图的 Tripo H3.1、原始 Rodin Fast、原始 TRELLIS。长椅标签来自原图主题,保留了哪些部件要看实际文件。
| 匹配文件 | 字节 | 三角面 | 来源记录数 |
|---|---|---|---|
| Tripo H3.1 缩贴图版 | 1,716,912 | 18,834 | 1 |
| Rodin 2.5 Fast | 3,125,640 | 19,892 | 2 |
| TRELLIS | 3,981,800 | 11,222 | 2 |
图里第一份能看到座面、网格靠背和椅腿,另外两份主要保留狗和局部平面。若要让用户筛到完整长椅,可以增加视觉验收字段,再用它过滤。持久化缩略图时,用资产哈希加渲染配置版本作为键。以后换灯光和相机,可以给同一文件更新缩略图。缩略图生成失败时,保留原记录并显示处理状态。
这个例子只在原位置读取文件并计算可节省的字节。正式按哈希存一份文件时,要验证每条来源都能解析到共享对象。删除某一条来源记录后,其他来源仍需能访问原字节。清理无引用文件前,要同时查派生关系及当前发布是否仍在使用。
重跑后检查 JSON 和数据库
python3 - <<'PY'
import json
import sqlite3
with open("catalog.json") as source:
    result = json.load(source)
print(result["totals"])
with sqlite3.connect("catalog.sqlite") as db:
    print(db.execute("PRAGMA integrity_check").fetchone()[0])
    print(db.execute("PRAGMA foreign_key_check").fetchall())
PY
实测快照的完整性检查返回 ok,外键检查返回空列表。把清单中的父文件改成缺失路径后,导入失败,原数据库字节保持一致。团队可以把清单版本和导出的 JSON 放在一起。后续快照变了,也能追溯报告对应的资产集。
可以从 Rodin 2.5 Fast 图生 3D 或 Hunyuan3D 3.1 Pro 图生 3D 拿一份原始 GLB,再加入一个编辑后的副本。按主体和体积找候选,打开实际文件看过后,再决定哪一个适合交付。
常见问题
哈希不同,模型外观就一定不同吗?
完整 GLB 的任意字节变化都可能改变哈希。重新编码贴图、调整元数据或修改打包顺序都可能产生新的键。要找外形相似的资产,可以做缩略图或几何对照。
可以用截图里的十二位哈希当文件键吗?
数据库和存储键应使用完整 SHA-256。截图里的前缀方便人阅读。把验收记录绑定到文件时,保存完整值。
这个例子能按图片语义搜索吗?
示例用人工给定的主体字段做精确筛选。后续可加文本索引或图片向量,用文件哈希关联搜索结果。搜索相关性和文件身份可以独立维护。
觉得有用?分享给更多人