Product Review Analyzer:功能、场景与 API 依赖
SandBase Product Review Analyzer 使用指南:支持平台、功能亮点、用户场景、使用边界,以及背后的 4 个商品评论 API。
一个商品评分 4.7,不代表它没有明确的问题。可能是杯盖用一周就漏水,也可能是尺码偏小,或者包装里经常少一颗螺丝。平均分把这些细节压扁了,真正能指导行动的东西往往藏在评论原文里。问题是,没人愿意每天手动翻完 4 个平台的评论分页。
SandBase Product Review Analyzer 就是为这一步准备的:输入商品 ID,选择 Walmart、Home Depot、淘宝/天猫或京东,工具会读取实时公开评论并整理成市场简报。它适合产品经理、电商卖家、采购团队和研究 Agent,用来判断下一步该改产品、改详情页、查供应链,还是继续收集证据。
先说结论
- 工具从商品 ID 开始,不做关键词找货;它解决的是「把某一个 listing 看深」,不是「发现有哪些商品」。
- 当前支持 Walmart、Home Depot、淘宝/天猫、京东 4 个平台。
- 它不只看平均分,还围绕评论流、评分分布、反复出现的用户语言、证据记录、数据源、检查时间和调用次数组织结果。
- 每翻一页会消耗 1 次实时电商 API 调用,并从登录的 SandBase 账户计费,所以分页要有目的。
- 要批量跑商品、做定时监控或接入自己的 Agent,可以直接使用文中列出的 4 个底层评论 API。
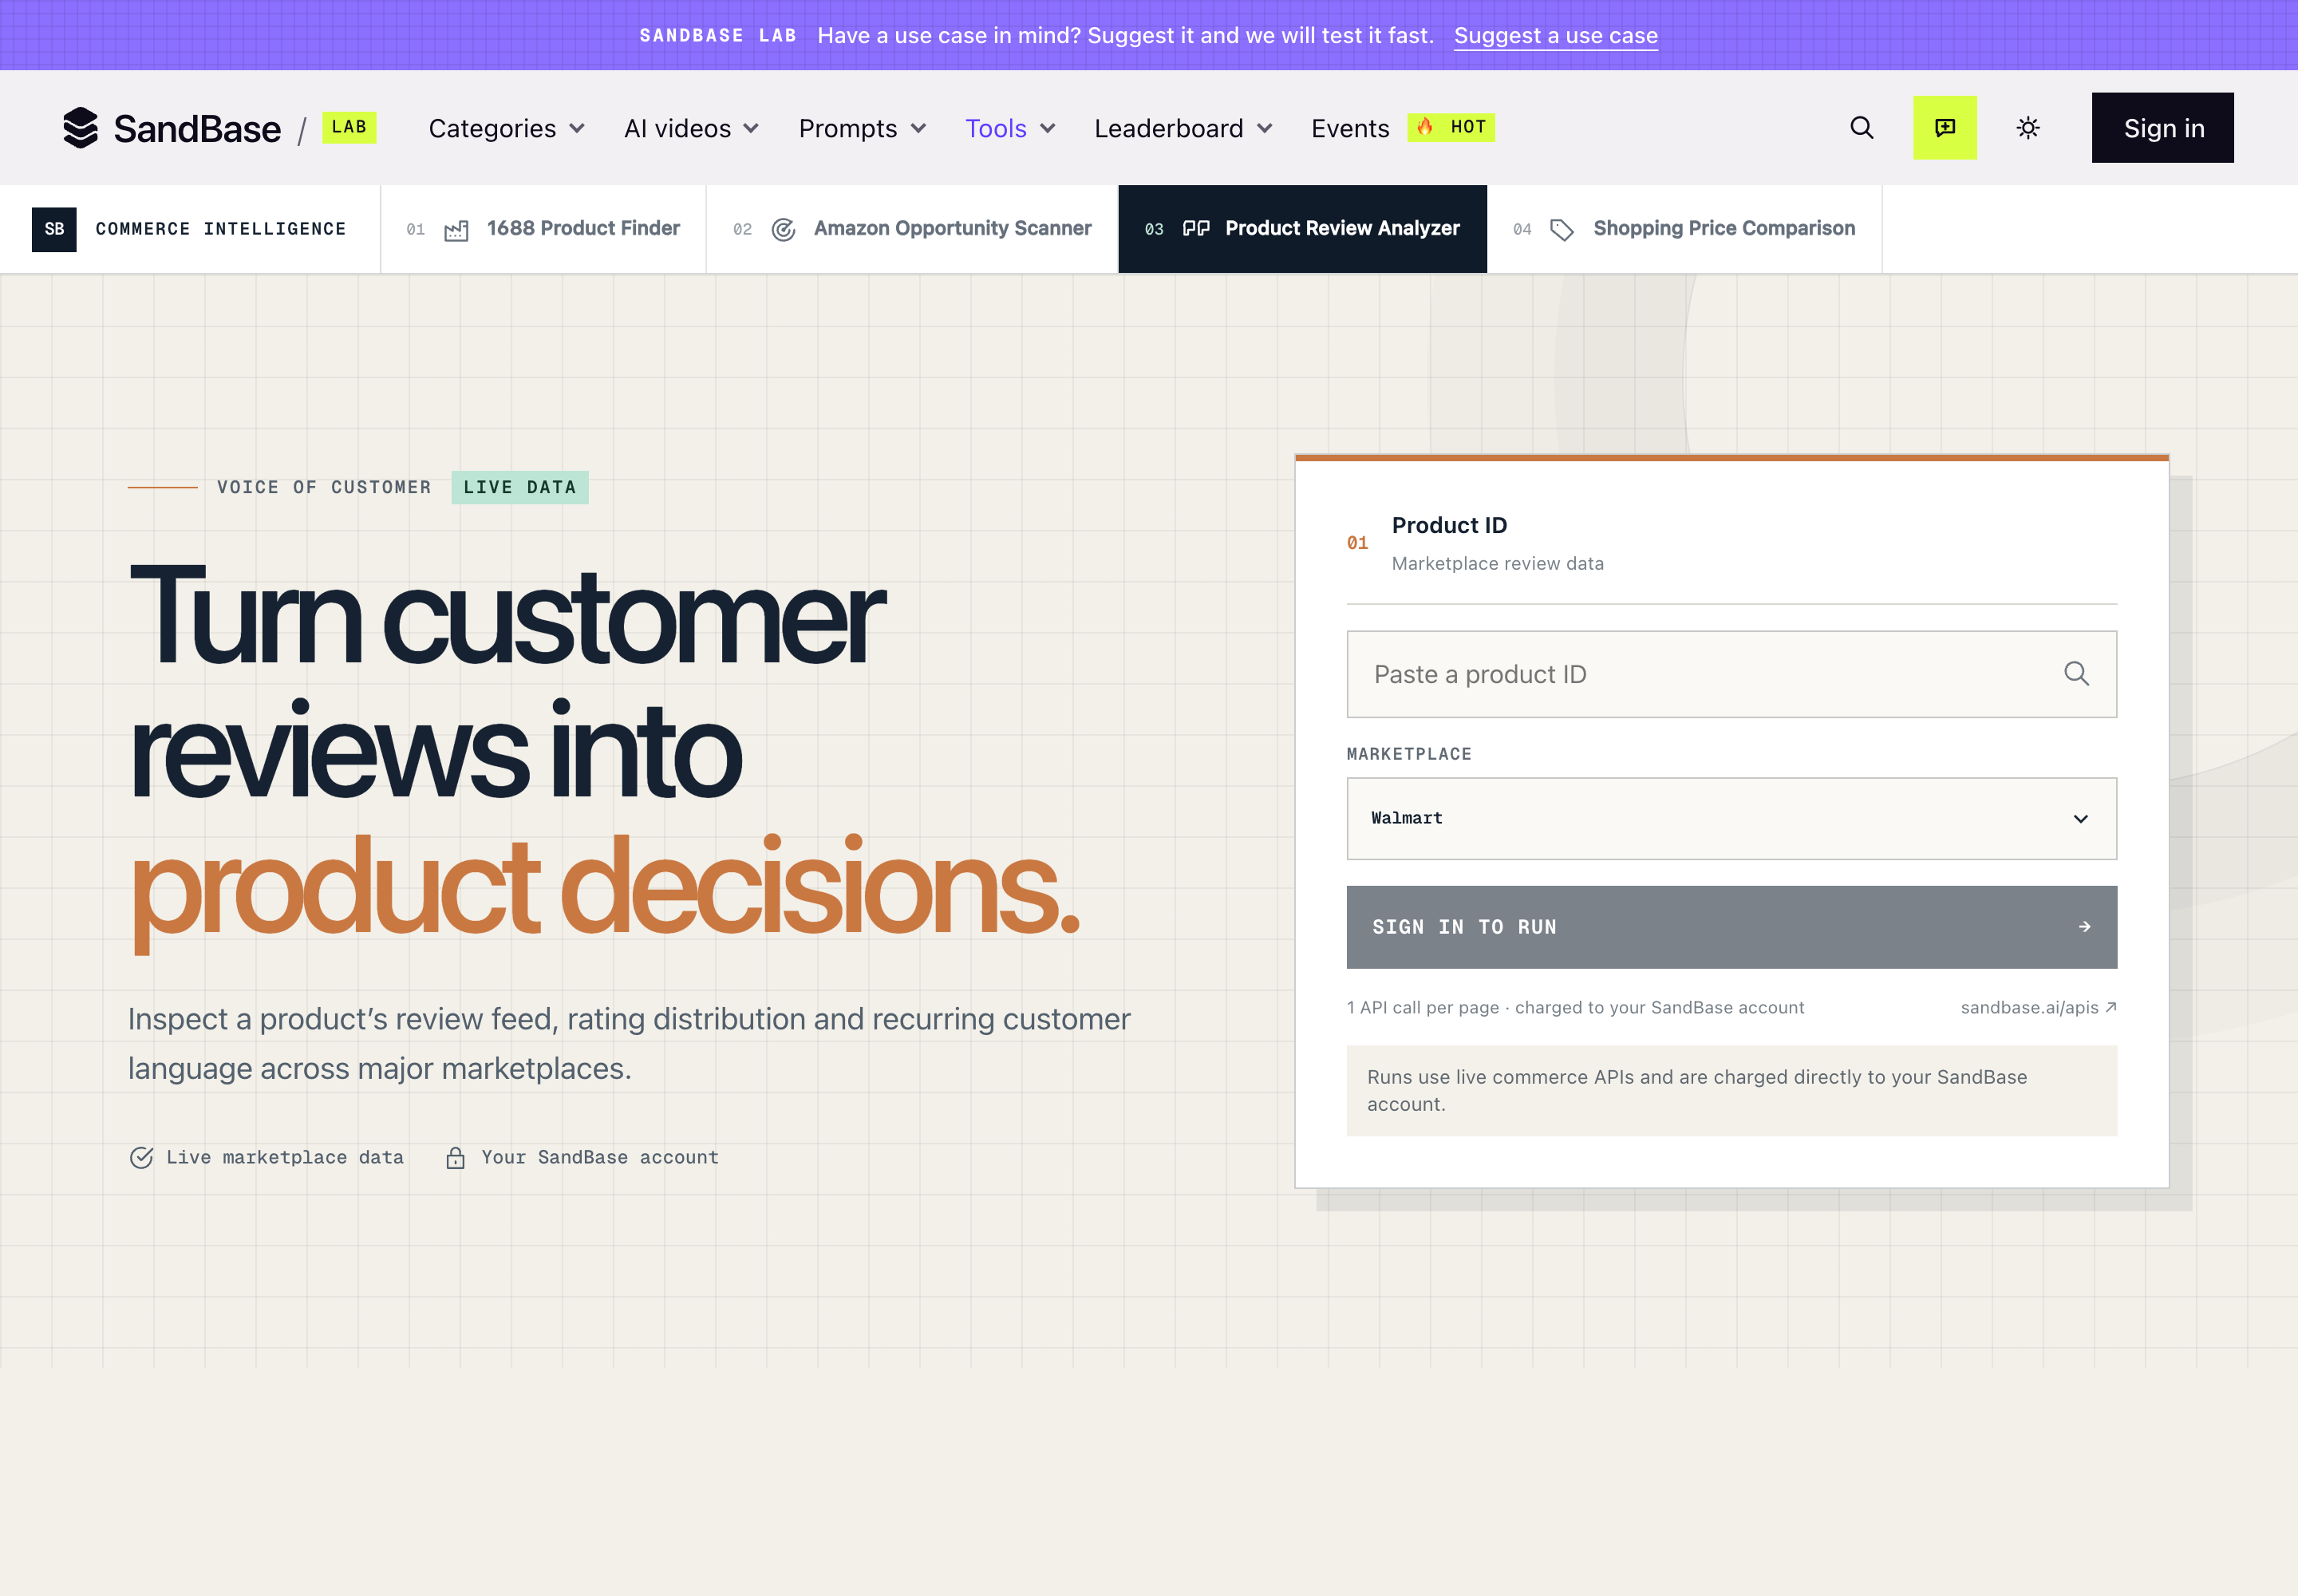
Product Review Analyzer 的第一步很克制:粘贴商品 ID、选平台、读取实时电商数据。截图于 2026 年 10 月 31 日。
这个工具到底做什么
页面只让你做两个选择:看哪个商品,以及从哪个平台看。这恰恰是它的亮点。关键词搜索回答的是「市场上有哪些商品」;评论分析回答的是「这个具体 listing 到底出了什么问题」。如果把两件事混在一起,搜索结果里的套装、配件、不同规格和相似品牌会把结论搅乱。
登录后,工具会把商品 ID 发给所选平台的评论端点,并把结果整理成一份实时市场简报。页面实现里可以看到这些结果区:
| 结果区域 | 能支持什么决策 |
|---|---|
| 评论流 | 读懂评分背后的用户原话 |
| 评分分布 | 判断高均分下面是否藏着一条不小的低星长尾 |
| 高频语言 / 决策信号 | 发现反复出现的抱怨、被夸的属性和需要继续核验的词 |
| 返回记录 | 回到证据,不接受悬空的总结 |
| 数据源与检查时间 | 保留平台和时效上下文 |
| API 调用次数 | 翻页时随时知道研究成本 |
这里要把「证据」和「解释」分开。评论里反复出现「难安装」,只能说明这个问题值得查;它不自动等于产品结构有缺陷。可能是说明书不清楚,可能是某一批次少配件,也可能是用户装错了。工具负责快速把模式捞出来,根因仍要结合退货原因、客服工单、质检记录或用户访谈确认。
4 个平台,对应 4 个 API 依赖
平台选择器不是一个展示用的筛选项。选不同平台,底层会切换不同端点,因为商品 ID、分页、排序和评分结构都不一样。
| 工具里的平台 | 对应 SandBase API | API 目录确认的能力 |
|---|---|---|
| Walmart | Walmart Product Reviews | 商品 ID、整体评分、评分直方图、正负面代表评论、分页评论文本与图片 |
| Home Depot | Home Depot Product Reviews | 商品 ID、整体评分、评分直方图、推荐数量、筛选与排序 |
| 淘宝 / 天猫 | Taobao Product Reviews | 商品 ID、分页,以及最新/默认排序 |
| 京东 | JD.com Product Comments | 商品 ID 与分页买家评论,用于反馈和商品质量研究 |
这 4 个链接是开发者真正要收藏的入口。临时看一个商品,用 Lab 工具最快;要批量处理整个商品库、每天定时检查,或者接到自己的 Agent 里,就从对应 API 页面开始。上表能力说明核验于 2026 年 10 月 31 日。电商平台上游可能调整嵌套业务字段,因此接入前要看线上 input schema;一次调用里观察到的字段,也不要写成永久保证。
Walmart:评分分布和评论原文放在一起看
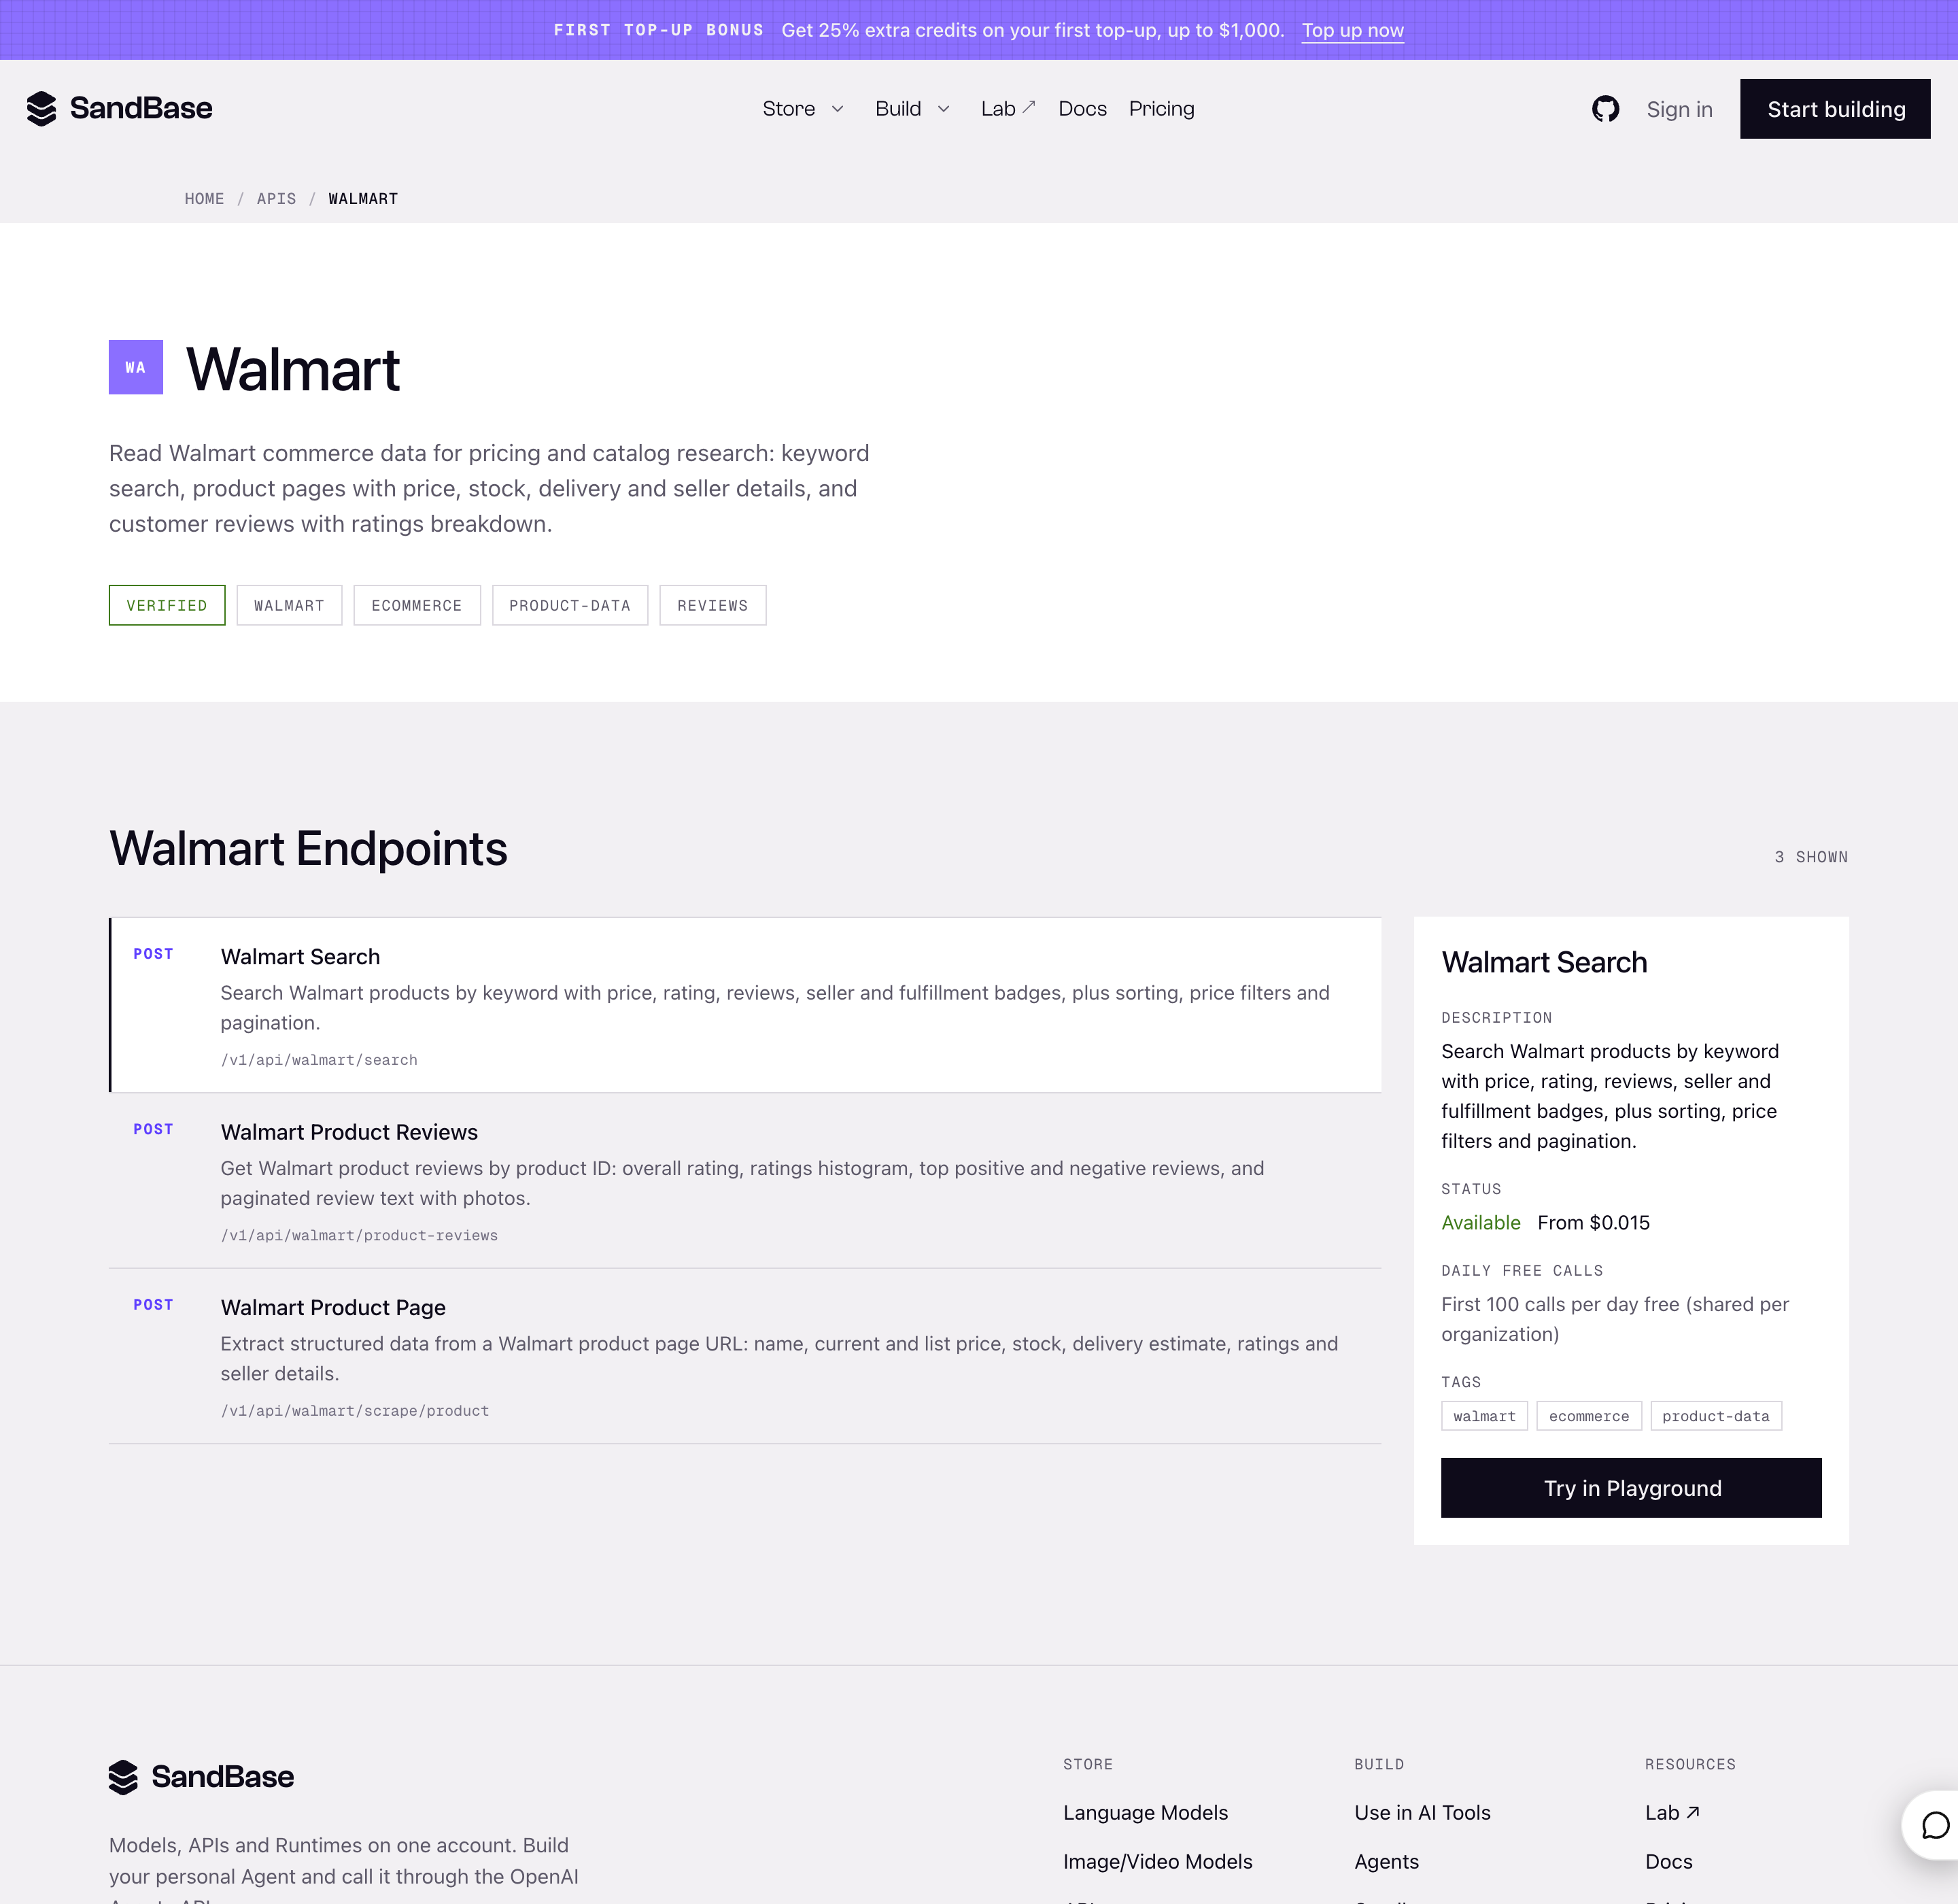
Walmart 目录把搜索、商品页提取和商品评论拆成了不同端点。Product Review Analyzer 依赖的是评论端点,不是关键词搜索。截图于 2026 年 10 月 31 日。
Walmart 端点适合先看「不满意的人有多少」,再看「他们到底怎么说」。目录明确列出了评分直方图、正负面代表评论和分页评论文本。评分分布负责告诉你问题规模,评论原文负责给出问题语言。
但「代表性差评」不等于「最常见故障」。先把它当阅读入口,再翻足够的页,确认同一个问题是否真的重复出现。
Home Depot:对耐用品来说,推荐数量很有用
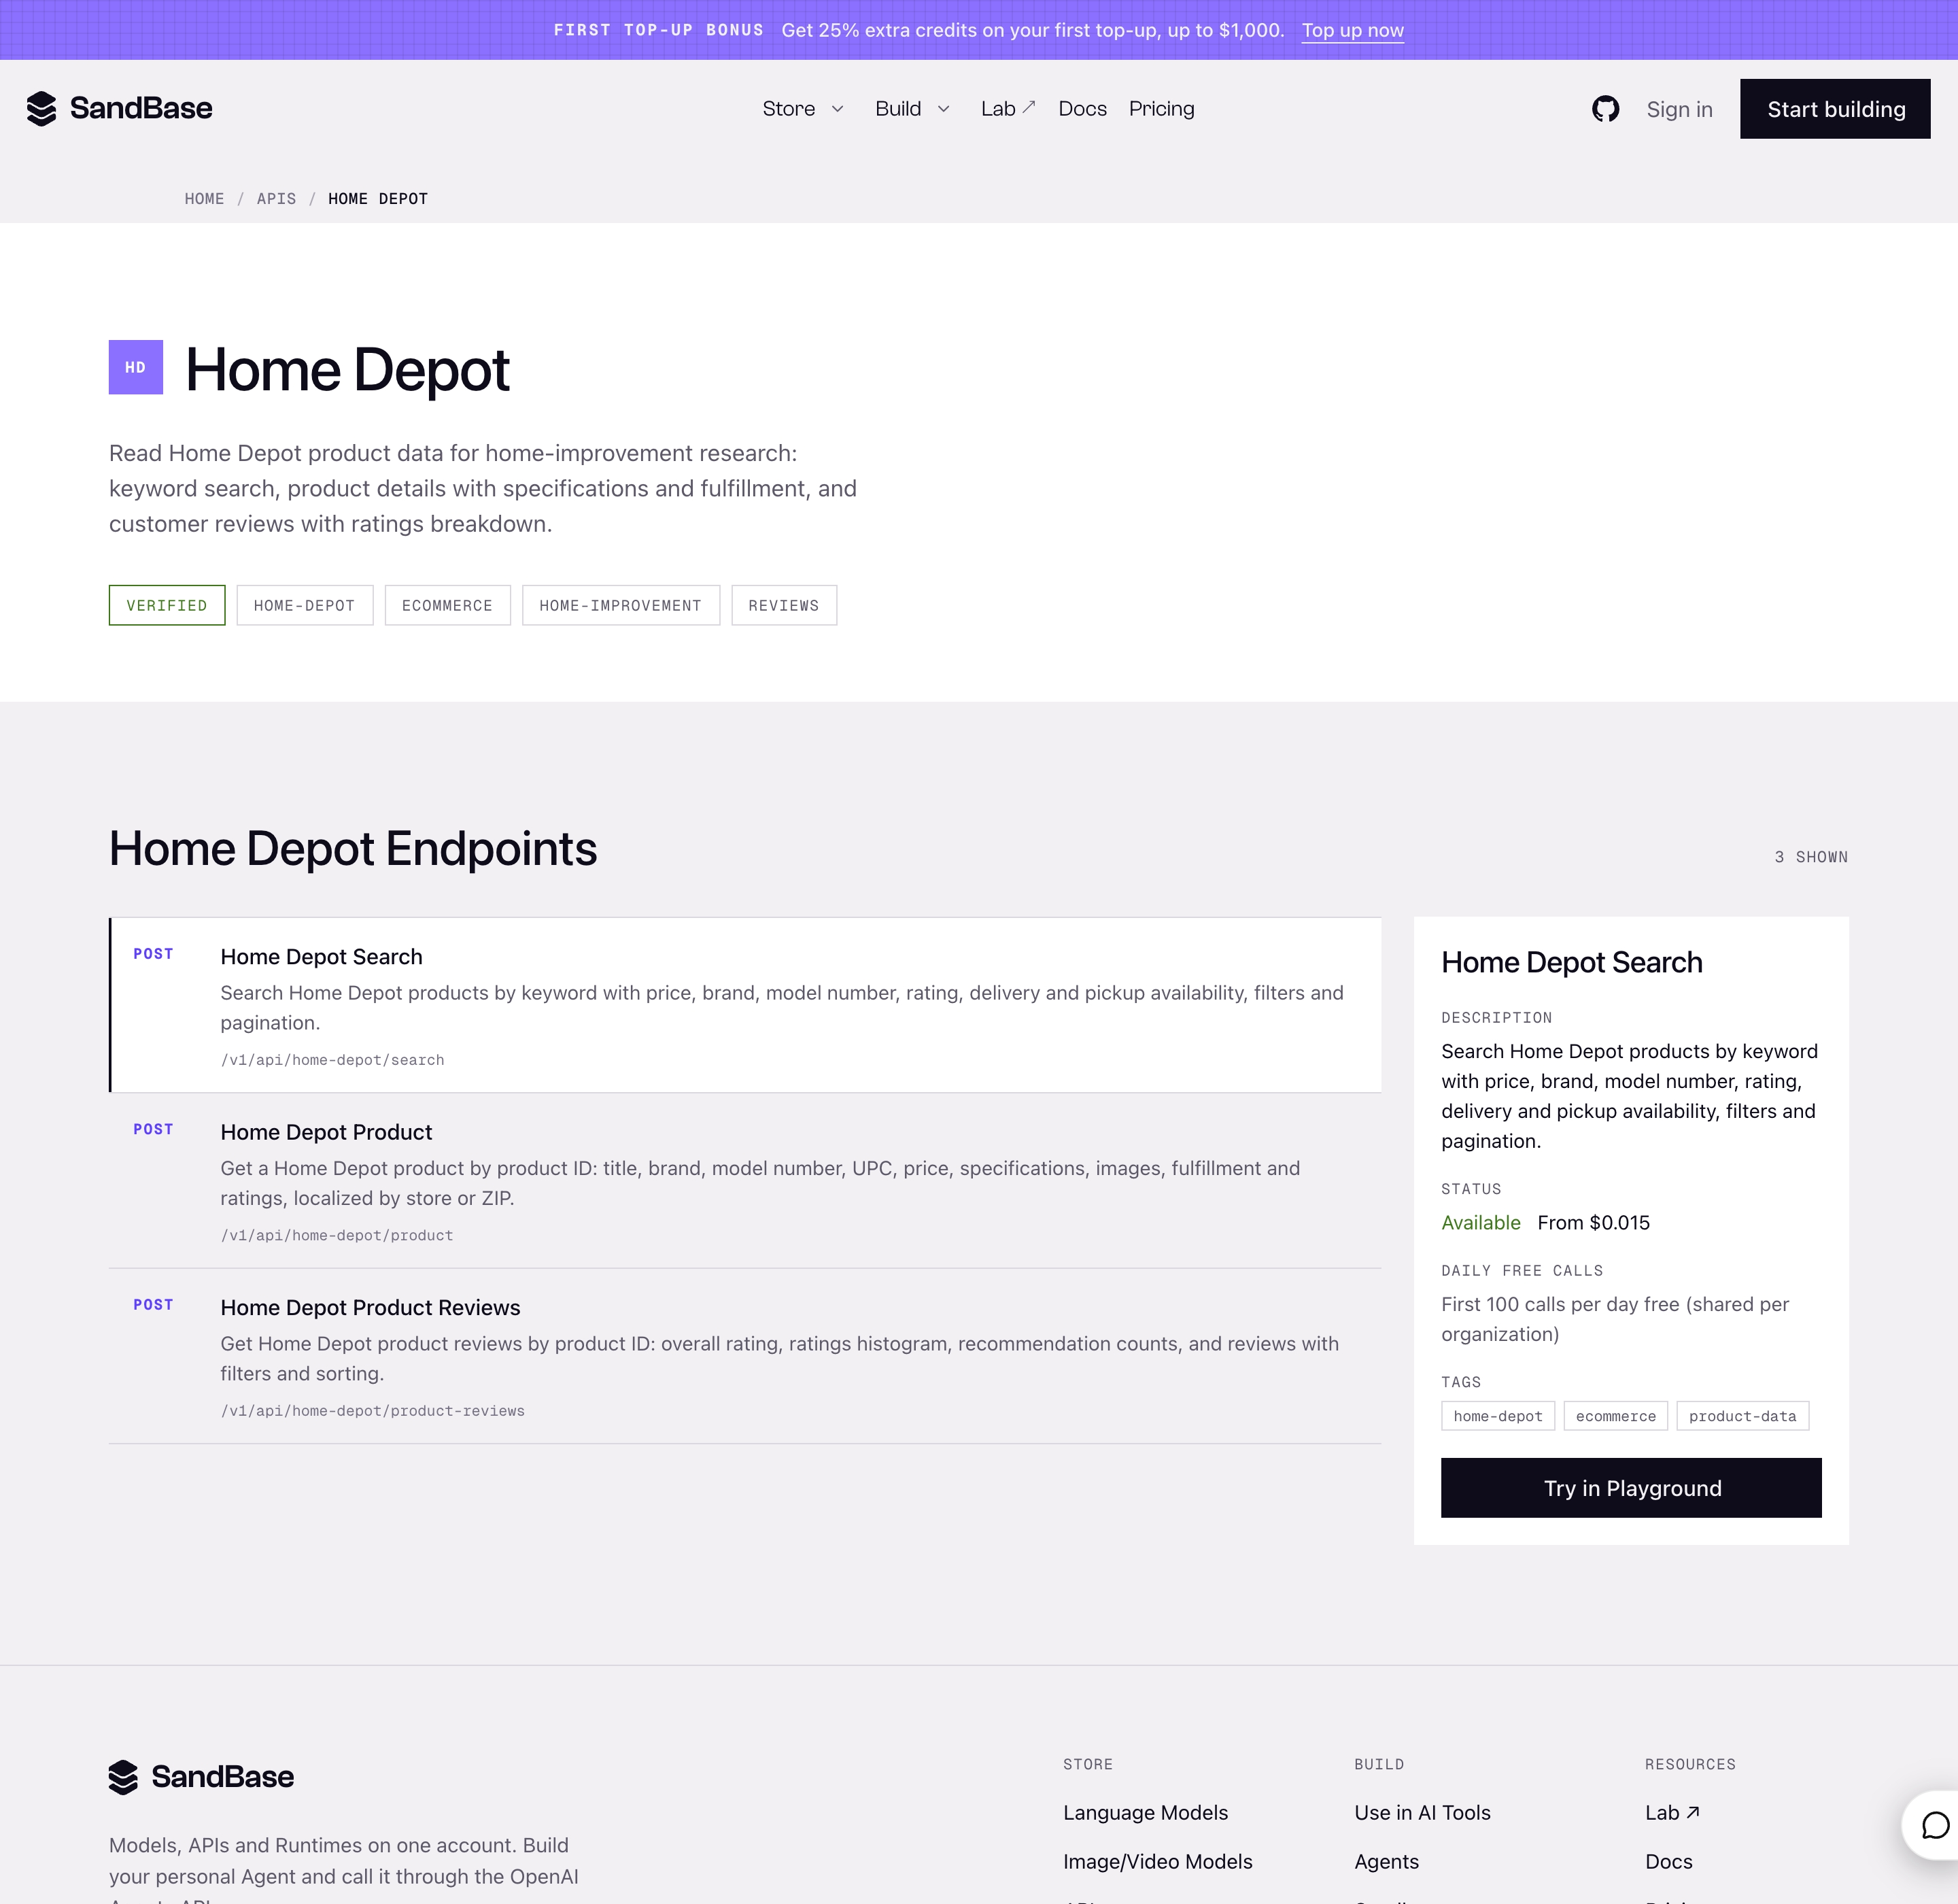
Home Depot 评论端点除了评分分布,还提供推荐数量、筛选和排序。截图于 2026 年 10 月 31 日。
工具、灯具、建材这类商品,4 星可能对应完全不同的经历:安装困难、规格不匹配、包装少件,或者用几个月后损坏。Home Depot 依赖里多了推荐数量和筛选能力,适合回答「买家愿不愿意推荐」这种问题,而不只是盯着平均分。
边界也很清楚:公开评论不是保修数据,不是经过验证的故障率,更不是零售商内部经营数据。
淘宝和天猫:排序方式本身就是研究方法
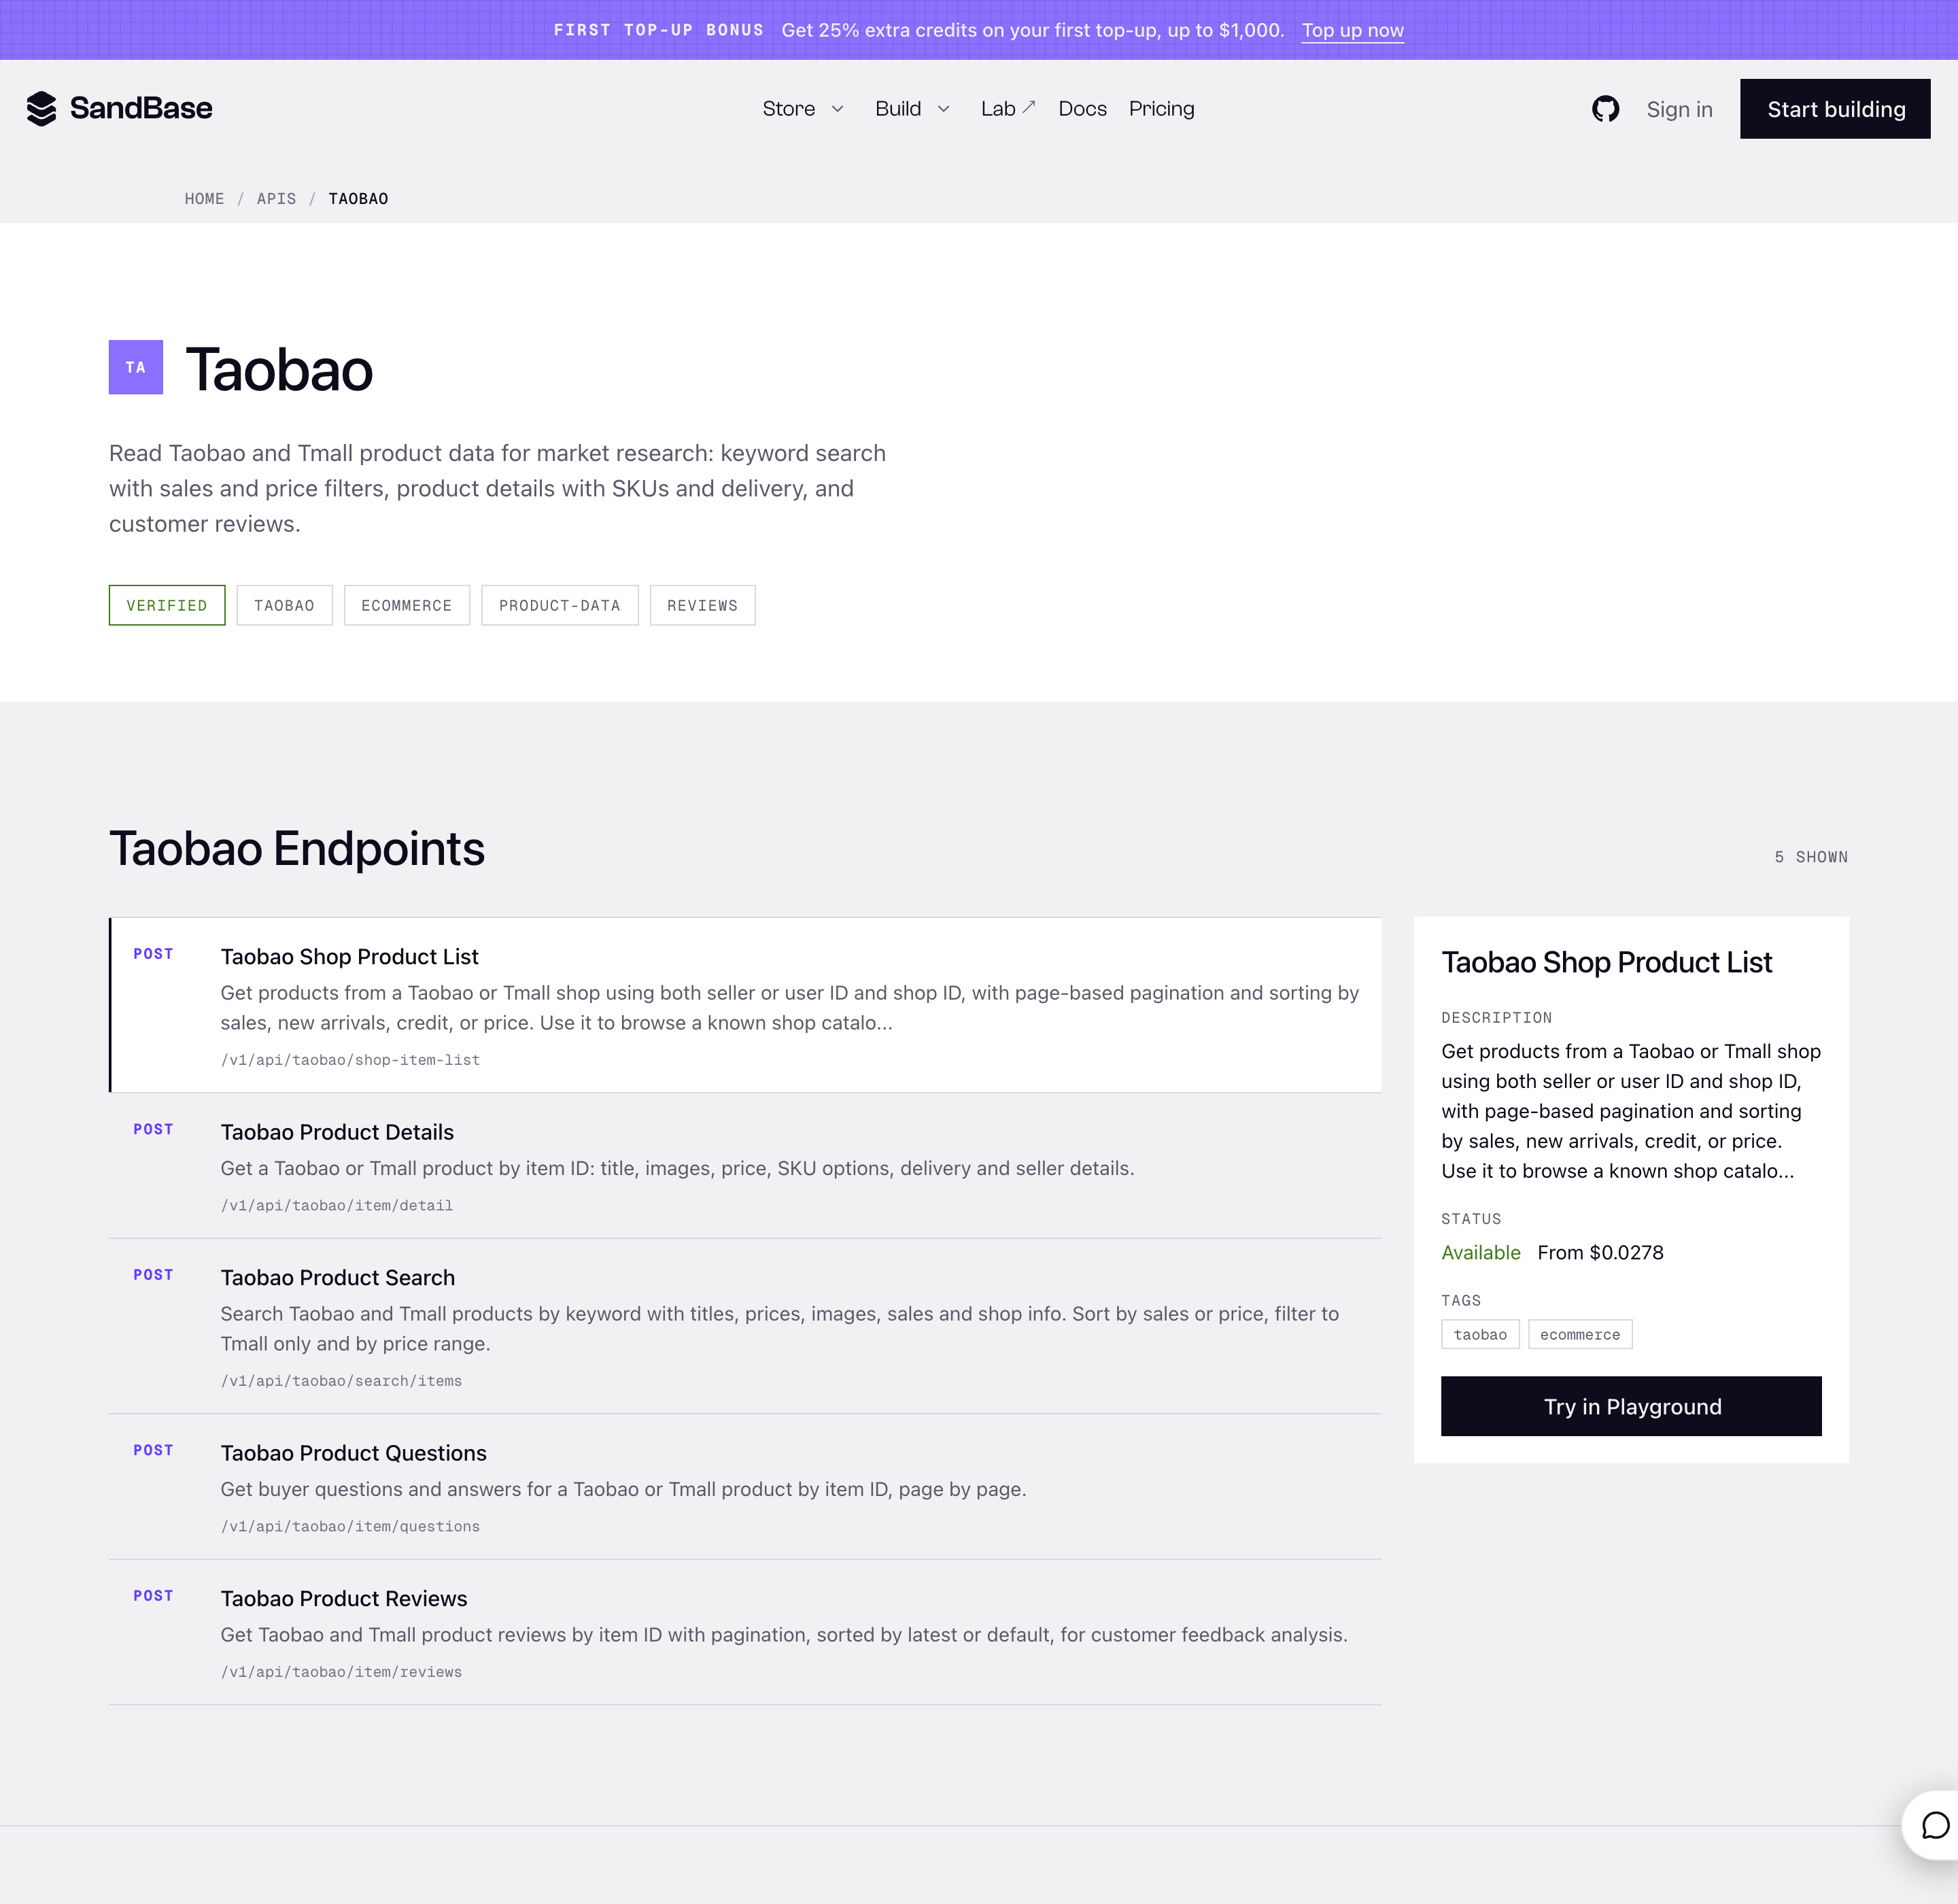
淘宝评论端点支持商品 ID、分页,以及最新/默认排序。截图于 2026 年 10 月 31 日。
这里尤其要留意排序。默认排序更接近消费者打开详情页时看到的社会证明;最新排序则更适合查近期批次、包装变化或突然出现的质量回退。没有哪一种永远正确,关键看你问的是什么问题。
这也是工具为什么要求商品 ID。一个关键词会命中许多 listing、规格和店铺;如果 listing 边界不清楚,评论结论就没有意义。
京东:接口叫 Comments,不要想当然拼 Reviews
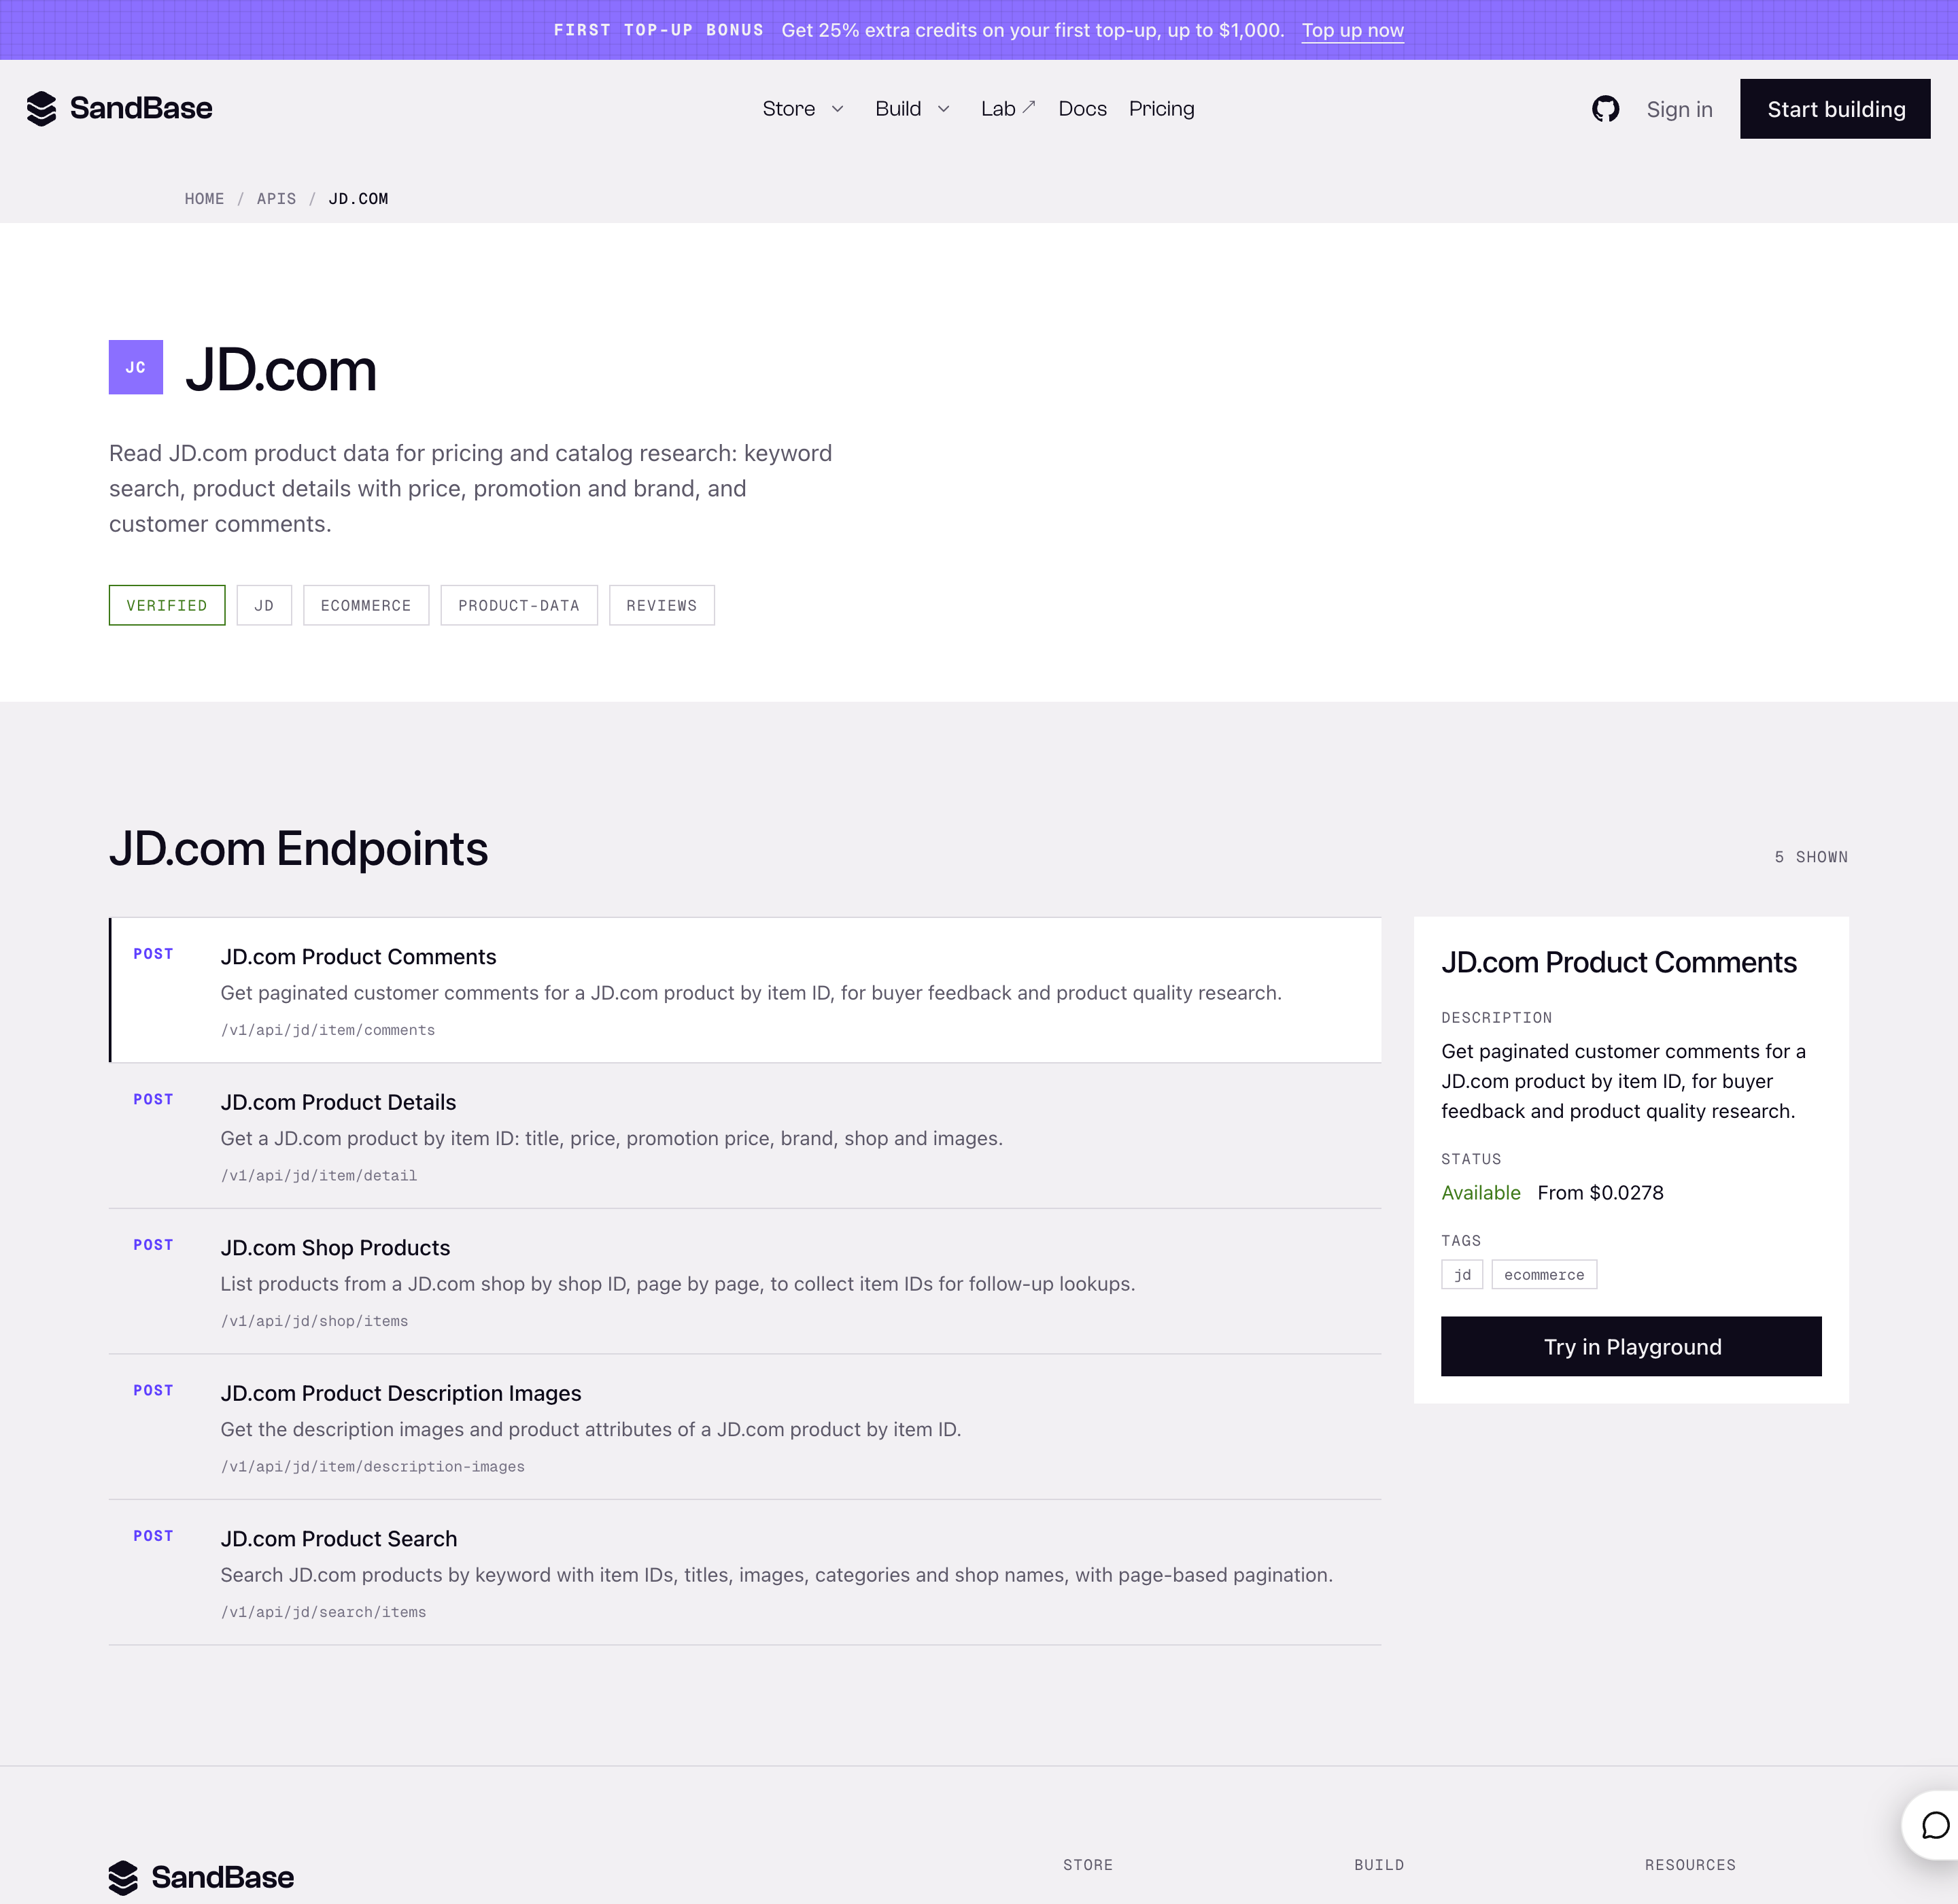
京东的底层依赖名为 Product Comments,接收商品 ID,并支持分页。截图于 2026 年 10 月 31 日。
京东在端点名里用的是 comments,但在工具里承担的任务相同:读取某个商品 ID 的公开买家反馈。做集成时这个命名差异很重要。不要猜所有平台都共用 /reviews 路径,直接以文中链接的模型页和确切路由为准。
哪些用户场景最值得用
1. 产品经理:把模糊差评变成可验证的 backlog
假设一款小家电销量不错,平均 4.6 星,但工具反复捞出「难清洗」和「密封圈」相关语言。这还不足以直接推动改模,却足够提出两个可验证问题:污渍是否容易卡在密封圈附近?低星评论是否集中在漏液?
它的价值是压缩信息。你不用把几百条评论丢给研发,而是交付一条短证据链,再附上需要复查的代表记录。
2. 电商卖家:先判断该改详情页,还是该找供应链
评论经常暴露「产品和承诺不一致」。如果买家反复说尺寸比想象中小,最便宜的动作可能是补一张清晰尺寸图;如果评论集中在少配件,改文案没用,问题在包装或履约。
这能挡住很多无效优化。先判断动作属于商品内容、包装、运营,还是产品本身,再决定谁接手。
3. 采购团队:下大货之前,先看最可能翻车的地方
采购真正关心的通常不是「谁的星更多」,而是「订 2,000 件以后会因为什么翻车」。对几款同类 listing 分别运行工具,再比较抱怨类型:材质手感、破损、尺码、安装、包装还是物流损坏。
尽量在同一个平台、同一个品类内对比。Walmart 的 4.5 和淘宝的 4.5 不是同一把尺子,用户结构、排序和审核规则都不同。
4. 用户研究和客服:把访谈问题问得更准
高频用户措辞能帮你改进访谈提纲。公开评论如果反复出现「晃」,可以继续问「在什么负载、哪个步骤开始晃」;不要直接问「你是不是觉得稳定性有问题」,那已经把答案塞进问题里了。
公开评论适合生成访谈假设,不适合替代目标用户访谈。
5. Agent 开发者:从单次查询升级成定时监控
UI 适合现在查一个商品。需要每周复查同一批商品、把新评论和基线对比,或者某类抱怨超过阈值就报警时,再做 Agent 才划算。
生产工作流至少要保留:原始端点响应、查询时间、平台、商品 ID、页数和转换逻辑版本。下周简报变了,你得分得清是用户反馈变了,还是抽取逻辑变了。
想看更深的实现,可以接着读商品评论分析 Agent 教程。那篇文章用另一组平台,详细讲了过滤、打标、聚合和模型选择的取舍。
什么时候用 Lab,什么时候直接接 API
| 选择 Lab 工具 | 直接接 API |
|---|---|
| 手里只有 1 个商品 ID,要快速形成简报 | 要处理许多商品 ID |
| 人会立刻检查证据 | 定时任务或 Agent 要重复运行 |
| 内置评论流和决策信号已经够用 | 要自定义标签、存储、告警或数据关联 |
| 不想写代码,但要看数据源和调用次数 | 要自己控制重试、分页和审计日志 |
Lab 不是「缩水版 API」,而是已经替你做了取舍的决策界面。任务刚好匹配时,这种取舍很省时间;任务不匹配时,它也会成为限制。
一套 5 分钟工作流
- 从电商商品页复制确切商品 ID。
- 打开 Product Review Analyzer,登录后选择对应平台。
- 先跑第 1 页,先看评分分布,不要一上来就接受总结。
- 打开有代表性的好评和差评,确认高频语言在证据里真的出现过。
- 写下一个决定和一个不确定项,例如:「检查杯盖密封耐用性;公开评论不能证明故障率。」
- 只有下一页可能改变决定时才继续翻。每页都会多消耗 1 次 API 调用。
最后一步很容易被忽略。评论不是越多越好。如果第 1 页里出现了 3 类互不相关的问题,继续翻页能帮你判断频率;如果 20 条都在重复同一句窄问题,再多翻几页可能只增加成本,不改变下一步行动。
使用边界
- 它看 listing,不负责找市场。 开始分析前,你必须先有商品 ID。
- 实时数据会变。 一份报告是带日期的快照,不是稳定 benchmark。
- 4 个平台 schema 不同。 字段、排序和分页方式不能想当然统一。
- 公开评论有选择偏差。 留评论的人不是全部买家的随机样本。
- 高频词不等于因果。 要和客服、退货、质检或访谈证据交叉核验。
- 分页要算调用。 页面明确写着每页 1 次 API 调用,并从登录账户计费。
- 它不代表卖家私域数据。 已核验的是公开评论,不包括订单、退款原因、私信或卖家后台分析。
本文核验范围说在前面:2026 年 10 月 31 日,我检查了公开工具界面、4 个平台选项、页面显示的调用计费说明,以及对应 SandBase API 目录。由于没有在登录账户里实际运行某个商品,本文不声称实测响应时间、固定返回评论数或永久不变的业务 payload schema。
常见问题
Product Review Analyzer 能用关键词搜商品吗?
不能。当前界面接收商品 ID 和平台。先通过平台页面或搜索端点找到 listing,再分析这个确切 ID。
现在支持哪些平台?
截至 2026 年 10 月 31 日,选择器里有 Walmart、Home Depot、淘宝/天猫和京东。对应 API 已在上文表格逐一链接。
跑一次结果就能做产品决策吗?
它足够帮你提出假设,或者决定下一步查什么;但不足以证明故障率和因果。至少复查代表记录,有内部数据时再和退货、客服、质检证据结合。
为什么不直接把评论复制给通用聊天模型?
通用模型仍需要可靠抽取、平台上下文、分页和可回溯记录。Product Review Analyzer 把这些机械工作收进一个有边界的流程里,还把数据源、检查时间和调用次数留在界面上。
能把同一套流程自动化吗?
可以。从 Walmart、Home Depot、淘宝或京东评论端点开始。按线上 schema 调用 POST /v1/api/<vendor>/<path>,SandBase 文档化 payload 位于 outputs[0].data。
结论
Product Review Analyzer 最适合做一件事:把「这个平均分有点可疑」推进到「下一步到底该查什么」。它把任务限制在一个 listing,把评论证据留在结果里,也把翻页成本摆在台面上。临时的人工作业用 Lab;要规模化、定时化、自定义标签或完整审计链,再切到对应 API。