京东 API Python 实战:搭一条可审计的商品研究流水线
用京东 API 做商品搜索、详情归一化、成本测算和评论研究;解释价格遮罩、调用未验证与上游字段变化该怎么处理。
商品搜索结果看起来很规整,接上详情接口后却可能完全换一种结构。11 月 1 日实测新上线的京东 API 时,我就撞上了这个问题:搜索结果是紧凑的 products 列表,详情却是一份很深的移动电商响应,价格还是 1?? 这样的遮罩字符串。真正要解决的不是“怎么发一个 HTTP 请求”,而是怎么给 agent 建一道可信的数据边界。
这篇文章面向商品研究、价格监测、货盘分析与用户反馈工具的开发者。它覆盖 SandBase 上 5 个京东端点、两次带 run id 的真实调用、Python 防御式解析和一套明确的成本模型。一次市场快照不能证明库存、需求或商品质量,文中不会把它包装成采购结论。
先说结论
- SandBase 当前列出 5 个京东端点:搜索、详情、描述图、店铺商品和评论,上线日期为 2026-10-29。
- 数据 API 应调用
POST /v1/api/jd/...,完成态业务数据只从outputs[0].data读取。- 11 月 1 日页面价格为:搜索 $0.0208/次,详情与评论各 $0.0278/次。
- 必须把商品 ID、标题、价格、店铺和证据来源归一化到自己的 schema。本次详情价格被遮罩,数不出来就应保持未知。
- 评论适合做证据抽样,不适合盲目算“口碑分”。本次没有保留文档样例商品的完成态响应,因此本文不声称已验证评论负载。
5 个接口分别解决什么问题
SandBase 京东 API 目录目前列出 5 个同步 POST 端点:
| 端点 | 用途 | 2026-11-01 页面价格 |
|---|---|---|
/v1/api/jd/search/items | 关键词搜索与页码分页 | $0.0208 |
/v1/api/jd/item/detail | 商品、价格、促销、品牌、店铺与图片 | $0.0278 |
/v1/api/jd/item/description-images | 描述图与商品属性 | $0.0208 |
/v1/api/jd/shop/items | 分页读取指定店铺商品 | $0.0278 |
/v1/api/jd/item/comments | 分页读取商品评论 | $0.0278 |
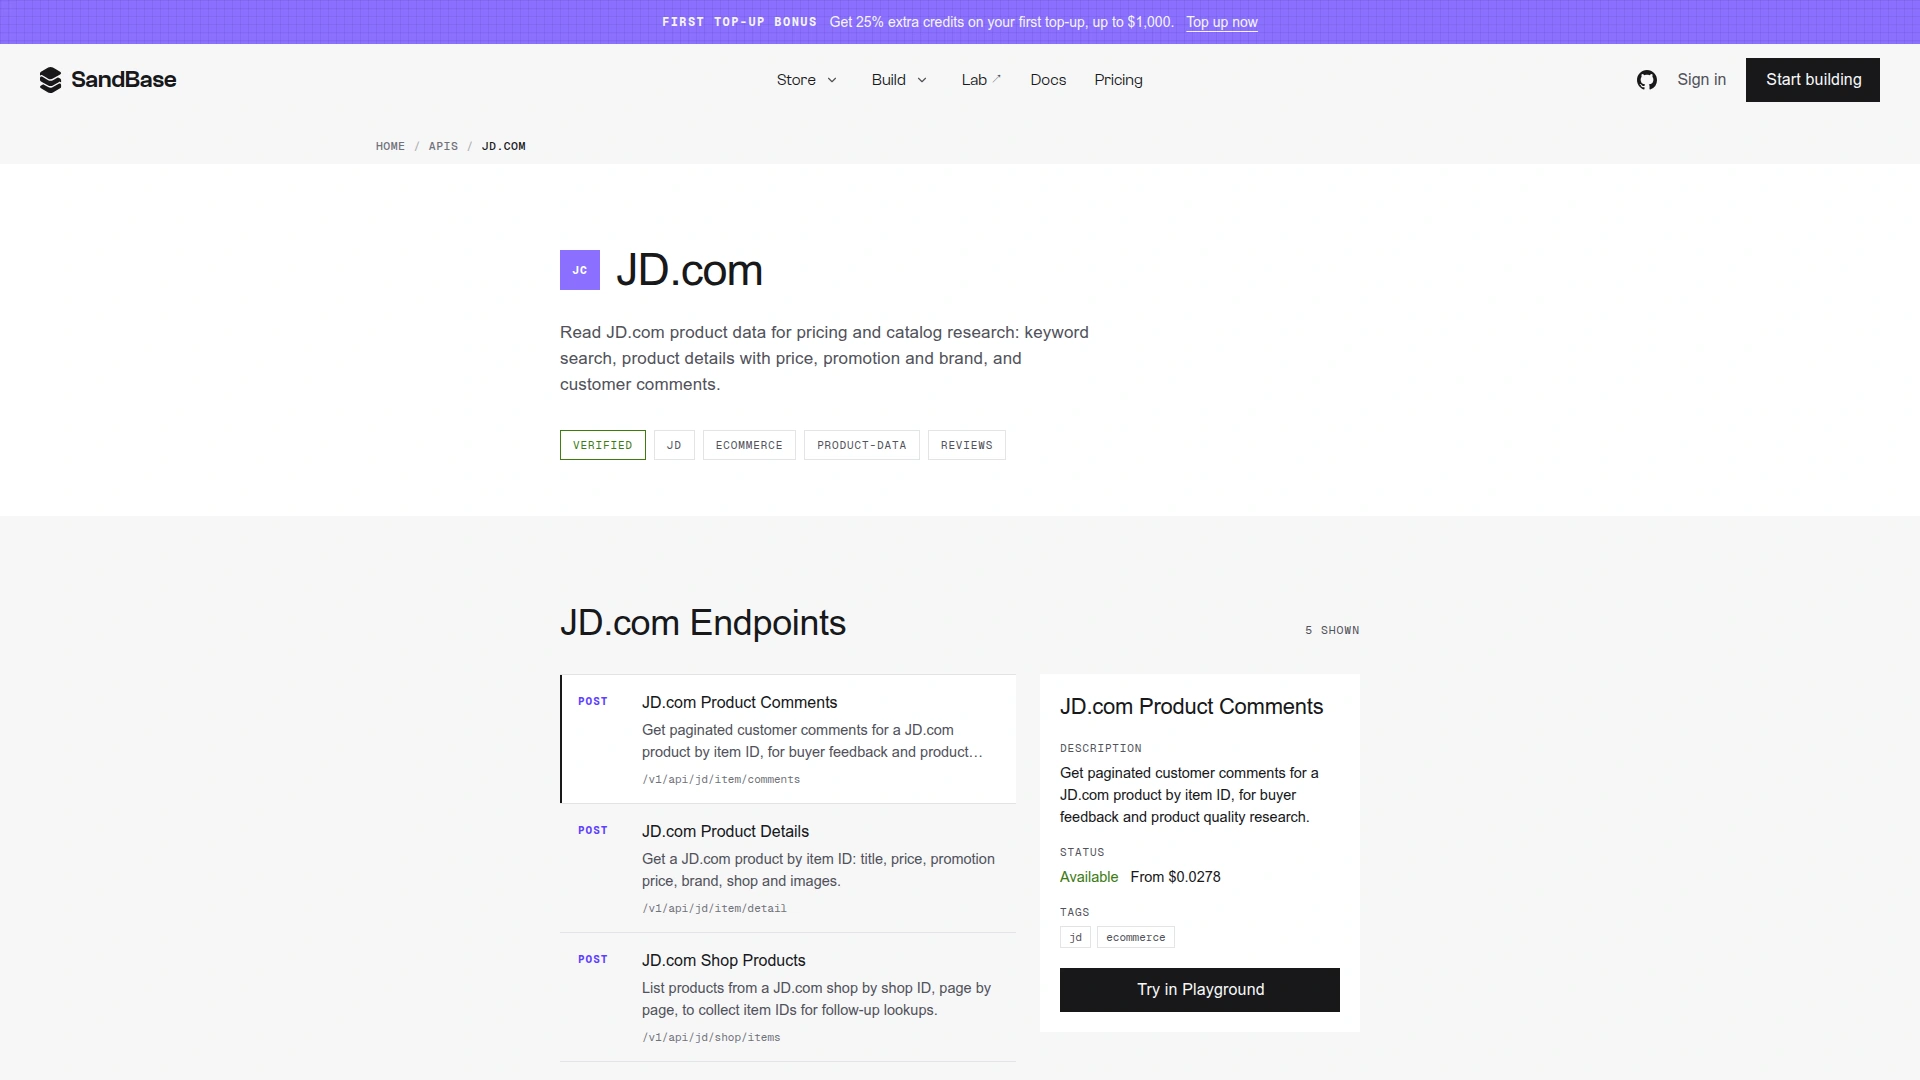 2026-11-01 的京东 API 目录快照。它能证明端点覆盖范围,不能证明任意商品的实时库存或数据完整性。
这里要把两层能力分开:京东提供原始公开市场数据,SandBase 提供统一认证、计费与完成态信封。业务负载仍是平台原始结构,因此“外层统一”不等于“里面每个字段长期稳定”。
先搜索,再归一化,最后补证据
“搜蓝牙耳机”还不是采购问题,但它足以拿到候选商品 ID 与店铺。比较稳的流水线分四步:
- 保存关键词、页码、时间与返回的商品 ID;
- 只归一化业务真正需要的字段;
- 对进入候选池的商品再查详情、描述图和评论;
- 缺失或遮罩数据保留为
None,禁止让 LLM 猜。
搜索端点只文档化了必填 keyword 和可选字符串 page。不要自行添加并不存在的价格、排序或类目参数。
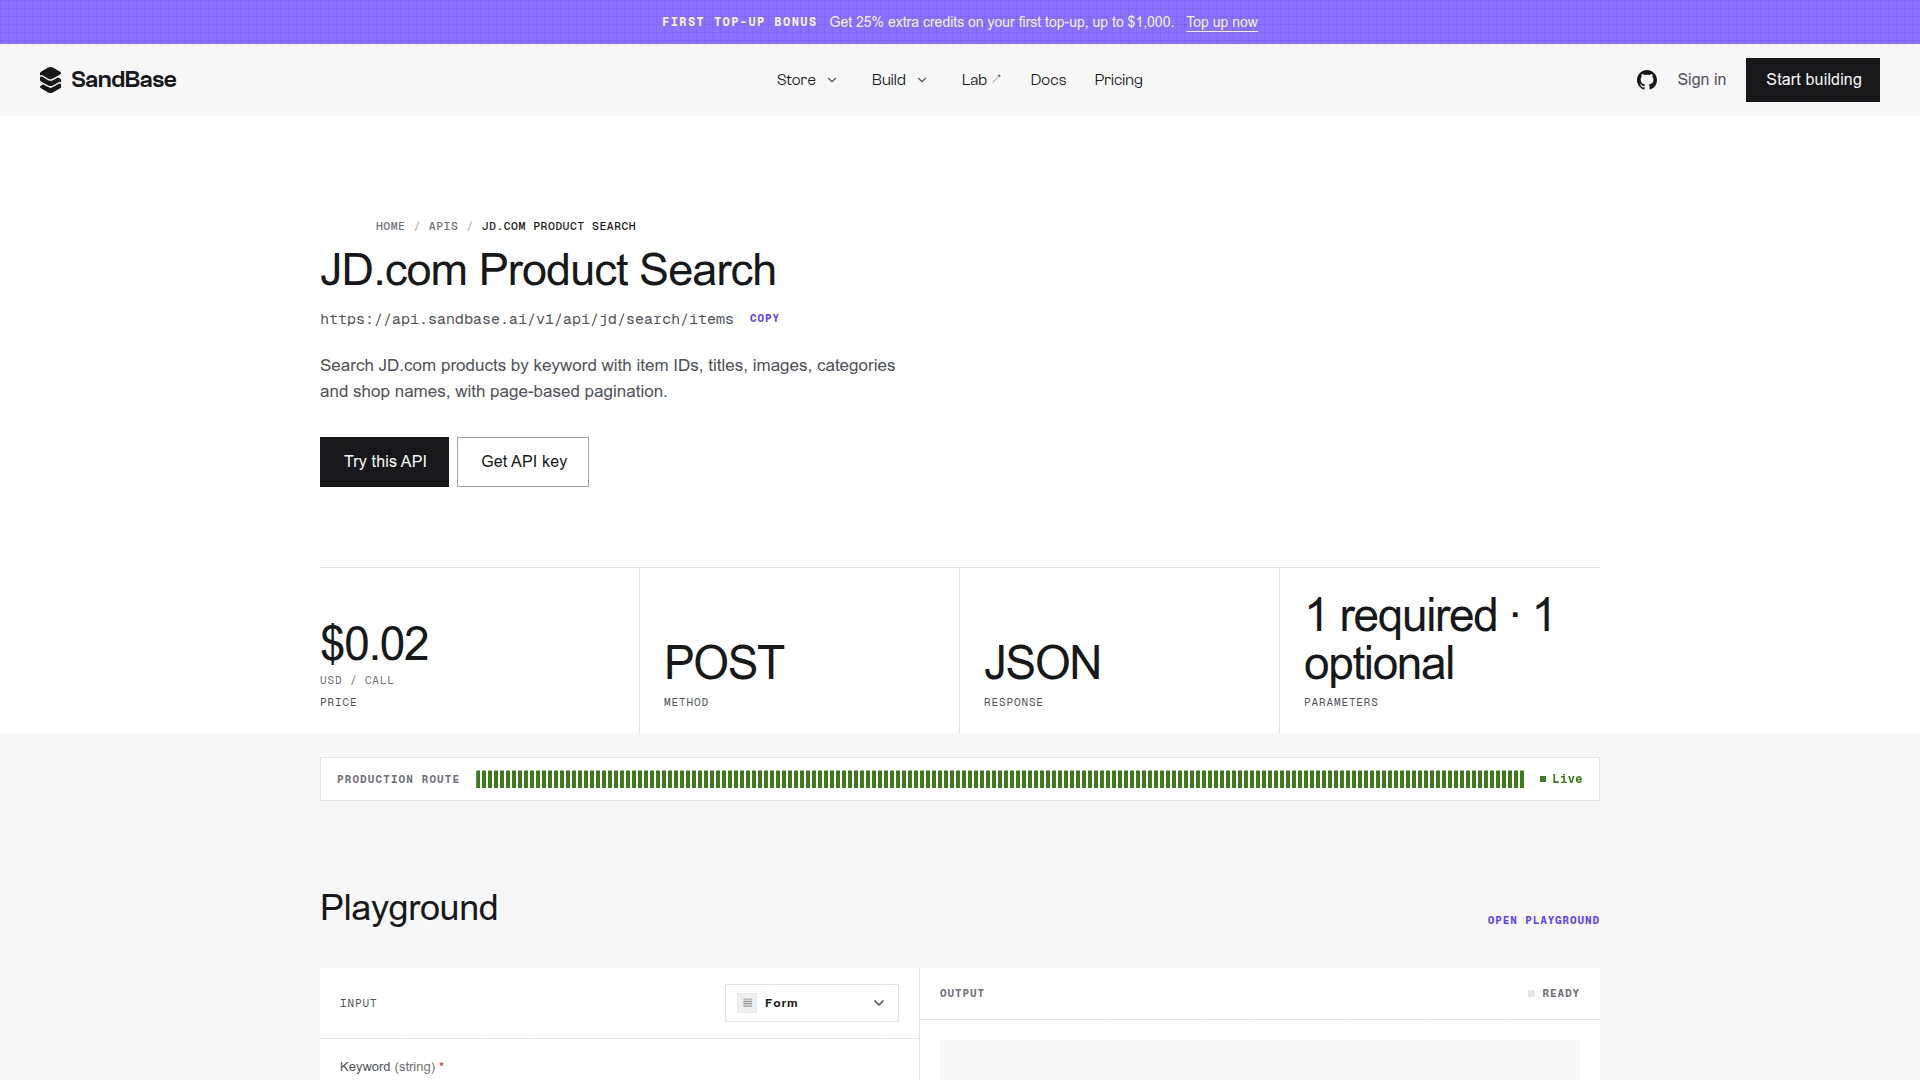 商品搜索使用
POST /v1/api/jd/search/items,参数为 keyword 与可选 page。截图于 2026-11-01,当前价格应以实时页面为准。
下面的客户端只读文档化的完成态信封,状态不完整就明确报错:
import os
import requests

BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call_jd(path: str, payload: dict) -> dict:
    resp = requests.post(
        f"{BASE}/jd/{path}", headers=HEADERS, json=payload, timeout=60
    )
    resp.raise_for_status()
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(
            f"JD call did not complete: {body.get('status')} {body.get('error')}"
        )
    data = outputs[0].get("data")
    if not isinstance(data, dict):
        raise RuntimeError("JD call completed without an object payload")
    return {"run_id": body.get("id"), "data": data}

result = call_jd("search/items", {"keyword": "蓝牙耳机", "page": "1"})
以下业务字段来自 2026-11-01(UTC+8)的真实调用,只代表本次观察,不是文档保证。搜索 run id f392e6eb-1430-4e90-912c-a3dfa49a38ee 的脱敏片段如下:
{
  "currentPage": 1,
  "totalCount": 7598,
  "products": [{
    "id": "100196304872",
    "title": "SANAG...Z60S 蓝牙耳机...",
    "price": "223.00",
    "shopName": "SANAG影音京东自营旗舰店"
  }]
}
totalCount 是这次响应的结果,不是稳定市场规模。生产系统可以保留原始 JSON 便于审计,但下游最好只接收更小的内部对象:
from decimal import Decimal, InvalidOperation

def money_or_none(value):
    try:
        return Decimal(str(value))
    except (InvalidOperation, TypeError, ValueError):
        return None

def normalize_search_item(item: dict, run_id: str) -> dict:
    return {
        "marketplace": "jd",
        "item_id": item.get("id"),
        "title": item.get("title") or item.get("shortTitle"),
        "price_cny": money_or_none(item.get("price")),
        "shop_id": item.get("shopId"),
        "shop_name": item.get("shopName"),
        "observed_run_id": run_id,
        "observed_at": "2026-11-01",
    }
详情接口为什么必须单独写适配器
详情端点只有一个必填 itemId。页面说明它提供标题、价格、促销价、品牌、店铺和图片,但实际原始负载比搜索结果深得多。
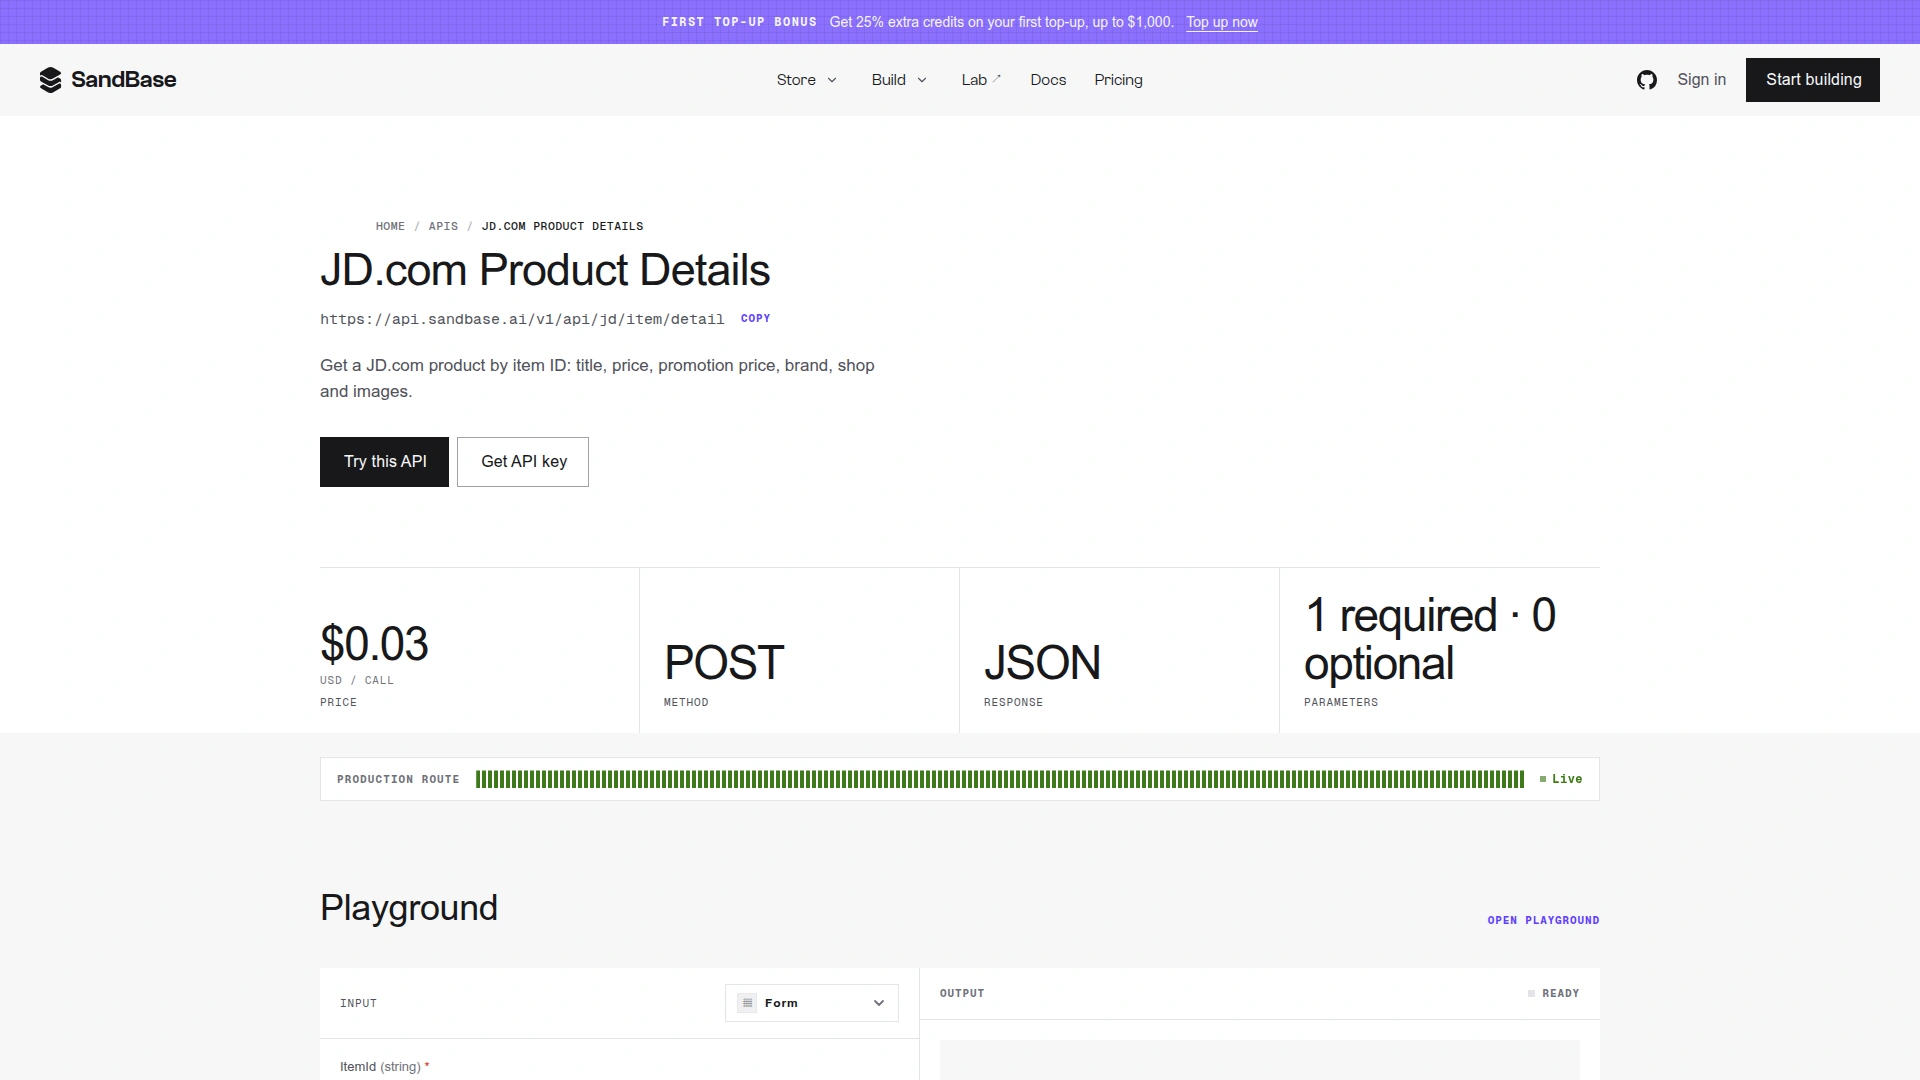 详情接口要求一个
itemId;截图时每次完成调用为 $0.0278。截图于 2026-11-01。
run id fd1ac766-af8c-427e-828f-e8a7e78e7f95 中,商品信息位于 product,价格对象位于 priceFloor。本次观察到了 skuId、skuName、brandName、shopId,但价格字符串是 1??。
这里最容易犯错:删除问号、拿搜索价硬补,或者让模型“修复”数字。搜索与详情是不同时间、不同结构的观察,甚至可能对应不同变体。更稳妥的做法是把两条证据各自保留,并给每条值带上来源。
def normalize_detail(data: dict, run_id: str) -> dict:
    product = data.get("product") or {}
    price_floor = data.get("priceFloor") or {}
    return {
        "marketplace": "jd",
        "item_id": product.get("skuId"),
        "title": product.get("skuName"),
        "brand": product.get("brandName"),
        "shop_id": product.get("shopId"),
        "detail_price_cny": money_or_none(price_floor.get("price")),
        "raw_price": price_floor.get("price"),
        "observed_run_id": run_id,
    }
评论能补证据,但不能制造口碑
评论接口接收 itemId 和可选 page,适合收集买家用语、重复出现的问题和待人工核查的质量线索。它不是一个自动“好评率裁判”。
这次用文档样例商品调用评论,没有留下可用的响应记录:留存证据里没有完成态信封、HTTP 状态或 run id。因此不能把它归类为有效空结果,也不能声称评论负载已通过实测。生产系统必须区分请求/执行失败、完成态 no_data、以及完成态中确实没有负面评论;三种状态都要单独记录。
要做文本分析,建议移除直接身份信息,保留评论日期与商品变体,先去重,再让模型聚类。对外展示时同时给出样本量、采集日期和筛选方式,避免一句“用户普遍认为”把有限样本扩大成全体结论。
一次日常任务要多少钱
假设每天搜索 20 个关键词、补 50 个候选详情,再为 20 个决赛商品取一页评论:
| 阶段 | 每日调用 | 单价 | 每日成本 |
|---|---|---|---|
| 搜索 | 20 | $0.0208 | $0.416 |
| 详情 | 50 | $0.0278 | $1.390 |
| 评论 | 20 | $0.0278 | $0.556 |
| 合计 | 90 | $2.362 |
按 30 天同样规模计算是 $70.86。它只是基于 11 月 1 日页面价格的场景估算,不是报价。控制成本的关键不是少写几行 Python,而是按商品 ID 缓存详情、只 enrich 通过确定性筛选的商品,并让价格/库存与描述图片采用不同刷新频率。
架构上最值得做的 5 件事
- 原始层与归一化层分开。 原始 JSON 用于追查,归一化对象保护业务代码不被上游字段变化拖垮。
- 证据来源进入 schema。 保存 run id、请求哈希、页码、商品 ID 与采集时间。
- 发现与监测分开。 搜索负责找候选,监测负责跟踪固定 ID。只重复搜索会悄悄换掉样本。
- LLM 之前先做确定性检查。 校验 ID、解析数值、处理缺失与去重,再把有限证据交给模型。
- 分页当状态机。 文档化的是页码分页,就保存实际请求页并在空页停止,不要创造 cursor。
边界与限制
市场数据只代表采集时刻。价格、促销、库存、卖家与评论都会变化;商品页不能证明真伪或履约质量;搜索结果数也不是需求量。评论可能重复、带营销倾向或属于某个特定变体。最后,京东原始负载字段很多,可能独立于 SandBase 的统一外层发生变化。
如果你的问题是 MOQ、阶梯价和供应商初筛,而不是零售货盘,可以看1688 Product Finder 指南。如果要比较多个商城的公开报价,则更接近商品比价工具。
FAQ
需要单独申请京东开发者 key 吗?
这些端点页使用 SandBase Bearer 认证。调用对应路由需要 SandBase API key,页面没有要求额外的京东开发者 key。
可以使用 /v1/run 吗?
数据 API 教程应使用端点页列出的 POST /v1/api/jd/<path>,并且只从 outputs[0].data 读取业务数据。不要照搬页面其他位置可能出现的旧生成示例。
Agent 能自动比价吗?
可以,但先做确定性解析。遮罩或缺失价格必须保持未知,同时保存币种、时间与商品变体,不能把不同 SKU 当成同一件商品比较。
数据多久刷新一次?
没有通用答案。发现任务可以每日跑搜索,候选商品按业务决策频率刷新详情,变化慢的图片与属性可以缓存更久。无论频率如何,都要让前端看见数据时间。
最后的判断
这 5 个京东端点覆盖一条零售研究流水线需要的阶段:关键词找候选、固定 ID 查详情、描述图补属性、店铺列表扩展货盘、评论补用户证据。本次已验证搜索与详情,没有验证评论响应。真正难的不是请求,而是遇到遮罩、缺失、未验证与结构差异时仍然保留不确定性。
每个端点单独适配,每条归一化记录都带证据来源,再让 agent 只读取这层有限数据。这样得到的是可审计的研究输入,而不是看起来很聪明、实际上在猜的采购结论。