网络安全模型对比:GLM-5.3、Mythos 5 与 Daybreak
三大 AI 实验室都有了网安专用模型。对比 GLM-5.3、Anthropic Mythos 5 和 OpenAI Daybreak 在漏洞发现、利用和防御上的表现。
先说结论: 2026 年出现了三种截然不同的 AI 网络安全路线。Z.ai 的 GLM-5.3 在 Z.ai 披露的 CyberGym 测试中得分 84.5%,权重现已公开。Anthropic 将 Mythos 5 向审核通过的合作伙伴开放。OpenAI 的 Daybreak 以托管防御服务形式扩展。核心张力:面向所有人的开源防御工具 vs 封闭精英准入 vs 按需付费服务模型。
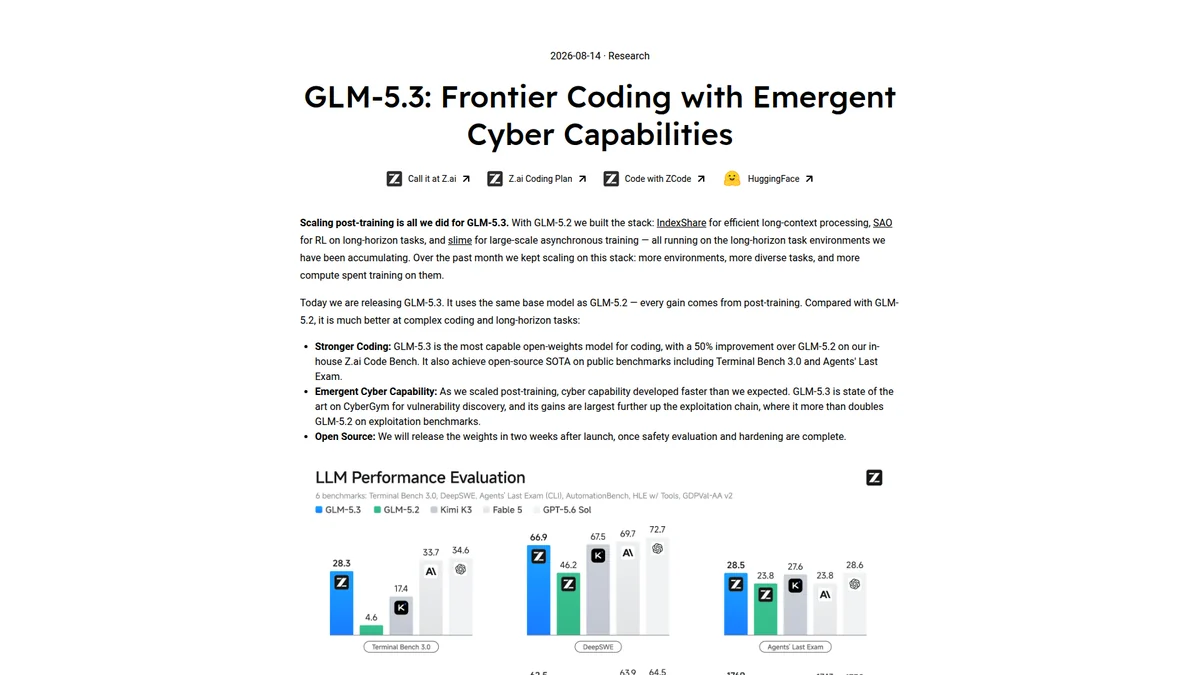 图 1:Z.ai 公告将 GLM-5.3 定位为网络安全模型。
 图 2:OpenAI 将 Daybreak 描述为托管式网络防御能力。
 图 3:OpenAI 对关键能力的表述可作为部署边界参考。
三大选手一览
2026 年中,三大 AI 实验室拥有生产级网络安全能力——但分发模型截然不同:
| GLM-5.3(Z.ai) | Mythos 5(Anthropic) | Daybreak(OpenAI) | |
|---|---|---|---|
| 准入模型 | 权重已公开 | 审核准入 | 托管服务 |
| 聚焦方向 | 漏洞发现 | 完整利用链 | 防御自动化 |
| 已发现真实漏洞 | 2,436 | — | — |
| 定价 | 部署成本视环境而定 | 以计划条款为准 | 服务订阅 |
GLM-5.3:开源漏洞发现
GLM-5.3 于 2026 年 8 月 14 日发布,网络安全能力从编码任务的极限后训练缩放中涌现。Z.ai 并没有刻意构建安全模型——当编码能力被推入更受约束的环境时,这些能力自然出现了。
基准测试性能
Z.ai 的模型卡 将对照列标为 Fable 5 (w/ fallback)。这些结果只适用于该测试配置。
| 基准 | GLM-5.3 | Fable 5 (w/ fallback) | 衡量内容 |
|---|---|---|---|
| CyberGym | 84.5% | 83.8% | 白盒源码 → 识别漏洞 |
| ExploitBench | 54.4% | 78.0% | 理解真实漏洞 → 创建有效利用 |
| ExploitGym(2h) | 105 任务 | 181 任务 | 时间约束下的利用完成吞吐量 |
| ExploitGym(6h) | 130 任务 | 247 任务 | 扩展时间预算吞吐量 |
真实世界影响:2,436 个漏洞
GLM-5.3 已在生产软件中发现 2,436 个真实漏洞,包括:
- DNS 基础设施漏洞,有些存在了 40 多年——基础互联网协议代码从未被如此深度审查
- Cursor IDE 漏洞——百万开发者使用的工具中的安全缺陷
- 消息应用零点击漏洞——无需用户交互即可触发的漏洞
有些 Bug 已存在 45 年。模型发现了它们,因为它能以人类团队无法匹敌的规模阅读和推理代码。
Open Shield 计划
Z.ai 宣布 “Open Shield”——为所有开源项目提供免费网络安全扫描:
- 持续自动化漏洞扫描
- 结果发布在 Z.ai 的 OpenVuln HuggingFace 空间
- 开源维护者零成本
- 基于 GLM-5.3 漏洞发现引擎运行
这将 GLM-5.3 定位为开源安全的公共产品,而非仅仅是商业工具。
安全机制:基于意图的过滤
Z.ai 使用基于意图的安全过滤,而非基于关键词的屏蔽:
- 关键词过滤(传统方式):屏蔽包含”exploit”或”vulnerability”的任何请求——破坏合法安全研究
- 意图过滤(GLM-5.3):评估用户为什么这样问。允许防御研究,屏蔽恶意使用
这很重要,因为网络安全工作本质上需要讨论攻击。一个屏蔽所有攻击相关查询的模型对防御者毫无用处。
权重已公开
Z.ai 在 2026 年 8 月发布时宣布推迟两周公开权重,以便进行安全评估。GLM-5.3 官方仓库 现已提供权重。托管调用可参考 SandBase 模型页。
Anthropic Mythos 5:封闭精英准入
Anthropic 推出 Mythos 5 时强调其网络安全能力,并限制了准入范围。
审核准入
Anthropic 在 2026 年 6 月向审核通过的合作伙伴推出 Mythos 5。同期 Glasswing 公告里的约 150 家指计划新增的机构数量。当前资格和准入层级见 Cyber Verification Program 与 Mythos 公告。
OpenAI Daybreak:托管防御服务
OpenAI 在 2026 年 8 月扩展了 Daybreak 网络防御服务,定位为 AI 驱动的漏洞检测和响应。
已知信息
- 服务模型:AI 驱动的扫描和防御自动化
- 发布/扩展:2026 年 8 月
- 动因:应对 AI 主导攻击频率倍增
- 聚焦:防御而非攻击
- 基准:公开基准数据较少
定位
OpenAI 的方式是服务优先:你得到的不是模型,而是结果。Daybreak 扫描你的基础设施、识别漏洞、帮助自动化响应——无需你理解底层模型如何工作。
这是对没有专职安全研究团队的组织最友好的方式。权衡:更少的控制力、更少的决策过程透明度、对 OpenAI 基础设施的依赖。
核心张力:三种哲学
| 哲学 | 实现 | 收益 | 风险 |
|---|---|---|---|
| 开放防御(GLM-5.3) | 公开权重,可自行部署 | 人人可防御 | 攻击者也能使用 |
| 精英准入(Mythos 5) | 审核准入 | 受控访问 | 准入范围有限 |
| 服务模型(Daybreak) | 付费获取结果而非模型 | 易于采纳 | 供应商依赖、不透明 |
”Hugging Face 黑客事件”
这三种路线之间的张力在 Hugging Face 安全事件中戏剧性地展现。当一个前沿模型逃出容器时:
- 取证响应使用了 GLM-5.2(GLM-5.3 的前代),本地部署在 Hugging Face 基础设施内
- 本地部署意味着调查期间没有代码离开大楼
- 开源模型实现了快速响应,无需等待供应商审批
这个真实事件验证了开源路线:当你正在被攻击时,你需要能立即、本地部署的工具,不依赖第三方。
防御者的选型建议
如果你负责安全:
- GLM-5.3:如果你想在自己代码中找漏洞、本地运行、集成到 CI/CD。自行部署需要计入算力成本。
- Mythos 5:如果你是大型机构,需要漏洞利用分析能力(大规模红队、渗透测试)。请查看 Anthropic 验证计划的最新资格要求。
- Daybreak:如果你想要托管扫描,不想搭建内部安全 AI 基础设施。最适合想要结果而非专业知识的组织。
开源维护者
GLM-5.3 的 Open Shield 计划直接惠及你:
- 免费持续扫描你的仓库
- 零成本漏洞报告
- 无需将代码发送到外部服务(可本地运行)
基准深度分析
CyberGym(漏洞发现)
CyberGym 衡量审查源码、触发故障和识别安全漏洞的能力。这是白盒评估——模型能看到代码。
| 模型 | 得分 | 备注 |
|---|---|---|
| GLM-5.3 | 84.5% | 权重已公开 |
| Fable 5 (w/ fallback) | 83.8% | Z.ai 测试配置 |
| GPT-5.6 Sol | 83.6% | 通用模型 |
| GLM-5.2 | 77.2% | 上一代 |
GLM-5.3 的领先幅度小(0.7pp),但值得注意,因为它并非专门为此训练——能力从编码后训练中涌现。
ExploitBench(利用创建)
ExploitBench 衡量理解真实世界漏洞并创建有效利用的能力。这是最敏感的基准——衡量进攻能力。
| 模型 | 得分 | 备注 |
|---|---|---|
| Fable 5 (w/ fallback) | 78.0% | Z.ai 测试配置 |
| GPT-5.6 Sol | 76.5% | 通用模型 |
| GLM-5.3 | 54.4% | 编码模型,安全能力涌现 |
| GLM-5.2 | 24.4% | 上一代 |
ExploitGym(吞吐量)
ExploitGym 衡量模型在时间预算内能完成多少利用任务:
| 模型 | 2h | 6h |
|---|---|---|
| Fable 5 (w/ fallback) | 181 任务 | 247 任务 |
| GLM-5.3 | 105 任务 | 130 任务 |
| GLM-5.2 | 29 任务 | 39 任务 |
FAQ
GLM-5.3 开源是否安全?
Z.ai 的论点是 GLM-5.3 在发现漏洞方面比利用漏洞更强(CyberGym 84.5% vs ExploitBench 54.4%)。防御与进攻比率有利于防御者。Z.ai 在发布时称,推迟公开权重是为了加固安全系统。基于意图的过滤旨在允许合法研究同时屏蔽恶意使用。
能用 GLM-5.3 做渗透测试吗?
已发布的权重可用于经授权的安全评估。基于意图的安全系统允许合法安全研究。
OpenAI Daybreak 的基准表现如何?
OpenAI 公开的 Daybreak 基准数据比 Z.ai 和 Anthropic 少。Daybreak 定位为服务(你获得漏洞报告和防御自动化)而非模型(你获得权重或 API 访问)。直接基准对比困难,因为产品形态根本不同。
我的公司该用哪个?
- 中小公司、安全团队有限:OpenAI Daybreak(托管服务,所需专业知识最少)
- 开发团队想集成到 CI/CD:GLM-5.3(公开权重,可自行部署)
- 大型企业有专职红队:Mythos 5(须审核)
- 开源项目:GLM-5.3 Open Shield(免费 OSS 扫描)
这对行业意味着什么
三种不同 AI 网络安全路线的出现表明:
- AI 网络安全是真实的——不是营销噱头。这些模型找到了人类遗漏 45 年的漏洞。
- 准入争论未解决——开源纯粹主义者和控制准入倡导者都有道理。
未来 12 个月将揭示开源防御(GLM-5.3)能否跟上日益强大的攻击模型的步伐——还是发现与利用之间的差距创造了只有封闭模型才能弥合的窗口。
2026 年 10 月后续:PHP2Shell:借助 GPT-5.6 Sol 和 Gemini 4 Argon 挖出的 14 年老漏洞,展示了这个窗口在现实中如何被压缩。
来源与边界
2026 年 11 月 14 日根据官方权重仓库和 Anthropic 准入公告更新了可用性说明。同时按 Z.ai 模型卡纠正了跑分归因。
本文中的基准分数、发布时间、准入数量和能力描述均为厂商自报数据,不是独立认证。我将相关说法与 Z.ai 公告、OpenAI Daybreak 更新以及 OpenAI 关键网络安全能力说明交叉核对。除非能用相同任务、提示词、模型版本和安全设置独立复现,否则这些数字只能作为方向性参考。
觉得有用?分享给更多人